记一次因误删mongodb索引,而导致集群数据库的内存飙升和锁数量剧增的生产事故(下)
一、做减法排查问题
总结下前文使用的办法是:不断地做减法,把嫌疑服务排除出去,等待mongodb数据库恢复性能。
其次,解决mongodb的慢查询语句,适时地对慢查询语句增加索引。
最后就是重启大法,包括重启应用和重启数据库。
事后来看,走了不少弯路,首先没有去充分分析Mongodb的指标数据,遗漏了内存飙升和锁数量剧增的同时,QPS和流量以及影响文档数却是减少的不对称信息。
本文尝试做一个总结,对于Mongodb的cpu和内存使用率偏高的情况,首先要查看的是数据库此时正在执行的操作信息。
使用db.currentOp()命令,长期监控并实时分析它,帮助我们第一时间找到数据库所在的性能问题。
二、什么是currentOp
在MongoDB数据库中,currentOp是一个命令,用于返回当前数据库实例中正在执行的操作的信息。这个命令可以帮助用户诊断性能问题和识别长时间运行的操作。
currentOp命令的输出包括多个字段,其中一些重要的字段包括:
- client:请求由哪个客户端发起。
- opid:操作的ID,可以通过db.killOp(opid)终止该操作。
- secs_running/microsecs_running:代表请求运行的时间,如果这个值特别大,需要检查请求是否合理。
- query/ns:可以看出是对哪个集合正在执行什么操作。
- lock*:与锁相关的参数。
如果currentOp命令的输出堆积过多,可能会导致以下后果:
- 性能问题:长时间运行的操作可能会占用大量资源,影响数据库的响应速度和吞吐量。
- 锁等待:如果操作长时间持有锁,可能会导致其他操作等待锁释放,从而增加延迟。
- 资源竞争:过多的操作可能导致资源(如CPU、内存、I/O)竞争,影响数据库的整体性能。
- 诊断困难:如果currentOp的输出堆积,可能会使得诊断特定性能问题变得更加困难,因为输出信息可能会非常庞大且难以分析。
因此,定期监控和分析currentOp的输出对于维护MongoDB数据库的性能至关重要。如果发现长时间运行的操作,应该及时分析和优化这些操作,以避免性能问题。
三、分析一条致命的currentOp命令
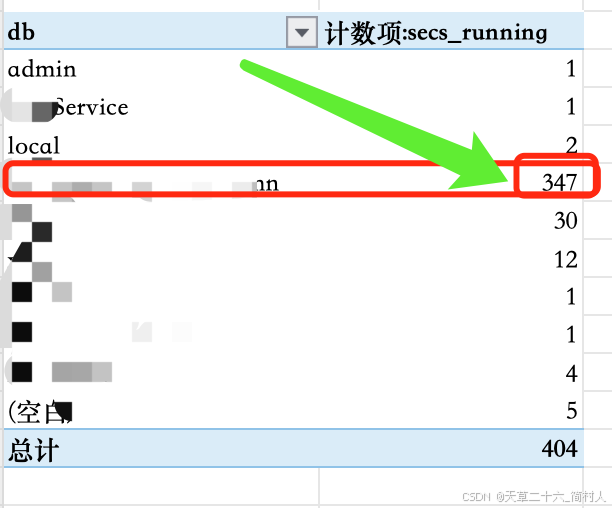
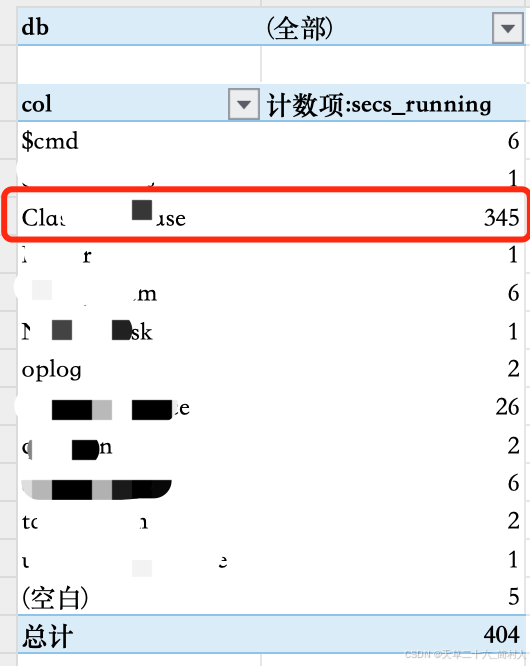
根据导出的currentOp命令占比,看到目标数据库的secs_running有347条。
按数据库占比分析结果:
按集合分析占比结果:
{
    "host": "v03h08276.cloud.et135:3166",
    "desc": "conn1535",
    "connectionId": 1535,
    "client": "11.112.241.44:63734",
    "clientMetadata": {
        // 略
    },
    "active": true,
    "currentOpTime": "2024-12-13T10:48:23.236+0800",
    "opid": 95272,
    "lsid": {
        // 略
    },
    "secs_running": 1932,
    "microsecs_running": 1932571681,
    "op": "command",
    "ns": "xx.xxx",
    "command": {
        "count": "xxx",
        "query": {
           //略
        },
        "shardVersion": [
            // 略
        ],
        "databaseVersion": {
            // 略
        },
        "allowImplicitCollectionCreation": false,
        "lsid": {
            // 略
        },
        "$clusterTime": {
            // 略
        },
        "$client": {
            // 略
        },
        "$configServerState": {
            // 略
        },
        "$db": "xx"
    },
    "planSummary": "IXSCAN { folderId: 1, newHiddenIds: 1, isDelete: 1 }, IXSCAN { folderId: 1, newHiddenIds: 1, isDelete: 1 }",
    "numYields": 58657,
    "locks": {

    },
    "waitingForLock": false,
    "lockStats": {
        "Global": {
            "acquireCount": {
                "r": 58657
            }
        },
        "Database": {
            "acquireCount": {
                "r": 58657
            }
        },
        "Collection": {
            "acquireCount": {
                "r": 58657
            }
        }
    }
}
去掉没用的信息,剩下关键字段:
// 操作ID为 95272。
"opid": 95272,
// 运行时间长达1932秒
"secs_running": 1932,
// 查询计划为IXSCAN
"planSummary": "IXSCAN { folderId: 1, newHiddenIds: 1, isDelete: 1 }, IXSCAN { folderId: 1, newHiddenIds: 1, isDelete: 1 }",
// 操作已发生 58657 次上下文切换。
"numYields": 58657,
// 操作没有在等待锁
"waitingForLock": false,
// 操作当前持有的锁,包括全局读锁(Global: “r”)、数据库读锁(Database: “r”)和集合读锁(Collection: “r”)。
"lockStats": {
     "Global": {
         "acquireCount": {
             "r": 58657
         }
     },
     "Database": {
         "acquireCount": {
             "r": 58657
         }
     },
     "Collection": {
         "acquireCount": {
             "r": 58657
         }
     }
 }
总结一下,这个操作除了相应耗时慢外,还将导致以下后果:
- “numYields”: 58657,cpu发生 58657 次上下文切换,上文说的cpu使用率100%
- “lockStats” ,当前持有的锁有58657,对应上文的锁数量剧增
手动终止慢操作
// 操作ID是95272,currentOp的唯一标识
db.killOp(95272)
四、总结
习惯性思维是慢查询导致数据库的性能下降,而当数据库的慢日志出现几万甚至几十万条的时候,我们又无法第一时间定位出具体是哪个慢,导致后续的操作变慢的。
此次事故,在应用没有发布的情况下,而且是发生在业务访问低峰,根本无法解释为什么数据库会被“挂了”。
这很大一个原因是分析的过程中,漏掉了一条重要信息。误删了数据库索引,以为是无用的索引。
这也印证了那句话,你以为的以为是你以为的吗?真的是一次惨痛的血琳琳的教训。
顺便说一下,mongo审计日志里可以看出对索引的操作日志,但是,在当时排查问题的时候,人人都急得如热锅上的蚂蚁,谁会留意到或者猜测是索引缺少导致的一系列问题呢。
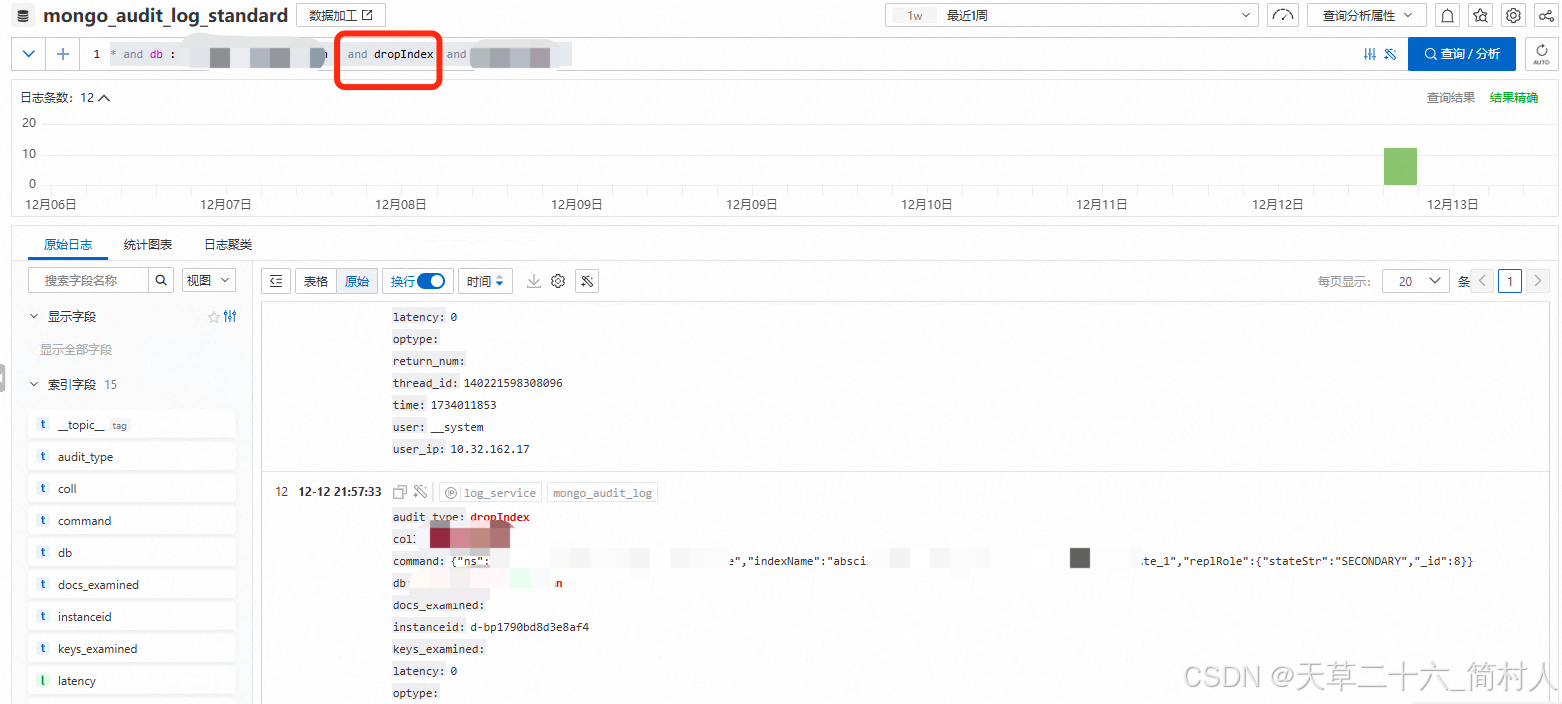
这也告诫我们,在分析问题发送的原因时,除了考虑数据库和应用本身外,如果是发生在低峰时刻,别遗漏了任何差异操作。像数据库的索引,这么重要的因素,把它供起来吧。
最后,从mongodb监控信息看到cpu和内存等使用率比较高,除了慢日志外,还需要第一时间导出currentOp。
因为错过了第一时间,后面的慢日志或者慢接口,都是由于mongodb数据库性能已变差的情况下产生的。
因果关系便是如此。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献15条内容

所有评论(0)