【递归,搜索与回溯算法 & 二叉树深搜】二叉树深搜算法入门详解 : 二叉树深搜小专题


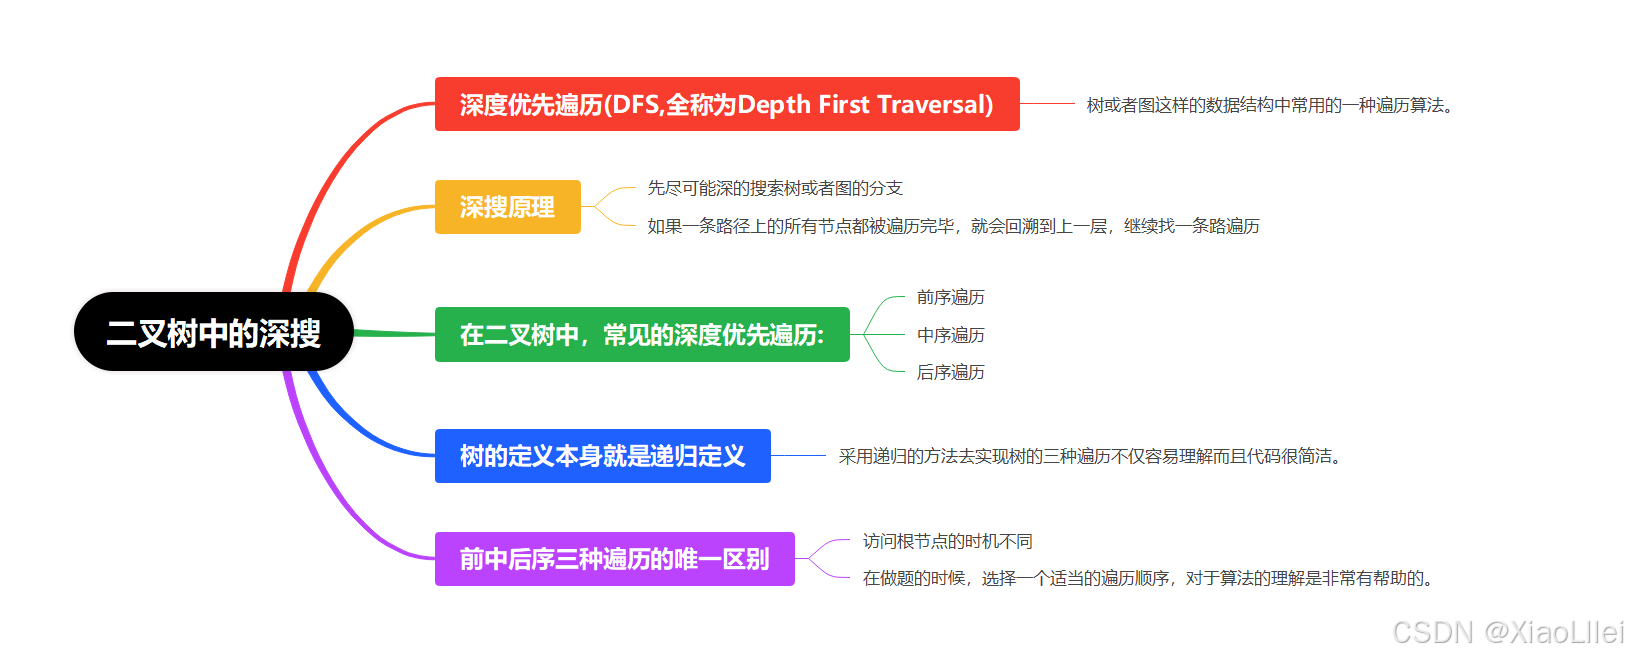
二叉树深搜的简单介绍
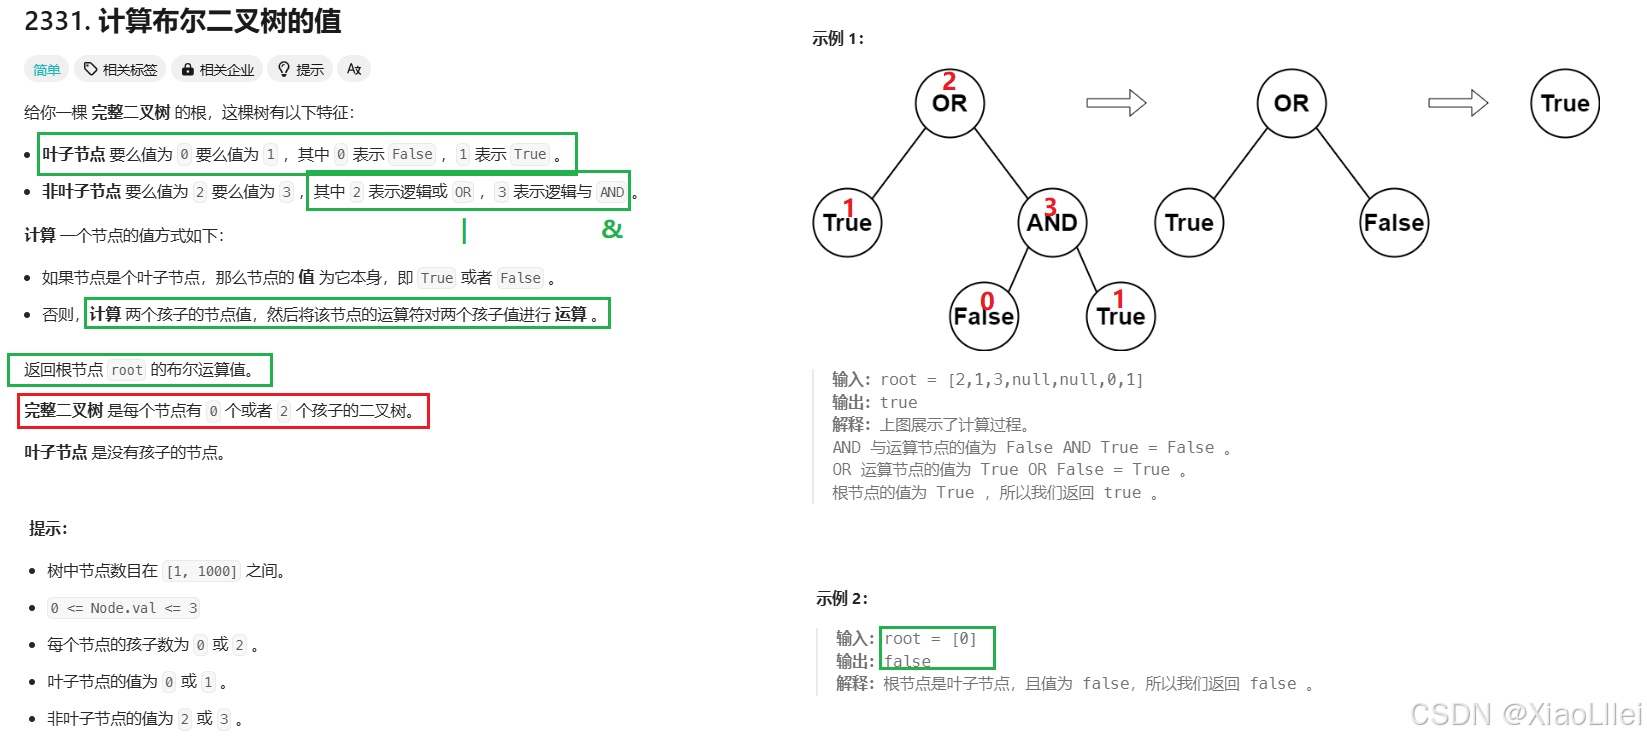
计算布尔二叉树的值
题目解析
算法原理
对于完全二叉树, 一个节点要么都有左右孩子, 或者为叶子节点
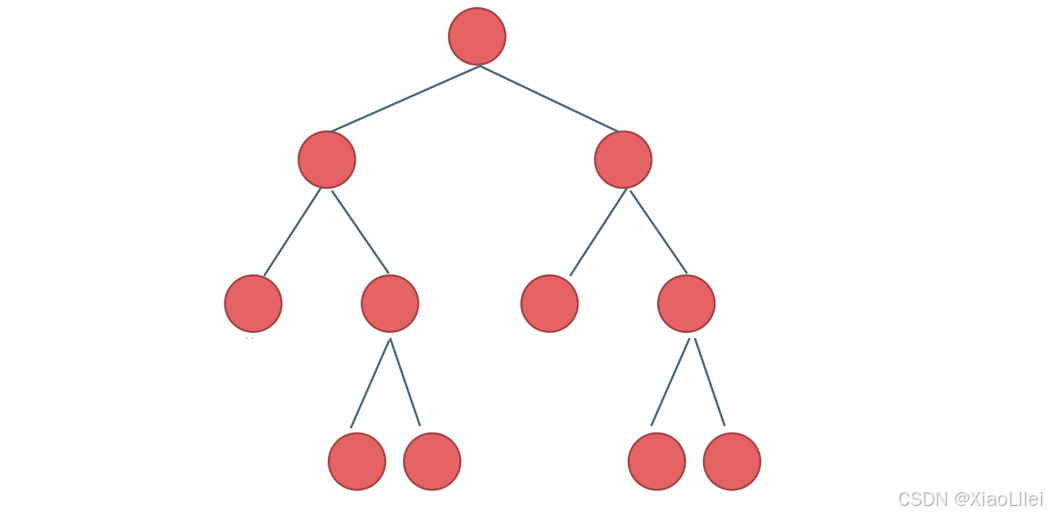
如果我们要算一棵完全二叉树根节点的值, 就要先算出这个根节点左子树的值以及右子树的值的整合结果, 得到的结果和根节点的运算符再次进行整合, 最终得到根节点的 boolean 结果;
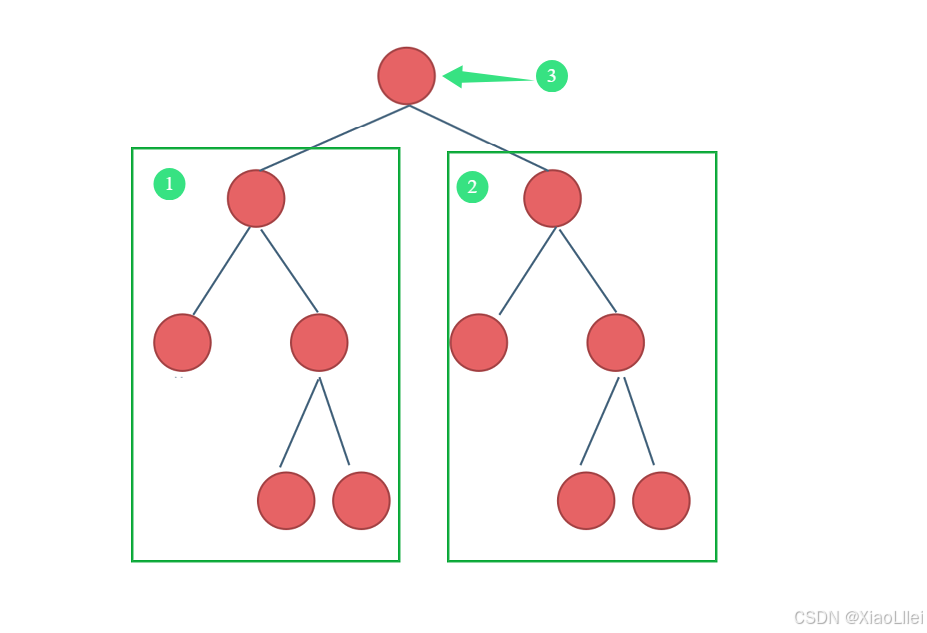
解法: 递归dfs
函数头
根据上述算法原理, 我们可以总结出函数头 boolean dfs( root )
函数体
我们需要根据下面的三步来设计函数体:
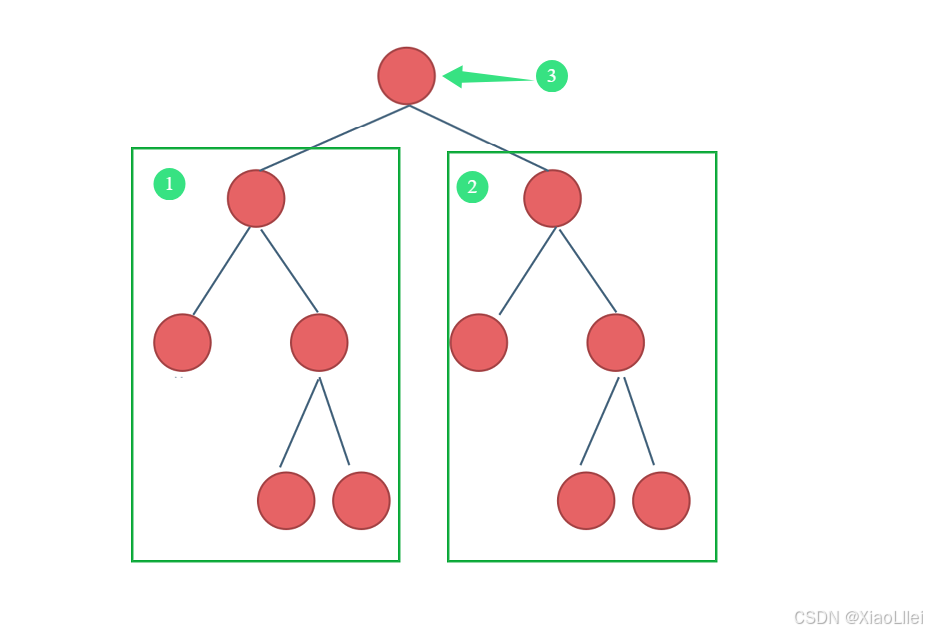
所以可以总结函数体:
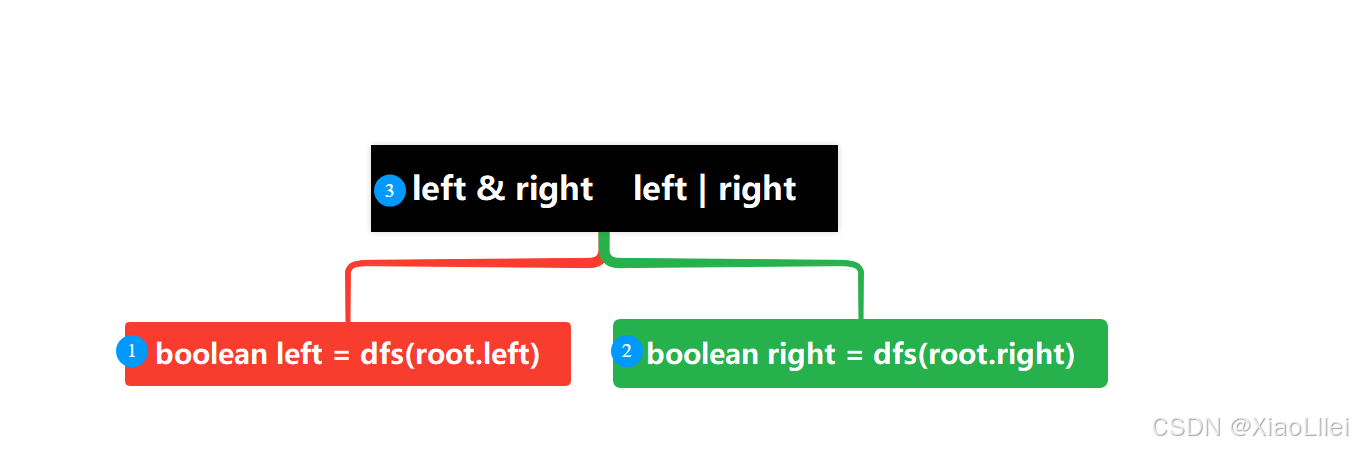 我们只需要相信: dfs() 可以帮助我们完成整合所传入节点的最终结果即可;
递归出口
在遍历到叶子节点时,只需要返回叶子节点值 true 或者 false 即可; 这也是我们的递归出口;
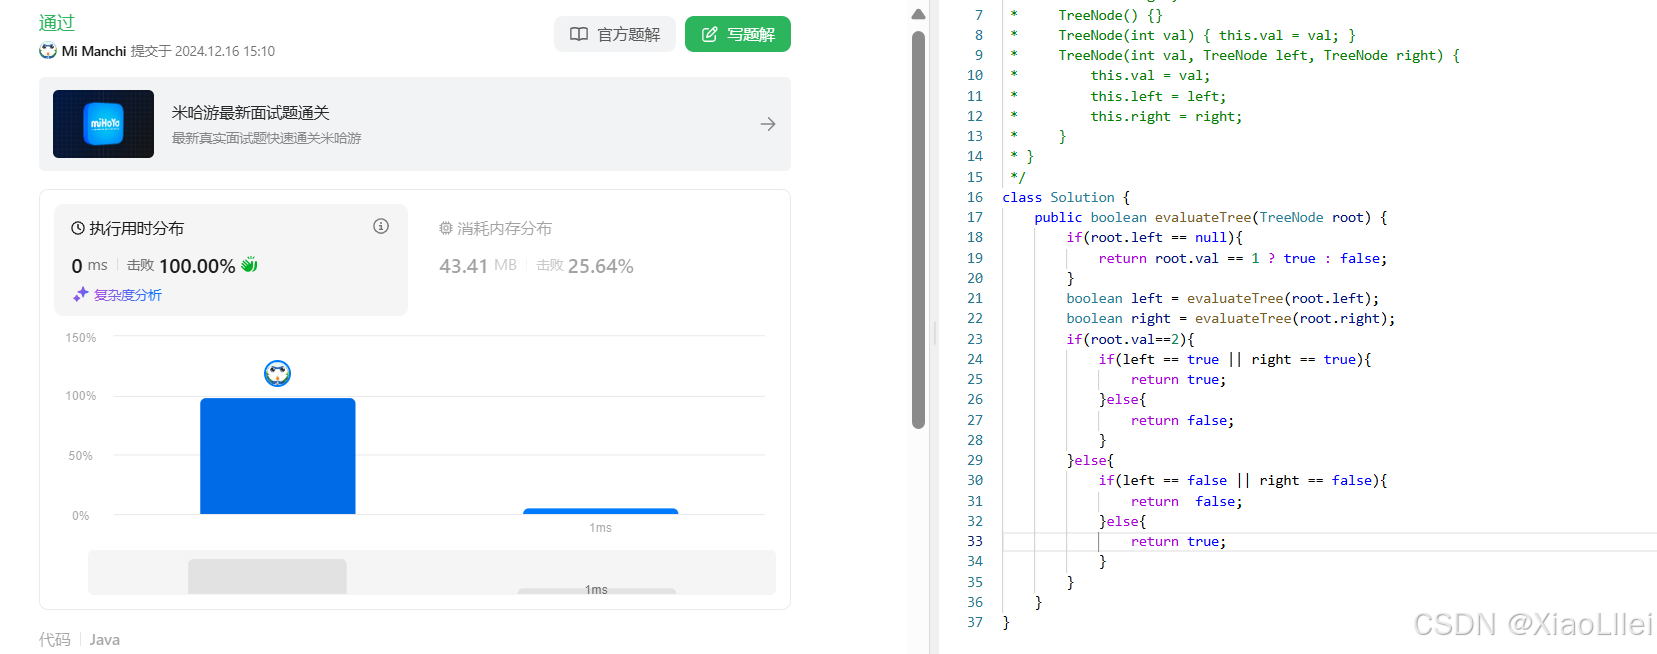
编写代码
注意 : 要根据每一个节点的 val, 来决定返回的值是 true 或者 false
求根节点到叶节点数字之和
题目解析
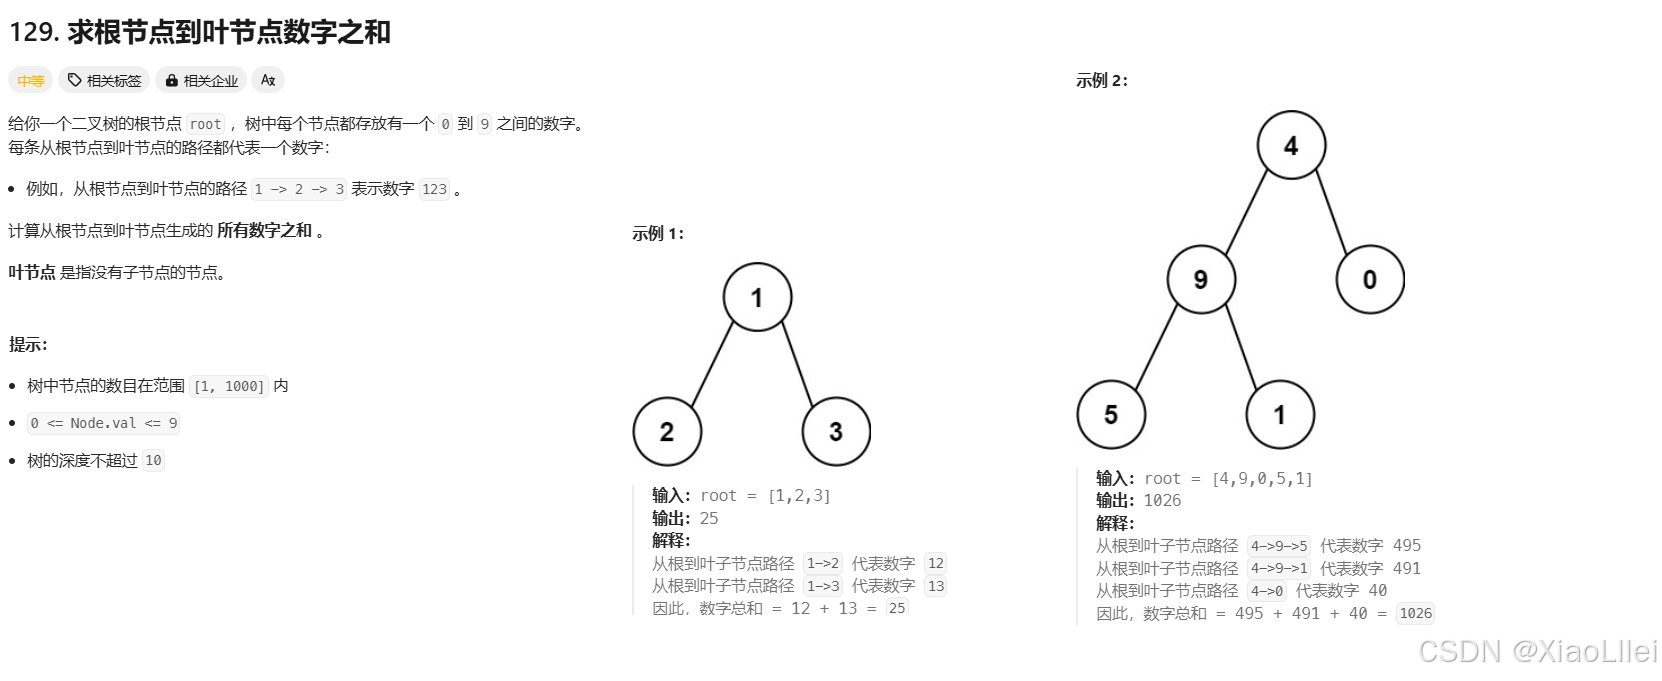
算法原理
解法: 递归
我们之前说过, 可以把 dfs 看作是一个黑盒, 把要完成的任务放心交给它处理即可; 但是如果 dfs 要处理的任务过多, 是比较难叙述清楚的, 这个时候我们该怎样解决呢 ?
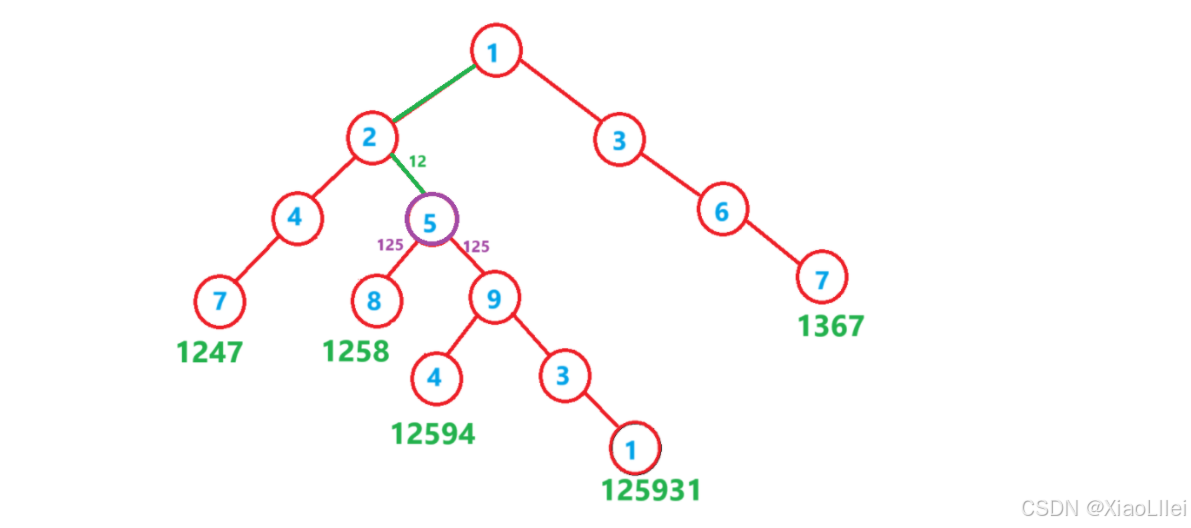
我们根据如下完全二叉树来作为本题的例子, 并且解决上述问题 ;
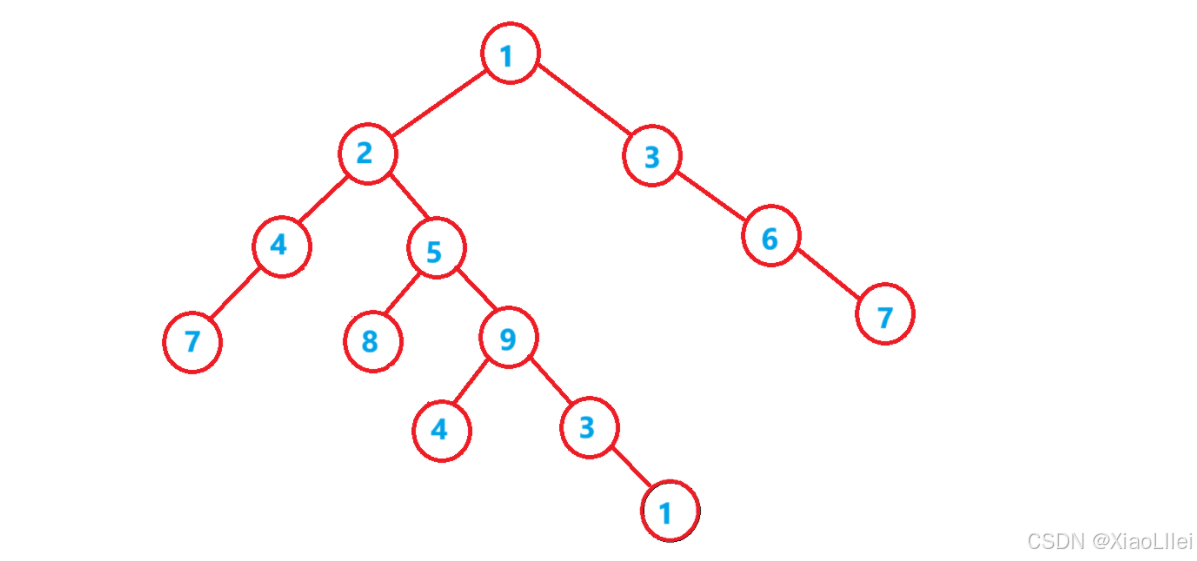
由题意可得 :
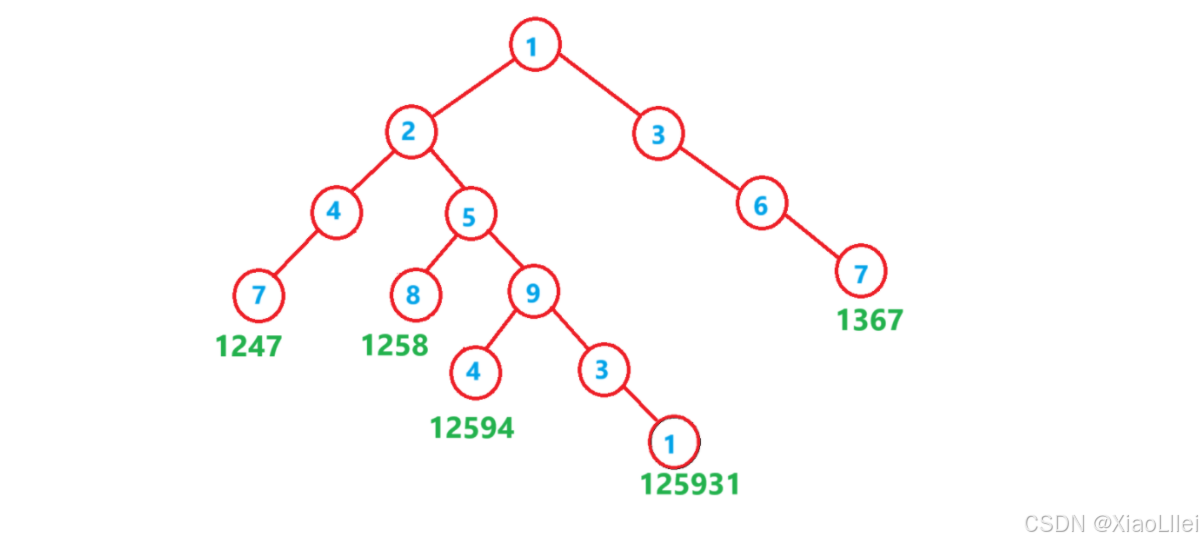
在算出每条分支代表的数之后 , 我们需要根据算数方法, 来总结出子问题, 在递归到二叉树的每一层时, 找出会重复执行的子任务; 所以我们只关心递归到某一层时, 会做的任务 :
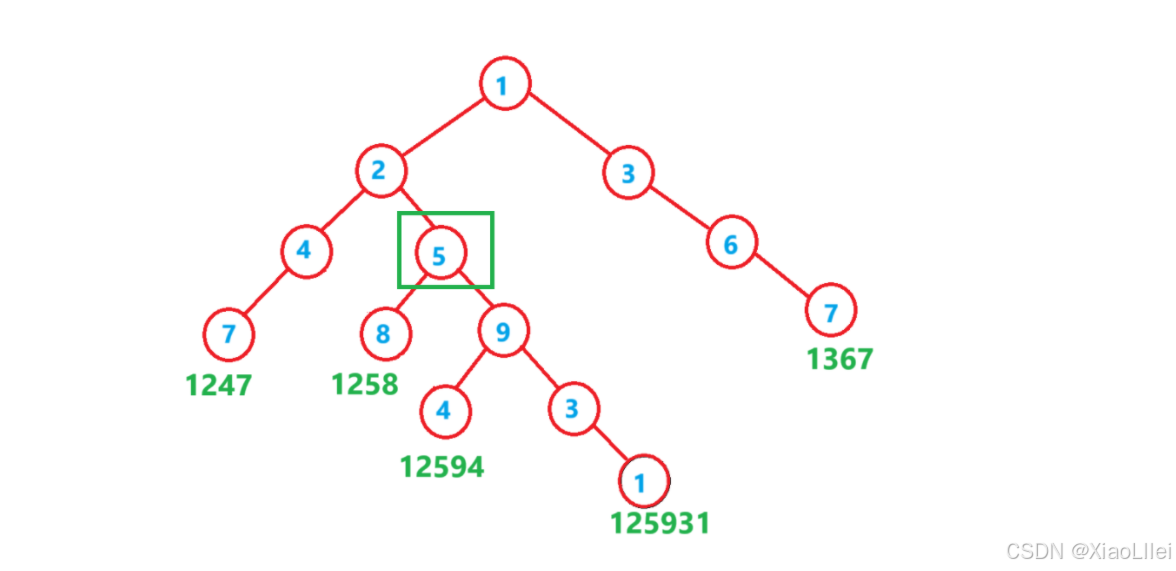
在递归到 5 节点时, 需要执行的任务有两种:
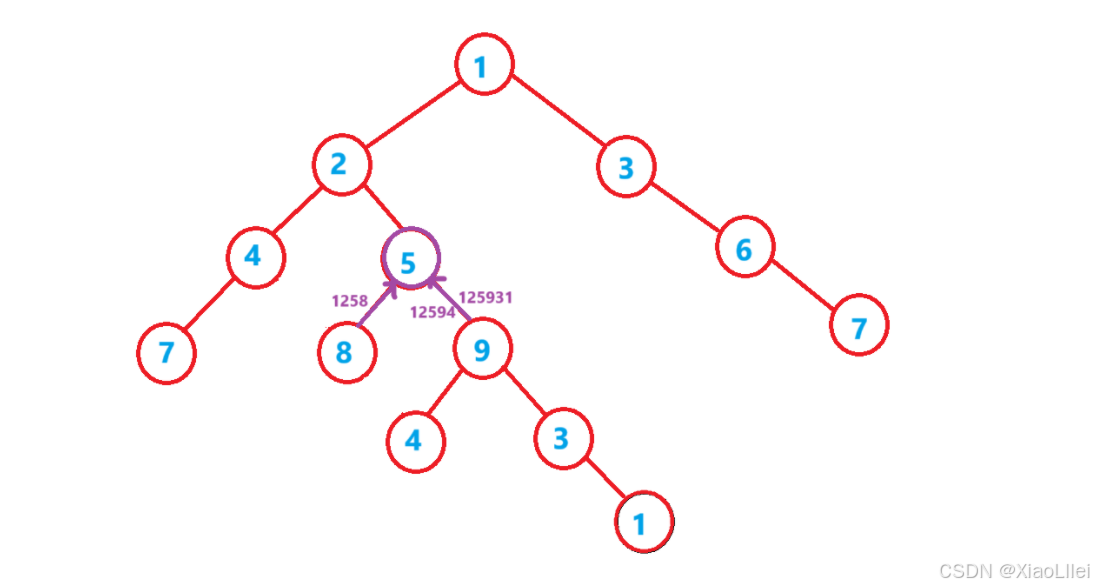
- 拿到 8 和 93 和 931 这三个数 , 表示从下往上计算
- 拿到 12 这个数 , 表示从上往下计算
我们选择让 dfs() 执行第二个任务, 因为 dfs() 完成的任务越简单, 越不容易出错;
拿到 12 这个数, 后续的递归才会继续正常运行; 所以函数体递归, 肯定是需要一个 int 类型的返回值进行接收的;
拿到 12 后, 要传 125 给 5 节点所在的所有分支
接下来, 5 节点就要接收所有返回的值并且相加 , 得到的结果返回上一个节点继续相加, 直到返回根节点:
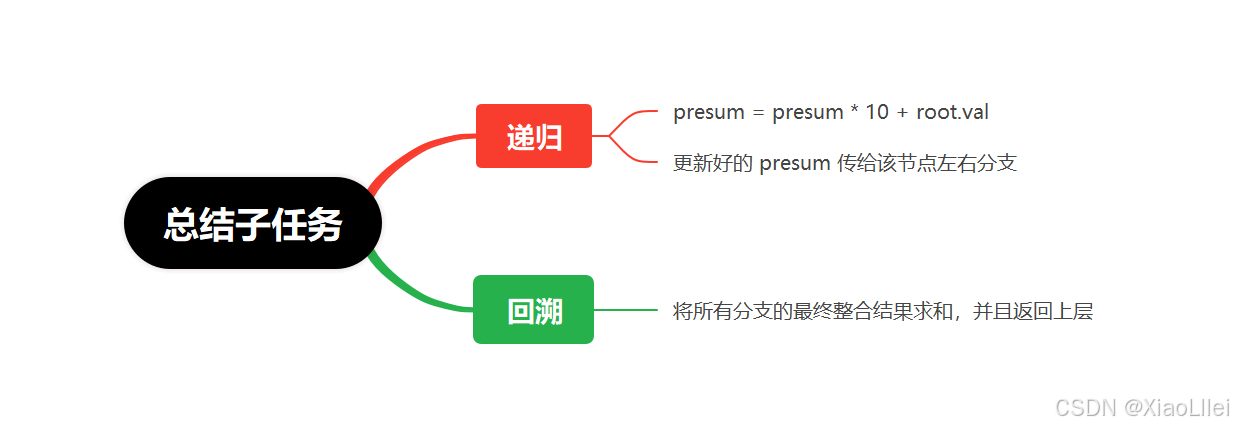
总结子任务
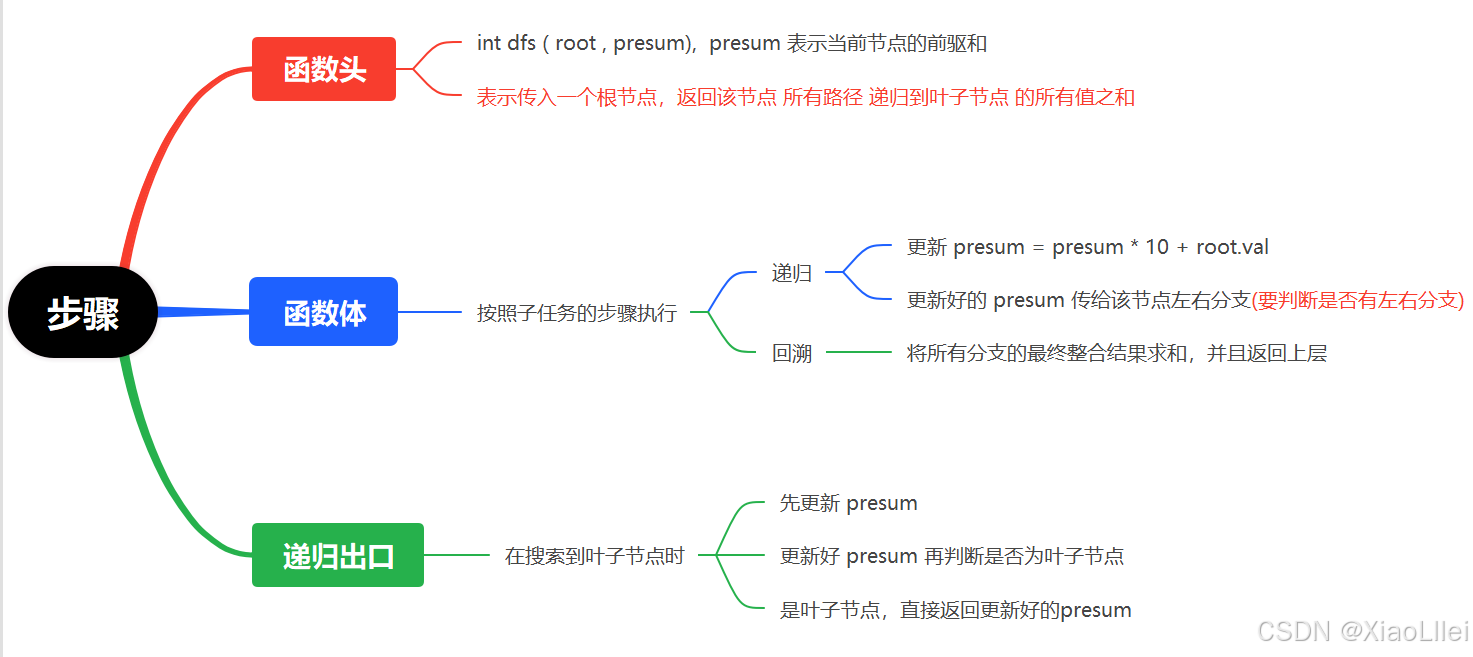
步骤总结
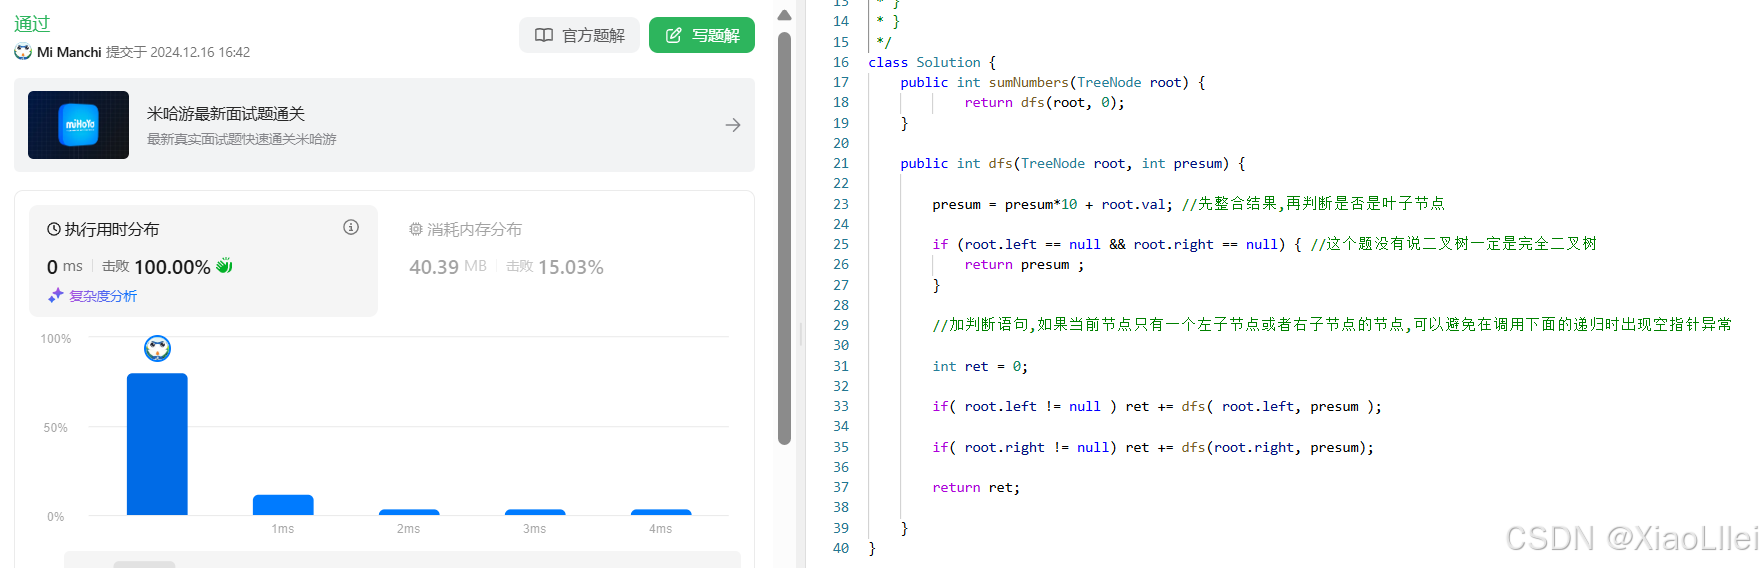
编写代码
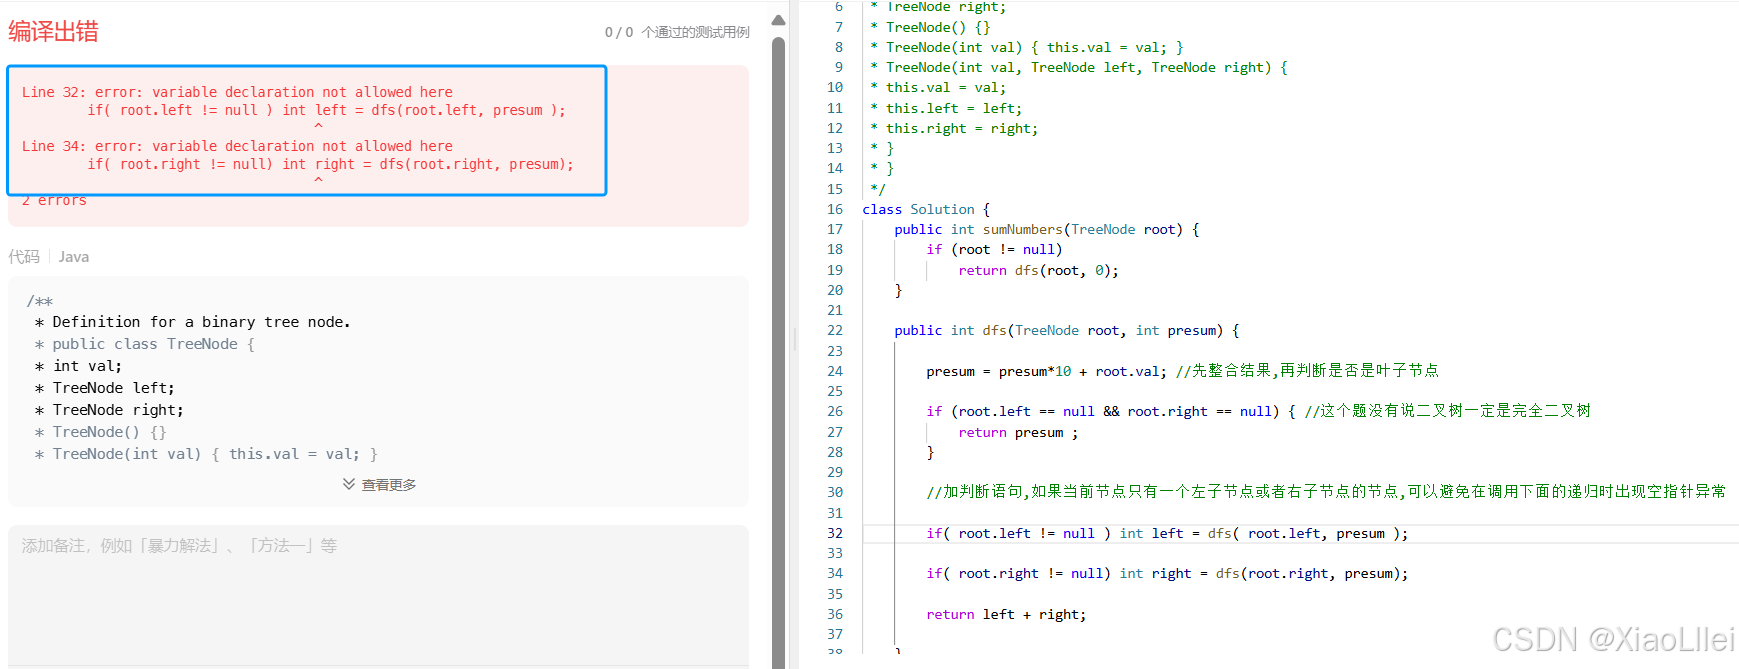 注意 : 判断语句后面不能定义新变量
二叉树剪枝
题目解析
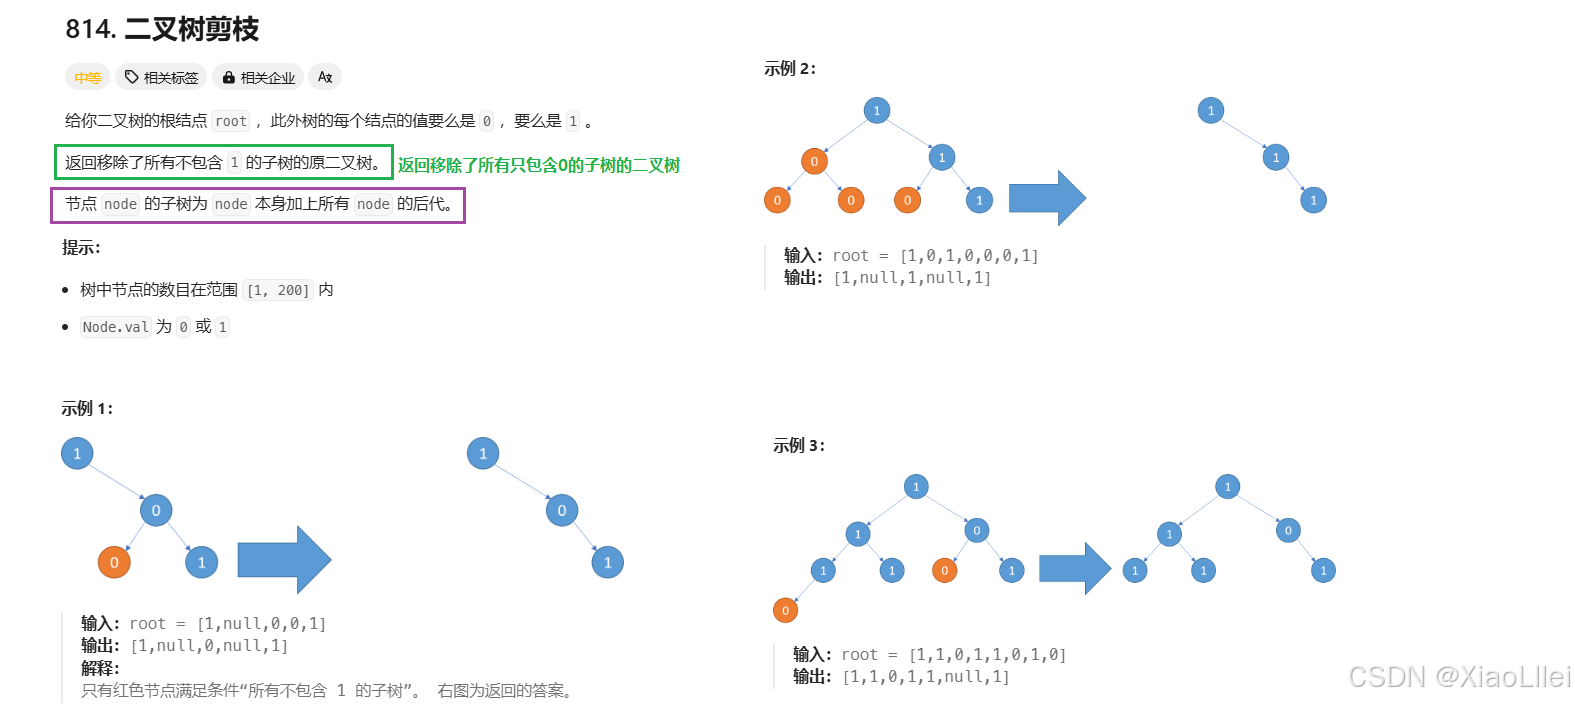
注意: 并不是节点值为0就要移除, 而是节点所在的子树节点全部为0, 才需要移除 ;
算法原理
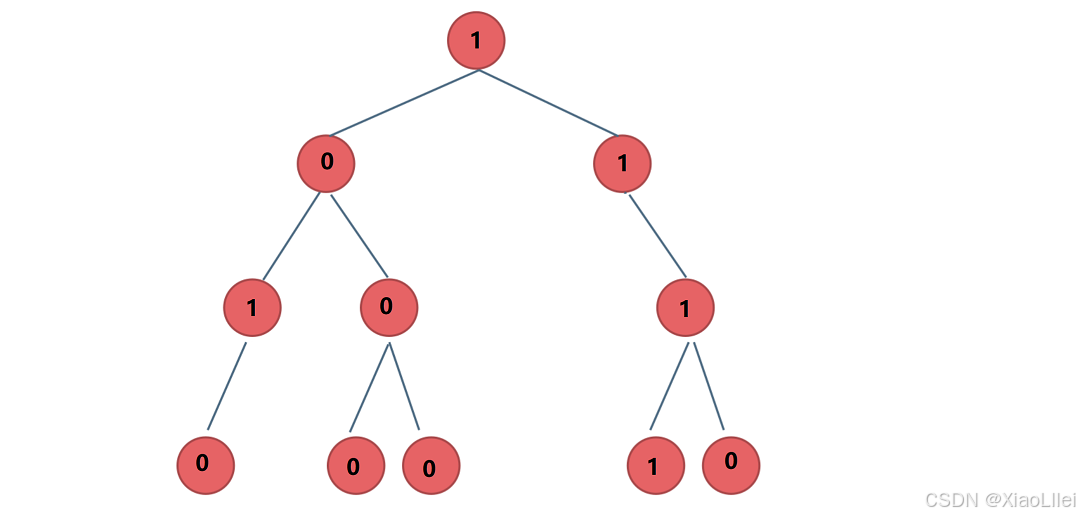
我们以下面的这棵二叉树为例 :
解法: 通过决策树抽象出递归的三个核心问题
通过二叉树剪枝这个任务 , 完成关于函数头, 函数体, 递归出口的设计;之前我们说过,要想设计这三个功能,需要找出递归的子问题;但是有些题特别难,是很难总结子问题会做什么事情,进而无法定义函数头;
模拟决策树过程
先说结论:本题函数头,是给 dfs() 一个头指针,把该头指针所在的子树中,所有只包含 0 的子树移除,移除完后,返回一个新的头指针;
但是有一些问题特别抽象的时候,是很难总结出子问题的,递归要完成的任务会非常多;此时,我们需要根据递归的过程,来总结出函数头需要什么参数,函数体要执行哪些逻辑,递归出口是什么;
也就是说,当递归问题非常抽象,很难总结出子问题时,我们不需要再关心要给 dfs() 布置什么任务,只需要搞清楚递归的逻辑,来总结出函数体,函数体,和递归出口即可;
对于本题,我们关心的问题是,是否需要剪枝,如下面二叉树的这个节点:
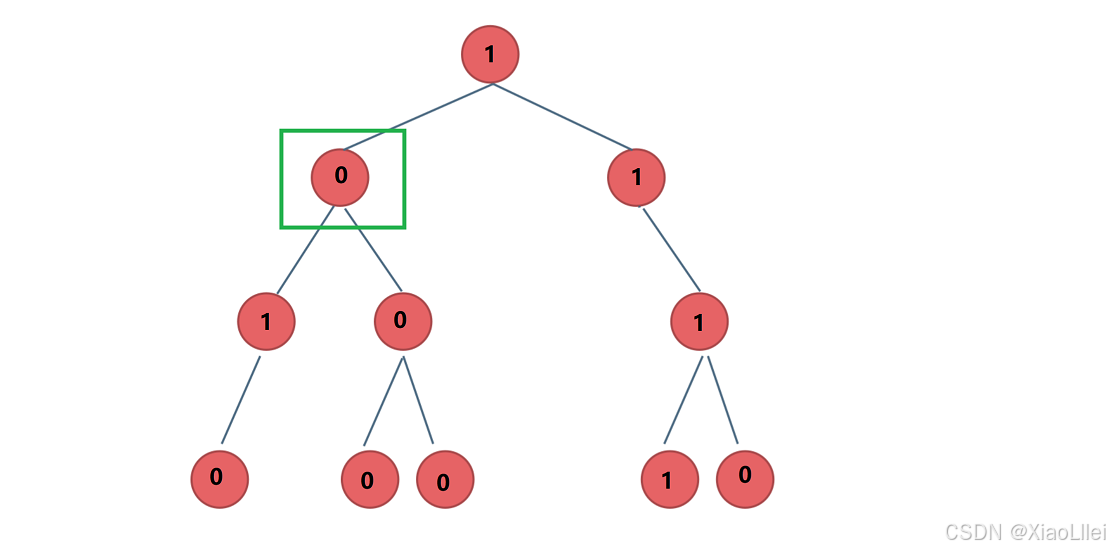
这个节点所在子树是否要被剪掉,我们就需要先知道左右子树的信息,只有左右子树节点全部为0,我们才可以剪掉这个节点所在的子树;
所以本题必须是后续遍历,因为只有后续遍历,才有能力在返回某个节点时,携带该节点左右子树的信息;
如果我们遍历到叶子节点,如果这个叶子节点的值为0,可以先剪去这个叶子节点,并且返回到上一层:
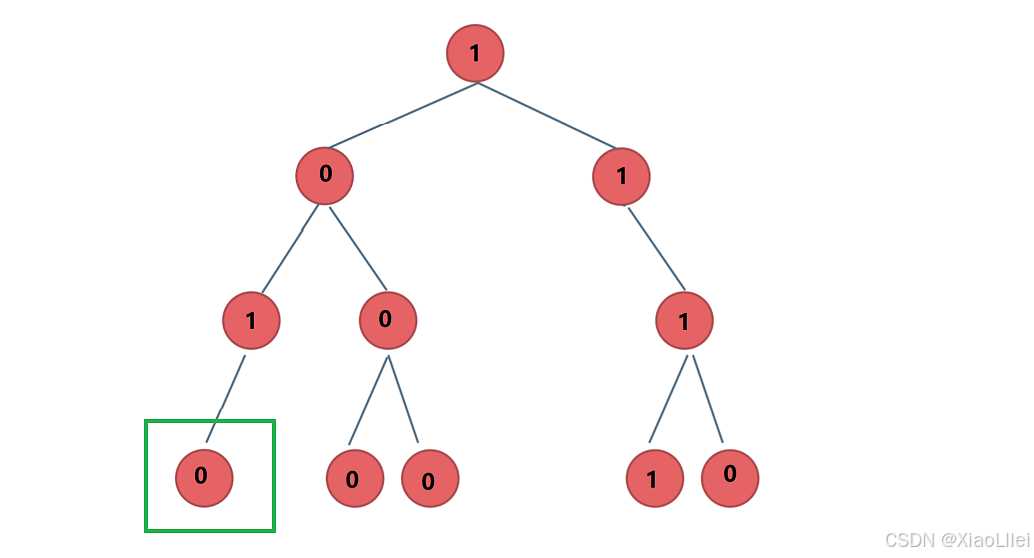
叶子节点被剪除,那么这个节点的父亲节点对应的 left / right 要被置为 null:
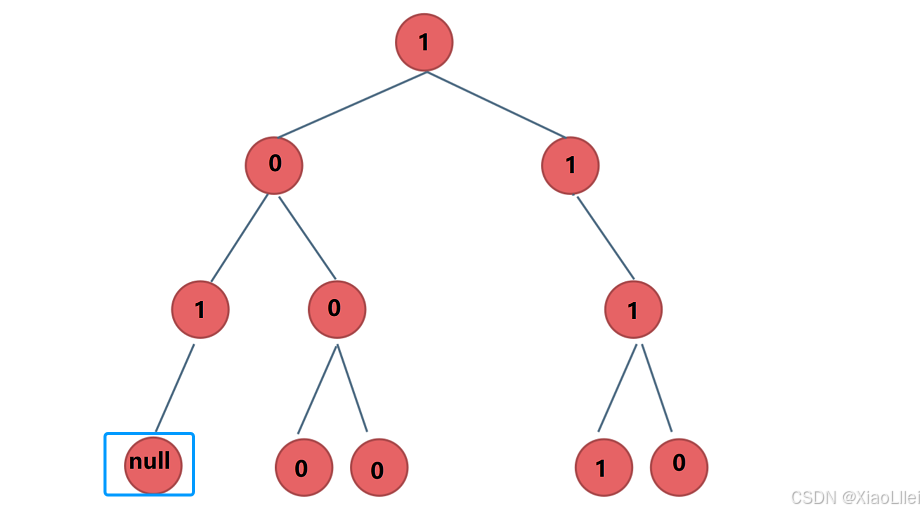 那么怎么才可以把这个叶子节点置为 null 呢?我们只需要在回溯到父亲节点时,return null 即可;在父亲节点接收到 null 后,把对应的 root.left / root.right 置为 null 即可;
所以我们设置的函数体,是一定需要接收返回值的,根据决策树模拟递归过程,来设置出我们的函数头;
此时,下图的节点变成这个分支的叶子节点,但是值为1,所以是不需要剪枝的:
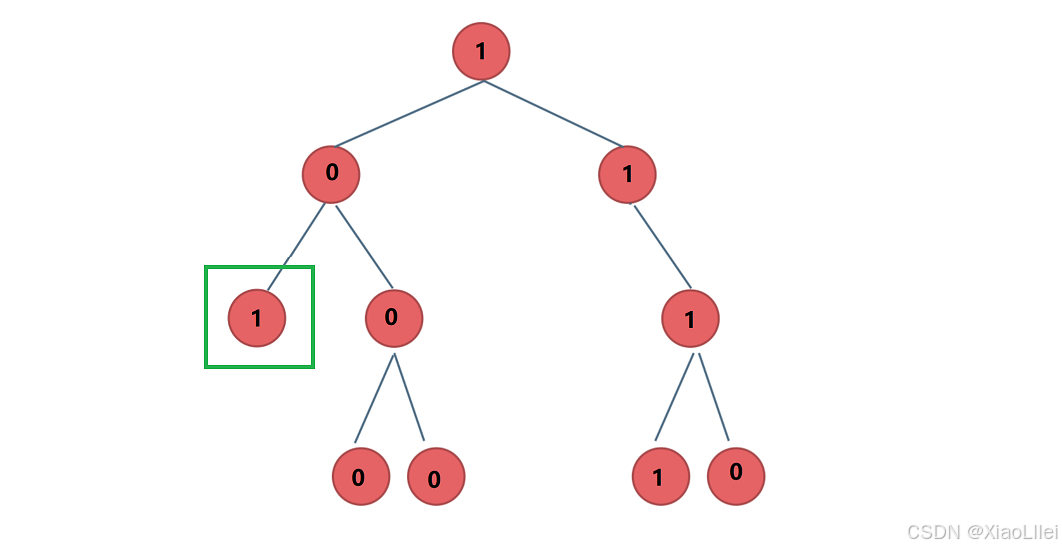
那么这个节点向上返回给父亲节点时,直接 return root 即可,相当于没有进行剪枝操作;
当我们在决策的时候,向上返回时,在别的位置要统一这个操作,因为递归问题的每一层要执行的操作是相同的;
在模拟上述的递归过程之后,我们就可以设计出函数头 dfs( root ),参数只有一个 root ,传入 root 之后,我们遍历一下 root 的左右子树,左右子树遍历完成后,会分别返回返回值,我们根据这两个返回值,可以判断当前节点是否需要删除;
通过决策树模拟过程总结步骤
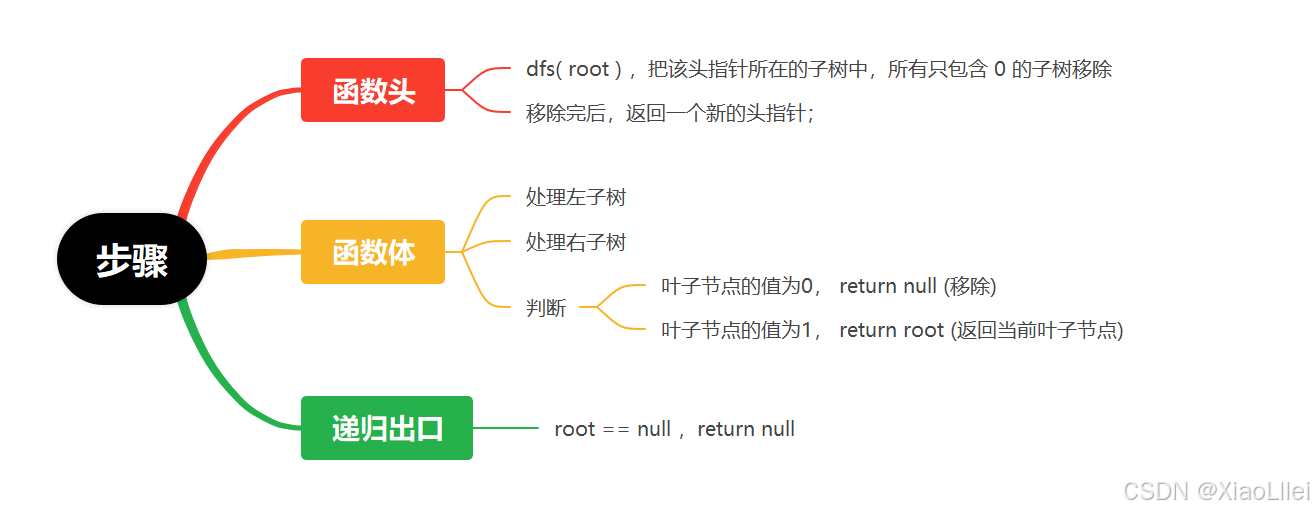
编写代码
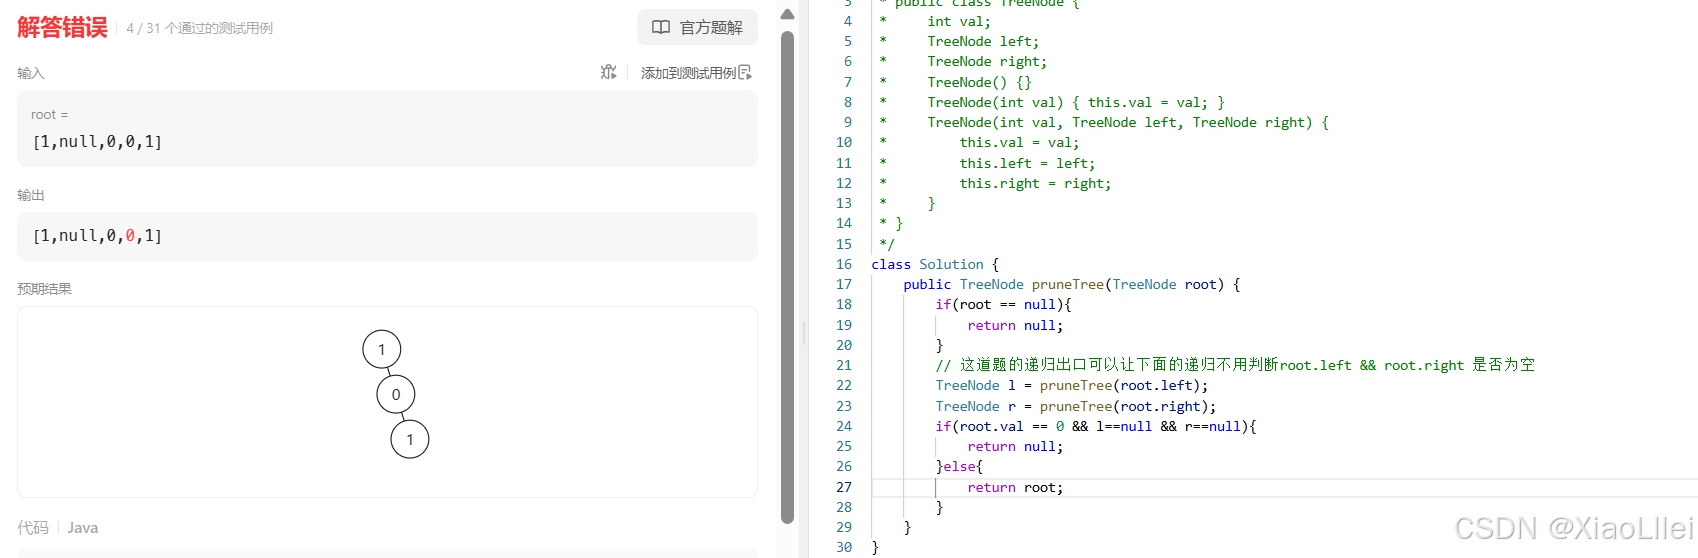
报错原因:只是接收递归的返回值,以返回值和 root.val 判断是否需要剪枝,但是其实并没有剪枝 ,也就是说,没有把要移除的节点置为 null,只是接收了一下返回值;
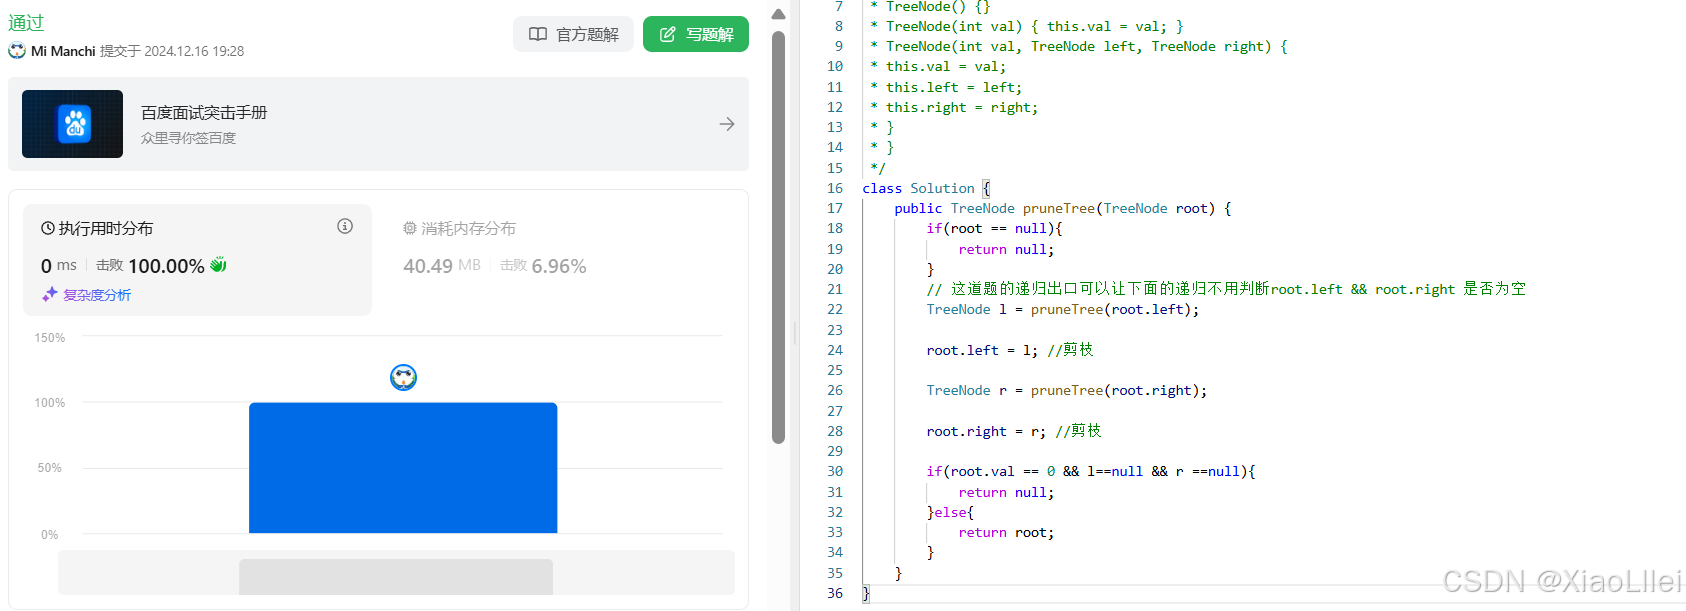
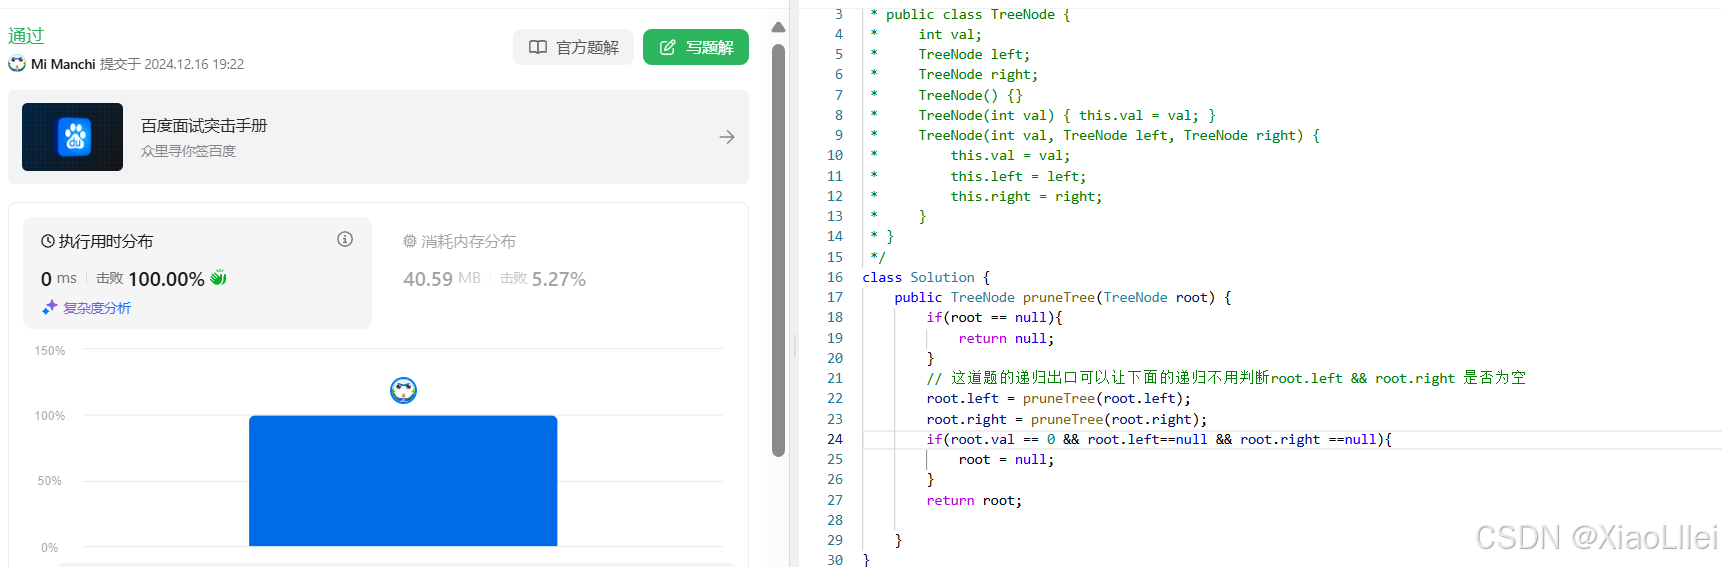
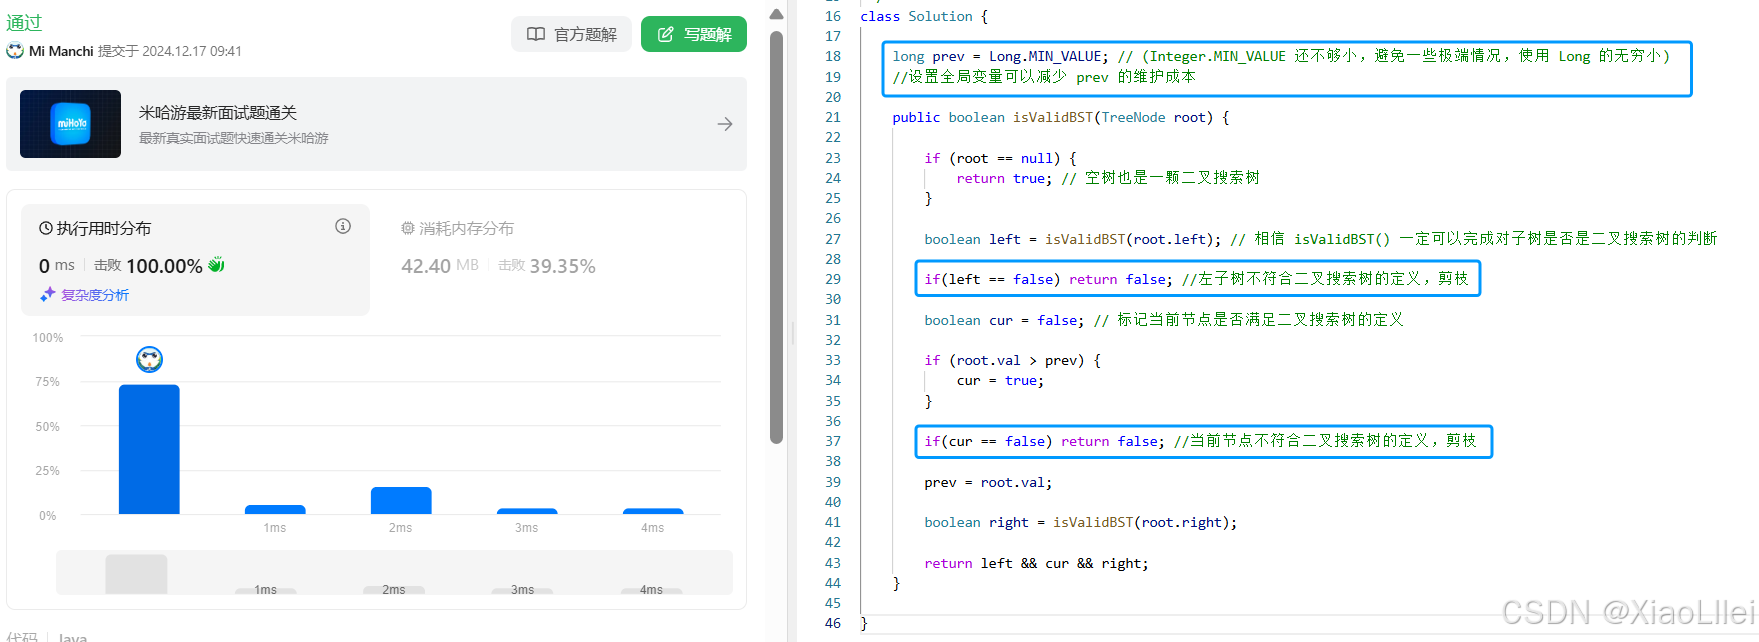
验证二叉搜索树
题目解析
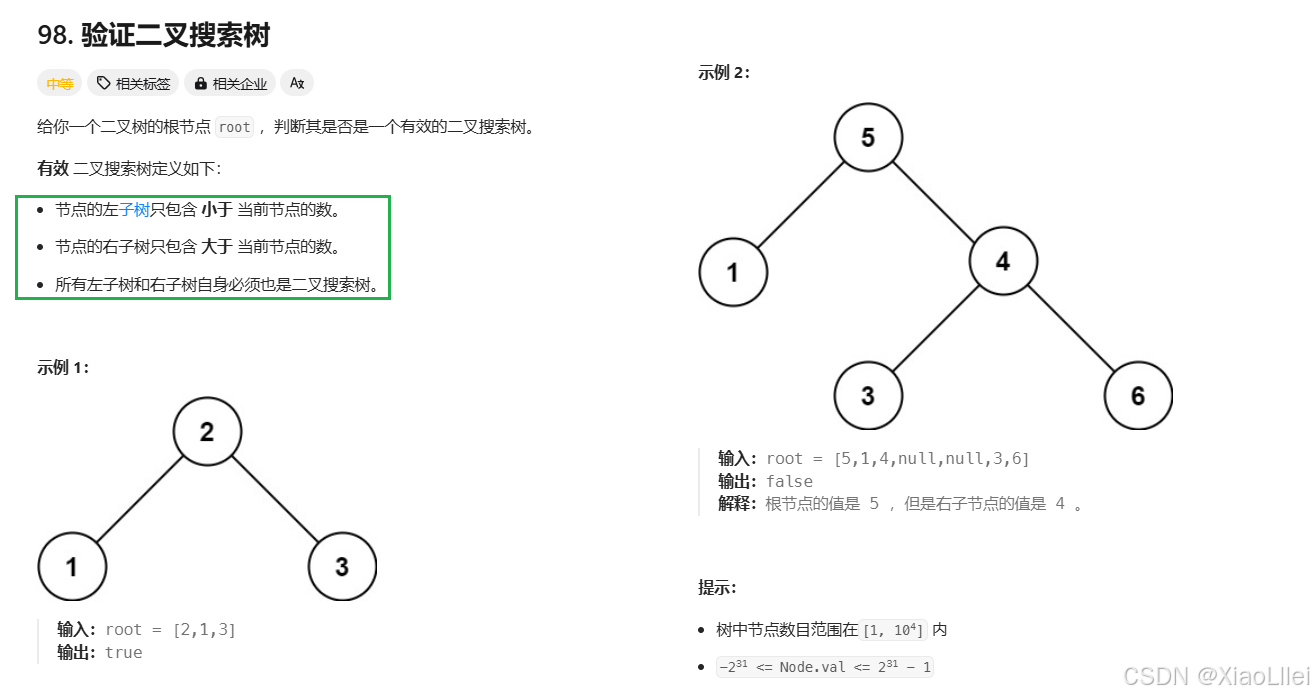
对于下面这棵二叉树,就不是二叉搜索树
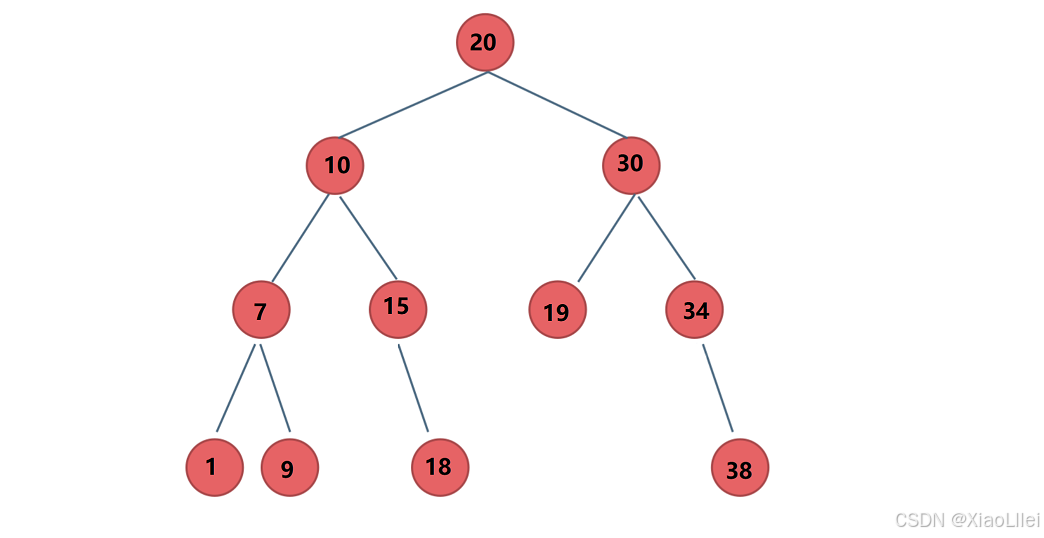
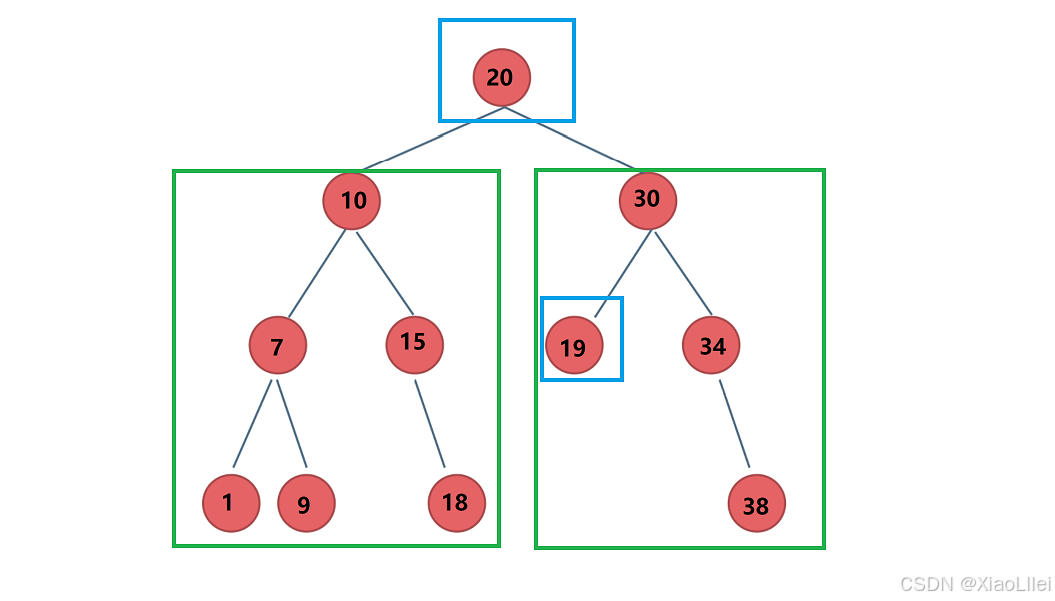
虽然根节点的左右子树都是二叉搜索树,但是在右子树中有一个节点的值比根节点小,所有就不是一棵二叉搜索树:
算法原理
解法: 二叉搜索树的中序遍历结果是一个有序序列
设置全局变量的优势
根据二叉搜索树的中序遍历是一个有序序列这个结论,我们可以创建一个数组,将中序遍历结果填入数组中,在验证数组是否有序即可;
但是这个操作因为要存每一个节点,所以空间开销是非常大的,但是我们可以根据这个原理来解决问题,也就是验证这棵树中序遍历是否有序;
我们设置一个全局变量 prev,初始化 prev 为负无穷,这个全局变量的意思是,在中序遍历二叉树的某一个节点时,这个前驱是多少;比如下面10节点的 prev 为 9节点;
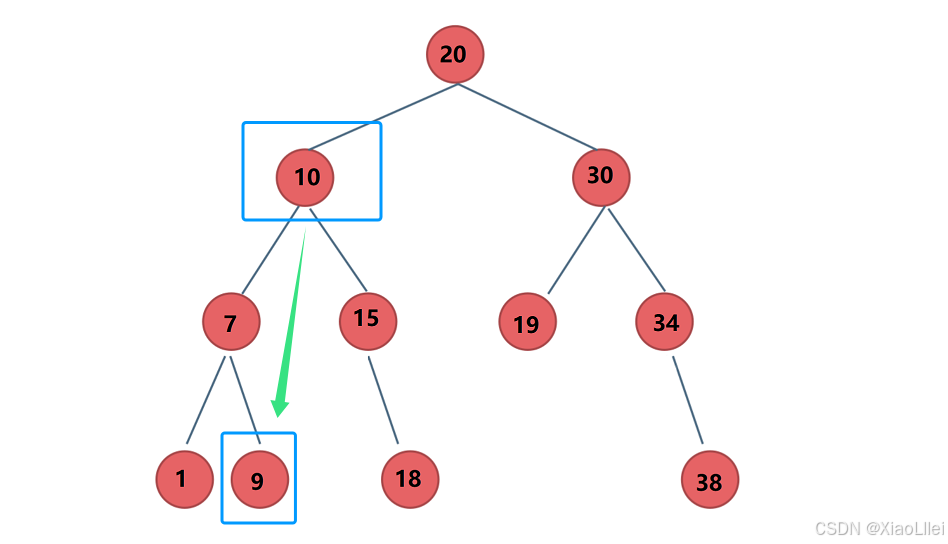
我们就可以拿 root.val 和 prev 进行比较;那么把 prev 设置成全局变量的优势是什么呢?一会编写代码的时候就可以发现,设置的参数和返回值都以为 prev 是全局变量而非常好设置;
处理细节问题
问: 为什么Java等语言要用 long 类型?题目不是只有 int 类型吗?
答: 虽然题目是 int 类型,但开始递归的时候,left 需要比所有节点值都要小,right需要
比所有节点值都要大,如果节点值刚好是 int 的最小值/最大值,就没有这样的 left 和 right
了,所以需要用long 类型。
剪枝
我们在进行判断是否为二叉搜索树时,有两个策略:
策略一
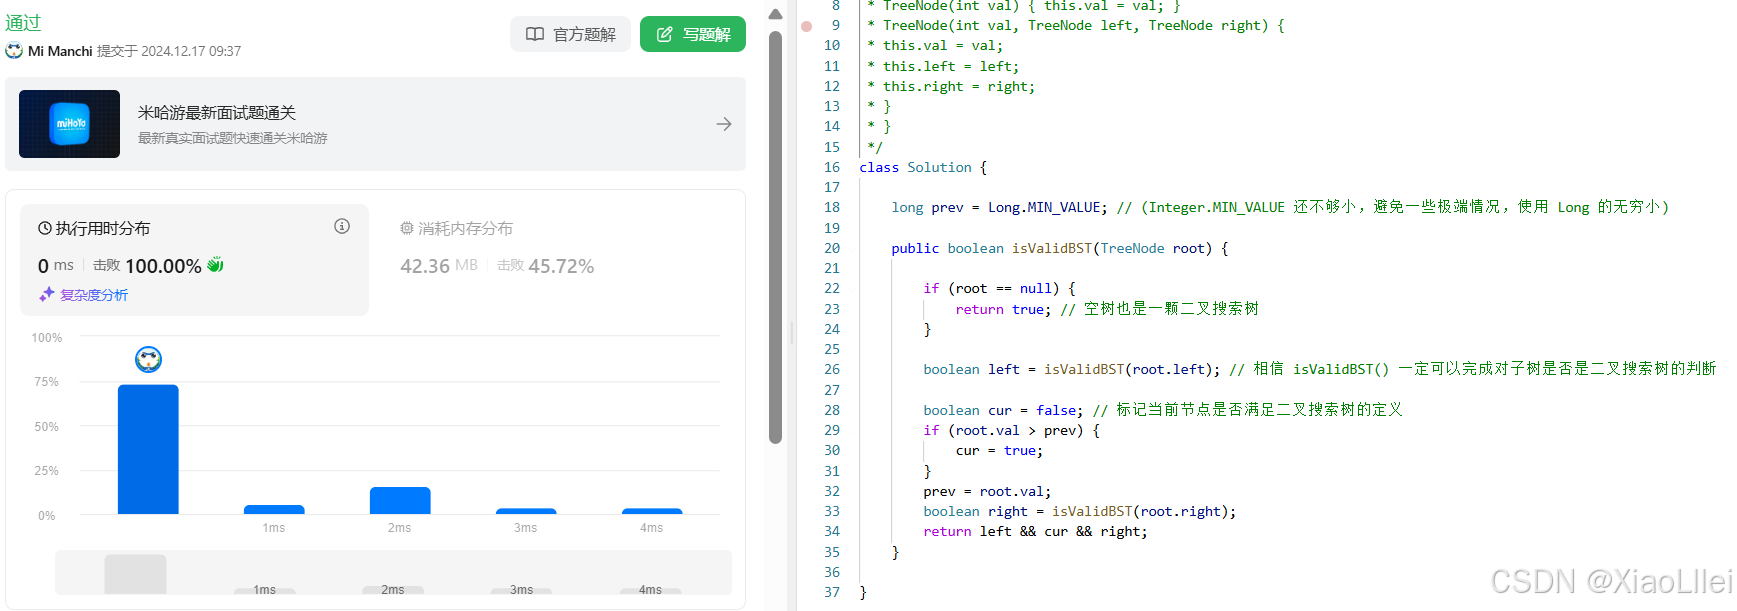
左子树是二叉搜索树,当前节点符合二叉搜索树的定义,右子树也是二叉搜索树,那么这棵树就是二叉搜索树;
但是其实策略一有些麻烦:
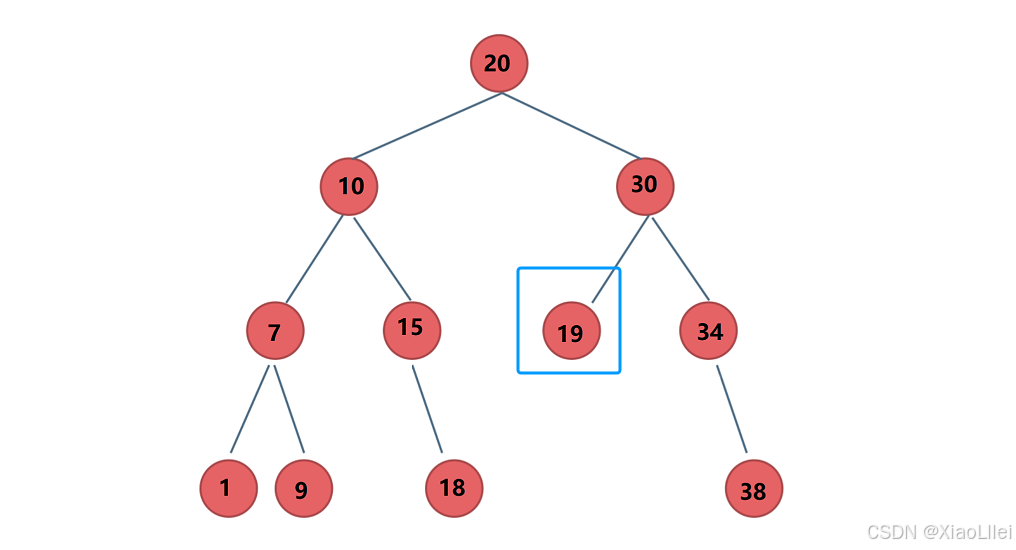
在遍历到19这个节点时,就已经能判断这一整棵树不是一棵二叉搜索树了,但是根据策略一,还是会递归 30 节点的右子树,这是完全没有必要的,因此我们引出策略二;
策略二
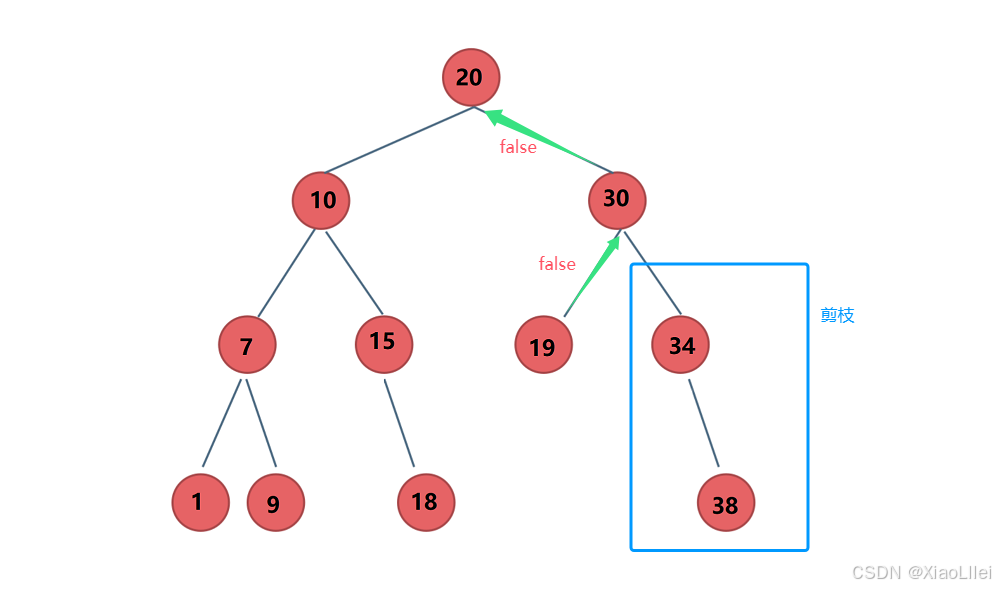
当遍历到不符合条件的节点时,直接停止中序遍历,一直向上返回 false:
如果图中剪枝的部分中,也就是30节点的右子树是一棵非常大的二叉树,那么通过剪枝可以大大减少递归次数,提高效率;
剪枝能够避免深度优先遍历一些没有意义的部分,加快搜索过程;
编写代码
策略一
策略二
二叉搜索树中第K小的元素
题目解析
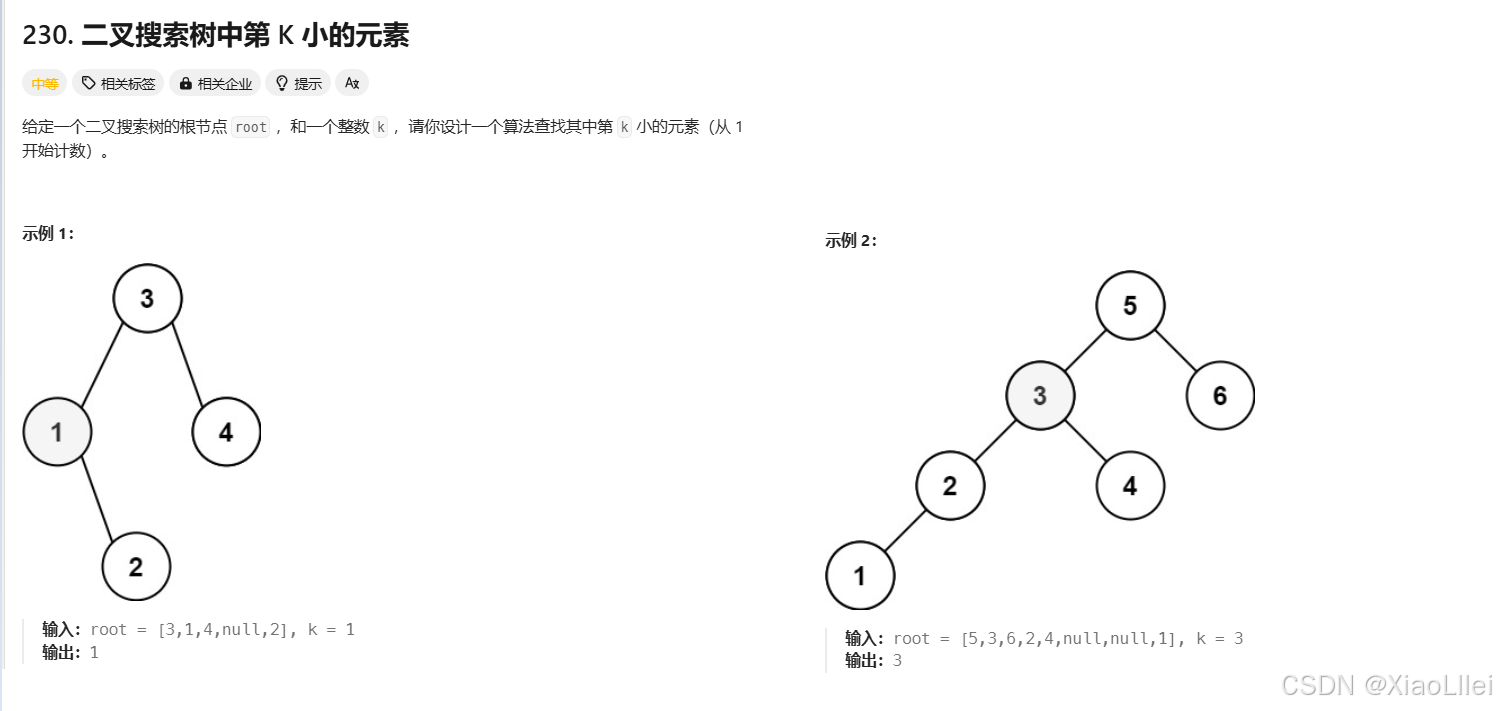
算法原理
解法: 定义两个全局变量 + 中序遍历结论
二叉搜索树中序遍历是一个有序的序列,因此我们可以设置一个全局变量用于计数,我们以如下二叉树进行演示:
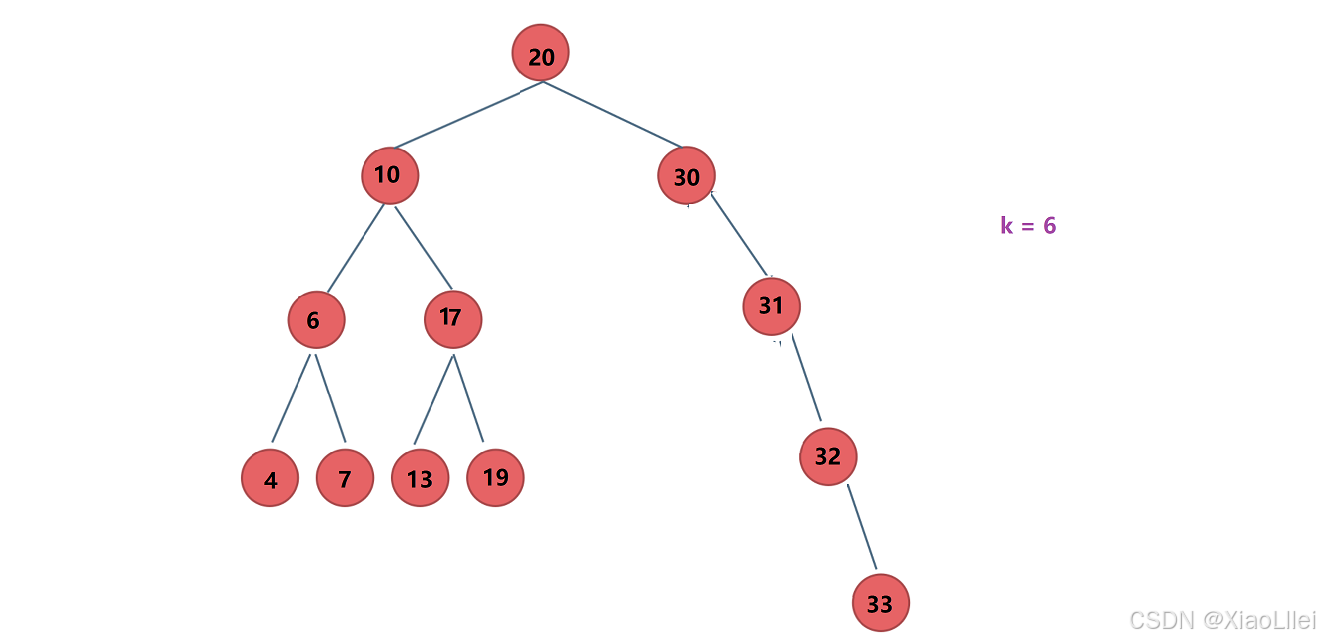
定义两个全局变量
int count = k ; //每中序遍历到一个节点,count--,count = 0,当前节点即为所求

int ret = 0 ; // 当 count = 0,ret 标记当前遍历节点的值
模拟过程
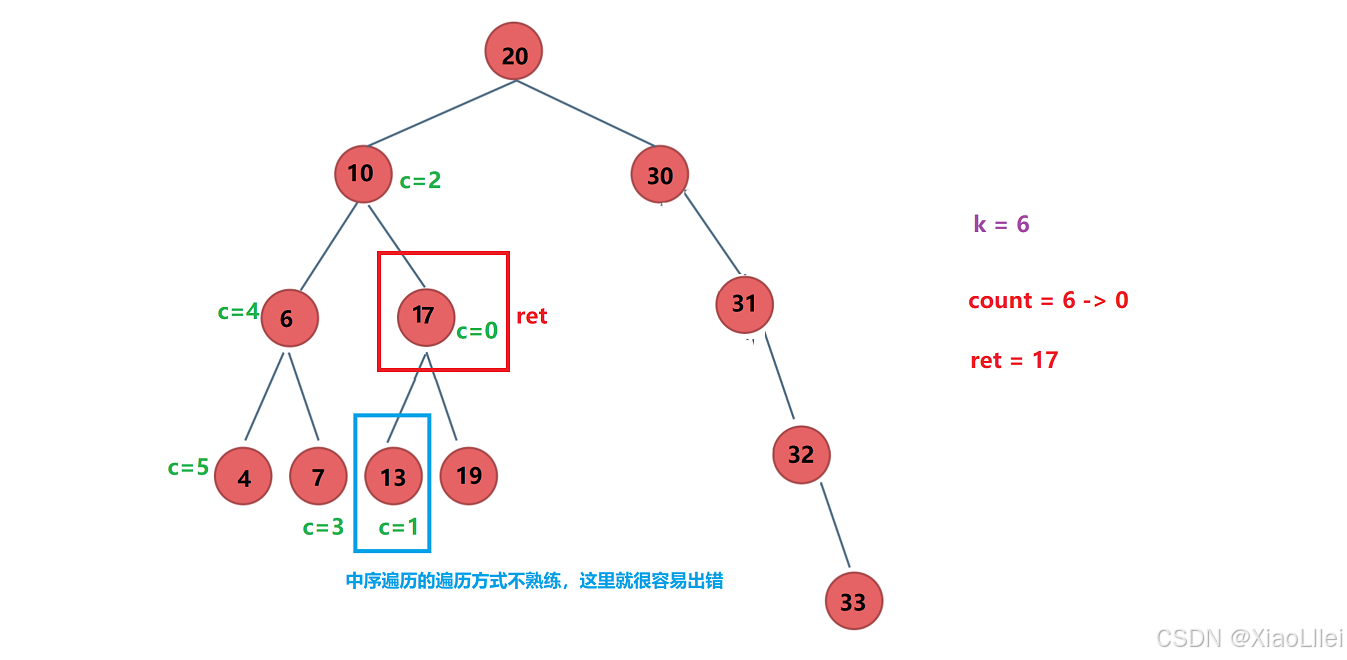
剪枝优化
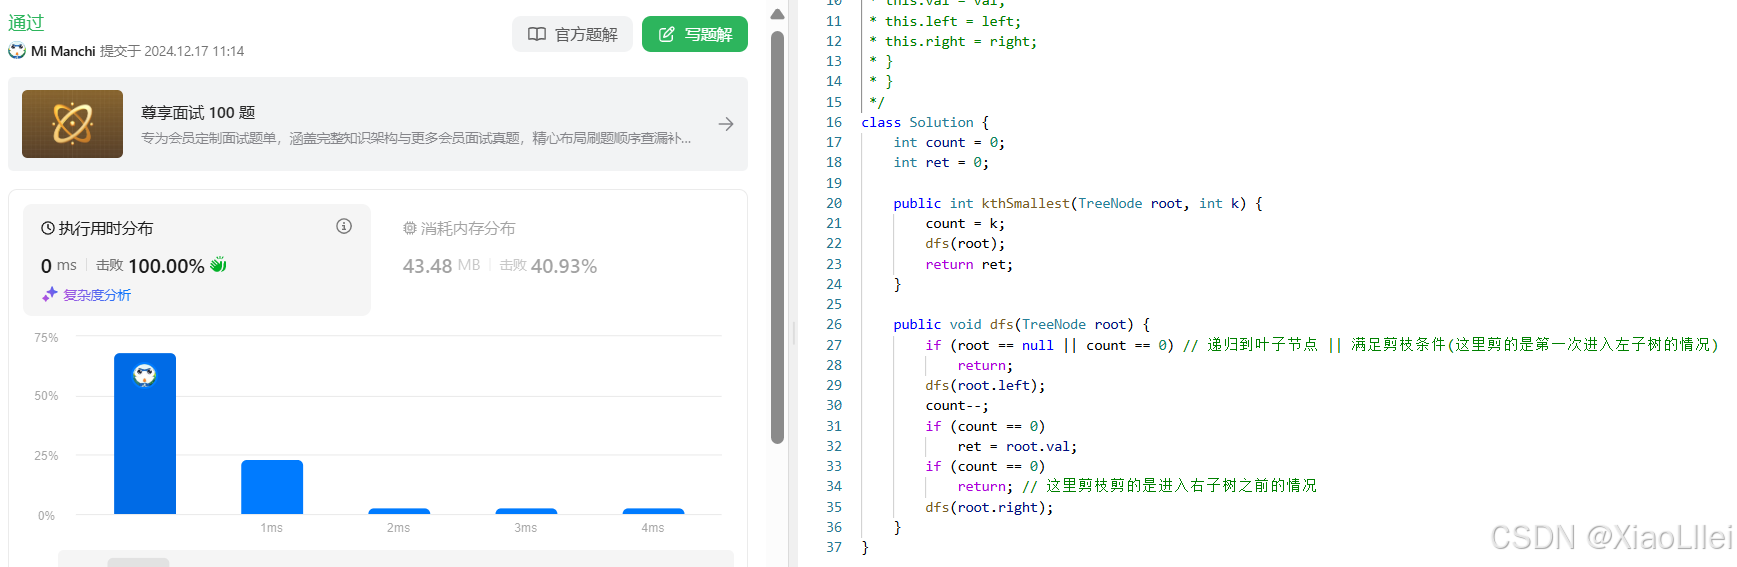
当 count = 0 时,后续的节点就不需要遍历了,我们需要进行剪枝操作; 剪枝操作可以设置在 dfs() 的最前面;
编写代码
收获
如果我们设置全局变量,就可以把中序遍历的过程封装成一个方法 dfs() ,dfs() 不用考虑返回值类型,只需要通过 dfs() 把 kthSmallest() 的返回值设置好即可;
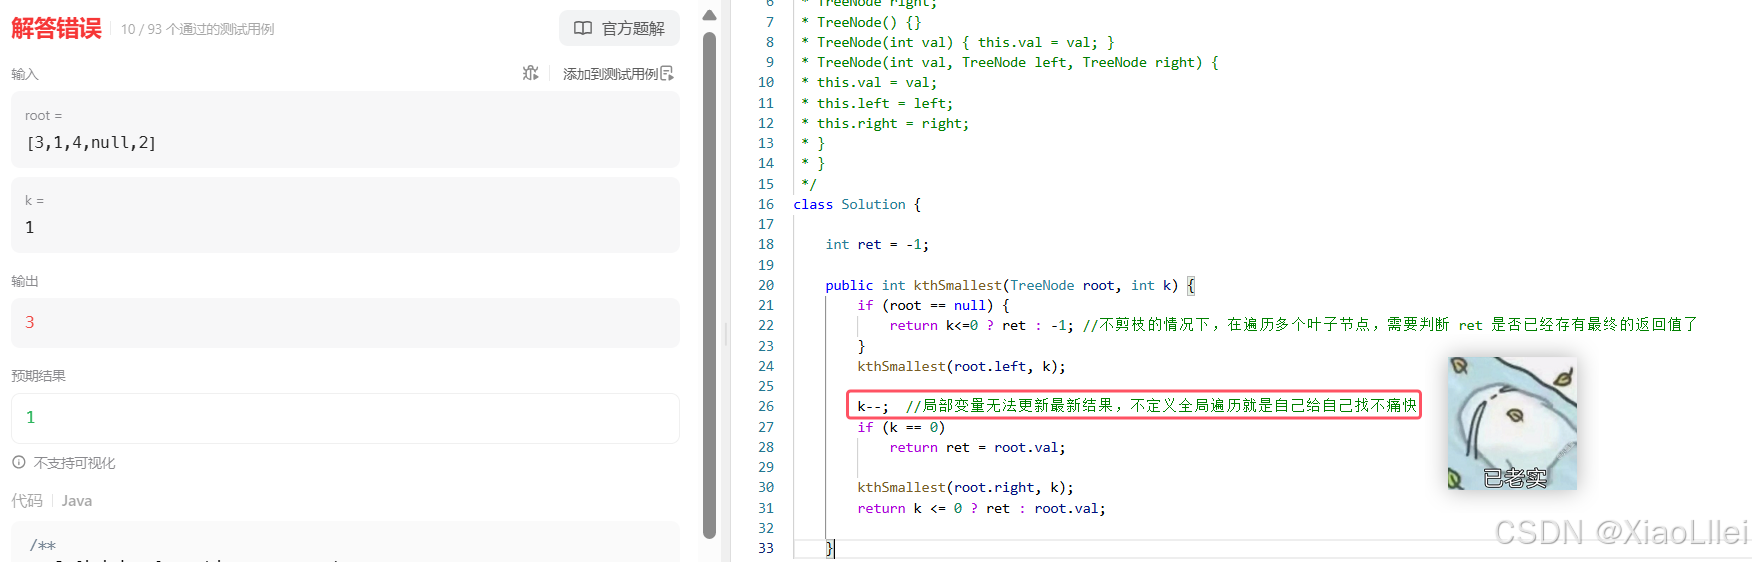
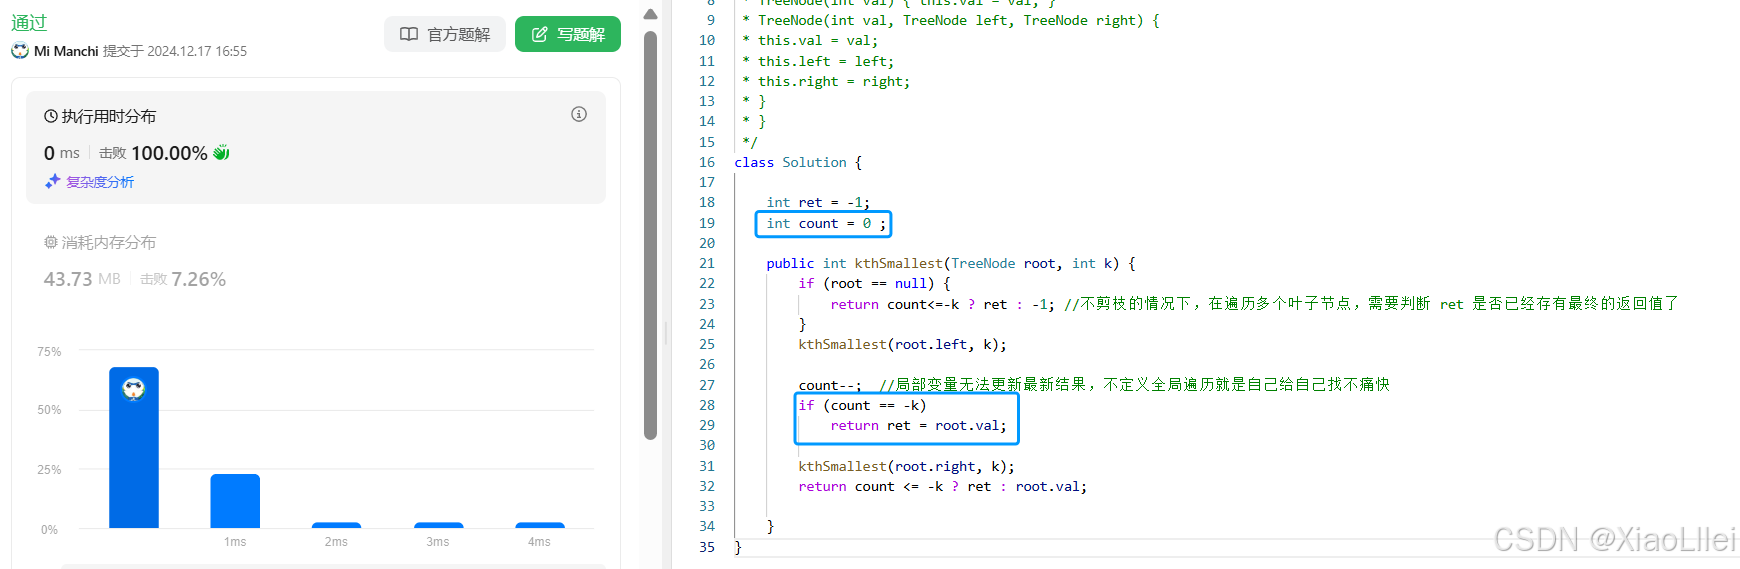
如果设置的是局部变量,则不能记录 k 最新的信息,函数在回溯时会恢复现场;
定义全局变量,就可以避免函数自动恢复现场:
可以看下一题的回溯部分,会详细讲恢复现场的概念;
可以在每次进行递归之前,先判断是否满足条件,满足了就直接返回,这样的做法就是剪枝,这道题是在递归左子树和右子树之前进行剪枝的;
二叉树的所有路径
题目解析
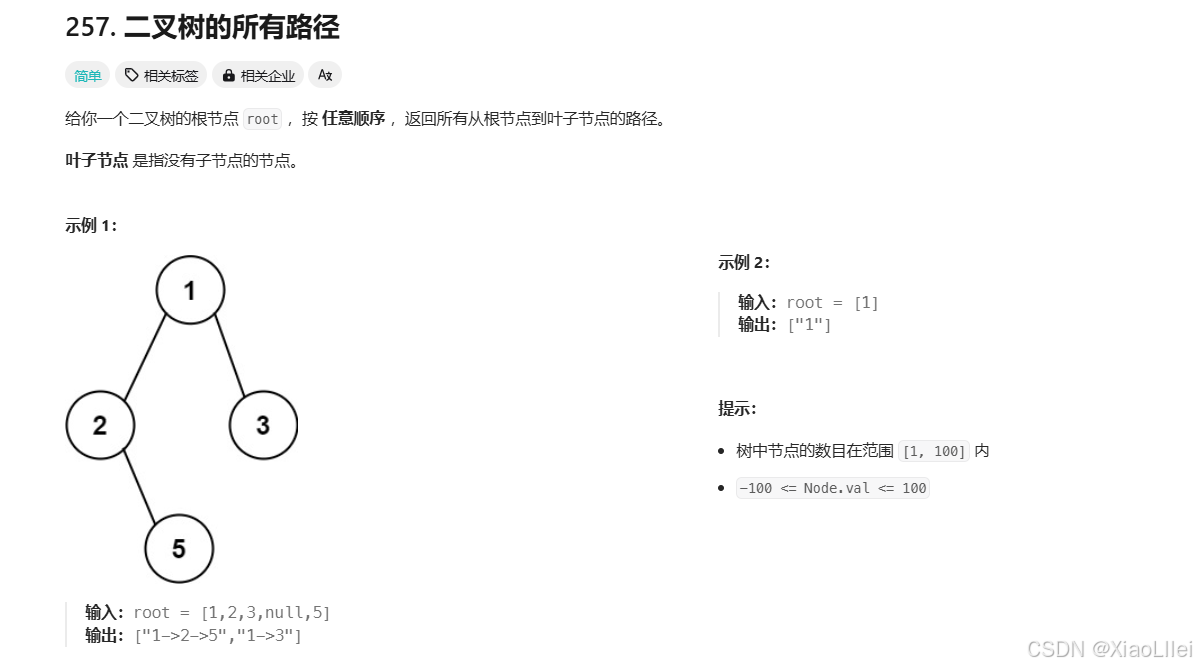
算法原理
开始的时候,会从根节点开始向下遍历,我们记录一下一个节点往下遍历的所有分支路径;到叶子节点时表示找到了一条完整路径,拿一个字符串来存一下该路径
解法: 前序遍历 + 回溯
定义两个全局变量
String[] ret = null ;

// 遍历完一条路径,就把该路径转换成字符申,并且放入字符串数组中

String path = null ;

// 表示路径,当我们在深度遍历的时候,记录一下路径;
当遍历到一个新节点时,把[ root.val +"->" ]中括号里的内容加入path 中
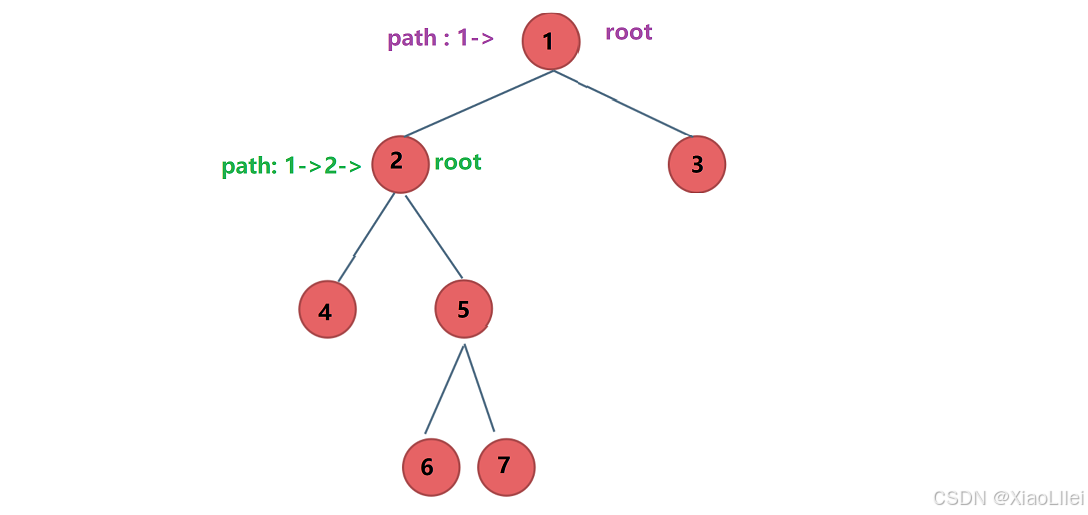
在遍历到叶子节点的时候,把[ root.val ] 加入到 path 中,然后把 path 加入到 ret 中:
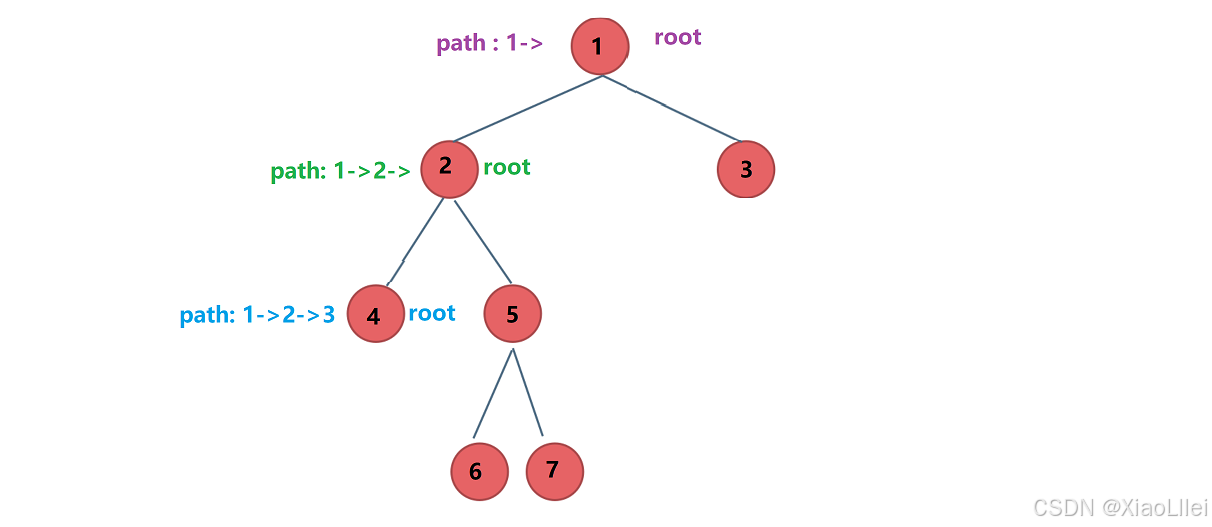
回溯 :恢复现场
回溯的处理非常重要,我们以下面这棵二叉树的其中一条路径来解释问题:
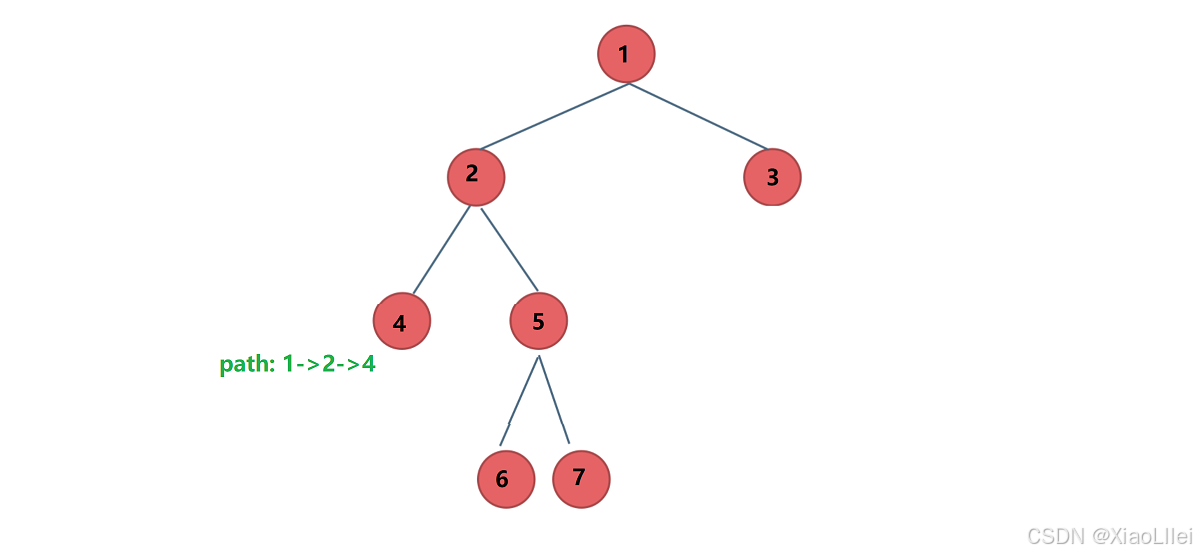
在回溯到2节点时,路径已经是 1->2->4 了,但是我们还需要递归右子树,此时 path 作为全局变量传给右子树继续递归就会出问题,因为传的 path 是不能有 4 的;因此,在回溯的时候,我们需要恢复现场;
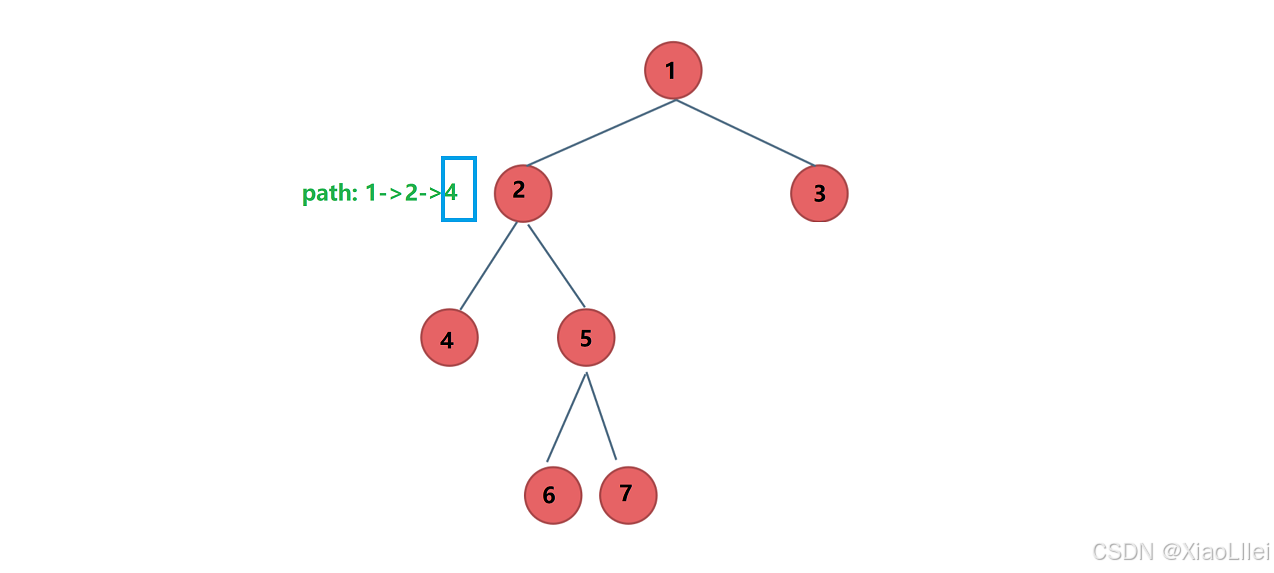
在我们深度优先遍历的时候,是会更改全局变量的,此时向上回溯,要把全局变量恢复到之前的样子,所以回溯这条路径,必须去掉4;
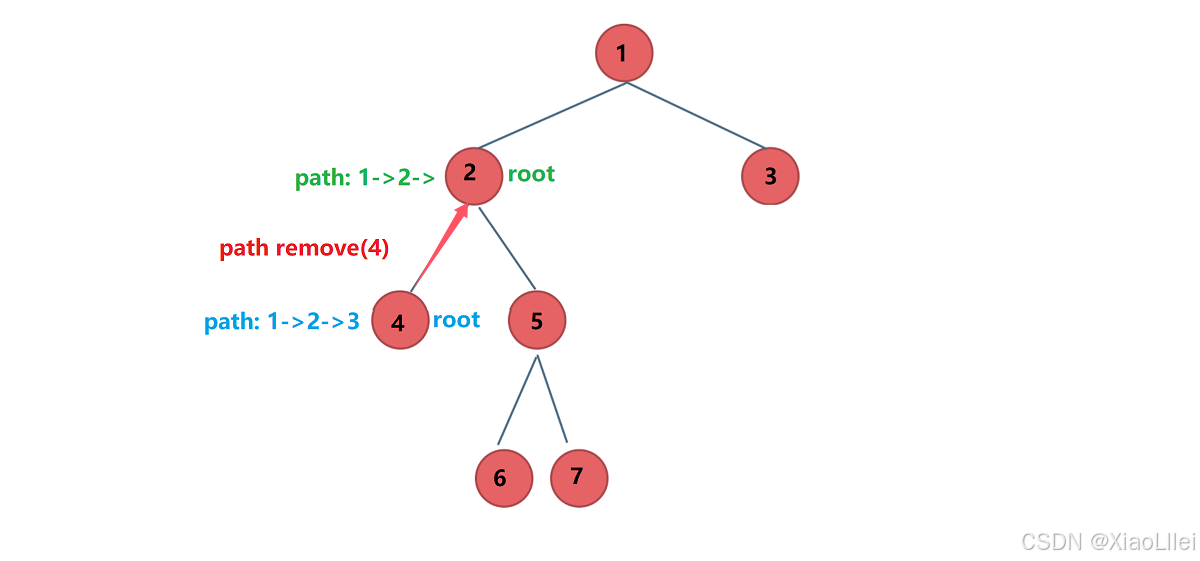
所以在向上回溯的时候,都需要对 path remove 一个 val,就是删除 path 最后一个数字,如果是字符串操作,会特别麻烦;
因为我们对字符串删减字符的操作非常复杂,并且回溯叶子节点和非叶子节点,要删除的字符是不同的:
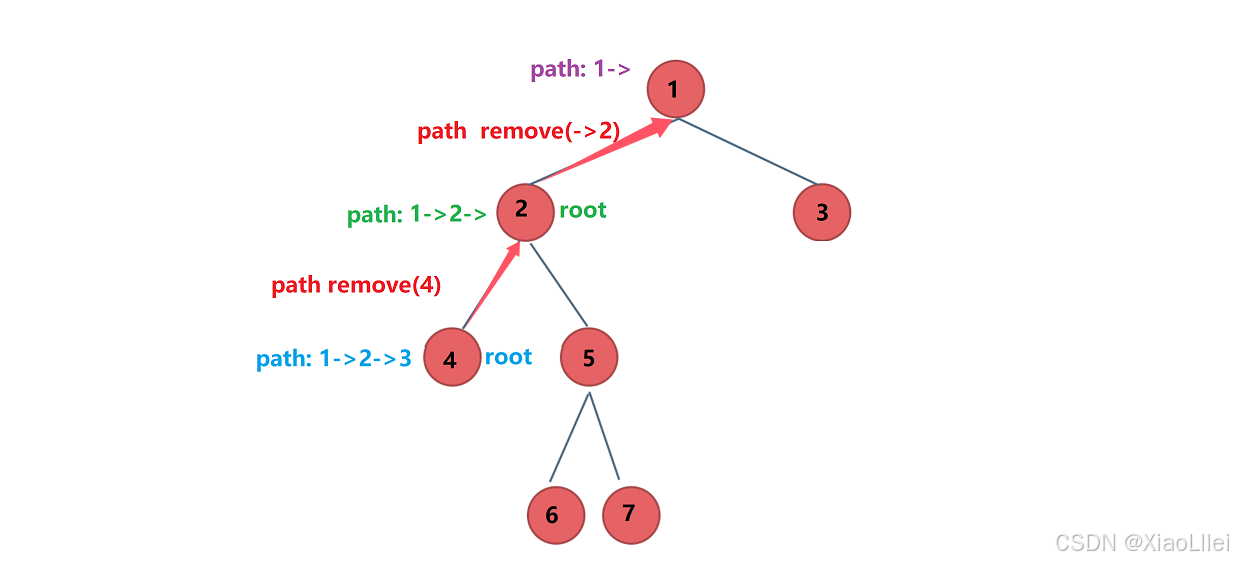
所以我们用全局变量 path 来记录路径,那么在恢复现场时,操作就会非常地复杂,所以这道题我们的 path 设置为局部变量;
但是这并不是说 path 设置为全局变量就没有意义了,而是这道题设置为全局变量不好用,但是对于大多数递归回溯的题,设置全局变量是优于局部变量的;
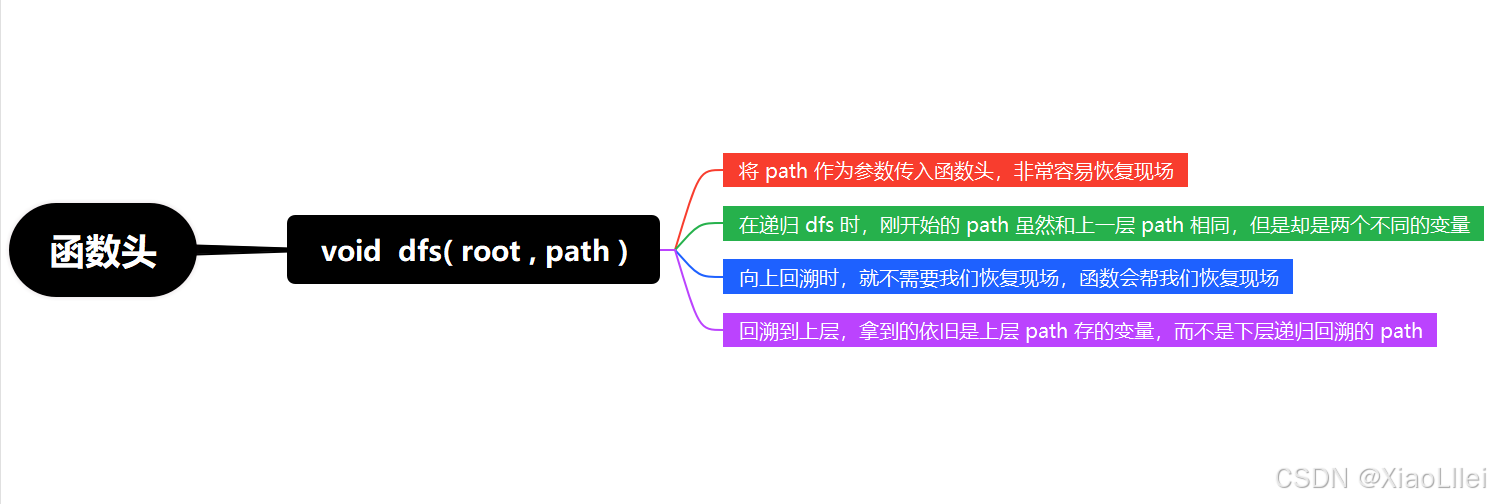
回溯总结
上面的叙述,重点强调了恢复现场的作用和必要性,在递归一条分支时,回溯到上层,就需要恢复现场,方便递归上层的另一条分支,这是站在 path 是全局变量的角度考虑的,但是如果path作为参数(局部变量),那么恢复现场就非常简单;
总结
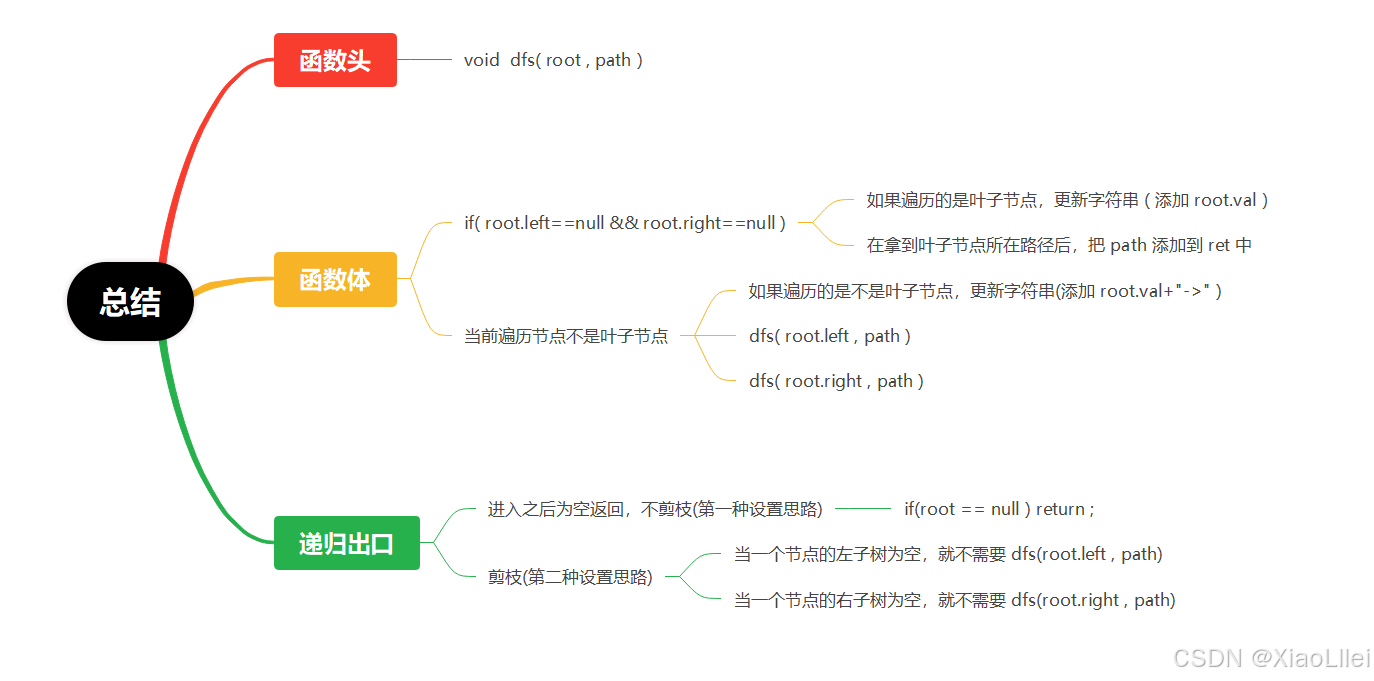
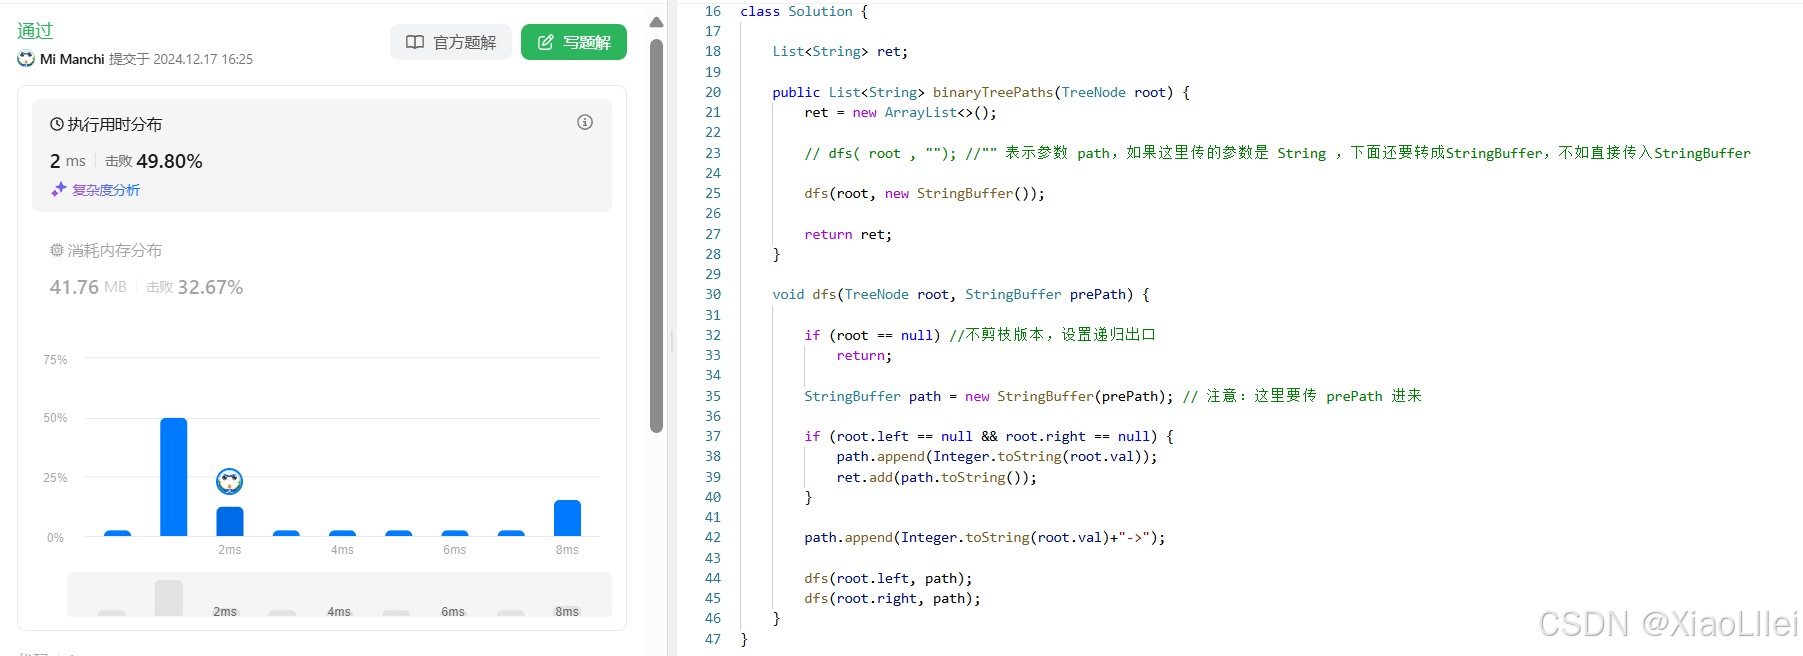
编写代码
剪枝版本
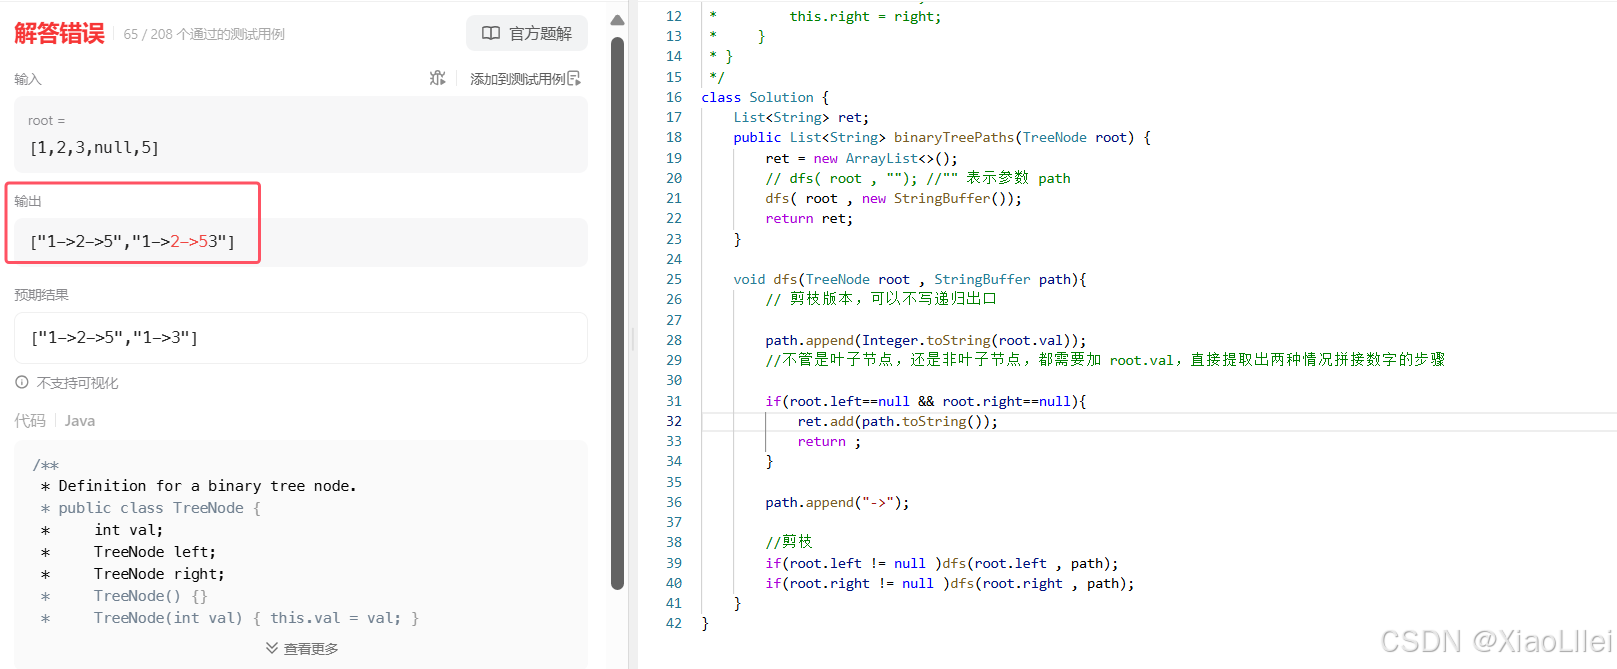
报错原因
没有恢复现场,在binaryTreePaths() 中直接对 dfs() 传 StringBuffer(),下面 dfs() 的参数 path 就相当于一个全局变量:
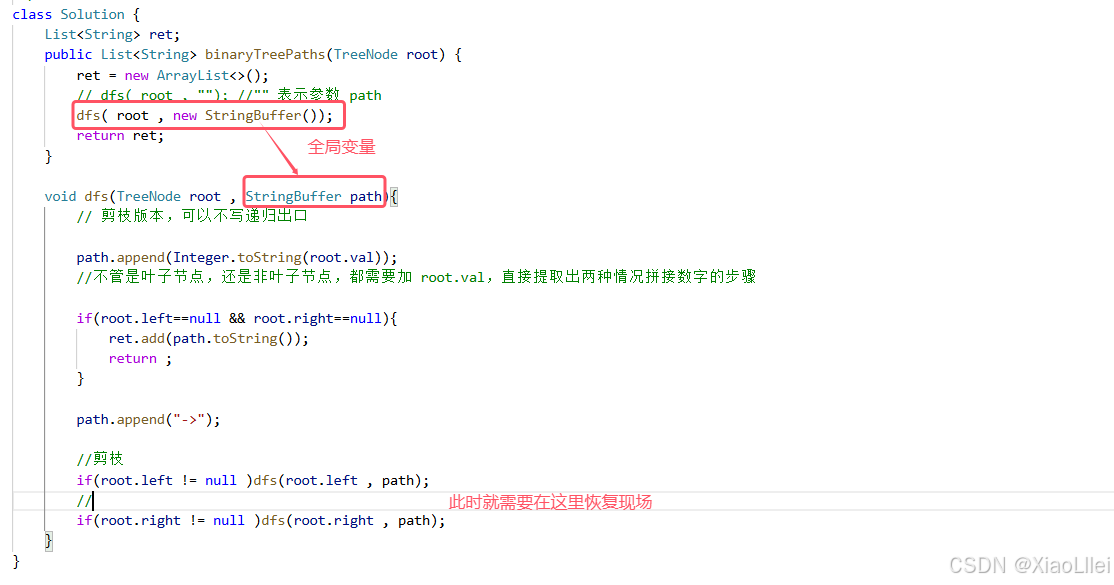
全局变量无法自动恢复现场,这也体现了在回溯时,恢复现场的必要性;
但是上面我们说过,可以通过传参的方式把 path 设置成局部变量,让函数帮我们恢复现场,那么任何操作呢?
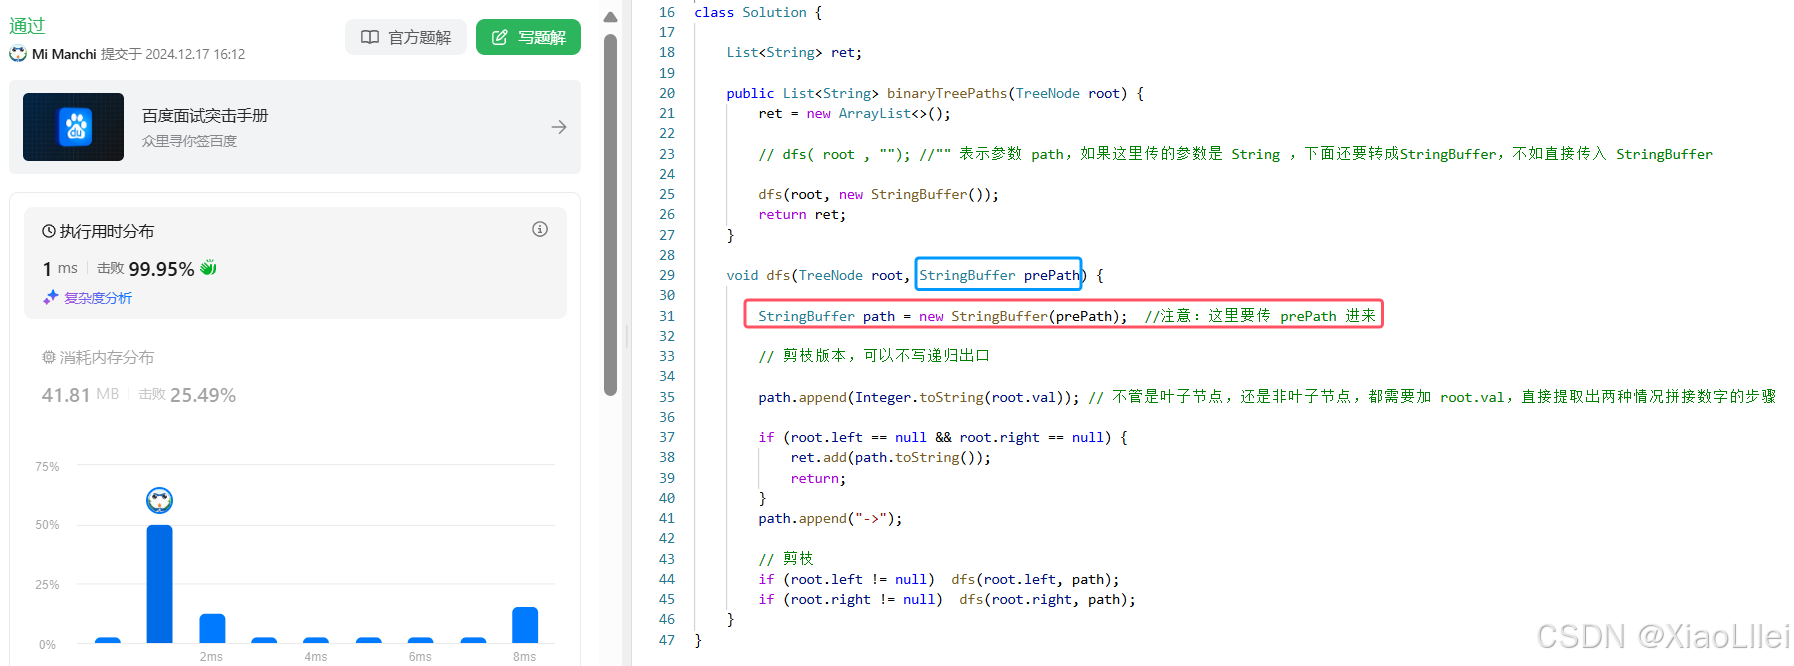
我们把 dfs 的参数设置成 prePath ,表示每次递归的上一层对应 path 路径,在 dfs 函数体内,重新实例化一个以 prePath 为基础的 StringBulder path;
在函数体内,所有操作都是针对在这一层递归新创建的 path,回溯到上一层时,操作的 path 会回到对应层创建的 path ,这就是恢复现场的作用;
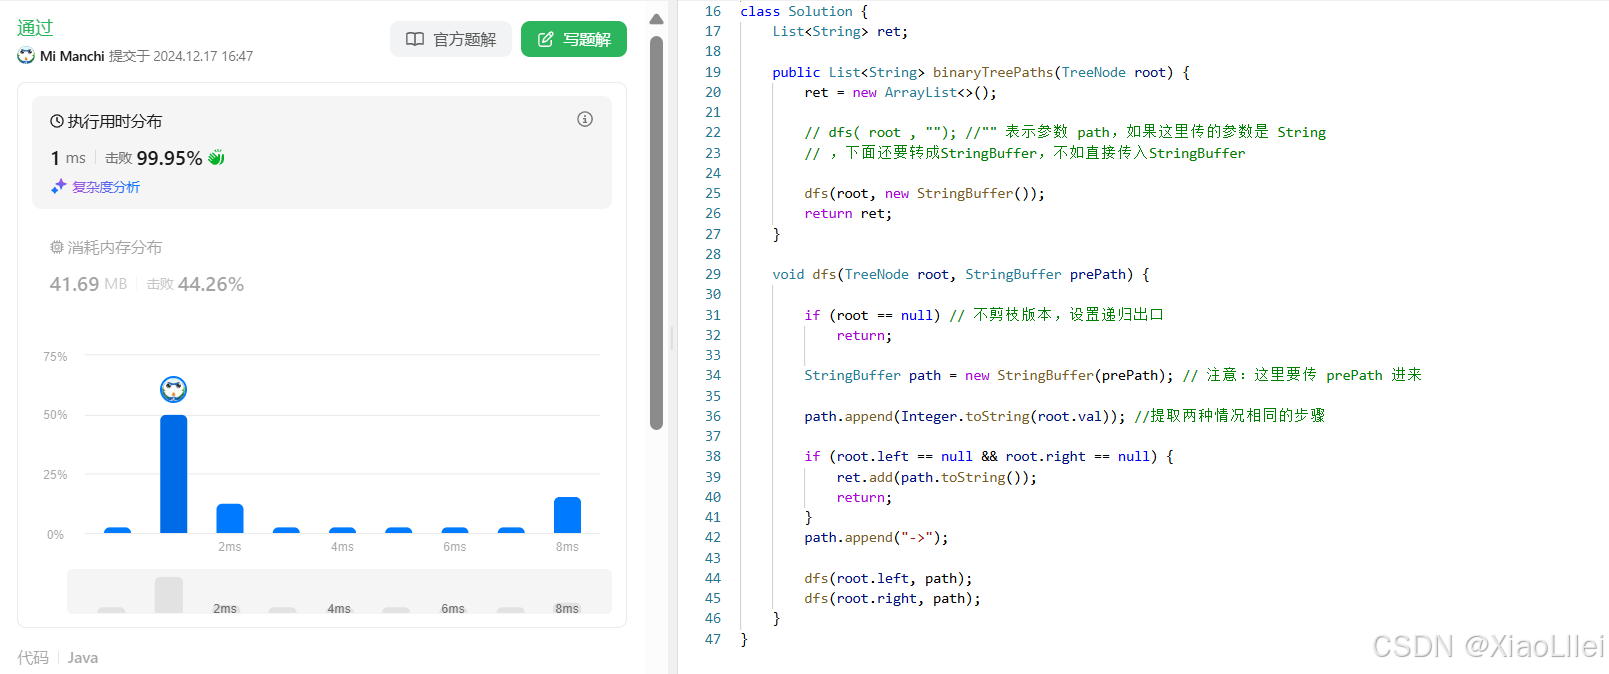
不剪枝版本
不管是叶子节点,还是非叶子节点,都需要加 root.val,直接提取出两种情况拼接数字的步骤:

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 124
 0
- 0


 已为社区贡献8条内容

所有评论(0)