Java开发的服务降级系统:限流、熔断与降级功能实践

简介:服务降级系统是高可用架构的关键部分,尤其是在高并发的分布式系统中。本项目展示了一个基于Java开发的服务降级系统,实现了限流、熔断和降级等重要功能,以保障核心业务的稳定运行。限流避免系统因请求过多而崩溃,熔断机制通过电路保护原理防止服务过载,降级则是在服务出现问题时提供默认值或错误信息,保证用户体验。系统的核心组件包括限流器、熔断器、降级策略、监控告警以及自动恢复功能。开发者可以通过本项目的源代码学习服务降级策略的实际应用,从而增强系统的鲁棒性和稳定性。 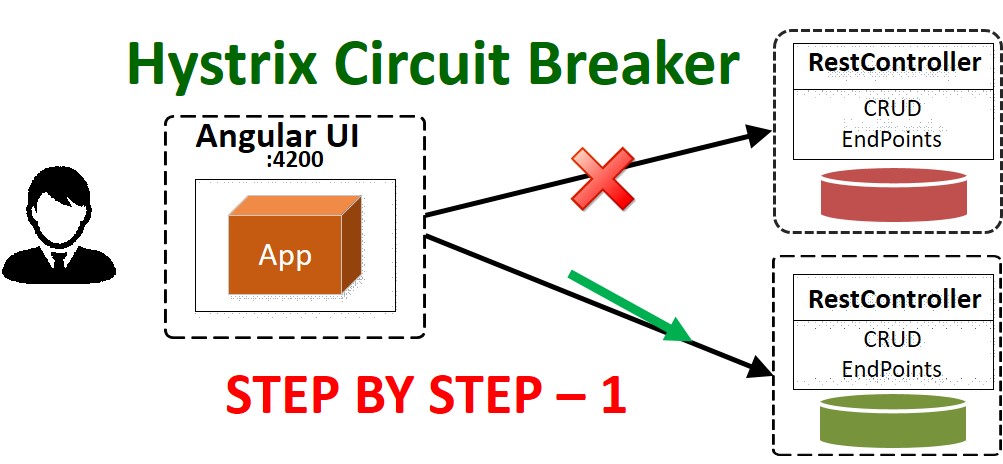
1. 服务降级的定义与作用
服务降级是一种常见的系统设计策略,其核心思想是在系统面临高负载或者部分服务故障时,主动降低系统非核心功能的执行力度,甚至暂时关闭非关键服务,以保障系统的核心功能能够正常运行,从而提升整体系统的稳定性和可用性。
服务降级的定义
在复杂的分布式系统中,服务降级通常指的是当服务无法承载过大的负载或者出现故障时,通过预先设计的降级策略,对服务进行降级操作,比如将原本需要远程调用的服务切换为本地调用,或者对部分用户请求直接返回预设的结果,减少对后端资源的压力。
服务降级的作用
服务降级在服务保障和用户体验方面起着至关重要的作用。当系统处于高负载状态时,通过服务降级,可以优先保证核心业务的连续性和稳定性,同时避免因资源不足而导致整个系统崩溃。此外,服务降级还能够帮助系统在突发事件发生时,通过动态调整服务级别,快速恢复至正常运行状态,提升用户体验。
2. 限流策略与常见算法
2.1 限流的必要性分析
2.1.1 服务过载的危害
服务过载通常发生在请求量超过服务处理能力的情况下,这会导致一系列的负面后果。首先,服务响应时间会显著增加,客户端可能因为超时而重试,这反过来进一步增加了系统的负载。其次,持续的高负载可能会耗尽系统资源,比如CPU、内存和数据库连接,从而导致服务崩溃。服务崩溃后,可能会引起连锁反应,影响其他依赖服务的正常运行,甚至影响整个系统的稳定性和可用性。
2.1.2 限流在服务降级中的角色
限流是服务降级策略中的重要组成部分。它能够保证在资源有限的情况下,服务能够优先处理重要的请求,同时暂时拒绝那些非关键的请求。这样做的好处是能够在高负载的情况下,维持系统的核心功能正常运行,并且能够防止系统过载导致的连锁故障。通过限流,可以在服务提供者和服务消费者之间建立一种保护机制,以确保整体系统即使在面对流量高峰时也能保持稳定。
2.2 限流算法详解
2.2.1 固定窗口计数器算法
固定窗口计数器算法是一种简单的限流算法,它将时间划分为多个固定长度的窗口,并对每个窗口内的请求数量进行计数。如果在当前窗口内的请求数量超过了设定的阈值,则拒绝后续的请求。这种算法实现简单,但在流量波动大的情况下可能不够精确。例如,如果所有的请求都集中在窗口的末尾,那么在接下来的窗口中可能会有大量的请求被错误地允许,导致服务过载。
import time

class FixedWindowRateLimiter:
    def __init__(self, limit, period):
        self.limit = limit
        self.period = period
        self.reset_period = 1
        self.requests = {}
    def is_allowed(self, key):
        current_time = time.time()
        current_window = int(current_time // self.period)
        last_reset = int(current_time - current_time % self.period)
        # Reset the counter at the end of the period
        if current_window - last_reset >= self.reset_period:
            self.requests = {}
            current_window = last_reset

        if key not in self.requests:
            self.requests[key] = 0
        self.requests[key] += 1
        if self.requests[key] <= self.limit:
            return True
        else:
            return False

# Example usage
limiter = FixedWindowRateLimiter(limit=5, period=60)  # 5 requests per minute
print(limiter.is_allowed('user_1'))
2.2.2 滑动窗口日志算法
滑动窗口日志算法维护一个有序的日志列表,记录所有请求的时间戳。通过计算当前时间与日志中最早的时间戳之间的差值,来决定是否允许新的请求。该算法的精确度较高,但会随着窗口长度的增加而增加存储的开销。
import datetime
from collections import deque

class SlidingWindowRateLimiter:
    def __init__(self, limit, period):
        self.limit = limit
        self.period = period
        self.requests = deque()
    def is_allowed(self, key):
        current_time = datetime.datetime.now()
        while self.requests and (current_time - self.requests[0]).total_seconds() > self.period:
            self.requests.popleft()
        if len(self.requests) < self.limit:
            self.requests.append(current_time)
            return True
        else:
            return False

# Example usage
limiter = SlidingWindowRateLimiter(limit=5, period=60)  # 5 requests per minute
print(limiter.is_allowed('user_1'))
2.2.3 漏桶算法与令牌桶算法
漏桶算法和令牌桶算法是两种常见的控制流量和限速的算法。漏桶算法中,请求被比作水,而桶的容量是固定的,如果水超出了桶的容量,则多余的水会流出并被丢弃。桶中始终有水流出,即系统始终以恒定的速率处理请求。
令牌桶算法中,每个用户在固定速率下获得令牌,然后使用令牌来消费服务。如果用户没有足够的令牌,则必须等待。这种算法可以允许突发流量,只要令牌累积得足够多。
这两种算法在实现上通常更为复杂,但它们提供了更加灵活的限流策略,适应不同的应用场景。
2.3 限流算法的实际应用
2.3.1 选择合适的限流算法
选择限流算法时,需要根据实际的应用场景和业务需求进行评估。固定窗口计数器算法适合那些请求相对均匀分布的场景。滑动窗口日志算法适用于那些请求量不稳定,需要更高精度控制的场景。漏桶算法和令牌桶算法则适用于那些需要更灵活的流量控制策略的场景。
2.3.2 限流算法的性能对比与评估
评估限流算法的性能时,要考虑算法的精确度、实现复杂度、内存使用和对极端流量变化的响应能力。在选择限流算法时,需要平衡这些因素,选择最适合当前服务需求的限流策略。在实际部署前,可以通过压力测试来评估不同限流算法在高负载情况下的表现,以确保限流策略的正确性和有效性。
flowchart LR
    A[选择限流算法] --> B[业务需求分析]
    B --> C[算法性能对比]
    C --> D[压力测试]
    D --> E[选择最佳算法]
通过上述的分析和实际应用的考量,我们可以确定最适合自己服务的限流策略和算法,从而为构建一个稳定可靠的系统提供坚实的基础。
3. 熔断机制的工作原理
3.1 熔断机制的概念与功能
熔断机制是一种重要的服务保护手段,类似于电路中的断路器。在分布式系统中,某个服务发生故障后,故障可能会迅速蔓延到整个系统,导致系统雪崩式故障。熔断器的加入,可以在检测到一定数量的错误之后,暂时切断对下游服务的调用,从而保护整个系统。
3.1.1 熔断器的设计原理
熔断器的主要设计原理是防止系统雪崩,保证整个系统的稳定运行。其核心思想是将系统调用的失败概率控制在一个安全范围内,当系统调用失败率超过预设阈值时,触发熔断器从“关闭”状态转为“打开”状态,暂时阻断调用链,以避免错误扩散。
:
if total_calls == 0:
return False
error_rate = error_count / total_calls
return error_rate >= trip_threshold
# 示例参数
error_count = 10 # 错误调用次数
total_calls = 50 # 总调用次数
trip_threshold = 0.2 # 错误率阈值
# 触发熔断判断
if should_trip(error_count, total_calls, trip_threshold):
print("熔断触发")
else:
print("熔断未触发")
3.2.2 熔断的恢复机制
熔断器打开后,并不是永远保持这种状态。一段时间后,熔断器会从打开状态转换为半开状态,以检查下游服务是否已经恢复可用。
import time

def recovery_process(open_time):
    time.sleep(open_time)  # 等待熔断器打开一定时间后
    # 此处省略实际恢复机制的代码逻辑
    print("尝试恢复熔断器状态")

# 示例参数
open_time = 30  # 熔断器打开后等待时间(秒)

# 触发恢复机制
recovery_process(open_time)
3.3 熔断与限流的协同工作
熔断与限流在保障系统稳定运行时具有互补性,两者之间需要紧密协同工作。
3.3.1 熔断与限流的互补性
- 限流 :主要通过限制访问频率来防止系统过载,它在服务正常运行时即开始生效。
- 熔断 :是在服务出现异常时的紧急保护措施,侧重于避免系统级的故障扩散。
在实际应用中,限流可以降低系统的负载,而熔断则可以在系统负载过高的情况下,快速切断不正常的流量,降低系统的负载。
3.3.2 实践中熔断与限流的配置
在配置熔断和限流时,需要对系统的行为有充分的认识和理解,因为不同的配置会直接影响到系统的稳定性和服务质量。通常,熔断器的阈值设置会比限流的阈值宽松,因为熔断更加激进,一旦触发会直接拒绝请求。
hystrix:
  command:
    default:
      circuitBreaker:
        errorThresholdPercentage: 50  # 错误率超过50%时熔断
        requestVolumeThreshold: 10  # 最小请求量阈值
        sleepWindowInMilliseconds: 5000  # 熔断器打开后,多少时间尝试半开状态
      execution:
        isolation:
          thread:
            timeoutInMilliseconds: 1000  # 请求超时时间
以上是配置示例,说明了如何在Hystrix中设置熔断器的参数,其中 errorThresholdPercentage 和 requestVolumeThreshold 定义了触发熔断的条件。
熔断与限流的配置需要根据实际的服务特点和业务需求,通过反复的测试和调优来确定合适的参数。只有这样,才能确保熔断和限流策略能在保证系统稳定的同时,也尽可能地提高系统的吞吐能力和用户体验。
4. 降级策略的实施
4.1 服务降级的决策策略
在面对系统资源紧张或服务超载时,服务降级作为一种防御机制,可以有效保证系统的核心功能正常运行。其核心在于根据系统的当前状况和业务场景,合理地放弃或削减非核心功能,从而将有限的资源用在最必要的地方。
4.1.1 根据服务等级进行降级
服务等级(Service Level)是一个预先定义好的指标,它能帮助我们区分哪些服务是优先级高的,哪些是优先级低的。通过事先对服务进行等级划分,当系统资源不足时,优先保障高等级服务的可用性。
. . . 服务等级的定义
服务等级的定义依赖于业务场景。例如,对于一个电商平台而言,商品展示和交易支付属于高等级服务,因为它们直接关系到用户的购买行为。而用户评论、商品推荐等功能则可以被划分为低等级服务。
| 服务名称 | 描述               | 等级 |
|----------|--------------------|------|
| 商品展示 | 展示商品信息       | 高   |
| 交易支付 | 处理支付请求       | 高   |
| 用户评论 | 用户对商品的评价   | 低   |
| 商品推荐 | 根据用户行为推荐商品 | 低   |
. . . 服务降级逻辑实现
为了实现基于服务等级的降级逻辑,我们需要在系统中引入相应的降级策略。这通常涉及服务监控和动态配置服务调用的优先级。在代码中,我们可能需要增加如下逻辑:
if (isServiceOverloaded()) {
    for (Service service : allServices) {
        if (service.getLevel() == HIGH) {
            // 保持服务高可用
        } else if (service.getLevel() == LOW) {
            // 降级处理
        }
    }
}
4.1.2 基于业务优先级的降级
在实际业务中,除了服务等级,我们还需根据业务场景的紧急程度来制定降级策略。这意味着,即使一些服务等级并不高,但如果它们对当前业务目标至关重要,也需要被赋予较高的优先级。
. . . 业务优先级的评估
业务优先级的评估通常由产品团队和业务运营团队联合完成,他们会根据业务目标、市场情况以及用户反馈等因素进行评估。
. . . 降级策略的代码实现
在降级策略的代码实现上,我们可以通过配置文件或数据库来动态管理业务优先级。这样的灵活性能够帮助我们在不改动代码的情况下,调整降级策略以适应不同的业务需求。
Map<String, Integer> businessPriorityConfig = new HashMap<>();
businessPriorityConfig.put("userLogin", 10); // 用户登录
businessPriorityConfig.put("orderCheckout", 9); // 订单结算
businessPriorityConfig.put("productRecommendation", 6); // 商品推荐

if (isSystemOverloaded()) {
    for (String serviceName : businessPriorityConfig.keySet()) {
        int priority = businessPriorityConfig.get(serviceName);
        if (priority <= threshold) {
            // 降级处理逻辑
        } else {
            // 保证服务运行
        }
    }
}
在上面的示例代码中,我们根据业务优先级配置表来决定是否执行某个服务。当系统过载时,只有优先级大于或等于阈值的服务会被执行,其他服务则被降级处理。
4.2 降级模式的分类与应用
4.2.1 被动降级与主动降级
根据降级触发的时机不同,降级模式可以被分为被动降级和主动降级两种。被动降级主要是在系统出现故障时被动触发的,而主动降级则是根据系统当前的运行状况主动做出的调整。
. . . 被动降级
被动降级一般是在资源耗尽,无法响应更多请求时发生的。被动降级常常通过设置阈值来实现,一旦系统的各项指标达到预设的阈值,就会触发降级机制。
public boolean isSystemOverloaded() {
    // 检查系统资源使用情况,如CPU、内存等
    boolean isMemoryOverloaded = checkMemoryUsage();
    boolean isCPUBurdened = checkCPULoad();
    return isMemoryOverloaded || isCPUBurdened;
}
. . . 主动降级
主动降级则是在系统运行正常的情况下,根据预设的策略主动关闭或限制某些功能。例如,可以预先设定在流量高峰时段自动关闭一些非核心服务。
4.2.2 降级的策略模式应用实例
策略模式是一种行为设计模式,它允许在运行时选择算法的行为。在服务降级的场景中,我们可以使用策略模式定义一系列的降级策略,并且根据实际情况动态地选择和应用这些策略。
. . . 策略模式的实现
假设我们有一个用户信息查询服务,当系统过载时,我们可以选择不同的策略进行降级:
- 完全关闭用户信息查询服务。
- 提供静态缓存中的用户信息,而非实时查询数据库。
- 仅返回用户的最基本信息,而非全部信息。
public interface DegradationStrategy {
    void execute();
}

public class CloseServiceStrategy implements DegradationStrategy {
    @Override
    public void execute() {
        // 关闭服务逻辑
    }
}

public class CacheFallbackStrategy implements DegradationStrategy {
    @Override
    public void execute() {
        // 使用缓存逻辑
    }
}

public class PartialInfoStrategy implements DegradationStrategy {
    @Override
    public void execute() {
        // 返回基本信息逻辑
    }
}

// 策略的使用者
public class DegradationContext {
    private DegradationStrategy strategy;

    public DegradationContext(DegradationStrategy strategy) {
        this.strategy = strategy;
    }

    public void performDegradation() {
        strategy.execute();
    }
}

// 实例化策略并执行
DegradationContext context = new DegradationContext(new CacheFallbackStrategy());
context.performDegradation();
在上面的代码中,我们定义了一个降级策略接口和几个具体策略的实现。在实际使用时,可以根据系统的运行状况,动态选择合适的策略,并通过策略上下文来执行。
4.3 降级实施中的常见问题
4.3.1 降级点的选择与实现
在实施服务降级时,选择合适的降级点非常关键。降级点是指在系统中定义好的某些功能点,当系统运行出现问题时,可以从这些点开始进行功能的降级。
. . . 降级点的定义
通常情况下,降级点设置在系统的关键路径上,即那些对于核心业务流程不可或缺的功能点。在代码层面,这些点往往是系统中的服务调用入口,或者是处理关键业务逻辑的模块。
public class PaymentService {
    public void processPayment() {
        // 业务逻辑
        // ...
        // 降级点
        if (shouldDegraded()) {
            // 执行降级逻辑
            degradePaymentProcess();
        }
    }

    private boolean shouldDegraded() {
        // 判断是否需要降级
        // ...
    }

    private void degradePaymentProcess() {
        // 降级后的支付处理逻辑
        // ...
    }
}
4.3.2 降级引起的业务风险评估
虽然服务降级能够提高系统的稳定性和可用性,但不当的降级操作也可能带来业务风险。因此,在实施降级策略时,需要对可能带来的业务风险进行评估。
. . . 风险评估的方法
评估业务风险通常需要结合业务知识和系统监控数据。可以通过模拟降级操作,评估系统的性能变化和业务指标的影响。
. . . 降级策略的风险控制
为了控制风险,降级策略应当遵循以下原则:
- 降级操作应当是可逆的,以便在条件允许时快速恢复。
- 在实施降级前,应进行充分的测试和模拟。
- 监控系统应能实时反馈降级策略对业务指标的影响,以便及时调整。
graph LR
A[开始] --> B[确定业务风险评估指标]
B --> C[模拟降级操作]
C --> D[分析系统性能变化]
D --> E[评估业务指标影响]
E --> F[实施降级]
F --> G[监控降级效果]
G --> H[是否满足业务要求]
H -- 是 --> I[记录降级策略]
H -- 否 --> J[调整降级策略]
在实施降级时,我们可以使用一个流程图来规划和监控降级策略的实施效果,确保业务风险得到有效的控制和管理。
5. 系统核心组件设计
5.1 服务降级系统架构设计
5.1.1 系统的模块划分
在服务降级系统架构设计中,模块划分是至关重要的。一个典型的系统架构通常可以分为以下几个模块:
- 监控模块 :负责收集系统运行的各种指标数据,如请求量、响应时间、系统资源利用率等。
- 决策模块 :根据监控模块提供的数据,结合预设的策略,做出是否触发降级的决策。
- 执行模块 :执行实际的降级操作,如替换调用的服务、返回预设的降级响应等。
- 配置模块 :提供一个界面或者接口,使得管理员可以动态调整降级策略和阈值。
- 通知模块 :当系统触发降级时,及时向相关人员或系统发送通知。
这种模块化设计的好处在于,它不仅使得系统的维护和管理更加方便,还能够灵活应对各种复杂场景。
5.1.2 核心组件的功能与交互
核心组件之间的交互关系通常如下:
- 监控模块实时收集数据,当监控到指标异常时,触发决策模块。
- 决策模块分析数据并作出决策,若决定触发降级,则通知执行模块进行降级操作。
- 执行模块根据降级策略执行相应的降级措施,比如返回缓存数据、拒绝请求等。
- 配置模块接受管理员的配置,更新降级策略和阈值。
- 通知模块将触发降级的结果通知给相关人员或系统。
这种流程保证了服务降级操作的及时性和准确性,同时也便于问题的追溯和分析。
5.2 高性能组件实现技术
5.2.1 高效的数据结构与算法应用
在服务降级系统中,高效的组件实现依赖于合适的数据结构和算法。例如,可以使用以下技术:
- 使用环形缓冲区(Ring Buffer) 来存储监控数据,这样可以固定内存消耗,同时提供常数时间复杂度的插入和读取操作。
- 哈希表(Hash Table) 可以用于快速定位和更新缓存数据,减少查找时间。
- 红黑树(Red-Black Tree) 或 跳表(Skip List) 可以用于维护有序的执行策略,特别是在动态调整执行顺序时。
这些数据结构和算法能够提升组件处理速度,优化内存使用,从而提供高性能。
5.2.2 高性能组件的优化策略
在实现高性能组件时,还可以采取一些优化策略:
- 避免锁竞争 :合理使用锁,尽量减少锁的粒度,利用无锁编程技术如原子操作(Atomic Operations)。
- 批量处理 :对于需要大量处理的请求,采用批处理的方式,减少单个请求的处理开销。
- 异步IO操作 :利用异步IO模型,避免阻塞线程,提升并发处理能力。
通过这些优化策略,系统可以更好地处理高并发请求,提供更稳定的服务。
5.3 组件的测试与维护
5.3.* 单元测试与集成测试策略
测试是确保组件质量的关键。单元测试需要针对每个独立组件进行,确保其功能正确实现。集成测试则需要关注组件之间的交互,确保整个系统协同工作。
- 单元测试 :对每个组件编写测试用例,验证其逻辑正确性,包括边界条件和异常情况。
- 集成测试 :将多个组件组合起来进行测试,验证它们之间的接口和交互。
单元测试可以使用如 JUnit 的测试框架进行编写,集成测试可以使用如 Selenium 的自动化测试工具。
5.3.2 组件的持续集成与部署
为了保证组件的快速迭代和稳定交付,需要实现持续集成和部署的流程:
- 持续集成(CI) :每当有代码提交到版本库时,自动运行测试,检查代码质量和合并冲突。
- 持续部署(CD) :通过自动化流程,将通过测试的代码部署到生产环境。
持续集成和部署可以通过工具如 Jenkins、Travis CI 或 GitLab CI/CD 实现。这些工具可以与代码库、测试框架和部署环境进行集成,实现自动化流程。
通过这种方式,可以保证服务降级系统的快速响应和持续改进,满足复杂多变的业务需求。
简介:服务降级系统是高可用架构的关键部分,尤其是在高并发的分布式系统中。本项目展示了一个基于Java开发的服务降级系统,实现了限流、熔断和降级等重要功能,以保障核心业务的稳定运行。限流避免系统因请求过多而崩溃,熔断机制通过电路保护原理防止服务过载,降级则是在服务出现问题时提供默认值或错误信息,保证用户体验。系统的核心组件包括限流器、熔断器、降级策略、监控告警以及自动恢复功能。开发者可以通过本项目的源代码学习服务降级策略的实际应用,从而增强系统的鲁棒性和稳定性。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 16
 0
- 0


 已为社区贡献19条内容

所有评论(0)