XML与正则表达式工具:数据处理的有效搭档

简介:XML是一种用于标记数据的语言,广泛用于数据交换和文档结构化。正则表达式是强大的文本模式匹配和搜索工具。结合XML的结构特性和正则表达式的模式匹配能力,XML正则表达式工具为开发者和数据处理人员提供了高效查找、验证和提取XML数据的能力。本工具通过友好的用户界面、可导入导出的XML文件、以及丰富的示例和模板,大幅提升XML数据处理的效率和准确性。 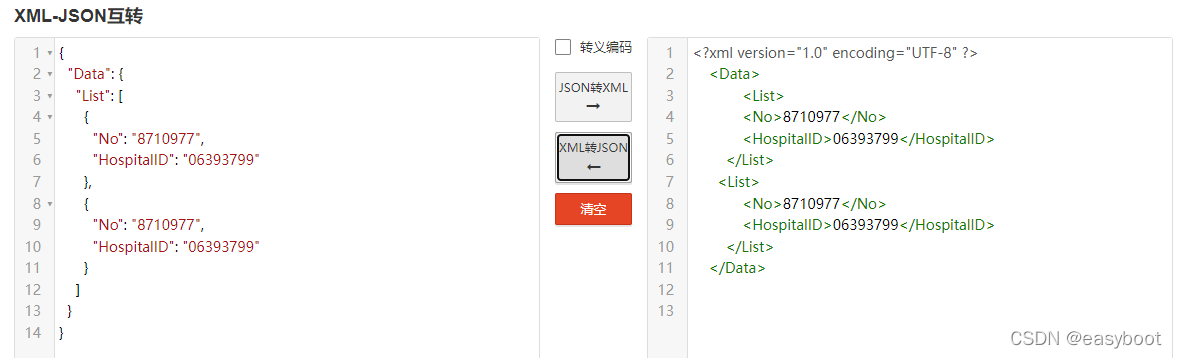
1. XML数据标记语言的应用
在本章中,我们将探索XML(Extensible Markup Language,可扩展标记语言)的核心概念及其广泛的应用领域。XML是一种标记语言,它允许用户定义自己的标签来描述数据。这一特性使得XML在多种不同的环境中都非常有用,包括电子商务、数据存储和网络服务等。
首先,我们会对XML做一个基本的介绍,解释它为什么被称为可扩展的,并探讨它与HTML的区别。随后,我们将详细分析XML如何在电子商务领域中用作数据交换的媒介。例如,订单、产品目录以及库存信息等都可以通过XML格式进行有效传递。
接下来,我们将讨论XML在数据存储方面的重要性。XML文件以一种结构化的方式存储信息,易于人阅读和编写,同时也方便机器解析和生成。这一点对于构建复杂的信息系统特别重要,因为它不仅增强了数据的可读性,而且促进了不同系统间的兼容性。
最后,本章也会探讨XML在网络服务中的作用。由于XML的跨平台特性,它成为了网络服务中数据交换的标准方式。它使得不同的应用程序和系统之间可以轻松地共享数据,无论它们是运行在何种操作系统或硬件平台上。
通过本章的学习,读者将对XML有一个全面的理解,并能够看到它在实际业务中的具体应用案例。这将为后续章节中对XML正则表达式工具的探讨奠定坚实的基础。
2. 正则表达式的文本模式匹配能力
正则表达式的基本语法和构成元素
正则表达式(Regular Expression),是一种用于匹配字符组合的字符串模式。它由一系列的字符和特殊符号组成,可以用于检索、替换那些符合某个模式(规则)的文本。一个简单的正则表达式例子是 /ab*c/ ,它表示匹配一个 a 后跟零个或多个 b ,最后是 c 。这里 a 、 b 和 c 是普通字符,而 * 是一个特殊字符,表示匹配前一个字符零次或多次。
一个典型的正则表达式模式由如下元素构成:
- 普通字符 : 匹配自身。如字母
a,数字1等。 - 元字符 : 具有特殊含义的字符。如
.匹配任意字符(除了换行符),*表示前一个字符的零次或多次出现。 - 转义字符 : 用于转义元字符,赋予普通字符特殊含义,或反之。使用反斜杠
\来转义。 - 字符集 : 用方括号
[]表示一组字符,匹配其中一个字符。如[abc]匹配a、b或c。 - 量词 : 用来指定字符出现的次数。常见的量词有
*(零次或多次)、+(一次或多次)、?(零次或一次)等。
正则表达式的特殊字符和模式构造
特殊字符在正则表达式中担任关键角色,是模式匹配能力的核心。
- 点号
.: 匹配除换行符以外的任意单个字符。 - 锚字符 : 包括
^和$,分别匹配行的开始和结束位置。 - 字符集和否定字符集 : 如
[a-zA-Z]匹配所有大小写字母,[^0-9]匹配任何非数字字符。 - 分组和捕获 : 通过括号
()表示一个子表达式,不仅可以用来分组,还可以用来捕获用于后续的引用。
(\d{3})-(\d{4}) # 此模式匹配电话号码,例如 123-4567,并将区号(123)和本地号码(4567)分组捕获。
正则表达式在文本处理中的应用实例
正则表达式广泛应用于编程语言和文本处理工具中。以下是几个实例:
- 验证输入 : 使用正则表达式验证用户输入的数据格式是否正确,如邮箱、电话号码等。
- 数据提取 : 从一段文本中提取需要的信息,如从日志文件中提取特定错误信息。
- 数据替换 : 高效地替换文本中的特定模式,如更改文件扩展名或将一些文本转换为小写。
正则表达式的高级模式匹配技巧
高级模式匹配技巧包括前瞻和后顾断言、正则表达式中的函数引用等。
- 前瞻断言 :
(=pattern)匹配pattern出现的位置,但不包括pattern本身。 - 后顾断言 :
(?<=pattern)匹配pattern出现之后的位置。 - 函数引用 : 一些正则表达式的实现支持引用特定函数,例如在某些环境中可以调用
/\d+(?!\.)/来匹配不以小数点结尾的数字。
实际应用案例:使用正则表达式进行文本数据处理
假设我们有一个文本文件,其中包含一系列电话号码,我们想要提取所有电话号码并将其转换为一种标准格式:
Jim 415-555-0123
Jane 650-555-0133
Bob 555-555-0120
我们可以使用如下正则表达式来匹配并捕获这些电话号码:
(\d{3})-(\d{3})-(\d{4})
在应用此模式后,我们可以编写代码来迭代每个匹配项,按照所需格式重组(例如,将分隔符从 - 改为 . )并输出最终结果:
import re

text = """
Jim 415-555-0123
Jane 650-555-0133
Bob 555-555-0120

pattern = ***pile(r'(\d{3})-(\d{3})-(\d{4})')
matches = pattern.findall(text)

for match in matches:
    print('{}.{}.{}'.format(match[0], match[1], match[2]))
总结
正则表达式通过其灵活的模式匹配能力,成为了处理文本不可或缺的工具。无论是验证数据格式、提取特定信息,还是进行文本替换,正则表达式都展示出了其强大的功能。在下一章节中,我们将详细探讨如何利用正则表达式,尤其是在处理XML数据时的应用,进一步揭示其在数据处理方面的独特优势。
3. XML正则表达式工具的设计目的和优势
设计背景与初衷
XML正则表达式工具的开发源于对数据处理需求的深刻理解,特别是在需要处理大量XML文件时所面临的挑战。在数据处理流程中,开发者往往需要从大量结构化或半结构化的数据中提取有用信息。这不仅需要对XML文档结构有深入的理解,还需要高效、准确地识别和提取数据。
该工具的设计初衷是为了解决以下问题: - 确保XML文档中的数据能够被快速和准确地解析。 - 提供一种更直观、更易于掌握的方式来构建和测试正则表达式。 - 简化数据处理流程,减少手动编码的工作量。
通过创建一个专门针对XML数据的正则表达式工具,我们能够提供一个更优化的解决方案,以应对处理XML数据时的复杂性和特殊性。
工具相较于传统方法的优势
相较于传统的XML处理方式,XML正则表达式工具在多个方面展现出其优势:
易用性
- 图形化界面 :用户可以通过图形化界面轻松编写和测试正则表达式,无需记忆复杂的语法规则。
- 即时反馈 :工具提供即时的匹配结果反馈,让用户可以快速调整表达式,直到达到预期效果。
效率提升
- 自动化处理 :对于重复性的数据提取任务,工具可以通过已编写的正则表达式快速执行,大幅度提高工作效率。
- 复杂模式匹配 :工具支持构建高级正则表达式来处理复杂的XML结构和数据模式。
精确度
- 错误提示 :在编写和测试正则表达式时,工具会提供详细的错误提示,帮助用户快速定位问题。
- 支持Unicode :全面支持Unicode字符集,确保能够处理国际化数据。
简化XML数据处理流程
XML正则表达式工具通过以下几个方面简化了XML数据处理流程:
集成开发环境(IDE)的功能
- 代码高亮 :对XML和正则表达式代码提供高亮显示,提升代码的可读性。
- 代码片段和自动完成功能 :减少重复输入和拼写错误,加快开发速度。
自动化工具链
- 命令行接口 :支持命令行操作,方便集成到自动化的数据处理流程中。
- 插件系统 :可扩展的插件系统允许用户根据需求增加额外的功能。
数据处理与转换
- 数据验证 :确保输入数据符合预期格式,预防数据错误。
- 数据转换 :支持将提取的数据转换成不同格式,如CSV、JSON等,以便于进一步的使用和分析。
在下面的示例中,我们将进一步探讨如何使用该工具来处理一个实际的XML数据提取任务,并展示它如何在不同的场景中提高数据处理能力。
示例:从电子商务XML数据中提取商品信息
假设我们拥有一个包含大量商品信息的XML文件,每个商品元素中包含了商品ID、名称、价格、库存量等信息。
<Products>
  <Product>
    <ID>12345</ID>
    <Name>Awesome Widget</Name>
    <Price>9.99</Price>
    <Stock>50</Stock>
  </Product>
  <!-- ... 更多商品元素 ... -->
</Products>
我们可以使用以下正则表达式来匹配并提取所有的商品信息:
<Product>
  <ID>(.*?)<\/ID>
  <Name>(.*?)<\/Name>
  <Price>(.*?)<\/Price>
  <Stock>(.*?)<\/Stock>
<\/Product>
该工具将帮助我们快速定位到每个 <Product> 元素,并从中提取所需的信息。之后,我们可以将提取的数据导出为CSV格式,以供其他应用程序使用。
在下一章中,我们将详细讨论XML正则表达式工具的具体组成部分以及它们的功能,进一步深入理解工具的工作机制和操作流程。
4. 工具的组成部分与功能
组成部分详解
RegExBuilder.chm帮助文件
在XML正则表达式工具中,RegExBuilder.chm是一个不可或缺的部分。它是该工具的使用手册,提供了一个完整的、可搜索的文档,指导用户如何安装、配置以及使用XML正则表达式工具。通过 chm 文件,用户可以快速查找到任何功能的具体解释,以及相关示例,从而更好地理解和掌握工具的使用方法。
RegExBuilder.exe主程序
作为工具的核心,RegExBuilder.exe负责执行所有与XML正则表达式处理相关的操作。该程序运行时提供一个用户友好的界面,让用户可以直观地进行正则表达式的编写、测试和结果展示。它的界面通常被设计为简洁明了,确保用户不会因为复杂的操作界面而分散注意力。
RegExBuilder.ico图标文件
图标文件为用户提供视觉上的识别。在使用工具的过程中,图标能够帮助用户快速识别出工具的快捷方式或工具本身,同时增强用户的使用体验。图标的设计应当简洁而具有代表性,能够反映出XML正则表达式工具的特点和作用。
MyRegEx.xml配置文件
MyRegEx.xml文件用于存储用户的自定义配置。这个文件允许用户保存个人的正则表达式模式和测试用例,方便用户在不同时间点重新加载之前的设置,而无需重新输入。这样的设计提升了工具的灵活性和个性化服务水平。
Examples文件夹
Examples文件夹提供了各种XML处理的正则表达式示例。这包括了不同类型的XML数据处理任务,例如提取特定节点、解析特定属性或进行复杂的数据转换。通过这些例子,用户可以更加容易地理解如何应用正则表达式来处理实际问题,并能够直接在自己的项目中进行复用或修改。
Expressions文件夹
Expressions文件夹主要用于存储和管理正则表达式模板。模板可以让用户快速应用常用或复杂的正则表达式模式到他们的XML数据上,无需每次都重新编写。此外,此文件夹可以被其他用户共享,从而形成一个合作的社区环境。
功能性分析
RegExBuilder.chm帮助文件的功能
该帮助文件对于提高用户效率尤为重要,它不仅提供了一个综合的用户指南,而且还可以帮助用户在遇到问题时快速定位解决方案。其功能主要体现在以下几个方面:
- 快速定位功能 :用户可以通过关键字搜索,快速找到需要的信息。
- 详细的解释说明 :对于每一个工具选项和功能,都有详细的解释和指导。
- 实例演示 :包含多个真实案例,展示正则表达式的实际应用和效果。
RegExBuilder.exe主程序的功能
RegExBuilder.exe是用户与XML正则表达式工具交互的主要途径。其核心功能包括:
- 直观的用户界面 :简化用户操作流程,降低学习难度。
- 强大的正则表达式处理能力 :实现复杂的XML数据匹配和转换。
- 即时结果反馈 :对正则表达式的测试结果进行实时反馈,帮助用户调试表达式。
RegExBuilder.ico图标文件的功能
图标文件虽然不直接参与数据处理,但其作用不容忽视:
- 易用性提升 :图标作为一种视觉元素,使得用户在寻找工具时更加便捷。
- 品牌识别 :图标帮助建立工具的品牌形象,加强用户的品牌忠诚度。
MyRegEx.xml配置文件的功能
MyRegEx.xml作为用户个人化的配置文件,其主要功能包括:
- 个性化存储 :保存用户的个人设置和自定义正则表达式,方便下次使用。
- 可移植性 :用户可以在不同计算机之间轻松转移个人的配置信息。
Examples文件夹的功能
该文件夹提供给用户一系列现成的正则表达式示例,这些示例可以作为学习材料或直接用于工作:
- 教育性 :帮助用户理解正则表达式的应用方法和逻辑。
- 便捷性 :用户可以快速查找并应用适合其需求的正则表达式。
Expressions文件夹的功能
Expressions文件夹增强了工具的共享性和协作性:
- 模板化处理 :用户可以使用现成的模板来加快数据处理流程。
- 社区合作 :用户可以分享自己创建的模板,形成一个共享资源库。
实际操作案例
以下是一个实际操作案例,展示了如何使用RegExBuilder工具的一些核心功能来处理XML数据。
步骤一:打开RegExBuilder.exe
启动程序后,用户可以看到一个简洁的界面,左侧是工具栏,右侧是配置区域。在这个界面中,用户可以编写正则表达式,并且设置相关的测试参数。
步骤二:编写正则表达式
在表达式编辑区域,用户可以根据需要编写或粘贴一个正则表达式。例如,如果用户希望匹配所有在XML文档中具有特定属性的元素,可以编写如下表达式:
<(\w+)[^>]*?id="(\w+)">
步骤三:导入XML文档
在界面的文件导入部分,用户可以加载XML文档。点击导入按钮后,选择需要处理的XML文件,程序将加载文件并准备进行正则表达式匹配。
步骤四:测试匹配
在正则表达式编写完毕后,用户可以点击测试按钮进行匹配。程序将在下方的区域显示所有匹配结果,如果在编写正则表达式时出现错误,程序也会给出相应的提示信息。
步骤五:调试表达式
如果测试结果并不符合预期,用户可以回到表达式编辑区域进行调试。通过修改正则表达式,或者调整测试参数,直至得到正确和满意的结果。
步骤六:保存配置
用户在完成匹配后,可以将整个配置保存下来。保存为一个 .xml 文件,这样在下次需要使用相同的设置时,可以直接通过导入配置文件来快速恢复。
通过以上步骤,用户可以体会到XML正则表达式工具的便捷性和高效性。以上操作流程可以有效地帮助用户完成各种复杂的数据处理任务,同时也展示了工具在实际应用中的强大能力。
5. 工具操作流程
第一节:准备工作
在开始使用XML正则表达式工具之前,用户需要确保已经正确安装了该工具,并准备好需要处理的XML文档。准备工作的完成是进行有效数据处理的前提。
第二节:导入XML文档
导入XML文档是使用工具的第一步,用户可以通过几种不同的方式来导入XML文件。
步骤一:从文件系统导入
用户可以直接通过工具界面中的“打开文件”功能,选择电脑上存储的XML文件。用户选择文件后,工具会读取并显示XML文档的结构,这样用户就可以开始对文档进行操作。
<!-- 示例代码:一个简单的XML文件 -->
<books>
  <book>
    <title>XML正则表达式工具应用</title>
    <author>张三</author>
  </book>
  <book>
    <title>深入理解XML</title>
    <author>李四</author>
  </book>
</books>
步骤二:从网络导入
如果XML文件存储在远程服务器上,用户可以使用工具提供的URL导入功能。只需输入XML文件的网络路径,并确认无误后,工具将会通过网络请求获取文件内容并加载。
步骤三:从剪贴板导入
对于临时的XML数据或从其他应用中复制的数据,用户可以通过剪贴板导入的方式,直接将XML内容粘贴到工具中进行处理。
第三节:编写正则表达式
在成功导入XML文档后,下一步便是编写用于匹配和处理XML数据的正则表达式。
步骤一:理解XML结构
在编写正则表达式之前,用户需要先熟悉XML文档的结构,这有助于准确地定位和提取所需的数据。
<books>
  <book>
    <title>Effective XML</title>
    <author>Jim Tivy</author>
  </book>
  <!-- 更多的books和book节点 -->
</books>
步骤二:定义匹配模式
根据要提取的数据类型和位置,用户需要定义一个或多个匹配模式。在工具的正则表达式编辑器中,用户可以输入表达式,并通过即时反馈验证其有效性。
<book.*?>
  <title>(.*?)</title>
  <author>(.*?)</author>
</book>
步骤三:使用特殊字符
在定义匹配模式时,用户应当掌握正则表达式中的特殊字符,例如点号( . )、星号( * )、问号( ? )等,这些字符在正则表达式中具有特定的功能,可以帮助用户精确地构造匹配规则。
第四节:测试匹配
编写正则表达式之后,需要进行测试以确保其能够正确匹配XML文档中的目标数据。
步骤一:使用测试功能
大多数XML正则表达式工具都带有测试功能。用户可以输入XML文档的某部分片段,并运行测试,工具会显示出所有匹配的结果,从而验证表达式的有效性。
步骤二:调整与优化
如果测试结果与预期有出入,用户需要根据匹配结果调整正则表达式,直到能够准确匹配目标数据为止。
第五节:调试表达式
调试是确保正则表达式按预期工作的关键步骤。在调试过程中,用户可能会修改表达式来排除匹配错误或提高效率。
步骤一:使用日志记录
一些高级工具提供日志记录功能,能够记录正则表达式执行过程中的详细信息,包括匹配的位置、查找的顺序等。用户可以通过这些日志来优化表达式。
步骤二:分步执行
在某些复杂情况下,分步执行正则表达式可以帮助用户理解表达式如何逐步匹配文本。这种方式对于调试特别有帮助。
第六节:保存与分享配置
完成正则表达式的编写、测试和调试后,用户可以将配置保存起来,以便将来重用或与他人分享。
步骤一:保存配置文件
用户可以通过工具提供的保存功能,将当前的正则表达式、匹配模式以及其他设置保存为一个配置文件,通常为XML或JSON格式。
{
  "regex": "<book.*?>(.*?)</title>.*?<author>(.*?)</author>.*?</book>",
  "XMLPath": "books/book"
}
步骤二:分享配置文件
工具通常支持将配置文件导出为独立的文件,这样用户就可以轻松地将其发送给同事或上传到网络上共享。
第二节:进阶操作与技巧
在熟练掌握基本操作流程之后,用户可以探索更多的进阶操作,以进一步提高数据处理的效率和灵活性。
第三节:使用高级功能
XML正则表达式工具通常具备一些高级功能,用以处理复杂的XML数据匹配和转换。
步骤一:利用分组与引用
在正则表达式中使用分组和引用可以帮助用户捕获和复用匹配的部分,这对于提取嵌套元素和重复模式特别有用。
<book.*?>
  <title>(.*?)</title>
  <author>(.*?)</author>
</book>
步骤二:运用正则表达式后向断言
后向断言能够在不消耗字符的情况下进行匹配,这对于处理某些特定的XML结构非常有效。
第四节:性能优化
随着数据量的增加,性能优化成为了数据处理流程中不可忽视的一部分。
步骤一:优化正则表达式
对于复杂的XML数据处理,简单的正则表达式可能会导致性能瓶颈。用户需要通过避免贪婪匹配、使用非贪婪匹配等方法优化表达式。
步骤二:利用工具缓存机制
一些工具提供缓存机制,可以缓存重复使用的模式匹配结果,从而提高整体处理速度。
第五节:处理特殊字符与编码问题
XML文件可能包含特殊字符,处理这些问题对于确保数据的准确性和完整性至关重要。
步骤一:识别特殊字符
特殊字符的处理通常需要在正则表达式中使用转义字符,如 < 代替 < 。
步骤二:处理不同编码
不同系统可能使用不同的编码方式,因此用户需要确保工具支持所有相关编码,以避免乱码或错误匹配。
第六节:自动化与脚本编程
为了更高效地处理大量XML文件,自动化和脚本编程是提高效率的有效途径。
步骤一:录制宏命令
一些工具支持录制宏命令,用户可以通过录制自己的操作生成脚本,随后自动化执行相同的操作。
步骤二:编写自定义脚本
高级用户可以编写自定义脚本来自动化数据处理任务,根据实际需求调整工具的行为。
第三节:工具操作进阶实例
为了更好地理解进阶操作的流程,以下将通过一个具体实例展示如何使用XML正则表达式工具。
第四节:实例解析
假设用户有一个包含多个 <book> 元素的XML文件,希望提取每个 <book> 中的 <title> 和 <author> 信息。
步骤一:导入XML文档
用户通过“打开文件”功能导入了包含书籍信息的XML文档。
步骤二:编写正则表达式
用户根据XML结构编写了如下正则表达式:
<book.*?>
  <title>(.*?)</title>
  <author>(.*?)</author>
</book>
步骤三:测试匹配
使用工具的测试功能,用户检查表达式是否能正确匹配预期的数据。
步骤四:调试表达式
通过分步执行和日志记录,用户调整了表达式,确保所有 <book> 节点均被正确匹配。
步骤五:保存配置
配置完成后,用户将配置保存为一个XML配置文件,命名为 ExtractBooks.xml 。
<configuration>
  <regex><book.*?>(.*?)</title>.*?<author>(.*?)</author>.*?</book></regex>
  <path>books/book</path>
</configuration>
步骤六:自动化处理
用户编写了一个简单的脚本,使用之前保存的配置文件来自动化处理导入的其他XML文件。
通过这个实例,我们可以看到,通过工具的进阶操作,用户能够更加有效地处理XML数据,实现自动化、高效的数据处理流程。
6. 工具提高数据处理能力的具体方式
自动化处理大量XML文件
在处理大量XML文件时,手动处理耗时且容易出错。XML正则表达式工具通过批量操作,可以快速处理这些文件。一个典型的案例是电子商务平台需要对产品信息进行更新。使用工具后,可以通过编写一个正则表达式来匹配和修改所有产品价格标签,从而自动化完成整个更新流程。
例如,以下的代码示例展示如何在XML正则表达式工具中使用正则表达式批量更新价格:
<product>
   <name>Widget</name>
   <price>19.99</price>
</product>
通过编写一个正则表达式 (<price>)([^<]+)(</price>) 来匹配价格部分,并将其替换为新的价格值,如 29.99 。
匹配与抽取复杂数据模式
XML文档通常包含结构化的信息,而这些信息的提取往往需要复杂的正则表达式。XML正则表达式工具能够通过直观的界面帮助用户设计出准确匹配特定模式的正则表达式。
举一个例子,假设需要从一系列的XML文件中提取出具有特定属性的 <user> 标签,可以使用如下的正则表达式:
<user[^>]*?name="([^"]+)"[^>]*?>
这个正则表达式将会匹配所有包含 name 属性的 <user> 标签,并抽取该属性的值。工具通过图形化界面辅助用户输入这个正则表达式,并提供即时反馈,确保模式的准确性。
清洗和转换数据
数据清洗是任何数据分析工作的重要环节。XML正则表达式工具可以用来清洗和转换不符合规范的数据。例如,如果需要将所有的日期格式从 YYYY-MM-DD 转换为 MM/DD/YYYY ,可以使用一个专门的正则表达式配合替换功能来实现这一转换。
下面的代码展示如何转换日期格式:
原始数据:
<appointment>
   <date>2021-12-31</date>
</appointment>
使用正则表达式 (\\d{4})-(\\d{2})-(\\d{2}) 配合替换 $2/$3/$1 ,得到目标格式的日期。
性能优化与效率提升
XML正则表达式工具在处理大型XML文档时,同样可以优化性能和提升处理效率。通过内置的性能分析器,用户可以找出正则表达式中的瓶颈,进而优化它们。对于大型文档,工具还支持分批处理功能,允许用户分块加载并处理数据,这样可以减少内存的消耗并提高处理速度。
通过本章的介绍,我们看到XML正则表达式工具是如何在自动化处理、模式匹配抽取以及数据清洗转换等各个环节提高数据处理的能力。这些案例证明了该工具在提升工作效率和准确性方面具有显著的效果,并为IT专业人员提供了一个强大的辅助工具,用于处理复杂的XML数据处理任务。
简介:XML是一种用于标记数据的语言,广泛用于数据交换和文档结构化。正则表达式是强大的文本模式匹配和搜索工具。结合XML的结构特性和正则表达式的模式匹配能力,XML正则表达式工具为开发者和数据处理人员提供了高效查找、验证和提取XML数据的能力。本工具通过友好的用户界面、可导入导出的XML文件、以及丰富的示例和模板,大幅提升XML数据处理的效率和准确性。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 23
 0
- 0


 已为社区贡献30条内容

所有评论(0)