GCNet: Graph Completion Network for IncompleteMultimodal Learning in Conversation(GCNet:面向对话中不完整多模态)
代码:https://github.com/zeroQiaoba/GCNet
摘要:
对话已经成为社交媒体平台上至关重要的数据格式。由于对话在人机交互中具有广泛应用,从情绪、内容等方面理解对话引起研究者广泛关注。在现实环境中,经常遇到模态不完整问题,这已经称为对话理解的核心问题。为解决这一问题,研究者提出各种方法。然而,现有方法主要是针对单个对话而非整个对话数据设计,因此无法充分利用对话中的时间和说话者信息。为此,提出一种新的对话不完整多模态学习框架,GCNet(图补全网络),GCNet包含两个基于GNN的模块:说话者GNN、时间GNN。以捕捉说话者和时间的依赖关系。为充分利用完整和不完整数据。以端到端的方式联合优化分类和重建任务。为验证所提方法的有效性,在三个基准对话数据集上进行了实验,结果表明,GCNet在不完整多模态学习方面优于现有最先进方法
1、介绍
对话理解因其在对话系统和智能推荐等众多任务中,因而成为研究热点,为了从情感、内容等不同方面理解对话,研究人员通过社交媒体平台收集了大量对话数据。然而,在现实环境中,许多因素都可能导致模态缺失,例如,由于背景噪音或传感器故障,语音可能会缺失;由于自动语音识别错误或遇到未知词汇,文本可能无法获取;由于光照、运动或遮挡,人脸可能无法被检测到。模态不完整的问题增加了准确理解对话的难度。
为此,研究人员提出了多种方法来处理模态不完整的问题。然而,现有的方法主要是针对单个话语或医学影像设计的,而不是针对对话数据。例如,吧啦 吧啦
在本文中,提出了“图补全网络(GCNet)”的新型框架,用于处理对话中的不完整多模态学习问题。目标是充分利用对话中的时间和说话人信息来处理模态不完整的情况。图1展示了我们的方法的整体结构。具体来说,首先,随机丢弃多模态特征,以模拟现实世界中的缺失模式。为了捕捉对话中的说话人和时间依赖性,提出了两个基于图神经网络(GNN)的模块:“说话人GNN(SGNN)”和“时间GNN(TGNN)”。这两个模块共享相同的边,但边的类型不同。最后,以端到端的方式联合优化分类和重建任务。在三个基准对话数据集上进行了实验。通过定量和定性分析,证明了我们的GCNet在分类和补全方面均优于当前先进的方法。本文的主要贡献可以概括如下:
与主要关注医学影像或单个话语的现有工作不同,我们研究了对话数据中模态不完整的问题,填补了当前工作的空白。
设计了一个新颖的框架GCNet来处理不完整的对话数据。该模型利用图神经网络来捕捉对话中的时间和说话人信息。
在三个基准数据集上的实验结果验证了所提方法的有效性。GCNet在不完整多模态学习方面优于现有的最先进方法。
2、相关工作
2.1 补全方法
大致分为以下三类
零/平均值补全(Zero/Average Imputation):使用零向量或平均值填充缺失模态是数据补全。零/平均值补全在不完整多模态学习中可以取得具有竞争力的性能。然而,由于未利用监督信息,填充值与原始数据之间仍存在差距,从而降低了下游任务的性能。
低秩补全(Low-Rank Imputation):完整的多模态数据在不同模态之间表现出相关性,导致数据矩阵的秩较低。然而,不完整的数据会破坏这些相关性并增加张量的秩。为了捕捉多模态相关性,以往的工作通过使用低秩性将数据投影到公共空间中。这些方法通常基于核范数最小化,如奇异值阈值(SVT)和Soft-Impture。除了核范数外,Fan等人还最小化了张量管状秩,以处理各种缺失模式。此外,Liang等人结合了非线性函数的优势,以学习张量秩最小化中的复杂相关性。然而,这些方法在处理大数据时通常计算成本较高。
基于DNN的补全(DNN-Based Imputation):由于DNN的生成能力,已出现几种基于DNN的模型来从部分观测到的输入中估计缺失的数据。
2.2 非补全方法
可分为:分组策略、相关性最大化以及无编码器模型
分组策略:完整数据比不完整数据更容易处理。分组策略直接将不完整数据划分为多个完整的子组,然后对每个子组独立进行特征学习。但子组的数量会随着模态数量的增加而呈指数级增长。因此,对于模态数量较多或样本量有限的数据,这种方法效果不佳
相关性最大化:为了处理不完整数据的问题,一种有效的方法是最大化不同模态之间的相关性。典型相关最大化、HGR相关最大化、互信息最大化和似然最大化
无编码器模型:与以往依赖编码器的模型不同,无编码器模型无需编码器即可学习潜在表示。它们直接优化潜在表示以重构模态不完整的数据,而无需考虑缺失模式。
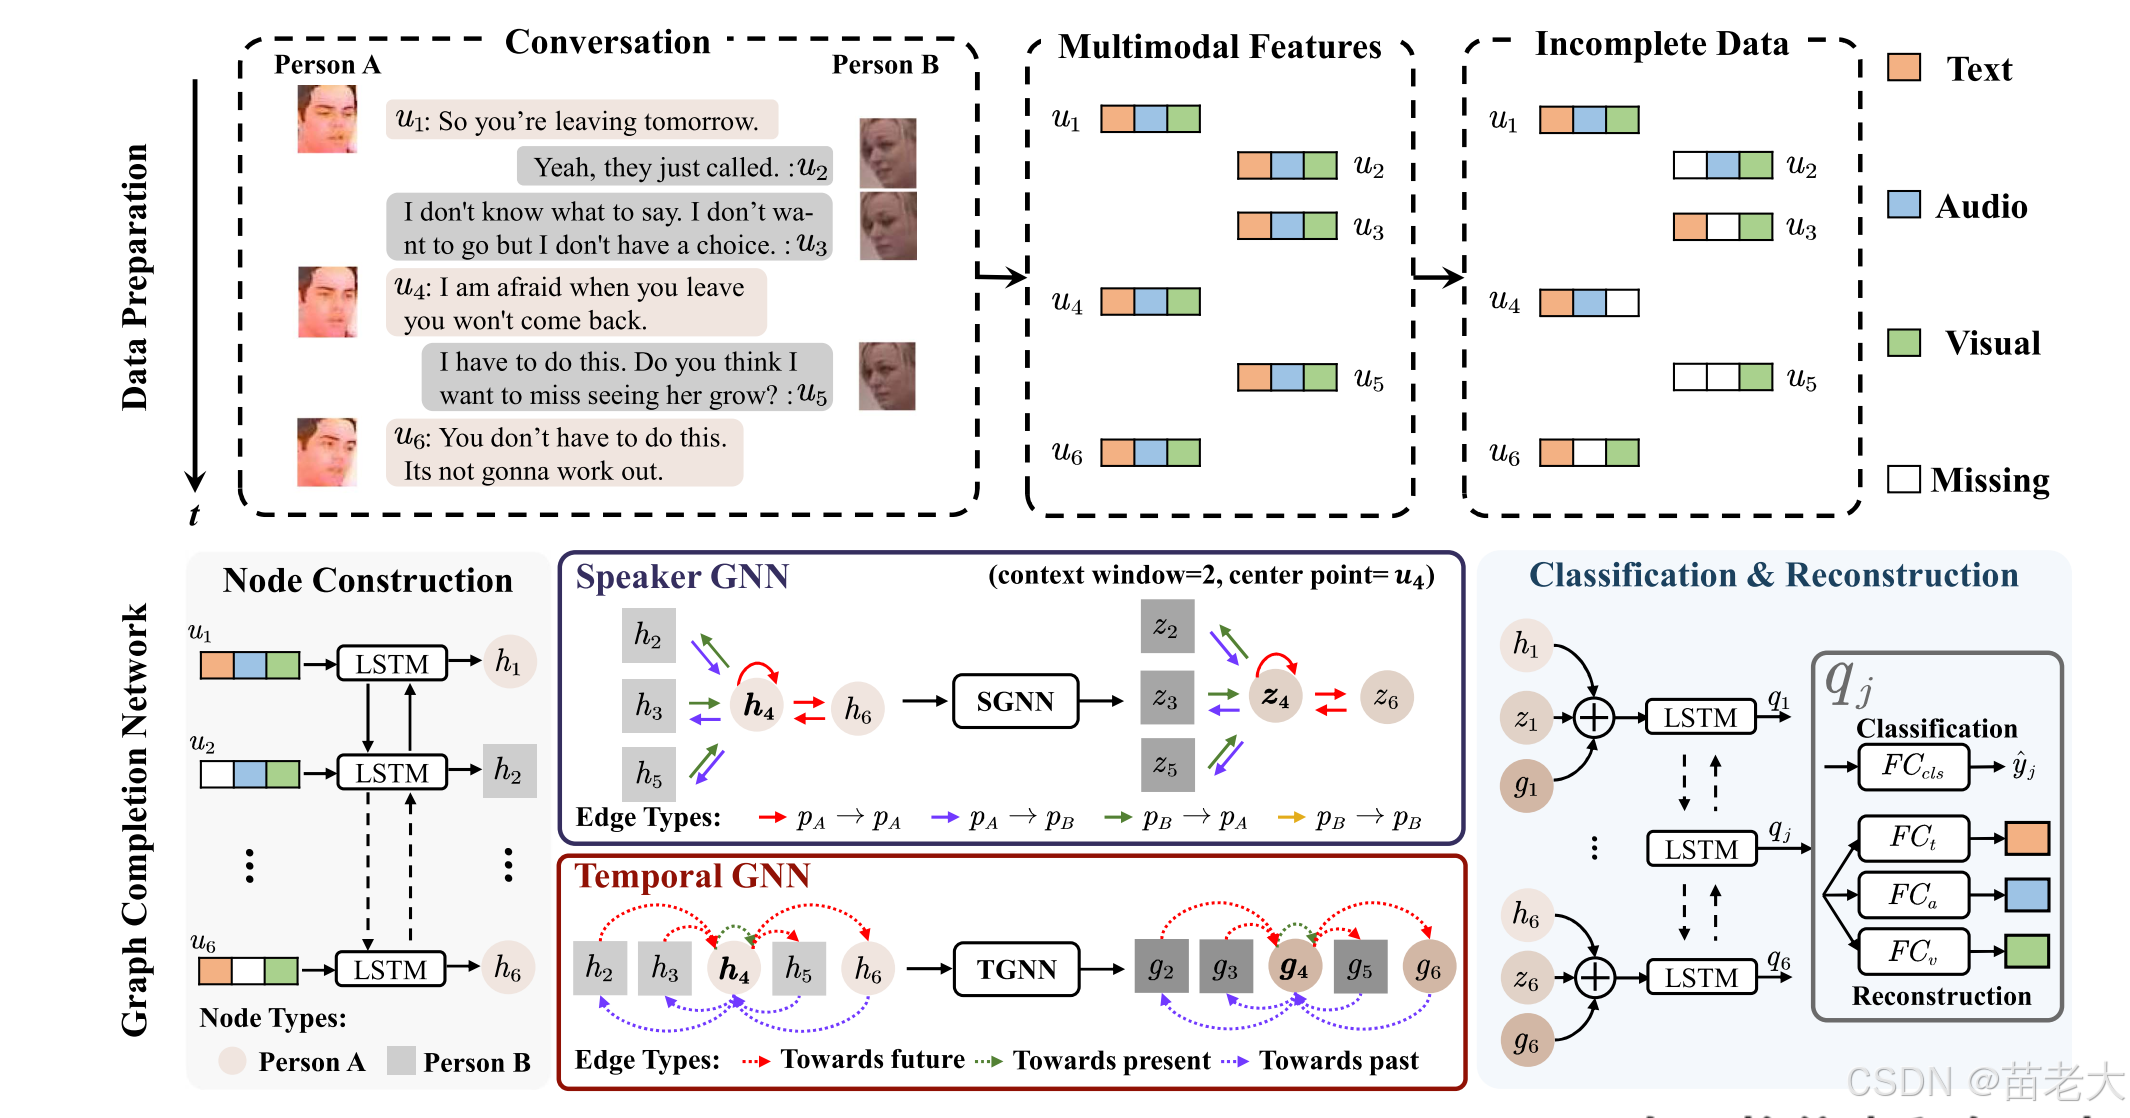
图1 具有三模态设置(M=3)的图补全网络(GCNet)的整体结构。该模型专注于基于不完整对话数据的分类任务。
3、方法
本文关注基于具有缺失模态的对话数据的分类任务。每个对话包含多个连续的话语。对于每个话语,首先提取具有随机缺失模式的多模态特征。然后,提出了一种新的基于图神经网络的框架GCNet,以处理不完整的对话数据。图1展示了本文所提方法的整体结构。
A. 数据准备
定义对话 其中L对话中的话语数量,
是C中第i个语句,
是
的真实标签,
c 是总标签数,每个话语
由说话者
发出,其中函数s(·)将话语的索引映射到其对应的说话者。对于每个话语
,提取多模态特征
,其中,
分别是声学、词汇和视觉模态的话语级特征,
是每个模态的特征维度。
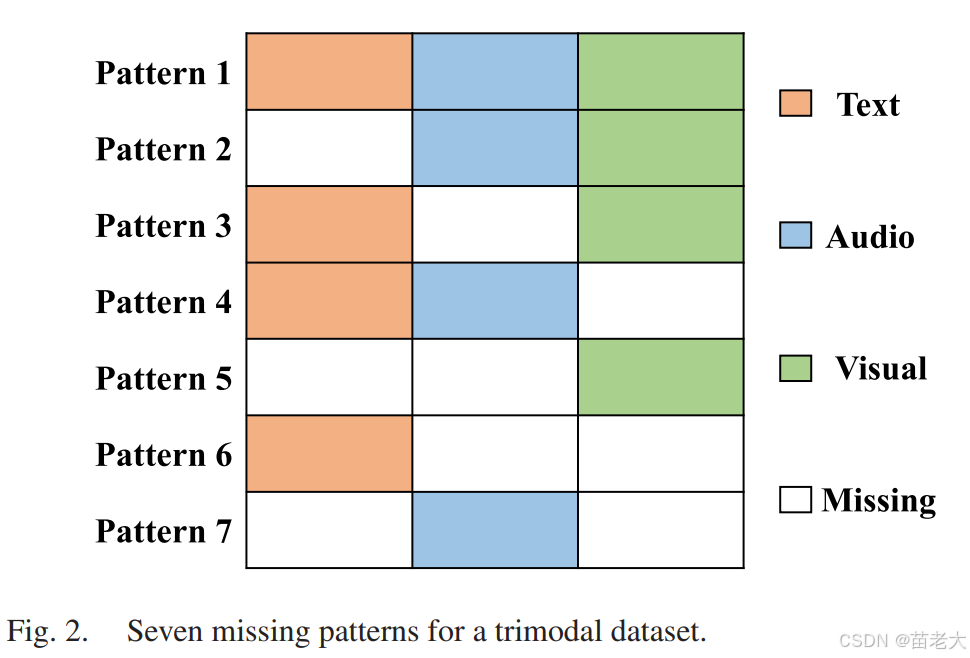
为了模拟现实世界中的缺失场景,我们随机丢弃一些模态,同时确保每个样本至少有一种模态是可用的,因此,一个不完整的M模态数据集有种不同的缺失模态,图2展示了一个具有七种缺失模式的三模态(M=3)数据集。假设
是
的缺失模式,
是一个将每个缺失模式映射到其可用模态的函数。
的不完整表示记为
,其中
定义如下:
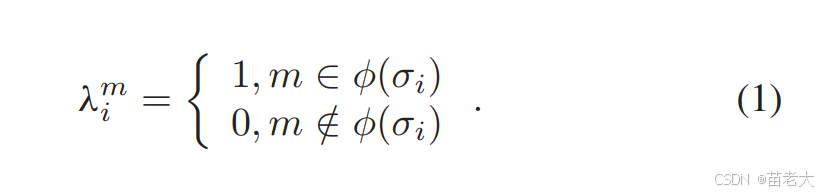
B 图补全网络
近期的研究已经验证了时间和说话者信息在对话中的重要性。为此,我们利用这些信息来提高不完整对话数据的分类性能。所提方法包含三个关键模块:节点构建、说话者与时间图神经网络(GNN)以及分类与重建。
1)节点构建。以具有缺失模态的对话数据作为输入。每个对话包含多个话语,将每个话语表示为一个节点
。为了提取
的初始表示,首先连接不完整的多模态特征
,然后使用双向长短期记忆(Bi-LSTM)来捕捉上下文信息。Bi-LSTM包含门控机制来控制信息的流动,能够建模前向和后向的长期上下文依赖
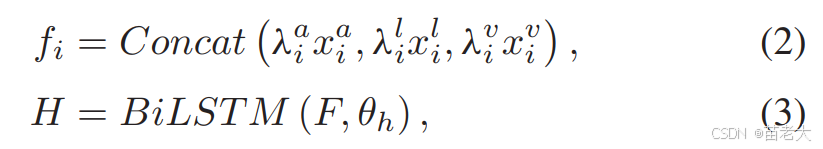
这里 和
是Bi-LSTM的输入和输出,d是输出特征的维度,
是可训练的参数。最后
被作为初始节点
2)Speaker & Temporal GNN: SGNN和TGNN是捕捉对话中说话者和时间依赖性的关键模块。在这些模块中,边用于衡量节点之间连接的重要性。边的类型定义了节点交互中不同的聚合方法。SGNN和TGNN共享相同的边,但使用不同的边类型来捕捉不同的依赖
边:对于每个节点,应考虑其与上下文节点的交互。如果每个节点与所有上下文节点
都进行交互,那么所设计的图将包含大量边,这将导致存储和优化变得困难。受先前工作启发,这些工作表明大多数话语都聚焦于其局部上下文,因此,将上下文窗口的大小固定为w,并且每个节点
仅与上下文窗口
内的节点进行交互。在我们的实现中,从{1, 2, 3, 4}中选择w的值。我们用
来表示从
到
的边。
说话者类型:SGNN利用说话者类型来捕捉对话中的说话者敏感依赖性。具体来说,为每个边分配一个说话者类型标识符
。这里,α表示说话者类型的集合,|α|表示α的数量。对于每条边
,
被设置为
,其中
分别表示
和
的说话者身份。如果对话中有S个不同的说话者,那么最多可以有|α| = S²种不同的说话者类型。
时间类型:TGNN(时序图神经网络)利用时间类型捕捉对话中的时间敏感依赖关系。具体来说,为每个边分配一个时间类型标识符
,
表示时间类型的集合,
是
中时间类型的数量,根据
和
在对话中出现位置的相对关系,将
的值确定为{过去、现在、未来},因此
.
图学习:近期的研究工作已经验证了关系图卷积网络(R-GCN)在处理关系建模问题上的有效性,因此,利用R-GCN来聚合图中的邻域信息。对静态图神经网络(SGNN)和时间图神经网络(TGNN),通过依赖边类型中的边来传递信息,计算公式如下:
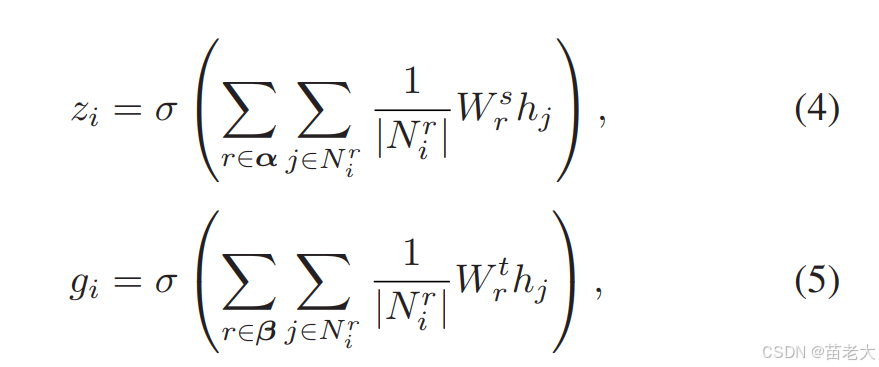
,
分别是SGNN和TGNN的输出,
是关系r下节点
的邻接索引集合。
是
的数量,σ(·) 是激活函数ReLU,
和
是SGNN和TGNN在关系r下的可训练的参数。
3)分类和重构:对于每个节点,提取初始特征
,
表示说话者信息,
表示时间信息。将这些信息拼在一起,然后利用Bi-LSTM进行上下文敏感建模:
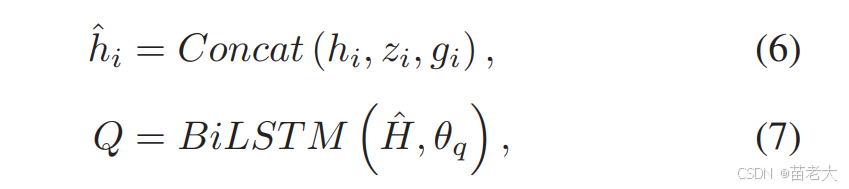
,
分别是Bi-LSTM的输入和输出,
是可训练的参数
分类:将 输入到全连接层,然后softmax层,以估计分类概率:4
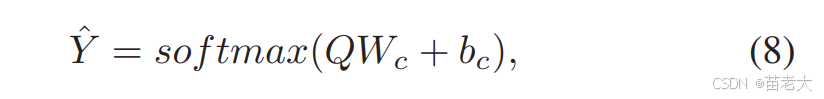
其中是估计概率,c是语料库中离散标签的数量。
和
是可训练的参数
重构:从潜在空间重构完整数据可以引导模型学习缺失部分的语义。因此,提出了模态重构模块。对于每个模态,( a l v 代表不同的模态,如音频、文本、视频等)。使用线性变换,将提取的特征映射回输入空间:
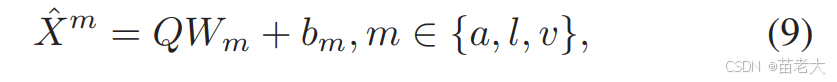
表示完整数据集,
,
是可训练的参数,
是每种模态的特征维度。
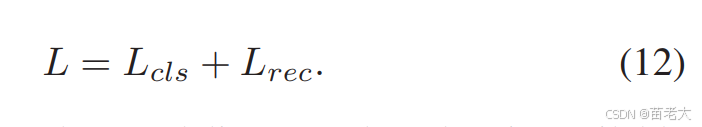
4)联合优化:为了同时利用完整数据和不完整数据,以端到端的方式联合优化分类和填补任务。因此,损失函数分为两部分:分类损失和重构损失
交叉熵损失作为分类损失
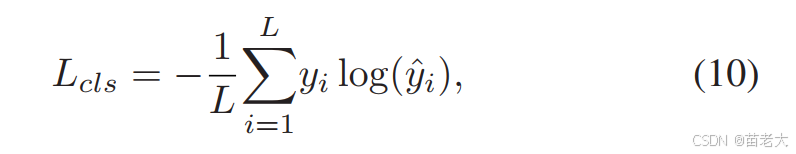
是真实的one-hot label
为了更好地从部分观测到的输入中估计缺失数据,计算了缺失位置处原始特征和填补后特征之间的重构损失。
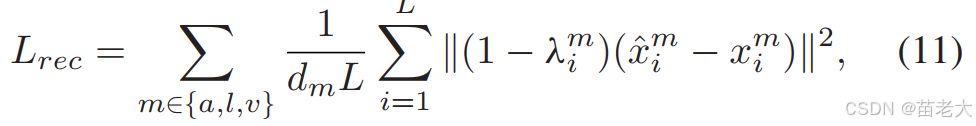
其中表示每个话语
可用的模态,如式(1)所定义的,因此,
是揭示缺失位置的掩码
最后,联合优化函数为:
4、实验数据集和实验步骤
所使用数据集为:IEMOCAP 、CMU-MOSI 、CMU-MOSEI
评估方法:F1-score;
实验细节
缺失率: ,
是第i个样本的可用模态数量,L表示样本总数,M表示模态总数,于每个具有M个模态的样本,都以概率η随机选择缺失的模态,同时,保证每个样本至少有一种模态可用,即
且
。如果有三种模态 M=3, 缺失率
从[0.0, 0.1, ... , 0.7],这里的0.7是
的近似值。在训练、验证和测试期间保持相同的缺失率。
由于CMU-MOSI和CMU-MOSEI数据集提供了训练/验证/测试划分,在验证集上选择最佳模型,并报告其在测试集上的性能。对于IEMOCAP数据集,使用五折交叉验证来调整所有参数。GCNet中有两个用户特定参数,即潜在表示的维度h和上下文窗口大小w。对于所有数据集,从{50, 100, 200}中选择h,从{1, 2, 3, 4}中选择w。在训练过程中,使用Adam优化方案,rl=0.001,权重衰减设置为0.00001。为了缓解过拟合问题,还使用了Dropout,其比率p = 0.5。由于GCNet以对话级别的特征作为输入,将同一小批量中的对话填充为具有相同数量的语句。同时,还实施了位掩码操作,以消除填充部分的影响。为了评估不同方法的性能,每个实验运行十次,并报告测试集上的平均值
模态特征提取
Acoustic Modality:使用预训练的wav2vec 作为声学特征提取器,利用预训练的wav2vec-large1为每个语句提取512维的声学特征。
Lexical Modality:采用预训练的DeBERTa作为词汇特征提取器,利用预训练的DeBERTa-large2将词序列编码为每个语句的1024维词汇特征
Visual Modality:使用预训练的MA-Net 作为视觉特征提取器,使用MTCNN人脸检测算法提取对齐的人脸图像,然后利用预训练的MA-Net3进行面部特征提取。最后,通过平均编码将帧级别的面部特征压缩为1024维的语句级别特征。
Baselines
基线模型有 CCA(典型相关分析)、DCCA(深度典型相关分析)、DCCAE(深度典型相关自编码器)、AE(自编码器)、CRA(级联残差自编码器)、MMIN(多模态不完整网络)、CPM-Net(完整性和结构保持网络)
5、结果和讨论
进行了对比实验和消融实验

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 14
 0
- 0


 已为社区贡献2条内容

所有评论(0)