【深度学习】知识蒸馏技术(上)简介
源文:https://cloud.tencent.com/developer/article/1814300
- 知识蒸馏介绍
1.1 什么是知识蒸馏?
在化学中,蒸馏是一种有效的分离不同沸点组分的方法,大致步骤是先升温使低沸点的组分汽化,然后降温冷凝,达到分离出目标物质的目的。化学蒸馏条件:(1)蒸馏的液体是混合物;(2)各组分沸点不同。
蒸馏的液体是混合物,这个混合物一定是包含了各种组分,即在我们今天讲的知识蒸馏中指原模型包含大量的知识。各组分沸点不同,蒸馏时要根据目标物质的沸点设置蒸馏温度,即在我们今天讲的知识蒸馏中也有“温度”的概念,那这个“温度“代表了什么,又是如何选取合适的”温度“?这里先埋下伏笔,在文中给大家揭晓答案。
进入我们今天正式的主题,到底什么是知识蒸馏?一般地,大模型往往是单个复杂网络或者是若干网络的集合,拥有良好的性能和泛化能力,而小模型因为网络规模较小,表达能力有限。因此,可以利用大模型学习到的知识去指导小模型训练,使得小模型具有与大模型相当的性能,但是参数数量大幅降低,从而实现模型压缩与加速,这就是知识蒸馏与迁移学习在模型优化中的应用。
Hinton等人最早在文章《Distilling the Knowledge in a Neural Network》中提出了知识蒸馏这个概念,其核心思想是先训练一个复杂网络模型,然后使用这个复杂网络的输出和数据的真实标签去训练一个更小的网络,因此知识蒸馏框架通常包含了一个复杂模型(被称为Teacher模型)和一个小模型(被称为Student模型)。
1.2 为什么要有知识蒸馏?
深度学习在计算机视觉、语音识别、自然语言处理等内的众多领域中均取得了令人难以置信的性能。但是,大多数模型在计算上过于昂贵,无法在移动端或嵌入式设备上运行。因此需要对模型进行压缩,且知识蒸馏是模型压缩中重要的技术之一。
- 提升模型精度
如果对目前的网络模型A的精度不是很满意,那么可以先训练一个更高精度的teacher模型B(通常参数量更多,时延更大),然后用这个训练好的teacher模型B对student模型A进行知识蒸馏,得到一个更高精度的A模型。
- 降低模型时延,压缩网络参数
如果对目前的网络模型A的时延不满意,可以先找到一个时延更低,参数量更小的模型B,通常来讲,这种模型精度也会比较低,然后通过训练一个更高精度的teacher模型C来对这个参数量小的模型B进行知识蒸馏,使得该模型B的精度接近最原始的模型A,从而达到降低时延的目的。
- 标签之间的域迁移
假如使用狗和猫的数据集训练了一个teacher模型A,使用香蕉和苹果训练了一个teacher模型B,那么就可以用这两个模型同时蒸馏出一个可以识别狗、猫、香蕉以及苹果的模型,将两个不同域的数据集进行集成和迁移。
因此,在工业界中对知识蒸馏和迁移学习也有着非常强烈的需求。
补充模型压缩的知识
模型压缩大体上可以分为 5 种:
模型剪枝:即移除对结果作用较小的组件,如减少 head 的数量和去除作用较少的层,共享参数等,ALBERT属于这种;
量化:比如将 float32 降到 float8;
知识蒸馏:将 teacher 的能力蒸馏到 student上,一般 student 会比 teacher 小。我们可以把一个大而深的网络蒸馏到一个小的网络,也可以把集成的网络蒸馏到一个小的网络上。
参数共享:通过共享参数,达到减少网络参数的目的,如 ALBERT 共享了 Transformer 层;
参数矩阵近似:通过矩阵的低秩分解或其他方法达到降低矩阵参数的目的;
1.3 这与从头开始训练模型有何不同?
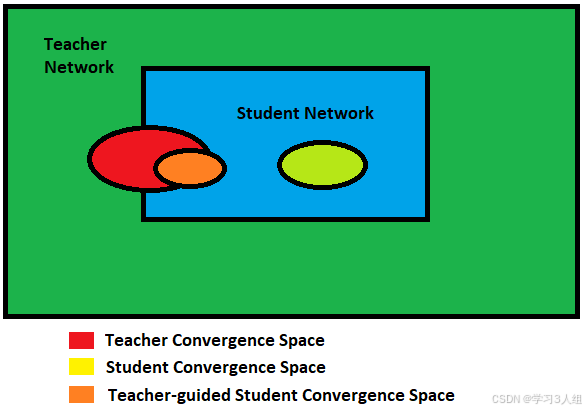
显然,对于更复杂的模型,理论搜索空间要大于较小网络的搜索空间。但是,如果我们假设使用较小的网络可以实现相同(甚至相似)的收敛,则教师网络的收敛空间应与学生网络的解空间重叠。
不幸的是,仅此一项并不能保证学生网络在同一位置收敛。学生网络的收敛可能与教师网络的收敛大不相同。但是,如果指导学生网络复制教师网络的行为(教师网络已经在更大的解空间中进行了搜索),则可以预期其收敛空间与原始教师网络收敛空间重叠。
2. 知识蒸馏方式
2.1 知识蒸馏基本框架
知识蒸馏采取Teacher-Student模式:将复杂且大的模型作为Teacher,Student模型结构较为简单,用Teacher来辅助Student模型的训练,Teacher学习能力强,可以将它学到的知识迁移给学习能力相对弱的Student模型,以此来增强Student模型的泛化能力。复杂笨重但是效果好的Teacher模型不上线,就单纯是个导师角色,真正部署上线进行预测任务的是灵活轻巧的Student小模型。
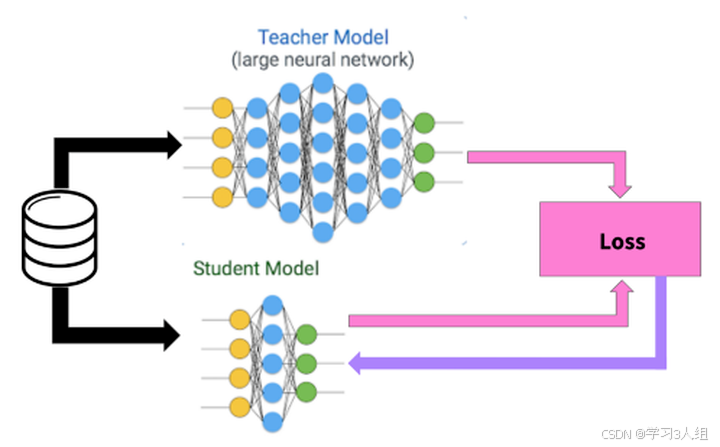
知识蒸馏是对模型的能力进行迁移,根据迁移的方法不同可以简单分为基于目标蒸馏(也称为Soft-target蒸馏或Logits方法蒸馏)和基于特征蒸馏的算法两个大的方向,下面我们对其进行介绍。
2.2 目标蒸馏-Logits方法
目标蒸馏方法中最经典的论文就是来自于2015年Hinton发表的一篇神作《Distilling the Knowledge in a Neural Network》。下面我们以这篇神作为例,给大家讲讲目标蒸馏方法的原理。
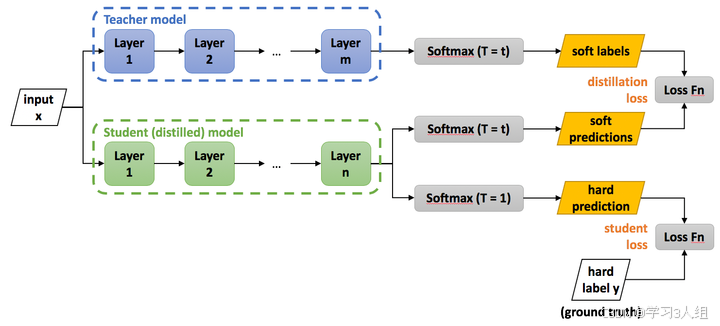
在这篇论文中,Hinton将问题限定在分类问题下,分类问题的共同点是模型最后会有一个softmax层,其输出值对应了相应类别的概率值。在知识蒸馏时,由于我们已经有了一个泛化能力较强的Teacher模型,我们在利用Teacher模型来蒸馏训练Student模型时,可以直接让Student模型去学习Teacher模型的泛化能力。一个很直白且高效的迁移泛化能力的方法就是:使用softmax层输出的类别的概率来作为“Soft-target” 。
2.2.1 Hard-target 和 Soft-target
传统的神经网络训练方法是定义一个损失函数,目标是使预测值尽可能接近于真实值(Hard- target),损失函数就是使神经网络的损失值和尽可能小。这种训练过程是对ground truth求极大似然。在知识蒸馏中,是使用大模型的类别概率作为Soft-target的训练过程。
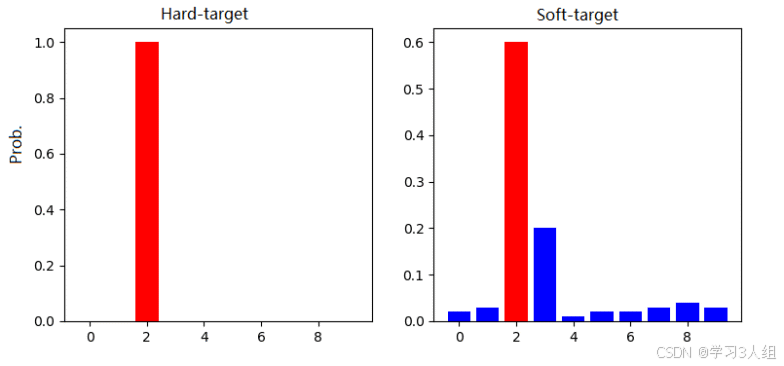
图:来源于参考文献2
Hard-target:原始数据集标注的 one-shot 标签,除了正标签为 1,其他负标签都是 0。
Soft-target:Teacher模型softmax层输出的类别概率,每个类别都分配了概率,正标签的概率最高。
知识蒸馏用Teacher模型预测的 Soft-target 来辅助 Hard-target 训练 Student模型的方式为什么有效呢?softmax层的输出,除了正例之外,负标签也带有Teacher模型归纳推理的大量信息,比如某些负标签对应的概率远远大于其他负标签,则代表 Teacher模型在推理时认为该样本与该负标签有一定的相似性。而在传统的训练过程(Hard-target)中,所有负标签都被统一对待。也就是说,知识蒸馏的训练方式使得每个样本给Student模型带来的信息量大于传统的训练方式。
如在MNIST数据集中做手写体数字识别任务,假设某个输入的“2”更加形似"3",softmax的输出值中"3"对应的概率会比其他负标签类别高;而另一个"2"更加形似"7",则这个样本分配给"7"对应的概率会比其他负标签类别高。这两个"2"对应的Hard-target的值是相同的,但是它们的Soft-target却是不同的,由此我们可见Soft-target蕴含着比Hard-target更多的信息。
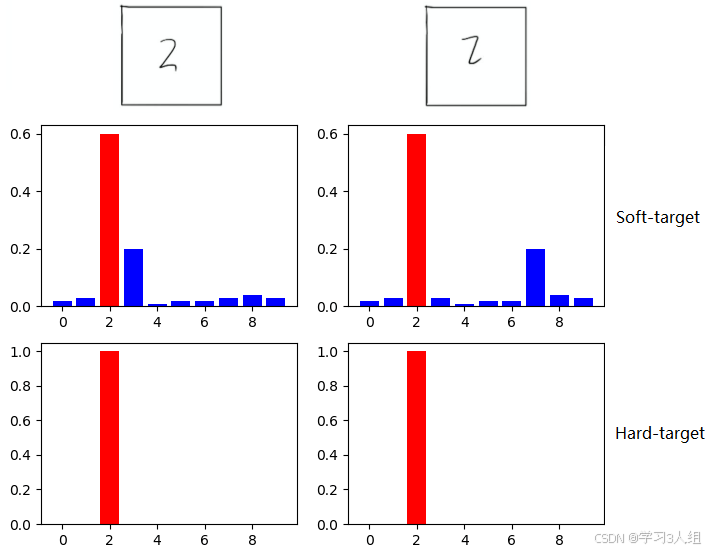
图:来源于参考文献2
在使用 Soft-target 训练时,Student模型可以很快学习到 Teacher模型的推理过程;而传统的 Hard-target 的训练方式,所有的负标签都会被平等对待。因此,Soft-target 给 Student模型带来的信息量要大于 Hard-target,并且Soft-target分布的熵相对高时,其Soft-target蕴含的知识就更丰富。同时,使用 Soft-target 训练时,梯度的方差会更小,训练时可以使用更大的学习率,所需要的样本也更少。这也解释了为什么通过蒸馏的方法训练出的Student模型相比使用完全相同的模型结构和训练数据只使用Hard-target的训练方法得到的模型,拥有更好的泛化能力。
2.2.2 知识蒸馏的具体方法
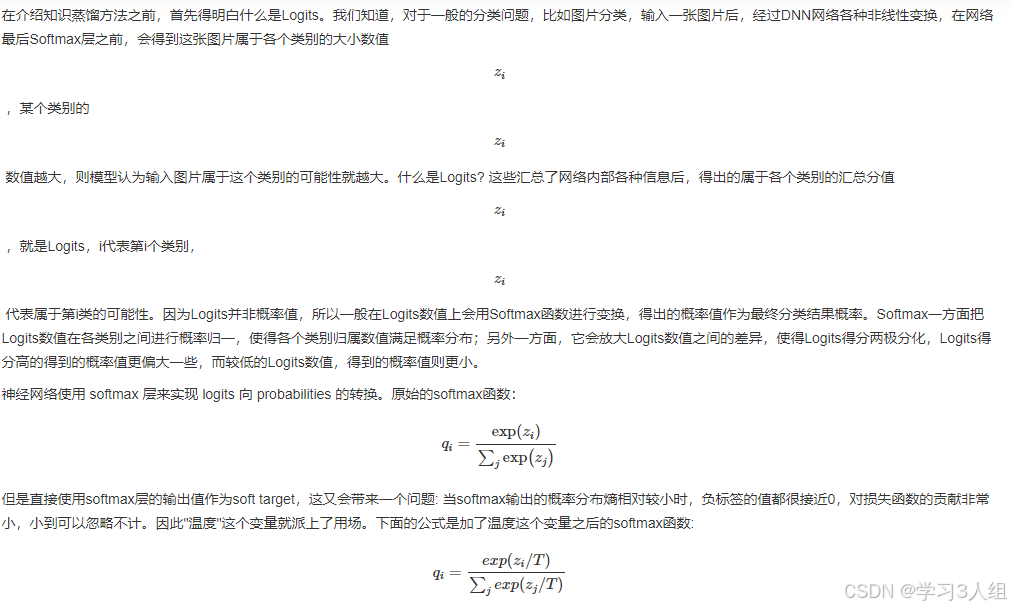
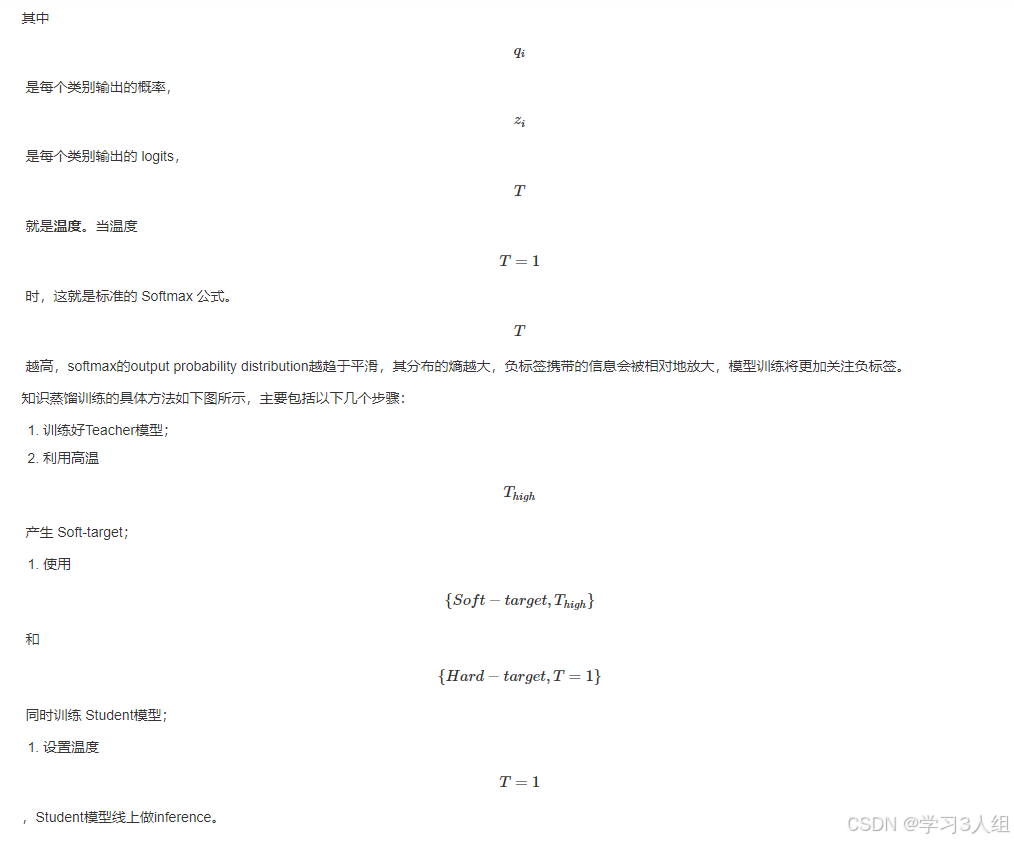
在介绍知识蒸馏方法之前,首先得明白什么是Logits。我们知道,对于一般的分类问题,比如图片分类,输入一张图片后,经过DNN网络各种非线性变换,在网络最后Softmax层之前,会得到这张图片属于各个类别的大小数值

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献7条内容

所有评论(0)