数据结构与算法实验7——查找表
7-1 电话聊天狂人
给定大量手机用户通话记录,找出其中通话次数最多的聊天狂人。
输入格式:
输入首先给出正整数N(≤105),为通话记录条数。随后N行,每行给出一条通话记录。简单起见,这里只列出拨出方和接收方的11位数字构成的手机号码,其中以空格分隔。
输出格式:
在一行中给出聊天狂人的手机号码及其通话次数,其间以空格分隔。如果这样的人不唯一,则输出狂人中最小的号码及其通话次数,并且附加给出并列狂人的人数。
输入样例:
4
13005711862 13588625832
13505711862 13088625832
13588625832 18087925832
15005713862 13588625832
输出样例:
13588625832 3
#include<bits/stdc++.h>
using namespace std;
map<string,int>mp;//创建映射mp,将字符串键映射到整数值
map<string,int>::iterator it;//创建迭代器it
int main()
{
    int n;
    scanf("%d",&n);
    while(n--)
    {
        string a,b;
        cin>>a>>b;
        mp[a]++;//a,b都为键,mp[a][b]为值
        mp[b]++;
    }
    int ren,max=0;
    string id;
    for(it=mp.begin();it!=mp.end();it++)//迭代器用于遍历,首先让它从映射的第一个元素开始遍历到最后一个
    {
        if(it->second>max)//it->second代表的是此元素的值
        {
            max=it->second;
            id=it->first;//it->first是此元素的键
            ren=1;
        }
        else if(it->second==max)//如果有并列的,就计并列人数+1
            ren++;
    }
    cout<<id<<" "<<max;
    if(ren>1)
        cout<<" "<<ren;
    return 0;
}
7-2 两个有序序列的中位数
已知有两个等长的非降序序列S1, S2, 设计函数求S1与S2并集的中位数。有序序列A0,A1,⋯,AN−1的中位数指A(N−1)/2的值,即第⌊(N+1)/2⌋个数(A0为第1个数)。
输入格式:
输入分三行。第一行给出序列的公共长度N(0<N≤100000),随后每行输入一个序列的信息,即N个非降序排列的整数。数字用空格间隔。
输出格式:
在一行中输出两个输入序列的并集序列的中位数。
输入样例1:
5
1 3 5 7 9
2 3 4 5 6
输出样例1:
4
输入样例2:
6
-100 -10 1 1 1 1
-50 0 2 3 4 5
输出样例2:
1
#include<bits/stdc++.h>
using namespace std;
int main()
{
    int n;
    scanf("%d",&n);
    int a[n*2];
    int i;
    for(i=0;i<n;i++)
    {
        cin>>a[i];
    }
    for(i=n;i<2*n;i++)
    {
        cin>>a[i];
    }
    sort(a,a+n*2);
    cout<<a[n-1];
    return 0;
}
7-3 词频统计
请编写程序,对一段英文文本,统计其中所有不同单词的个数,以及词频最大的前10%的单词。
所谓“单词”,是指由不超过80个单词字符组成的连续字符串,但长度超过15的单词将只截取保留前15个单词字符。而合法的“单词字符”为大小写字母、数字和下划线,其它字符均认为是单词分隔符。
输入格式:
输入给出一段非空文本,最后以符号#结尾。输入保证存在至少10个不同的单词。
输出格式:
在第一行中输出文本中所有不同单词的个数。注意“单词”不区分英文大小写,例如“PAT”和“pat”被认为是同一个单词。
随后按照词频递减的顺序,按照词频:单词的格式输出词频最大的前10%的单词。若有并列,则按递增字典序输出。
输入样例:
This is a test.

The word "this" is the word with the highest frequency.

Longlonglonglongword should be cut off, so is considered as the same as longlonglonglonee.  But this_8 is different than this, and this, and this...#
this line should be ignored.
输出样例:
(注意:虽然单词the也出现了4次,但因为我们只要输出前10%(即23个单词中的前2个)单词,而按照字母序,the排第3位,所以不输出。)
23
5:this
4:is
感谢武汉理工大学的郭小兵老师修正测试数据!
#include<bits/stdc++.h>
using namespace std;
typedef pair<string,int>word;//把string和int绑在一起,叫word
map<string,int>mp;
map<string,int>::iterator it;
vector<word>q;
int cmp(word a,word b)
{
    if(a.second!=b.second)
        return a.second>b.second;
    else
        return a.first<b.first;
}//排序函数,如果频率大,就输出频率大的,相同的话就输出字母序
int main()
{
    char x;
    string a;
    while(scanf("%c",&x)&&x!='#')
    {
        if((x>='A'&&x<='Z')||(x>='a'&&x<='z')||(x>='0'&&x<='9')||x=='_')
        {
            if(x>='A'&&x<='Z')
                x=x-'A'+'a';//先把大写转化为小写
            if(a.size()<15)
                a=a+x;
        }
        else if(a.size()>0)
        {
            mp[a]++;//如果不是合法字符,而且还有字符的话就把之前已经统计的字符+1
            a.clear();//然后清空字符
        }
    }
    for(it=mp.begin();it!=mp.end();it++)
    {
        q.push_back({it->first,it->second});
    }
    sort(q.begin(),q.end(),cmp);
    cout<<q.size()<<endl;
    int l=q.size()/10;
    for(int i=0;i<l;i++)
    {
        cout<<q[i].second<<':'<<q[i].first<<endl;
    }
    return 0;
}
7-4 集合相似度
给定两个整数集合,它们的相似度定义为:Nc/Nt×100%。其中 Nc 是两个集合都有的不相等整数的个数,Nt 是两个集合一共有的不相等整数的个数。你的任务就是计算任意一对给定集合的相似度。
输入格式:
输入第一行给出一个正整数 n(≤50),是集合的个数。随后 n 行,每行对应一个集合。每个集合首先给出一个正整数 m(≤104),是集合中元素的个数;然后跟 m 个 [0,109] 区间内的整数。
之后一行给出一个正整数 k(≤2000),随后 k 行,每行对应一对需要计算相似度的集合的编号(集合从 1 到 n 编号)。数字间以空格分隔。
输出格式:
对每一对需要计算的集合,在一行中输出它们的相似度,为保留小数点后 2 位的百分比数字。
输入样例:
3
3 99 87 101
4 87 101 5 87
7 99 101 18 5 135 18 99
2
1 2
1 3
输出样例:
50.00%
33.33%
#include<bits/stdc++.h>
using namespace std;
set<int>st[55];//set是元素集合容器
int main()
{
    int n;
    cin>>n;
    for(int i=1;i<=n;i++)
    {
        int m;
        cin>>m;
        while(m--)
        {
            int x;
            cin>>x;
            st[i].insert(x);//将x插入集合内,当i=1时,就是插入了第一个集合内
        }
    }
    int k;
    cin>>k;
    while(k--)
    {
        int a,b,cnt=0;
        cin>>a>>b;
        for(auto i:st[a])//auto时编译器自动根据st[a]的类型给i定类型
        {
            if(st[b].find(i)!=st[b].end())//find函数是返回集合内i出现的第一个位置,如果没有的话就返回end(),所以如果不等于的end的话就是找到了,也就是重合了,cnt+1
            {
                cnt++;
            }
        }
        double rate=100.0*cnt/(st[a].size()+st[b].size()-cnt);//整除运算符 (/)需要注意的就是运算结果会自动转换为与被除数一致的数据类型
        printf("%.2f%\n",rate);
    }
    return 0;
}
7-5 悄悄关注
新浪微博上有个“悄悄关注”,一个用户悄悄关注的人,不出现在这个用户的关注列表上,但系统会推送其悄悄关注的人发表的微博给该用户。现在我们来做一回网络侦探,根据某人的关注列表和其对其他用户的点赞情况,扒出有可能被其悄悄关注的人。
输入格式:
输入首先在第一行给出某用户的关注列表,格式如下:
人数N 用户1 用户2 …… 用户N
其中N是不超过5000的正整数,每个用户i(i=1, ..., N)是被其关注的用户的ID,是长度为4位的由数字和英文字母组成的字符串,各项间以空格分隔。
之后给出该用户点赞的信息:首先给出一个不超过10000的正整数M,随后M行,每行给出一个被其点赞的用户ID和对该用户的点赞次数(不超过1000),以空格分隔。注意:用户ID是一个用户的唯一身份标识。题目保证在关注列表中没有重复用户,在点赞信息中也没有重复用户。
输出格式:
我们认为被该用户点赞次数大于其点赞平均数、且不在其关注列表上的人,很可能是其悄悄关注的人。根据这个假设,请你按用户ID字母序的升序输出可能是其悄悄关注的人,每行1个ID。如果其实并没有这样的人,则输出“Bing Mei You”。
输入样例1:
10 GAO3 Magi Zha1 Sen1 Quan FaMK LSum Eins FatM LLao
8
Magi 50
Pota 30
LLao 3
Ammy 48
Dave 15
GAO3 31
Zoro 1
Cath 60
输出样例1:
Ammy
Cath
Pota
输入样例2:
11 GAO3 Magi Zha1 Sen1 Quan FaMK LSum Eins FatM LLao Pota
7
Magi 50
Pota 30
LLao 48
Ammy 3
Dave 15
GAO3 31
Zoro 29
输出样例2:
Bing Mei You
#include<bits/stdc++.h>
using namespace std;
set<string>st;
map<string,int>mp;
vector<string>qq;
int main()
{
    string s;
    int n;
    cin>>n;
    for(int i=0;i<n;i++)
    {
        cin>>s;
        st.insert(s);
    }
    int m;
    cin>>m;
    int d,sum=0;
    for(int i=0;i<m;i++)
    {
        cin>>s;
        cin>>d;
        mp[s]=d;
        sum=sum+d;
    }//这里为什么必须要用for循环,而改成while循环就不对了呢
    double aver=1.0*sum/m;
    for(auto i:mp)
    {
        string name=i.first;
        int cnt=i.second;
        if(cnt>aver&&st.find(name)==st.end())
        {
            qq.push_back(name);
        }
    }
        if(qq.empty())
            printf("Bing Mei You");
        else
        {
            sort(qq.begin(),qq.end());
            for(auto i:qq)
                cout<<i<<endl;
        }
    return 0;
}
7-6 单身狗
“单身狗”是中文对于单身人士的一种爱称。本题请你从上万人的大型派对中找出落单的客人,以便给予特殊关爱。
输入格式:
输入第一行给出一个正整数 N(≤50000),是已知夫妻/伴侣的对数;随后 N 行,每行给出一对夫妻/伴侣——为方便起见,每人对应一个 ID 号,为 5 位数字(从 00000 到 99999),ID 间以空格分隔;之后给出一个正整数 M(≤10000),为参加派对的总人数;随后一行给出这 M 位客人的 ID,以空格分隔。题目保证无人重婚或脚踩两条船。
输出格式:
首先第一行输出落单客人的总人数;随后第二行按 ID 递增顺序列出落单的客人。ID 间用 1 个空格分隔,行的首尾不得有多余空格。
输入样例:
3
11111 22222
33333 44444
55555 66666
7
55555 44444 10000 88888 22222 11111 23333
输出样例:
5
10000 23333 44444 55555 88888
#include<bits/stdc++.h>
using namespace std;
int t[10086];
map<int,int>mp;
set<int>st;
vector<int>a;
int main()
{
    int n;
    cin>>n;
    for(int i=0;i<n;i++)
    {
        int a,b;
        cin>>a>>b;
        mp[a]=b;
        mp[b]=a;
    }
    int m,cnt=0;
    cin>>m;
    for(int i=0;i<m;i++)
    {
        cin>>t[i];
        st.insert(t[i]);
    }
    for(int i=0;i<m;i++)
    {
        if(st.find(mp[t[i]])==st.end())
        {
            cnt++;
            a.push_back(t[i]);
        }
    }
    sort(a.begin(),a.end());
    cout<<a.size()<<endl;
    int flag=0;
    for(auto i:a)
    {
        if(flag)
            printf(" ");
        printf("%05d",i);
        flag++;
    }
    return 0;
}
7-7 这是二叉搜索树吗?
一棵二叉搜索树可被递归地定义为具有下列性质的二叉树:对于任一结点,
- 其左子树中所有结点的键值小于该结点的键值;
- 其右子树中所有结点的键值大于等于该结点的键值;
- 其左右子树都是二叉搜索树。
所谓二叉搜索树的“镜像”,即将所有结点的左右子树对换位置后所得到的树。
给定一个整数键值序列,现请你编写程序,判断这是否是对一棵二叉搜索树或其镜像进行前序遍历的结果。
输入格式:
输入的第一行给出正整数 N(≤1000)。随后一行给出 N 个整数键值,其间以空格分隔。
输出格式:
如果输入序列是对一棵二叉搜索树或其镜像进行前序遍历的结果,则首先在一行中输出 YES ,然后在下一行输出该树后序遍历的结果。数字间有 1 个空格,一行的首尾不得有多余空格。若答案是否,则输出 NO。
输入样例 1:
7
8 6 5 7 10 8 11
输出样例 1:
YES
5 7 6 8 11 10 8
输入样例 2:
7
8 10 11 8 6 7 5
输出样例 2:
YES
11 8 10 7 5 6 8
输入样例 3:
7
8 6 8 5 10 9 11
输出样例 3:
NO
#include<bits/stdc++.h>
using namespace std;
int num[1010],n,pre[1010];
int flag=1;
void dfs(int l,int r){
    if(l>r)return;
    int i=l+1,j=r;
    if(flag){
        while(i<=r&&pre[i]<pre[l])i++;
        while(j>l&&pre[j]>=pre[l]) j--;
    }else {
        while(i<=r&&pre[i]>=pre[l])i++;
        while(j>l&&pre[j]<pre[l])j--;
    }
    dfs(l+1,j);
    dfs(i,r);
    num[++num[0]]=pre[l];
}
int main(){
    cin>>n;
    int i,k,j;
    for(i=1;i<=n;i++)
        cin>>pre[i];
    dfs(1,n);
    if(num[0]!=n){
        flag=0;
        num[0]=0;
        dfs(1,n);
    }
    if(num[0]!=n)cout<<"NO";
    else{
        cout<<"YES\n"<<num[1];
        for(i=2;i<=num[0];i++)
            cout<<" "<<num[i];
    }
}
7-8 二叉搜索树
对于一个无穷的满二叉排序树(如图),节点的编号是1,2,3,…。对于一棵树根为X的子树,沿着左节点一直往下到最后一层,可以获得该子树编号最小的节点;沿着右节点一直往下到最后一层,可以获得该子树编号最大的节点。现在给出的问题是“在一棵树根为X的子树中,节点的最小编号和最大编号是什么?”。请你给出答案。
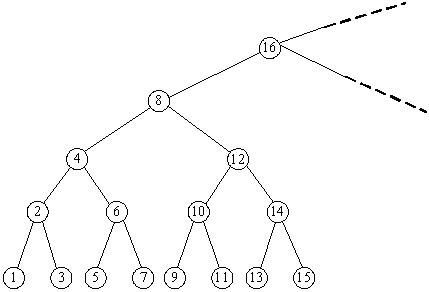
输入格式:
输入的第一行给出测试用例的数目,一个整数N。在后面的N行中,每行给出一个整数X(1<=X<=231-1),表示子树树根的编号。
输出格式:
输出N行,第i行给出第i个问题的答案。
输入样例:
2
8
10
输出样例:
1 15
9 11
#include<bits/stdc++.h>
int getheight(int x)
{
    int height=0;
    while(x%2==0)
    {
        x=x/2;
        height++;
    }
    return height;
}
int main()
{
    int n;
    scanf("%d",&n);
    for(int i=0;i<n;i++)
    {
        int x;
        scanf("%d",&x);
        int max,min;
        max=min=x;
        int p=1;
        int height=getheight(x);
        for(int j=0;j<height;j++)
        {
            min=min-p;
            max=max+p;
            p=p*2;
        }
        printf("%d %d\n",min,max);
    }
    return 0;
}
7-9 词典
你刚从滑铁卢搬到了一个大城市,这里的人们讲一种难以理解的外语方言。幸运的是,你有一本字典来帮助你理解它们。
输入格式:
输入第一行是正整数N和M,后面是N行字典条目(最多10000条),然后是M行要翻译的外语单词(最多10000个)。每一个字典条目都包含一个英语单词,后面跟着一个空格和一个外语单词。
输入中的每个单词都由最多10个小写字母组成。
输出格式:
输出翻译后的英文单词,每行一个单词。非词典中的外来词汇输出“eh”。
输入样例:
5 3
dog ogday
cat atcay
pig igpay
froot ootfray
loops oopslay
atcay
ittenkay
oopslay
输出样例:
cat
eh
loops
#include<bits/stdc++.h>
using namespace std;
map<string,string>f;
int main()
{
    int m,n;
    cin>>n>>m;
    while(n--)
    {
        string a,b;
        cin>>a>>b;
        f[b]=a;
    }
    while(m--)
    {
        string x;
        cin>>x;
        if(f.count(x))
            cout<<f[x]<<endl;
        else
            cout<<"eh"<<endl;
    }
    return 0;
}
7-10 二分查找
输入n值(1<=n<=1000)、n个非降序排列的整数以及要查找的数x,使用二分查找算法查找x,输出x所在的下标(0~n-1)及比较次数。若x不存在,输出-1和比较次数。
输入格式:
输入共三行:
第一行是n值;
第二行是n个整数;
第三行是x值。
输出格式:
输出x所在的下标(0~n-1)及比较次数。若x不存在,输出-1和比较次数。
输入样例:
4
1 2 3 4
1
输出样例:
0
2
#include<bits/stdc++.h>
using namespace std;
int a[1005];
int main(){
    int n,i,x,y=0,l,r,k=0,mid;
    cin>>n;
    for(i=0;i<n;i++)cin>>a[i];
    cin>>x;
     for(i=0;i<n;i++){
         if(x==a[i]){k=1;break;}
     }
    l=0;r=n-1;
    while(l<=r){
         y++;
        mid=(l+r)/2;
        if(a[mid]>x)r=mid-1;
        else l=mid+1;
    }
    if(k==1) cout<<mid<<endl<<y;
    else cout<<"-1\n"<<y;
    return 0;
}

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 32
 0
- 0


 已为社区贡献6条内容

所有评论(0)