【数据结构与算法】线性表链式存储结构
线性表链式存储结构
文章目录
前面所讲的顺序存储结构,简而言之就是相邻两个元素的存储位置具有邻居关系,它们在内存中的位置是紧挨着的,中间没有间隔,无法快速的插入和删除。那么,我们换一种方法,哪里有空位我们就放哪里,利用指针对元素进行定位,所有的元素就可以通过遍历来找到了。本篇文章,我将详细的介绍线性表的另外一种存储结构——链式存储结构。
链式存储结构
- 定义
-
结点:线性表的链式存储结构的特点是,用一组任意的存储单元存储线性表的数据元素(这组存储单元可以是连续的,也可以是不连续的),因此,为了表示某个数据元素a i与它的直接后继元素a i + 1 之间的逻辑关系,对数据元素a i 来说,除存储其本身的信息之外,还需要存储一个指示它直接后继的信息(即直接后继的存储位置),这两部分信息组成数据元素a i 的存储映像,称为结点(node)。
-
它包括两个域:其中存储数据元素信息的域称为数据域,存储直接后继存储位置的域称为指针域,指针域中存储的信息称为指针或链,n 个结点(a i (1<=i<=n)的存储映像)链结成一个链表,即为线性表的链式存储结构。data的类型根据具体问题,next的类型是(data类型的)指针
-
头指针:是指向链表中第一个结点的指针
-
头结点:它是链表中的辅助结点,只包含指向第0个数据元素的指针,而没有数据信息,头结点有简化代码的作用,因为它始终指向了第0个元素,便于执行时对元素位置的定位。
-
首元结点:是指链表中存储第一个数据元素a1的结点
-
尾结点:尾结点中存储的地址信息可以用于区分链表类型。尾指针为空:单链表。尾指针指向链表的开头:循环链表。为随机值:非法链表。
-
数据结点:它是链表中代表数据元素的结点,表现为数据域和指针域。

- 特点
- 结点在存储器中的位置是任意的,即逻辑上相邻的数据元素在物理上不一定相邻。
- 访问时只能通过头指针进入链表,并通过每个结点的指针域依次向后顺序扫描其余结点,所以寻找到一个结点和最后一个结点所花费的时间不等。这种存取元素的方法称为顺序存储法
- 分类
- 单链表: 每个结点只包含直接后继的地址信息,结点只有一个指针域的链表。
- 循环链表:单链表的最后一个结点的直接后继为第一给结点(首尾相接)
- 双向链表:单链表中的结点包含直接前驱和后继的地址信息(结点有两个指针域 )

*头结点和头指针
上文我们提到了,头结点的数据域一般不存储任何信息,这是它作为第一个结点的特性。但是一个链表中不一定有头结点:

那么这个时候就会有疑惑了,既然头结点的数据域不存储任何信息,那么头指针和头结点又有什么异同呢?
- 头指针
- 头指针是指链表指向第一个结点的指针,若链表有头结点,则是指向头结点的指针。
- 头指针具有标识作用,所以常用头指针冠以链表的名字(指针变量的名字)
- 无论链表是否为空,头指针均不为空。
- 头指针是链表的必要元素。
- 头结点
- 头结点是为了操作的统一和方便而设立的,放在第一个元素的结点之前,其数据域一般无意义(但也可以用来存放链表的长度),但此结点不能计入链表长度值。
- 有了头结点,对在第一个元素结点前插入结点和删除第一结点起操作域其他结点从操作就统一了。
- 头结点不一定是链表的必须要素。
那么,在链表中设置头结点有什么好处呢?
便于首元结点的处理
首元结点的地址保存在头结点的指针域中,所以在链表的第一个位置上的操作和其他位置一致,无需进行处理
便于空表和非空表的统一处理
无论链表是否为空,头指针都是指向头结点的非空指针,因此空表和非空表的处理也就统一了。
一.线性链表(单链表)
1.1定义
单链表是由表头唯一确定的,因此单链表可以用头指针的名字来命名。若头指针名是L,则把链表称为表L。
带头结点的单链表

我们在C语言中可以用结构指针来描述单链表:
typedef struct Node{//声明结点的类型和指向结点的指针类型
    ElemType data;//结点的数据域
    struct Node* Next;//结点的指针域
}Node;
typedef struct Node* LinkList;//LinkList为指向结构体Lnode的指针类型
- 定义链表L:
LinkList L - 定义结点指针p:
LNode *p或LinkList p
为了统一链表的操作,通常我们这样定义:先将数据域中要存储的多个数据项定义成一个结构类型,然后直接用这个结构类型来定义这个数据域data.
实例:存储学生学号,姓名,成绩的单链表结点类型定义如下:
typedef Struct{
    char num[8];//数据域
    char name[8];//数据域
    int score;//数据域
}ElemType;
typedef struct Lnode{
    ElemType data;//数据域
    struct Londe* next;//指针域
}Lnode;
typedef struct Node* LinkList;
1.2初始化
1.2.1带头结点的初始化
算法思路:构造一个空表:从内存中找到头结点,用指针变量L指向头结点,给结点的指针域置空。
typedef struct LNode{//定义单链表结点类型
    ElemType data;//每个结点存放一个数据元素
    struct LNode* next;//指针指向下一个结点
}LNode;
typedef struct LNode* LinkList;

//初始化一个单链表(带头结点)
bool InitList(LinkList &L){
    L=(LNode*)malloc(sizeof(LNode));//分配一个头结点
    if(L==NULL){//内存分配不足,分配失败
        return false;
    }
    L->next=NULL;//建立空的单链表,结点之后暂时还没有结点
    return true;
}//bool类型函数返回true或false

void test(){
    LinkList L;//声明一个指向单链表的指针
    //初始化一个空表
    InitList(L);
    ……
}
注意:
L是指向单链表的头结点的指针,用来接收主程序中待初始化单链表的头指针变量的地址
*L相当于主程序中待初始化单链表的头指针变量
1.2.2不带头结点的初始化
typedef struct LNode{//定义单链表结点类型
    ElemType data;//每个结点存放一个数据元素
    struct LNode* next;//指针指向下一个结点
}LNode;
typedef struct Lnode* LinkList;

//初始化一个空的单链表
bool InitList(LinkList &L){
    L=NULL;//空表,暂时没有任何结点(防止脏数据)
    return true;
}

void test(){
    LinList L;//声明一个指向单链表的指针
    //初始化空表
    InitList(L);
    ……
}

//判断单链表是否为空
bool Empty(LinkList L){
    if(L==NULL){
        return true;
    }else{
        return false;
    }
}
由此可见这两种情况下判断空表的方法:
- 无头结点时,头指针为空时表示空表
- 有头结点时,当头结点的指针域为空时表示空表

1.3插入
1.3.1按位序插入
在表L中的第i个位置上插入指定元素。那么就要找到第i-1个结点的存储位置p,生成一个数据域为e的新结点t,然后将新结点插入其后面:新结点的指针域指向ai,结点ai-1的指针域指向新结点。注意:这两步操作不能交换顺序,不然会丢失ai的地址。
- 带头结点:

typedef struct LNode{           //定义单链表节点类型
    ElemType data;              //每个节点存放一个数据元素
    struct LNode *next;         //指针指向下一个节点
}LNode, *LinkList

//在第i个位置插入元素e(带头结点)
bool ListInsert(LinkList &L, int i, ElemType e){
    if(i<1){
        return false;
    }
    if(i==1){
        LNode *t = (LNode *)malloc(sizeof(LNode));
        t->data = e;
        t->next = L;
        L = t:      //头指针指向新结点
        return true;
    }
    LNode *p;       //指针p指向当前扫描的结点
    int j = 1;      //当前p指向的是第几个结点
    p = L;          //p指向第一个结点(注意:不是头结点)
    while(p != NULL && j<i-1){      //循环找到第i-1个结点
        p = p->next;
        j++;
    }
    if(p == NULL){      //i值不合法
        return false;
    }
    LNode *t = (LNode *)malloc(sizeof(LNode));
    t->data = e;
    t->next = p->next;
    p->next = t;
    return true;        //插入成功
}
- 不带头结点:

typedef struct LNode{//定义单链表结点类型
    ElemType data;//每个结点存放一个数据元素
    struct LNode* next;//指针指向下一个结点
}LNode;
typedef struct LNode* LinkList;

//在第i个位置插入元素e(不带头结点)
bool ListInsert(LinkList &L,int i,ElemType e){//参数可以是各种类型
    if(i<1){
        return false;
    }
    LNode* p;//指针p指向当前扫描的结点
    int j=0;//当前p指针的是第几个结点
    while(p!=NULL && j<i-1){//循环找到第i-1个结点
        p=p->next;
        j++;
    }
    if(p==NULL){//i值不合法
        return false;
    }
    LNode* t=(LNode*)malloc(sizeof(LNode));//给结点t分配空间
    t->data=e;//给结点t的data赋值为e
    t->next=p->next;//结点t的指针赋值为当前结点p的下一个结点
    p->next=t;//将结点t连接到p之后
    return true;//插入成功
}
当i=1时,执行插入操作所需要的时间复杂度为T(n)=O(1)
当i>1 && i<=n时,时间复杂度为T(n)=O(n)
但是,值得注意的是,实际上插入这个操作真正的时间复杂度为T(n)=O(1),而程序运行所耗费时间都在找到要插入的元素位置的前一个位置,所以综合考究:
📌平均时间复杂为T ( n ) = O ( n )
1.3.2指定结点的后插入操作
创建新结点t,为t分配内存,将要插入的数据元素e保存到t中,将结点t连接到p之后
typedef struct LNode{           //定义单链表节点类型
    ElemType data;              //每个节点存放一个数据元素
    struct LNode *next;         //指针指向下一个节点
}LNode, *LinkList

//后插操作:在p结点之后插入元素e
bool InsertNextNode(LNode *p, ElemType e){
    if(p == NULL){
        return false;
    }
    LNode *t = (LNode *)malloc(sizeof(LNode));
    if(s==NULL){        //内存分配失败
        return false;
    }
    t->data = e;        //用结点t保存数据元素e
    t->next = p->next;
    p->next = t         //将结点t连接到p之后
    return true;
}
📌平均时间复杂度为T ( n ) = O ( 1 )
1.3.3指定结点的前插入操作
创建新结点t,为t分配内存,先将结点t连接到p之后,将原来p中的数据元素复制到t中,将p中数据元素覆盖为e(相当于交换了p和t的位置)
typedef struct LNode{//定义单链表结点类型
    ElemType data;//每个结点存放一个数据元素
    struct LNode* next;//指针指向下一个结点
}LNode,*LinkList

//前插操作:在p结点之前插入元素e
bool InsertNextNode(LNode* p,ElemType e){
    if(p==NULL){
        return false;
    }
    LNode* t=(LNode*)malloc(sizeof(LNode));
    if(s==NULL){//内存分配失败
        return false;
    }
    t->next = p->next;
    p->next = t;//新结点t连接到p之后
    t->data = p->data;//将p中元素复制到t中
    p->data = e;//p中元素覆盖为e
}
📌平均时间复杂度为T ( o ) = n ( 1 )
1.4销毁
单链表的销毁——链表销毁后不存在(数据没有被销毁,只是数据之间的链表关系被销毁了)
算法思路:从头指针开始,依次释放所有结点。P用来销毁结点,L用来指向下一个结点(不然销毁一次以后指针找不到剩下结点的地址了,销毁流程就不能持续进行)
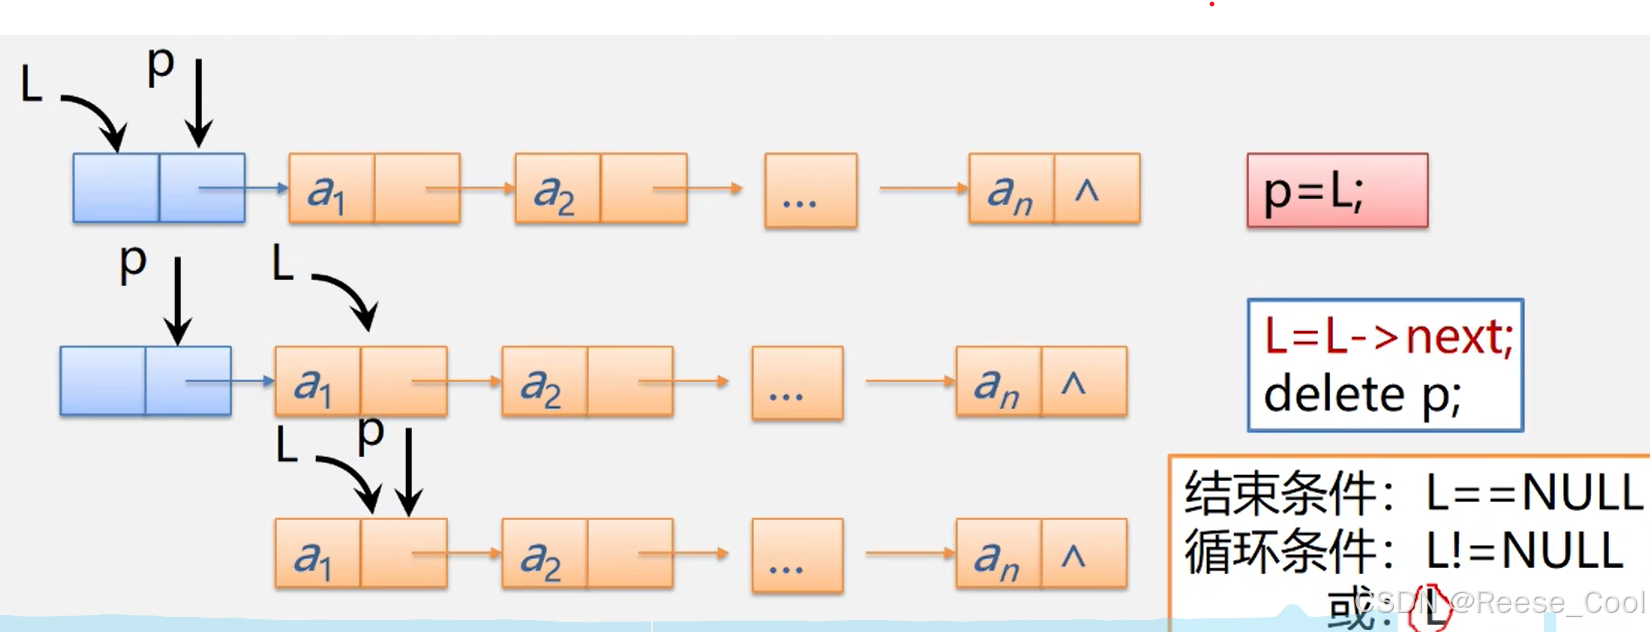
bool Status DestroyList_L(LinkList &L){//销毁单链表L
    LinkList p;//用来指向当前要销毁的结点
    while(L){//判断L是否为空
        p=L;//是将地址L交给新变量P做一个拷贝
        L=L->next;//接着L被赋值为下个结点的地址
        free(p);//销毁原来的地址
    }
    return true;
}
1.5清空
链表仍存在,但链表中无元素,称为空链表(头指针和头结点仍然在)
算法思路:一次释放所有结点,并将头结点指针域设置为空
其实就是在前面的基础上往后走了一步,销毁要销毁头结点,先把头结点交给p,而清空需要保留头结点,所以把头结点的下一个交给p
bool Status ClearList(LinkList &L){//将L重置
    LNode *p,*q;//或LinkList p,q;p用来存放当前所要删除的结点,q指向下一个结点
    p=L->next;//从首元结点开始删除.头结点的后继指针置空了, 后面的信息就丢失了,所以要提前保存
    while(p){
        q=p->next;//把p指向的下一节点的位置赋值给q
        free(p);//放心的删除p
        p=q;//删除掉当前结点后,p指针向后移
    }
    L->next=NULL;//头结点指针域为空
    return true;
}
1.6删除
删除表L中第I个位置的元素,并用e返回删除元素的值(如果需要的话,将要删除的结点的数据元素值保存下来)。
算法思路:首先找到ai-1的存储位置p,保存要删除的a的值;令p->next指向ai+1;释放结点a的空间。

1.6.1按位序删除
- 带头结点:
令 q (第i 个结点)指向被删除结点,用e返回被删除结点的数据元素的值,令p(第i-1个结点)指向被删除结点原来指向的值。
typedef struct LNode{           //定义单链表节点类型
    ElemType data;              //每个节点存放一个数据元素
    struct LNode *next;         //指针指向下一个节点
}LNode, *LinkList

//带头结点的删除操作
bool ListDelete(LinkList &L, int i, ElemType &e){
    if(i<1){
        return false;
    }
    LNode *p;       //指针p指向当前扫描到的结点
    int j=0;        //当前p指向的是第几个结点
    p = L;          //L指向头结点,头结点是第0个结点(不存数据)
    while(p != NULL && j<i-1){      //循环找到第i-1个结点
        p = P->next;
        j++;
    }
    if(p == NULL){      //i值不合法
        return false;
    }
    if(p->next == NULL){        //第i-1个结点之后已无其他结点
        return false;
    }
    LNode *q = P->next;         //令q指向被删除结点
    e = q->data;                //用e返回元素的值
    p->next = q->next;          //将*q结点从链中断开
    free(q);                    //释放结点的存储空间
    return true;                //删除成功
}
📌在删除操作中,最坏和平均时间复杂度为T ( o ) = o ( n )
1.6.2指定结点的删除
typedef struct LNode{           //定义单链表节点类型
    ElemType data;              //每个节点存放一个数据元素
    struct LNode *next;         //指针指向下一个节点
}LNode, *LinkList

//删除指定结点p
bool DeleteNode(LNode *p){
    if(p == NULL){
        return false;
    }
    LNode *q = p->next;     //令q指向*p的后继结点
    p->data = p->next->data //和后继结点交换数据域
    p->next = q->next;      //将*q结点从链中断开
    free(q);                //释放后继结点的存储空间
    return true;
}
但是,使用这个算法有个问题,如果p是最后一个结点,那么当程序执行到p->data = p->next->data这一句时,会出现空指针的错误,所以只能从表头开始依次寻找p的前驱
📌时间复杂度为T ( n ) = O ( n )
*求单链表的表长
算法思路:从首元结点开始,依次计数所有结点
算法思路:从首元结点开始,依次计数所有结点
int ListLength_L(LinkList L){//返回L中数据元素个数
     LinkList p;
     p=L->next;//p指向第一个结点
     i=0;
     while(p){//遍历单链表,统计结点数,当P为空时停止循环
         i++;
         p=p->next;
     }
     return i;
 }
1.7查找操作
1.7.1按位查找操作
获取表L中第i 个元素的值
算法思路:从链表的头指针出发,顺着链域next逐个结点往下搜索,找到第 i 个结点结束,将当前所指的结点中的数据元素输出。因此链表是顺序存储结构。
typedef struct LNode{           //定义单链表节点类型
    ElemType data;              //每个节点存放一个数据元素
    struct LNode *next;         //指针指向下一个节点
}LNode, *LinkList

//按位查找,返回第i个元素(带头结点)
LNode * GetElem(LinkList L, int i){
    if(i<0){
        return NULL;
    }
    LNode *p;       //指针p指向当前扫描的结点
    int j = 0;      //当前p指向的是第几个结点
    p = L;          //L指向头结点,头结点是第0个结点(不存数据)
    while(p != NULL && j<i){        //循环找到第i个结点
        p = p->next;
        j++;
    }
    return p;
}
📌平均时间复杂度为T ( n ) = O ( n )
1.7.2按值查找操作
根据给定的值在表L中查找与之相同的指定元素。
算法思路:从第一个结点起,依次和e相比较。如果找到一个其值与e相等的数据元素,则返回其在链表中的“位置”或地址;如果查遍整个链表都没有找到其值和e相等的元素,则返回0或“NULL"。要获取查找元素的值就返回值,获取查找元素的地址就返回指针p,获取查找元素的位置序号就对查找操作计数返回计数值。
typedef struct LNode{           //定义单链表节点类型
    ElemType data;              //每个节点存放一个数据元素
    struct LNode *next;         //指针指向下一个节点
}LNode, *LinkList

//按值查找操作(带头结点)
LNode * LocateElem(LinkList L, ElemType e){
    LNode *p = L->next;
    // 从第1个结点开始查找数据域为e的结点
    while(p != NULL && p->data != e){
        p = p->next;
    }
    return p;       //找到后返回该结点指针,否则返回NULL
}
📌平均时间复杂度为T ( n ) = O ( n )
1.8创建
1.8.1尾插法
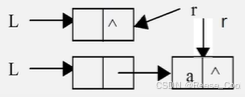
算法思路:从一个空表开始,将新结点逐个插入到链表的尾部,尾指针r指向链表的尾结点;初始时,r同L均指向头结点。每读入一个数据元素则申请一个新结点,新结点的指针域置空,将新结点插入到尾结点之后,r指向新结点。
LinkList List_Taillnsert(LinkList &L){      //正向建立单链表
    int x;      //设ElemType为整型
    L = (LinkList)malloc(sizeof(LNode));        //建立头结点,初始化空表
    LNode *s, *r = L;       //r为表尾指针
    scanf("%d", &x);        //输入结点的值
    while(x != 9999){       //输入9999表示结束
        s = (LNode *)malloc(sizeof(LNode));
        s->data = x;
        r->next = s;        //在r结点之后插入元素x
        r = s;              //r指向新的表尾结点,永远保持r指向最后一个结点
        scanf("%d", &x);
    }
    r->next = NULL;         //尾结点指针置空
    return L;
}
📌平均时间复杂度为T ( n ) = O ( n )
1.6.2头插法
每次都在头结点之后插入新元素,头插法较为重要,当遇到链表的逆置操作时,可以使用头插法实现。
算法思路:从一个空表开始,重复读入数据;生成新结点,将读入数据存放到新结点的数据域中;从最后一个结点开始,依次将各结点插入到链表的前端。
LinkList List_Taillnsert(LinkList &L){      //逆向建立单链表
    LNode *s;
    int x;
    L = (LinkList)malloc(sizeof(LNode));        //创建头结点
    L->next = NULL;                             //初始为空链表
    scanf("%d", &x);                            //输入结点的值
    while(x != 9999){                           //输入9999标志结束
        s = (LNode*)malloc(sizeof(LNode));      //创建新结点
        s->data = x;
        s->next = L->next;
        L->next = s;                    //将新结点插入表中,L为头指针
        scanf("%d", &x);
    }
    return L;
}
📌平均时间复杂度为:T ( n ) = O ( n )
表头指针
L->next表尾指针
*r=L
二.静态链表
面向对象语言,如:Java、C#等。它们是没有指针这个东西的。更别说一些早期的语言,如:Basic、Fortran等。由于没有指针,按照之前[单链表的结构,指针域就没办法实现。所以衍生了静态链表这个产物。
简单点说静态链表是用数组描述的链表。注意:和前面的顺序存储不一样,这里是用数组模拟链表。

首先我们让数组的元素都是由两个数据域组成,称之为Date和Cur。也就是说数组的每一个下标都对应一个Date和Cur。
数据域Date,用来存放数据元素,也就是我们通常要处理的数据。
数据域Cur,相当于单链表中的Next指针,存放该元素的后继在数组中的下标,我们把Cur叫做游标。这种实现方法也叫游标实现法。
为了方便插入数据,我们通常会把数组建立更大一些,以便有一些空闲空间插入时不至于溢出。说到这里它的优点和缺点都很明显了。
- 优点:在插入和删除操作时只需要修改游标,不需要移动元素。从而改进了在顺序存储结构中插入和删除操作需要移动大量元素的缺点。
- 缺点:(1)没有解决连续存储分配带来的表长难以确定的问题。(2)失去了顺序存储结构随机存取的特性。“失去了顺序存储结构随机存取的特性。”这句话听起来可能有点懵,我解释一下。因为顺序存储是由数组实现的,给我随机的数组下标我都可以将数据存进去,取出来。而现在变成了链表的形式,变成了链式存储,只能从头到尾进行查找,然后存取。
总的来说,静态链表就是为了给没有指针的高级语言实现单链表能力的一种方法。尽管大家以后不一定用的上,但这样的思考方式是非常巧妙的,应该理解其思想,以备不时之需。
三.循环链表
循环链表(circular linked list)是另外一种形式的链式存储结构,它的特点是从表中最后一个结点的指针域指向头结点,整个链表形成一个环,由此,从表中任一结点触发均可找到表中的其他结点
循环链表的操作和线性表基本一致,差别仅在于算法中的循环条件不是P—>next是否为空,而是是否等于头指针.

📌在循环单链表中,从头部找到尾部元素,时间复杂度为T ( n ) = O ( n )
📌从尾部找到头部元素,时间复杂度为T ( n ) = O ( 1 )
四.双向链表
上述的链式存储结构的结点中只有一个指示直接后继的指针域,由此,从某结点出发只能顺指针往后查询其他结点,若要寻查结点的直接前驱,则需要从头指针出发。换句话说,在单链表中,NextElem的执行时间为O ( 1 ) O(1)O(1),而PriorElem的执行时间为O ( n ) O(n)O(n),为克服单链表这种单向性的缺点,可利用双向链表。

顾名思义,在双向链表的结点中有两个指针域,其一指向直接后继,其二指向直接前驱。和单链表的循环链表类似,双向链表也有循环链表。
注意:双向链表不可随机存取,按位查找,按值查找操作只能用遍历的方式实现。
📌时间复杂度为:T ( n ) = O ( n )
4.1初始化
带头结点
typedef struct DNode{
    ElemType data;
    struct DNode *prior, *next;
}DNode, *DLinklist;

bool InitDLinkList(DLinklist &L){
    L = (DNode *)malloc(sizeof(DNode));     //分配一个头结点
    if(L == NULL){                  //内存不足,分配失败
        return false;
    }
    L->prior = NULL;        //头结点的prior永远指向NULL
    L->next = NULL;         //头结点之后暂时还没有结点
    return true;
}

void testDLinkList(){
    //初始化双链表
    InitDLinkList(L);
    ......
}
4.2插入

typedef struct DNode{
    ElemType data;
    struct DNode *prior, *next;
}DNode, *DLinklist;

// 在p结点之后插入s结点
bool InsertNextDNode(DNode *p, DNode *s){
    if(p == NULL || s == NULL){         //非法参数
        return false;
    }
    s->next = p->next;
    if(p->next != NULL){        //如果p结点有后继结点
        p->next->prior = s;
    }
    s->prior = p;
    p->next = s;
    return true;
}
4.3删除
typedef struct DNode{
    ElemType data;
    struct DNode *prior, *next;
}DNode, *DLinklist;

// 删除p结点的后继结点
bool DeletenextDNode(DNode *p){
    if(p == NULL || s == NULL){         //非法参数
        return false;
    }
    DNode *p = p->next;     //找到p的后继结点q
    if(q == NULL){
        return false;       //p没有后继
    }
    if(q->next != NULL){    //q结点不是最后一个结点
        q->next->prior = p;
    }
    free(q);                //释放结点空间
    return true;
}
链表优缺点
优点:
- 结点空间可以动态申请和释放
- 数据元素的逻辑次序靠结点的指针来指示,插入和删除时不需要移动数据元素
缺点:
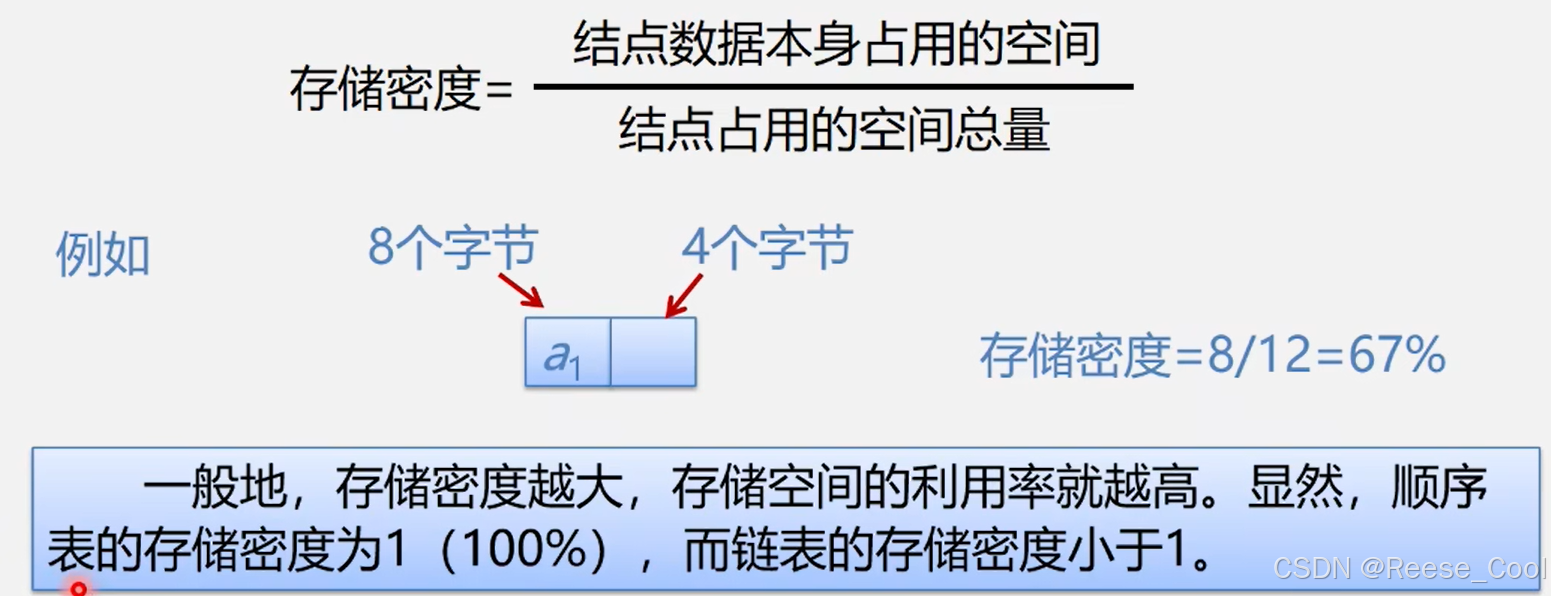
- 存储密度小,每个结点的指针域需要额外占用存储空间。当每个结点的数据域所占字节不多时,指针域所占存储空间的比重显得很大。
 + 链式存储结构是**非随机存取**结构。对任一结点的操作都要从头指针依指针链查找到该结点,这增加了算法的复杂度。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 26
 0
- 0


 已为社区贡献5条内容

所有评论(0)