zookeeper和kafka
文章目录
一,zookeeper
1.zookeeper是什么
ZooKeeper 是 是 Apache 开发的一种开源,专门用于分布式系统的协调服务,旨在为分布式应用提供高效的同步、配置管理和故障恢复功能。它的主要目的是简化分布式系统中多个节点的管理,确保各节点之间的数据保持一致并能够有效协同工作。ZooKeeper 使用类似文件系统的结构来存储和管理元数据,从而保障系统在运行过程中能够实现高可用性和数据的一致性。
2.zookeeper如何工作

2.1 观察者模式
在软件设计中,观察者模式 是一种行为设计模式,允许对象定义一种订阅机制,以便当对象的状态发生变化时,依赖于它的对象(观察者)会自动收到通知并做出反应。ZooKeeper 利用这一模式管理分布式系统中的数据变化和事件通知。
2.2 ZooKeeper 如何体现观察者模式
- 主体(Subject):ZooKeeper 中的 ZNode(ZooKeeper 的数据节点)相当于主体(Subject)。它存储了所有客户端关心的状态或元数据。
- 观察者(Observers):任何连接到 ZooKeeper 的客户端都可以在特定的 ZNode 上设置 监视(Watches)。这些客户端就是观察者(Observers)。
- 状态变化:当 ZooKeeper 中的某个 ZNode 状态(如数据的更改、节点的删除或创建)发生变化时,ZooKeeper 会自动通知所有注册的观察者(即客户端)。这些客户端可以根据通知做出相应的反应,例如重新读取节点的数据、执行相应的业务逻辑或调整配置。
- 回调机制:当客户端设置的监视器被触发时,ZooKeeper 通过回调机制通知客户端,让它们可以进行必要的操作。
2.3 ZooKeeper = 文件系统 + 通知机制
- 文件系统:ZooKeeper 的数据结构类似于一个分层的文件系统,数据以树状的层次结构进行存储,类似目录和文件。每个 ZNode 都可以存储数据,并且可以通过路径访问,就像文件系统中的文件路径一样。
- 通知机制:ZooKeeper 允许客户端在 ZNode 上注册监视(即观察者模式中的观察者),这些监视会在 ZNode 发生变化时触发通知。ZooKeeper 负责将数据变化事件发送给注册的观察者客户端。
2.4 实际应用中的观察者模式
- 服务发现:在分布式服务中,某个服务(如一个数据库节点)上线或下线,所有依赖该服务的客户端可以通过在 ZooKeeper 上的相应 ZNode 设置监视,从而实时了解该服务的状态变化。
- 配置管理:当分布式系统的配置文件存储在 ZooKeeper 中时,客户端可以监视配置的 ZNode。当配置文件被更新或修改时,ZooKeeper 会通知所有注册的观察者,使它们能够动态重新加载配置。
3.ZooKeeper 的特点
- Leader-Follower 架构:ZooKeeper 由一个 Leader 和多个 Follower 组成,形成集群。Leader 负责处理写请求,Follower 跟随 Leader 并同步数据。
- 半数以上节点存活即可工作只要集群中有半数以上的节点存活,ZooKeeper 就能够正常提供服务。因此,适合安装奇数台服务器来提高容错能力。
- 数据全局一致性所有服务器都保存相同的数据副本。无论客户端连接到哪个服务器,所读取的数据都是一致的。
- 顺序执行更新请求来自同一个客户端的更新请求按顺序执行,遵循 先来先服务 的原则,保证了请求的顺序性。
- 数据更新的原子性每次数据更新操作要么全部成功,要么完全失败,确保事务的原子性。
- 最终一致性(实时)在一定时间范围内,ZooKeeper 保证客户端能够读取到最新的数据。
这些特点确保了 ZooKeeper 在分布式系统中的高可用性、数据一致性和系统可靠性,非常适合用于需要强一致性和高容错性的场景
4.ZooKeeper 中的ZNode (数据结构)
4.1ZNode
ZNode 是 ZooKeeper 中存储数据的基本单元。每个 ZNode 可以存储少量数据,并且可以有子节点,形成树状结构。
4.2ZNode 类型:
- 持久节点:该类型的 ZNode 会一直存在,直到被手动删除。
- 临时节点:客户端会话断开时,临时节点会自动删除。常用于实现分布式锁等功能。
- 顺序节点:在创建 ZNode 时,ZooKeeper 可以为其自动添加递增编号,常用于分布式队列或顺序任务处理。
4.3ZNode 的特性:
- ZooKeeper 的数据模型类似于 Linux 文件系统,节点的结构就像树状结构,每个节点(ZNode)有一个唯一的路径作为标识。
- 每个 ZNode 默认可以存储最多 1MB 的数据。
4.4ZooKeeper 节点(ZNode) 的四个主要属性
- data:存储节点的数据内容,保存 ZNode 上存储的具体信息。
- ACL(访问控制列表):定义 ZNode 的访问权限,控制哪些客户端可以访问或修改该节点。
- stat:包含各种元数据,比如数据的大小、版本号、事务 ID、时间戳等,帮助跟踪节点的状态和更新历史。
- child:引用当前 ZNode 的子节点,表示该节点下所有子节点的引用信息。
5.zookeepe应用范围
统一命名服务
- 在分布式系统中,应用或服务通常需要一个统一的名字来标识它们,而不只是用 IP 地址。
- ZooKeeper 可以帮助实现这种统一命名,比如通过域名代替难记的 IP 地址。
统一配置管理
- 在分布式环境中,所有节点的配置文件需要保持一致,比如 Kafka 集群。如果修改配置,希望能快速同步到所有节点。
- 通过 ZooKeeper,可以将配置文件的信息存储在一个节点中(ZNode)。客户端(应用程序)可以监视这个节点,一旦配置有变化,ZooKeeper 会通知所有客户端进行更新。
统一集群管理
- 在分布式环境中,实时了解每个节点的状态很重要,ZooKeeper 能帮助你监控节点的状态变化。
- 每个节点的信息可以存储在 ZooKeeper 中,ZooKeeper 可以通知你节点的状态是否发生了变化。
服务器动态上下线
当服务器上线或下线时,客户端可以通过 ZooKeeper 快速感知这些变化,从而做出相应调整。
软负载均衡
ZooKeeper 可以记录每个服务器的访问数量情况,帮助将更多的请求分配给空闲的(访问数量最少)服务器,避免某些服务器负载过重。
6.zookeeper选举
ZooKeeper 的选举机制是为了确保在分布式系统中,所有节点对外表现为一个统一的服务,也就是确保系统的核心协调者(Leader)能够正常工作,而其他节点(Follower)与之保持同步。这对于保持系统的高可用性、一致性和协调性至关重要。
Leader 选举
- Leader 是 ZooKeeper 集群中的核心节点,它负责处理写操作、更新数据并将数据同步到所有 Follower 节点。每次 ZooKeeper 启动或出现节点故障时,集群必须通过选举机制选出一个新的 Leader。
- 在集群启动或 Leader 节点失效时,所有处于 LOOKING 状态的节点都会发起 Leader 选举,参与的节点相互比较编号,通常是选择编号更大的节点作为候选 Leader。
投票确认
- 在选举过程中,ZooKeeper 节点之间会互相交换信息,并根据编号投票。节点会持续比较其他节点的信息,并不断调整自己的投票,以支持它认为合适的节点作为 Leader。
- 当某个节点的票数超过了半数(即集群中的大多数节点都投票支持它),这个节点就会被选举为 Leader。
- 其他未被选中的节点则成为 Follower,它们会进入 FOLLOWING 状态,跟随 Leader 并从 Leader 处同步数据。
6.1第一次启动选举
假设集群有五台服务器
第一台服务器启动:
- 服务器1启动,首先发起选举,并投自己一票。因为集群中只有一台服务器,它的票数不足以超过半数(至少要 3 票),所以服务器1保持在 LOOKING(寻找 Leader)状态,等待更多服务器加入。
第二台服务器启动:
- 服务器2启动后,也发起选举。服务器1和服务器2分别给自己投票,并交换选票信息。
- 服务器1发现服务器2的编号(myid)比自己的大,因此更改投票,支持服务器2。
- 结果:服务器1有 0 票,服务器2有 2 票,票数仍不足半数(3 票),所以它们都保持在 LOOKING 状态。
第三台服务器启动:
- 服务器3启动后,发起新的选举。服务器1和服务器2发现服务器3的编号(myid)比它们的都大,所以更改投票,支持服务器3。
- 结果:服务器1和服务器2各有 0 票,服务器3获得了 3 票,超过半数,因此服务器3当选为 Leader。
- 服务器1和服务器2的状态变为 FOLLOWING(跟随者),服务器3的状态变为 LEADING(领导者)。
第四台服务器启动:
- 服务器4启动并发起选举。此时服务器1、2、3已经不再处于 LOOKING 状态,已经有了 Leader(服务器3)。
- 服务器4发现服务器3已经是 Leader,并且大多数服务器都支持它,于是服务器4更改自己的选票,支持服务器3,状态也变为 FOLLOWING。
第五台服务器启动:
- 服务器5的启动过程与服务器4相同,直接跟随现有的 Leader(服务器3),状态变为 FOLLOWING。
6.2 非第一次启动选举 (节点重新加入)
当某台 ZooKeeper 服务器开始进入选举流程时,集群可能处于以下两种状态
(1) 集群中已经存在 Leader
- 如果集群中已有 Leader,当该服务器尝试选举 Leader 时,其他服务器会告知该节点当前已有的 Leader 信息。该服务器只需要连接到现有的 Leader,完成数据的状态同步,然后进入 FOLLOWING 状态,无需重新进行完整的 Leader 选举。
- 这种情况意味着集群保持稳定,新的服务器只需跟随现有的 Leader,不触发新的选举。
(2)集群中没有 Leader
- 如果集群中确实没有 Leader(例如当前 Leader 出现故障),则集群必须重新进行 Leader 选举。
- 假设:ZooKeeper 集群由 5 台服务器组成,服务器编号为 1、2、3、4、5(对应 SID),每个服务器有一个事务编号(ZXID),用于表示服务器处理的最新事务。假如,SID 为 3 的服务器当前是 Leader,某一时刻,SID 为 3 和 5 的服务器同时出现故障,导致没有 Leader,集群开始新的 Leader 选举。
(3)Leader 选举规则
在没有 Leader 的情况下,ZooKeeper 按照以下规则选举新的 Leader:
EPOCH 较大者胜出
- EPOCH 是选举过程中用于标识版本或轮次的一个值。EPOCH 较大的服务器表示拥有更新的状态,因此直接胜出。
EPOCH 相同,事务 ID 较大者胜出
- 如果 EPOCH 值相同,那么将对比 ZXID(事务 ID)。事务 ID 较大的服务器胜出,因为它处理了更多的事务,数据更为完整。
事务 ID 相同,服务器 ID 较大者胜出
- 如果 EPOCH 和 ZXID 都相同,则对比 SID(服务器 ID)。服务器 ID 较大者胜出,因为它在系统中具有更高的优先级。
名词解释
SID:服务器ID。用来唯一标识一台ZooKeeper集群中的机器,每台机器不能重复,和myid一致。
ZXID:事务ID。ZXID是一个事务ID,用来标识一次服务器状态的变更。在某一时刻,集群中的每台机器的ZXID值不一定完全一致,这和ZooKeeper服务器对于客户端“更新请求”的处理逻辑速度有关。
Epoch:每个Leader任期的代号。没有Leader时同一轮投票过程中的逻辑时钟值是相同的。每投完一次票这 个数据就会增加
7.Zookeeper集群配置
7.1环境部署
| 服务名称 | IP 地址 | 服务 |
|---|---|---|
| zk01 | 192.168.88.70 | zookeeper-3.5.7, kafka_2.13-2.7.1, jdk_1.8 |
| zk02 | 192.168.88.80 | zookeeper-3.5.7, kafka_2.13-2.7.1, jdk_1.8 |
| zk03 | 192.168.88.90 | zookeeper-3.5.7, kafka_2.13-2.7.1, jdk_1.8 |
7.2环境准备
zk01 zk02 zk03
关闭防火墙,关闭增强功能
systemctl stop firewalld
setenforce 0

改主机名
hostnamectl set-hostname zk01
hostnamectl set-hostname zk02
hostnamectl set-hostname zk03


配置映射关系,加快访问速度
vim /etc/hosts
192.168.88.70 zk01
192.168.88.80 zk02
192.168.88.90 zk03


安装 JDK,如果是这个就不需要安装
yum install -y java-1.8.0-openjdk java-1.8.0-openjdk-devel
java -version

下载安装包
官方下载地址:https://archive.apache.org/dist/zookeeper/
cd /opt
wget https://archive.apache.org/dist/zookeeper/zookeeper-3.5.7/apache-zookeeper-
3.5.7-bin.tar.gz
或者
将压缩包放置/opt下
7.3安装Zookeeper
解压
cd /opt
tar -zxvf apache-zookeeper-3.5.7-bin.tar.gz -C /usr/local
mv /usr/local/apache-zookeeper-3.5.7-bin /usr/local/zookeeper-3.5.7

修改配置文件
cp /usr/local/zookeeper-3.5.7/conf/zoo_sample.cfg /usr/local/zookeeper-3.5.7/conf/zoo.cfg
vim zoo.cfg
tickTime=2000 #第2行通信心跳时间,Zookeeper服务器与客户端心跳时间,单位毫秒

initLimit=10 #第5行Leader和Follower初始连接时能容忍的最多心跳数(tickTime的数量),这里表示为10*2s

syncLimit=5 #第8行Leader和Follower之间同步通信的超时时间,这里表示如果超过5*2s,Leader认为Follwer死掉,并从服务器列表中删除Follwer

dataDir=/usr/local/zookeeper-3.5.7/data #12行修改,指定保存Zookeeper中的数据的目录,

目录需要单独创建
dataLogDir=/usr/local/zookeeper-3.5.7/logs #添加,指定存放日志的目录,目录需要单独创建

clientPort=2181 #第14行客户端连:接端口

添加集群信息(三台设备)
server.1=192.168.88.70:3188:3288
server.2=192.168.88.80:3188:3288
server.3=192.168.88.90:3188:3288


server.A=B:C:D
A是一个数字,表示这个是第几号服务器。集群模式下需要在zoo.cfg中dataDir指定的目录下创建一个文件
myid,这个文件里面有一个数据就是A的值,Zookeeper启动时读取此文件,拿到里面的数据与zoo.cfg里面
的配置信息比较从而判断到底是哪个server。
B是这个服务器的地址。
C是这个服务器Follower与集群中的Leader服务器交换信息的端口。
D是万一集群中的Leader服务器挂了,需要一个端口来重新进行选举,选出一个新的Leader,而这个端口就
是用来执行选举时服务器相互通信的端口。


拷贝配置好的 Zookeeper 配置文件到其他机器上
scp -r /usr/local/zookeeper-3.5.7/conf/zoo.cfg 192.168.88.30:/usr/local/zookeeper-3.5.7/conf/
scp -r /usr/local/zookeeper-3.5.7/conf/zoo.cfg 192.168.88.40:/usr/local/zookeeper-3.5.7/conf/
或
scp -r /usr/local/zookeeper-3.5.7/conf/zoo.cfg zk02:/usr/local/zookeeper-3.5.7/conf/
scp -r /usr/local/zookeeper-3.5.7/conf/zoo.cfg zk03:/usr/local/zookeeper-3.5.7/conf/


在每个节点上创建数据目录和日志目录
mkdir /usr/local/zookeeper-3.5.7/data
mkdir /usr/local/zookeeper-3.5.7/logs

在每个节点的dataDir指定的目录下创建一个 myid 的文件
echo 1 > /usr/local/zookeeper-3.5.7/data/myid   #zk01上设置
echo 2 > /usr/local/zookeeper-3.5.7/data/myid   #zk02上设置
echo 3 > /usr/local/zookeeper-3.5.7/data/myid   #zk03上设置

配置 Zookeeper 启动脚本
vim /etc/init.d/zookeeper
#!/bin/bash
#chkconfig:2345 20 90   #2345字符界面图形化界面  20 90启动优先级
#description:Zookeeper Service Control Script
ZK_HOME='/usr/local/zookeeper-3.5.7'
case $1 in
start)
echo "---------- zookeeper 启动 ------------"
$ZK_HOME/bin/zkServer.sh start
;;
stop)
echo "---------- zookeeper 停止 ------------"
$ZK_HOME/bin/zkServer.sh stop
;;
restart)
echo "---------- zookeeper 重启 ------------"
$ZK_HOME/bin/zkServer.sh restart
;;
status)
echo "---------- zookeeper 状态 ------------"
$ZK_HOME/bin/zkServer.sh status
;;
*)
echo "Usage: $0 {start|stop|restart|status}"
esac

把脚本从zk01 传给 zk02 zk03
scp -r /etc/init.d/zookeeper 192.168.88.30:/etc/init.d/
scp -r /etc/init.d/zookeeper 192.168.88.40:/etc/init.d/
或
scp -r /etc/init.d/zookeeper zk02:/etc/init.d/
scp -r /etc/init.d/zookeeper zk03:/etc/init.d/

设置开机自启  zk01 zk02 zk03
chmod +x /etc/init.d/zookeeper
chkconfig --add zookeeper

分别启动 Zookeeper  zk01 zk02 zk03 分别错开启动
service zookeeper start

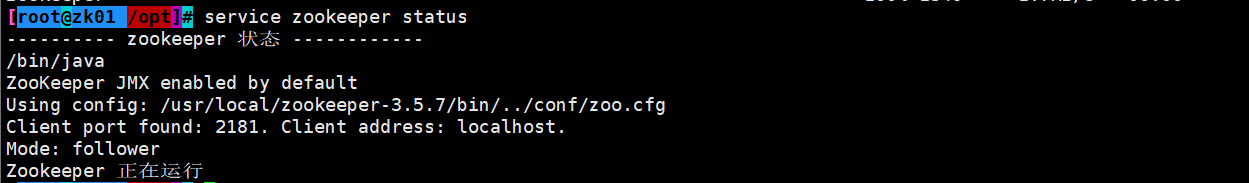
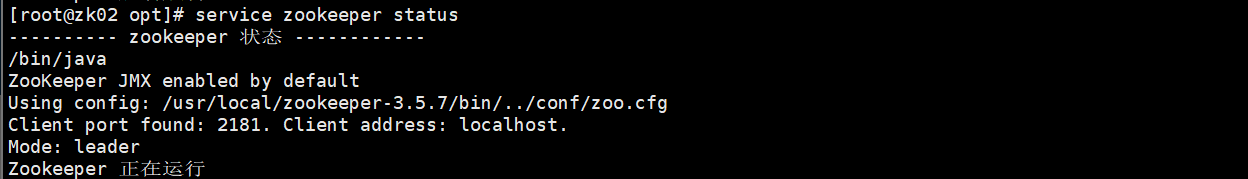
查看当前状态   zk01 zk02 zk03
service zookeeper status
zk01 是 follower
zk02 是 leader
zk03 是 follower

总结
ZooKeeper 通过观察者模式实现了分布式系统中的协调与管理。它存储和管理分布式环境中的重要数据,并允许客户端在这些数据上注册监视,一旦数据发生变化,ZooKeeper 会立即通知客户端。这使得 ZooKeeper 不仅仅是一个数据存储工具,更是一个强大的通知和协调框架,特别适合分布式系统中的配置管理、服务发现和状态同步等场景。
第一选举
通过比较myid,myid最大的获取选票,当选票过半数确定leader的节点,之后再加入的节点无论myid有多大都会做follower加入到这个集群中
非第一选举
当源leader故障,其他节点会选举新的leader,先比较EPOCH(任期)最大的直接胜出,如果EPOCH相同的,比较事务ID最大的胜出,如果事务ID也相同,最后比较服务器ID大的胜出
二,kafka
1.消息队列(MQ)
消息队列(Message Queue,MQ)是一种用于不同系统或应用程序之间进行异步通信的技术。它允许发送方将消息发送到一个队列中,而接收方可以在适当的时间读取这些消息。这种机制有助于解耦系统组件,提高系统的可扩展性和可靠性。
1.1为什么要使用消息队列
由于在高并发环境下,同步请求来不及处理,请求往往会发生阻塞。比如大量的请求并发访问数据库,导致行锁表锁,最后请求线程会堆积过多,从而触发** too many connection** 错误,引发雪崩效应。 使用消息队列,通过异步处理请求,从而缓解系统的压力。消息队列常应用于异步处理,流量削峰,应用解耦,消息通讯等场景。
常见的 MQ 中间件有
ActiveMQ
RabbitMQ
RocketMQ
Kafka
1.2消息队列的特点(优点)
(1)解耦
- 定义:通过消息队列,发送方和接收方之间的耦合度降低。它们只需遵循相同的消息格式和协议,而不需要直接依赖彼此的实现。
- 优势:允许独立开发和扩展,便于系统的维护和升级。即使修改了某一方的实现,只要接口不变,另一方仍然可以正常工作。
(2)可恢复性
- 定义:在一个组件发生故障时,系统的其他部分仍然可以继续运行。消息队列确保消息不会丢失,即使消费者进程暂时不可用。
- 优势:提高系统的可靠性,确保在故障发生后,可以恢复处理未处理的消息,保持数据一致性。
(3)缓冲
- 定义:消息队列作为一个中间层,能够暂存消息,平衡生产者和消费者之间的速度差异。
- 优势:缓冲可以防止瞬时的高负载对系统造成冲击,平滑消息流,提升系统性能。例如,当生产者速度过快时,消息队列可以暂时存储这些消息,待消费者准备好后再处理。
(4)灵活性与峰值处理能力
- 定义:消息队列允许系统根据当前的负载情况灵活应对突发流量。
- 优势:在高峰时段,系统可以继续处理请求,而不需要为偶尔的流量高峰预留过多资源。这样可以避免资源浪费,提高系统的效率和成本效益。
(5)异步通信
- 定义:消息队列支持异步处理,允许用户在不需要立即处理的情况下,将消息放入队列中。
- 优势:可以改善用户体验,用户发起请求后不需要等待响应,可以继续进行其他操作。这种模式适合许多场景,例如用户注册、订单处理等。
1.3消息队列模式
(1)点对点
点对点模式是一种一对一的消息传递模型,消费者主动从队列拉取数据,消息一旦消费即从队列中清除。消息生产者将消息发送到队列中,消费者从队列中获取并消费,消息消费后队列中不再保留该消息。同一消息只能被一个消费者处理,队列支持多个消费者竞争获取消息,但每条消息仅被处理一次。
(2)发布订阅模式
发布/订阅模式也称观察者模式,是一种一对多的消息传递模型。消息生产者将消息发布到主题topic,所有订阅该主题的消费者都会接收并消费该消息,消息不会因为被消费而删除。该模式定义了对象间的一对多依赖关系,当一个对象的状态改变时,所有依赖它的对象都会收到通知并自动更新。
2.kafka
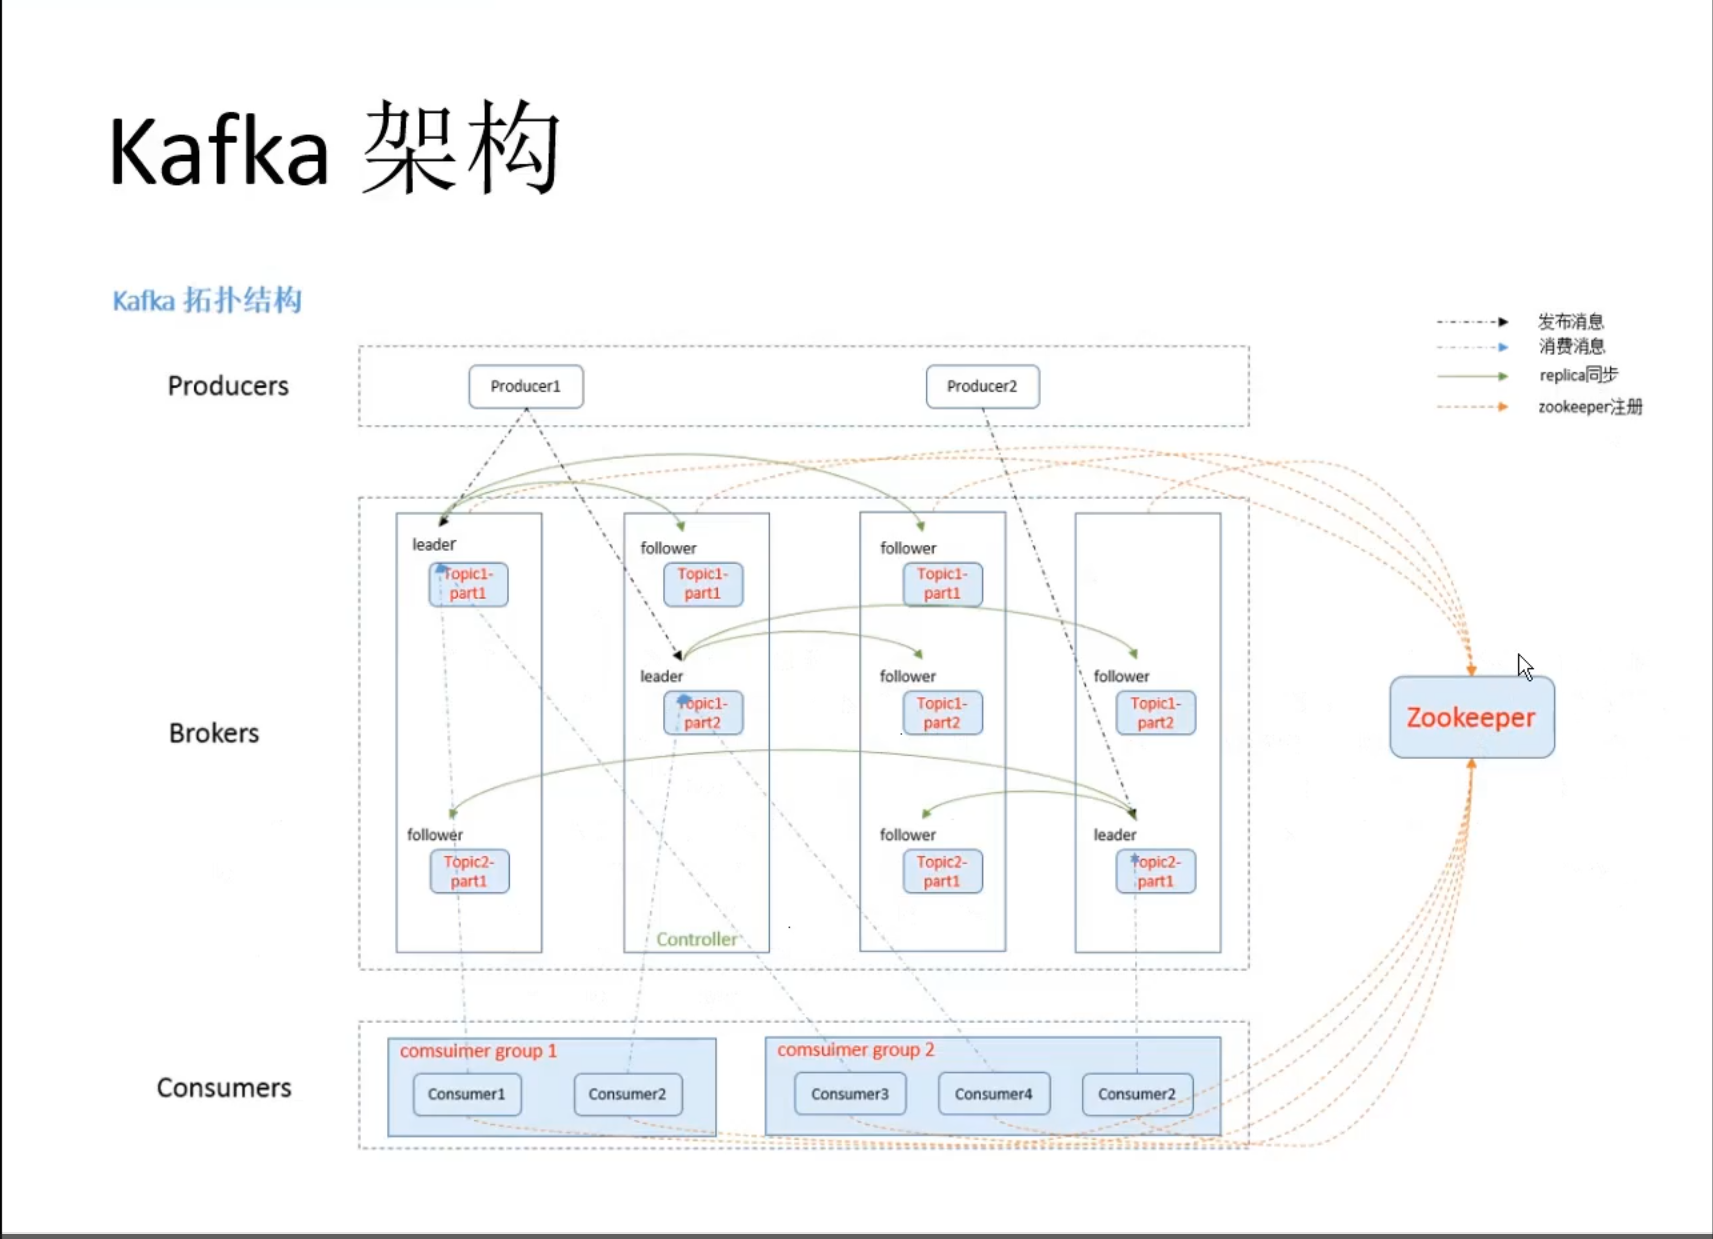
Kafka 是一个分布式的、基于发布/订阅模式的消息队列(MQ,Message Queue),主要应用于大数据的实时处理领域。
最初由 LinkedIn 开发,Kafka 是一个支持分区(partition)、多副本(replica),并基于 Zookeeper 协调的分布式消息中间件系统。其最大的特点是能够实时处理海量数据,适用于各种场景,如基于 Hadoop 的批处理系统、低延迟的实时系统、Spark/Flink 流式处理引擎、Nginx 访问日志和消息服务等。Kafka 由 Scala 语言编写,并在 2010 年由 LinkedIn 贡献给 Apache 基金会,成为顶级开源项目。
2.1Kafka 的主要特点
高吞吐量、低延迟:Kafka 每秒可处理数十万条消息,延迟最低仅几毫秒。每个 topic 可分为多个分区(Partition),通过消费者组(Consumer Group)并行消费分区,提高负载均衡和消费能力。
可扩展性:Kafka 集群支持热扩展,方便在不影响服务的情况下增加节点。
持久性与可靠性:消息被持久化存储在本地磁盘,并支持数据备份,防止数据丢失。
容错性:在多副本机制下,Kafka 允许集群中部分节点故障(若副本数为 n,则允许最多 n-1 个节点失败),确保系统的高可用性。
高并发:Kafka 支持数千个客户端同时进行读写操作,保证高并发性能。
2.2Kafka系统架构
(1)Broker服务器
一台 kafka 服务器就是一个 broker。一个集群由多个 broker 组成。一个 broker 可以容纳多个topic。
(2)Topic主题
是 Kafka 中用于数据流动的基本单位,可以类比为数据库中的表名或者 Elasticsearch 中的索引index(一个队列) 生产者和消费者面向的都是一个 topic。每个 Topic 物理上是独立存储的,即不同的 Topic 的数据不会混合存储。
(3)Partition 分区
为了实现扩展性,一个大的 topic 可以分布到多个 broker(即服务器)上,一个 topic 可以分割为一个或多个 partition,每个 partition 是一个有序的队列。Kafka 只保证 partition 内的记录是有序的,而不保证 topic 中不同 partition 的顺序。
每个 topic 至少有一个 partition,当生产者产生数据的时候,会根据分配策略选择分区,然后将消息追
加到指定的分区的队列末尾。
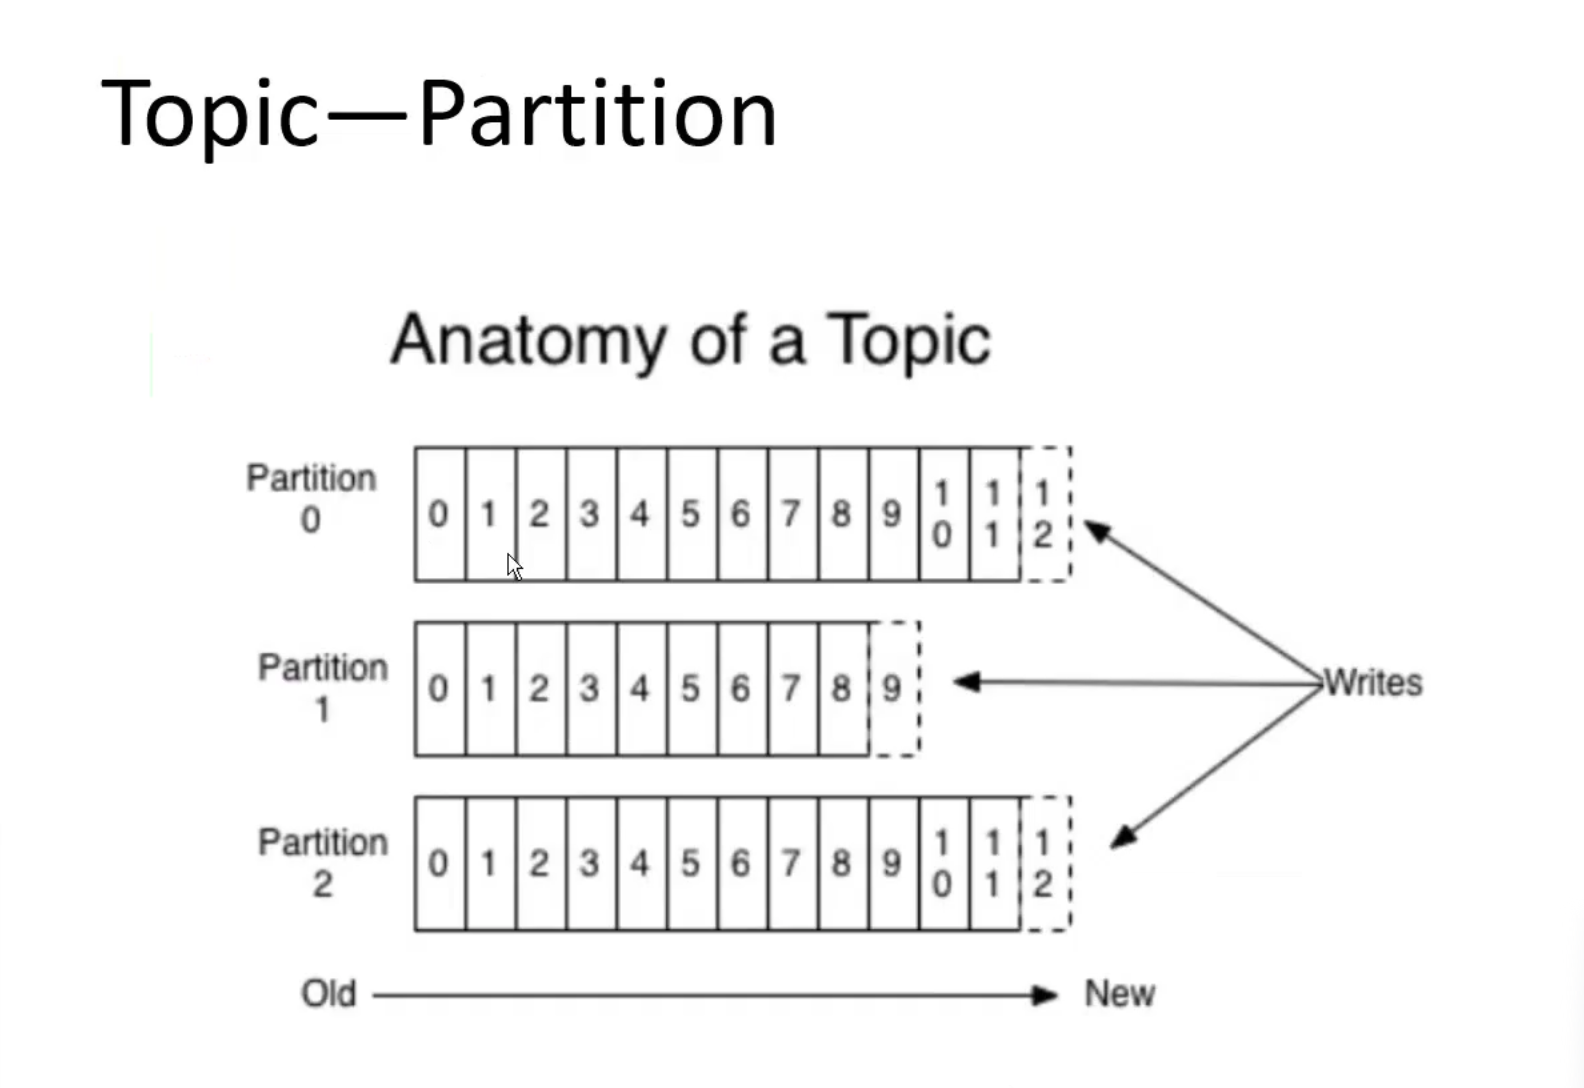
Partation 数据路由规则:
- 指定了 patition,则直接使用。
- 未指定 patition 但指定 key(相当于消息中某个属性),通过对 key 的 value 进行 hash 取模,选出一个 patition。
- patition 和 key 都未指定,使用轮询选出一个 patition。
每条消息都会有一个自增的编号,用于标识消息的偏移量,标识顺序从 0 开始。 每个 partition 中的数据使用多个 segment 文件存储。
假设topic 有多个 partition,消费数据时就不能保证数据的顺序。严格保证消息的消费顺序的场景下(例如商品秒杀、 抢红包),需要将 partition 数目设为 1。
Kafka Partition 和 Broker 的关系
- broker 存储 topic 的数据。如果某 topic 有 N 个 partition,集群有 N 个 broker,那么每个broker存储该 topic 的一个 partition。
- 如果某 topic 有 N 个 partition,集群有 (N+M) 个 broker,那么其中有 N 个 broker 存储 topic 的一个 partition, 剩下的 M 个 broker 不存储该 topic 的 partition 数据。
- 如果某 topic 有 N 个 partition,集群中 broker 数目少于 N 个,那么一个 broker 存储该 topic 的一个或多个 partition。在实际生产环境中,尽量避免这种情况的发生,这种情况容易导致 Kafka 0集群数据不均衡。
分区的原因
- 方便在集群中扩展,每个Partition可以通过调整以适应它所在的机器,而一个topic又可以有多个Partition组成,因此整个集群就可以适应任意大小的数据了。
- 可以提高并发,因为可以以Partition为单位读写了。
分区(Partition)副本(Replica)机制
- Replica
副本,为保证集群中的某个节点发生故障时,该节点上的 partition 数据不丢失,且 kafka 仍然能够继续工作,kafka 提供了副本机制,一个 topic 的每个分区都有若干个副本,一个 leader 和若干 个 follower。
- Leader
每个 partition 有多个副本,其中有且仅有一个作为 Leader,Leader 是当前负责数据的读写的partition。
- Follower
Follower 跟随 Leader,所有写请求都通过 Leader 路由,数据变更会广播给所有 Follower,Follower 与 Leader 保持数据同步。Follower 只负责备份,不负责数据的读写。
如果 Leader 故障,则从 Follower 中选举出一个新的 Leader。
当 Follower 挂掉、卡住或者同步太慢,Leader 会把这个 Follower 从 ISR(Leader 维护的一个和Leader 保持同步的 Follower 集合) 列表中删除,重新创建一个 Follower。
(4)producer
生产者(Producer)作为数据发布的主体,负责将消息以push的方式推送到Kafka的特定topic中。当broker接收到生产者发送的消息时,这些消息会被高效地追加到当前活跃、专门用于数据存储的segment文件中。这一过程确保了数据的有序性和高效性。
生产者具有灵活性,在发送消息时,可以选择将数据直接存储到指定的partition中,或者让Kafka根据消息的key或分区器(partitioner)逻辑自动选择partition进行存储。
(5)Consumer
消费者可以从 broker 中 pull 拉取数据。消费者可以消费多个 topic 中的数据。
(6) Consumer Group(CG)
消费者组,由多个 consumer 组成。所有的消费者都属于某个消费者组,即消费者组是逻辑上的一个订阅者。可为每个消费者指定组名,若不指定组名则属于默认的组。将多个消费者集中到一起去处理某一个 Topic 的数据,可以更快的提高数据的消费能力。消费者组内每个消费者负责消费不同分区的数据,一个分区只能由一个组内消费者消费,防止数据被重复读取。 消费者组之间互不影响。
(7)offset 偏移量
- 可以唯一的标识一条消息。
- 偏移量决定读取数据的位置,不会有线程安全的问题,消费者通过偏移量来决定下次读取的消息(即消费位置)。
- 消息被消费之后,并不会被马上删除,这样多个业务就可以重复使用 Kafka 的消息。
- 某一个业务也可以通过修改偏移量达到重新读取消息的目的,偏移量由用户控制。
- 消息最终还是会被删除的,默认生命周期为 1 周(7*24小时)。
(8)Zookeeper
Kafka 通过 Zookeeper 来存储集群的 meta 信息。由于 consumer 在消费过程中可能会出现断电宕机等故障,consumer 恢复后,需要从故障前的位置的继续消费,所以 consumer 需要实时记录自己消费到了哪个 offset,以便故障恢复后继续消费。Kafka 0.9 版本之前,consumer 默认将 offset 保存在 Zookeeper 中;从 0.9 版本开始,consumer 默认将 offset 保存在 Kafka 一个内置的 topic 中,该 topic 为 __consumer_offsets。也就是说,zookeeper的作用就是,生产者push数据到kafka集群,就必须要找到kafka集群的节点在哪里,这些都是通过zookeeper去寻找的。消费者消费哪一条数据,也需要zookeeper的支持,从zookeeper获得offset,offset记录上一次消费的数据消费到哪里,这样就可以接着下一条数据进行消费
2.3配置Kafka
zk01 zk02 zk03
官网下载地址:http://kafka.apache.org/downloads.html
cd /opt
wget https://mirrors.tuna.tsinghua.edu.cn/apache/kafka/2.7.1/kafka_2.13-
2.7.1.tgz
或
把压缩包上传至/opt下

安装 Kafka
cd /opt/
tar zxvf kafka_2.13-2.7.1.tgz
mv kafka_2.13-2.7.1 /usr/local/kafka

修改配置文件
cd /usr/local/kafka/config/
cp server.properties{,.bak} #备份文件

vim server.properties

broker.id=0     #zk01改1 zk02改2 zk03改3
#21行,broker的全局唯一编号,每个broker不能重复,因此要在其他机器上配置

broker.id=1、broker.id=2
listeners=PLAINTEXT://192.168.88.20:9092
#zk01改192.168.88.20:9092
#zk02改192.168.88.30:9092
#zk03改192.168.88.40:9092
#31行,指定监听的IP和端口,如果修改每个broker的IP需区分开来,也可保持默认配置不用修改

num.network.threads=3
#42行,broker 处理网络请求的线程数量,一般情况下不需要去修改

num.io.threads=8
#45行,用来处理磁盘IO的线程数量,数值应该大于硬盘数

socket.send.buffer.bytes=102400
#48行,发送套接字的缓冲区大小

socket.receive.buffer.bytes=102400
#51行,接收套接字的缓冲区大小

socket.request.max.bytes=104857600
#54行,请求套接字的缓冲区大小

log.dirs=/usr/local/kafka/logs
#60行,kafka运行日志存放的路径,也是数据存放的路径

num.partitions=1
#65行,topic在当前broker上的默认分区个数,会被topic创建时的指定参数覆盖

num.recovery.threads.per.data.dir=1
#69行,用来恢复和清理data下数据的线程数量

log.retention.hours=168
#103行,segment文件(数据文件)保留的最长时间,单位为小时,默认为7天,超时将被删除

log.segment.bytes=1073741824
#110行,一个segment文件最大的大小,默认为 1G,超出将新建一个新的segment文件

zookeeper.connect=192.168.88.20:2181,192.168.88.30:2181,192.168.88.40:2181
#123行,配置连接Zookeeper集群地址

修改环境变量
vim /etc/profile
export KAFKA_HOME=/usr/local/kafka
export PATH=$PATH:$KAFKA_HOME/bin
source /etc/profile

配置 Zookeeper 启动脚本
Kafka 命令行操作


#!/bin/bash
kconfig:2345 22 88
#description:Kafka Service Control Script

KAFKA_HOME='/usr/local/kafka'

case $1 in
    start)
        echo "---------- Kafka 启动 ------------"
        ${KAFKA_HOME}/bin/kafka-server-start.sh -daemon
        ${KAFKA_HOME}/config/server.properties
        ;;
    stop)
        echo "---------- Kafka 停止 ------------"
        ${KAFKA_HOME}/bin/kafka-server-stop.sh
        ;;
    restart)
        echo "---------- Kafka 重启 ------------"
        $0 stop
        sleep 5  # Optional: give Kafka some time to fully stop
        $0 start
        ;;
    status)
        echo "---------- Kafka 状态 ------------"
        count=$(ps -ef | grep kafka | egrep -cv "grep|$$")
        if [ "$count" -eq 0 ]; then
            echo "kafka is not running"
        else
            echo "kafka is running"
        fi
        ;;
    *)
        echo "Usage: $0 {start|stop|restart|status}"
        ;;
esac


设置开机自启
chmod +x /etc/init.d/kafka
chkconfig --add kafka

分别启动 Kafka
service kafka start

创建topic
kafka-topics.sh --create --zookeeper
192.168.88.20:2181,192.168.88.30:2181,192.168.88.40:2181 --replication-factor 2 -
-partitions 3 --topic test


--zookeeper:定义 zookeeper 集群服务器地址,如果有多个 IP 地址使用逗号分割,一般使用一个 IP
即可
--replication-factor:定义分区副本数,1 代表单副本,建议为 2
--partitions:定义分区数
--topic:定义 topic 名称


查看当前服务器中的所有 topic
kafka-topics.sh --list --zookeeper
192.168.88.20:2181,192.168.88.30:2181,192.168.88.40:2181

查看某个 topic 的详情
kafka-topics.sh --describe --zookeeper
192.168.88.20:2181,192.168.88.30:2181,192.168.88.40:2181

发布消息
kafka-console-producer.sh --broker-list
192.168.88.20:9092,192.168.88.30:9092,192.168.88.40:9092 --topic test

消费消息
kafka-console-consumer.sh --bootstrap-server
192.168.88.20:9092,192.168.88.30:9092,192.168.88.40:9092 --topic test --from-beginning

--from-beginning:会把主题中以往所有的数据都读取出来


修改分区数
kafka-topics.sh --zookeeper
192.168.88.20:2181,192.168.88.30:2181,192.168.88.40:2181 --alter --topic test --
partitions 6

删除 topic
kafka-topics.sh --delete --zookeeper
192.168.88.20:2181,192.168.88.30:2181,192.168.88.40:2181 --topic test
3.深入了解Kafka
3.1工作流程及文件存储机制
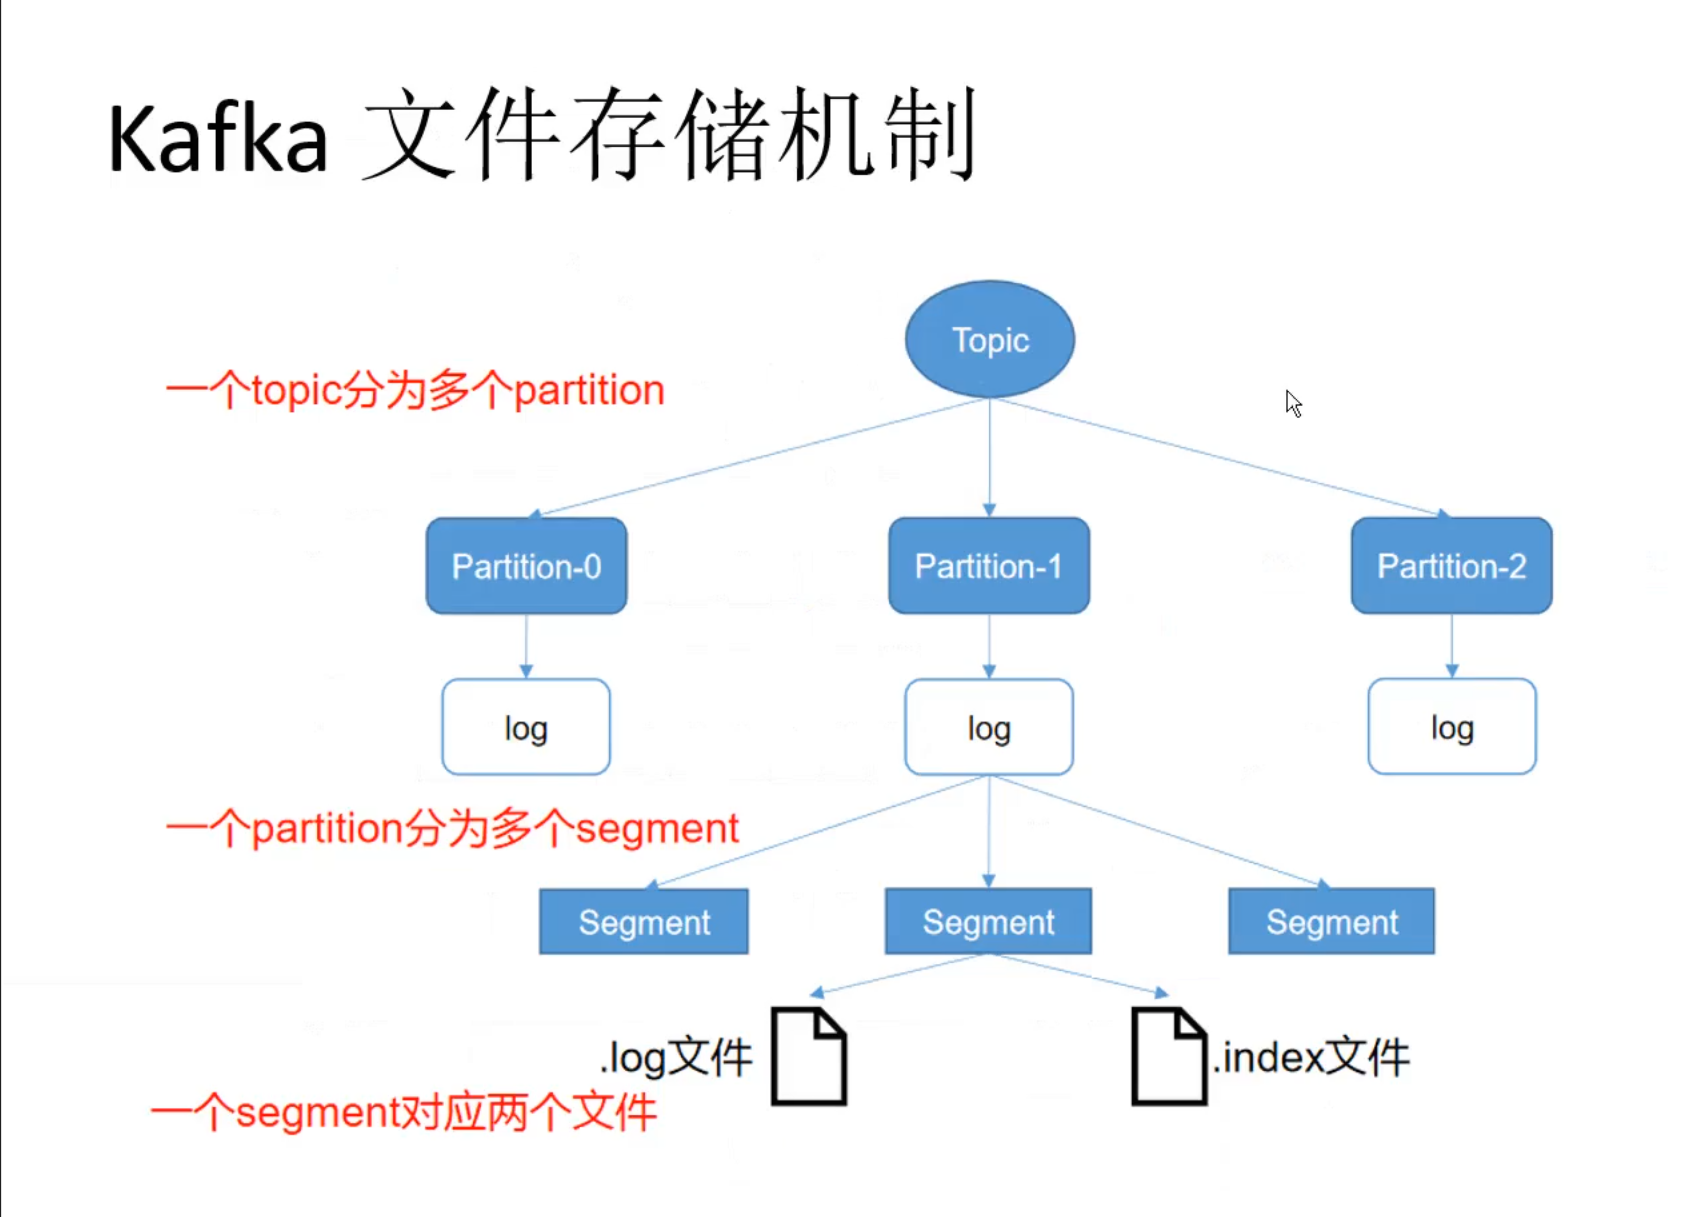
Kafka 中消息是以 topic 进行分类的,生产者生产消息,消费者消费消息,都是面向 topic 的。 topic 是逻辑上的概念,而 partition 是物理上的概念,每个 partition 对应于一个 log 文件,该 log 文件中存储的就是 producer 生产的数据。 Producer 生产的数据会被不断追加到该 log 文件末端, 且每条数据都有自己的 offset。 消费者组中的每个消费者,都会实时记录自己消费到了哪个 offset,以 便出错恢复时,从上次的位置继续消费。
由于生产者生产的消息会不断追加到 log 文件末尾,为防止 log 文件过大导致数据定位效率低下, Kafka 采取了分片和索引机制,将每个 partition 分为多个 segment。 每个 segment 对应两个文件: “.index” 文件和 “.log” 文件。这些文件位于一个文件夹下,该文件夹的命名规则为:topic名称+分区序 号。
假设test 这个 topic 有三个分区, 则其对应的文件夹为 test-0、test-1、test-2。 index 和 log 文件以当前 segment 的第一条消息的 offset 命名。“.index” 文件存储大量的索引信息,“.log” 文件存储大量的数据,索引文件中的元数据指向对应数据文件 中 message 的物理偏移地址。
3.2Kafka数据可靠性
为了保证 producer 发送的数据,能可靠的发送到指定的 topic,topic 的每个 partition 收到 producer 发送的数据后, 都需要向 producer 发送 ack(acknowledgement 确认收到),如果 producer 收到 ack,就会进行下一轮的发送,否则要重新发送数据。
3.3数据一致性
Kafka 通过 LEO(Log End Offset)和 HW(High Watermark)来管理副本间的数据同步和消费者的可见性,但这只能保证副本间数据的一致性,不能完全避免数据丢失或重复。
LEO:指的是每个副本最大的 offset;
HW:指的是消费者能见到的最大的 offset,所有副本中最小的 LEO。
(1)Follower 故障处理
当 Follower 副本发生故障时,Kafka 会将该副本暂时踢出 ISR(In-Sync Replica,即与 Leader 保持同步的副本集合)。
恢复过程:
Follower 恢复:当 Follower 副本恢复时,它会读取本地磁盘中记录的上次的 HW 值。
截断日志:Follower 会将本地log日志中大于 HW 的部分截掉,以保证它的日志与之前的 Leader 日志保持一致。这部分截断是为了避免恢复前接收到的消息与 Leader 不一致。
重新同步:Follower 从 HW 开始向 Leader 请求同步,直到它的 LEO 大于等于 Leader 的 HW,即 Follower 的日志追上 Leader。
重新加入 ISR:当 Follower 的 LEO 达到 Leader 的 HW 时,它会重新加入 ISR 集合。
注意:Follower 故障后即便恢复了,如果无法追上 Leader 的 HW,它将不会被视为一个同步副本,直到它重新与 Leader 同步为止。
(2)Leader故障处理
当 Leader 副本发生故障时,Kafka 会从 ISR 集合中选举一个新的 Leader。Kafka 的副本机制旨在保证系统在 Leader 故障时保持高可用性。
恢复过程:
选举新的 Leader:Kafka 会从 ISR 集合中选择一个新的 Leader,通常选择 LEO 最大的 Follower,来确保尽量多的消息被同步到新 Leader。
日志截断:选出新的 Leader 后,其余的 Follower(包括旧的 Leader 恢复后)会将本地日志中高于 HW 的部分截掉。这是为了确保所有 Follower 的日志与新的 Leader 保持一致,从而避免不一致的数据传播。
数据同步:Follower 副本从新的 Leader 同步日志,直到它们的 LEO 追上新的 Leader。此时,系统重新建立起一致性。
注意:在 Leader 故障时,Kafka 只能确保副本之间的数据一致性,但无法保证完全不丢失或不重复消息,尤其是在某些极端情况下(如 Leader 故障时未完全同步的消息)。
3.4 ack 应答机制
对于不太重要的数据,对数据的可靠性要求不高,能够容忍数据的少量丢失,所以没必要等 ISR 中的 follower 全部接收成功。所以 Kafka 为用户提供了三种可靠性级别,用户根据对可靠性和延
迟的要求进行权衡选择。
producer 向 leader 发送数据时,通过 request.required.acks 参数来设置数据可靠性的级别:
- 0:这意味着producer无需等待来自broker的确认而继续发送下一批消息。这种情况下数据传输效 率最高,但是数据可靠性确是最低的。当broker故障时有可能丢失数据。
- 1(默认配置):这意味着producer在ISR中的leader已成功收到的数据并得到确认后发送下一条 message。如果在follower同步成功之前leader故障,那么将会丢失数据。
- -1或all:producer需要等待ISR中的所有follower都确认接收到数据后才算一次发送完 成,可靠性最高。但是如果在 follower 同步完成后,broker 发送ack 之前,leader 发生故障会造成数据重复。
三种机制性能依次递减,数据可靠性依次递增。
在Kafka 0.11 版本前,只能保证数据不丢失,在下游消费者对数据做全局去重。在Kafka 0.11版本及以后版本的 ,引入了一项特性:幂等性。所谓的幂等性就是指 Producer 不论向 Server 发送多少次重复数据, Server 端都只会持久化一条。
(1)普通消息发送(无幂等性、无事务)
性能:最高
数据可靠性:最低
在Kafka 0.11 版本前,只能保证数据不丢失,在下游消费者对数据做全局去重。在Kafka 0.11版本及以后版本的 ,引入了一项特性:幂等性。所谓的幂等性就是指 Producer 不论向 Server 发送多少次重复数据, Server 端都只会持久化一条。
(2)幂等性Producer
性能:中等
数据可靠性:中等
在Kafka 0.11 版本前,只能保证数据不丢失,在下游消费者对数据做全局去重。在Kafka 0.11版本及以后版本的 ,引入了一项特性:幂等性。所谓的幂等性就是指 Producer 不论向 Server 发送多少次重复数据, Server 端都只会持久化一条。这大大减少了因网络问题或重试导致的消息重复问题,提高了数据的可靠性。然而,由于需要额外的处理来确保消息的幂等性,这可能会对性能产生一定的影响,但通常这种影响是可以接受的。
(3)事务性Producer
性能:最低
数据可靠性:最高
事务性Producer是Kafka中提供最高级别数据可靠性的机制。它允许用户将一组消息作为一个原子事务提交,确保这些消息要么全部成功写入,要么全部失败。这种机制通过协调Producer与Kafka Server之间的交互,使用两阶段提交协议(2PC)来保证事务的原子性。虽然事务性Producer提供了最高的数据可靠性,但由于其复杂的协调机制和额外的处理开销,它的性能通常会比普通消息发送和幂等性Producer更低。
总结
| 机制 | 性能 | 数据可靠性 |
|---|---|---|
| 普通消息发送(无幂等性、无事务) | 最高 | 最低 |
| 幂等性Producer | 中等 | 中等 |
| 事务性Producer | 最低 | 最高 |
这些机制在Kafka中提供了不同的性能和可靠性权衡,可以根据具体的应用场景和需求来选择最适合的机制。
3.5 Filebeat+Kafka+ELK 配置
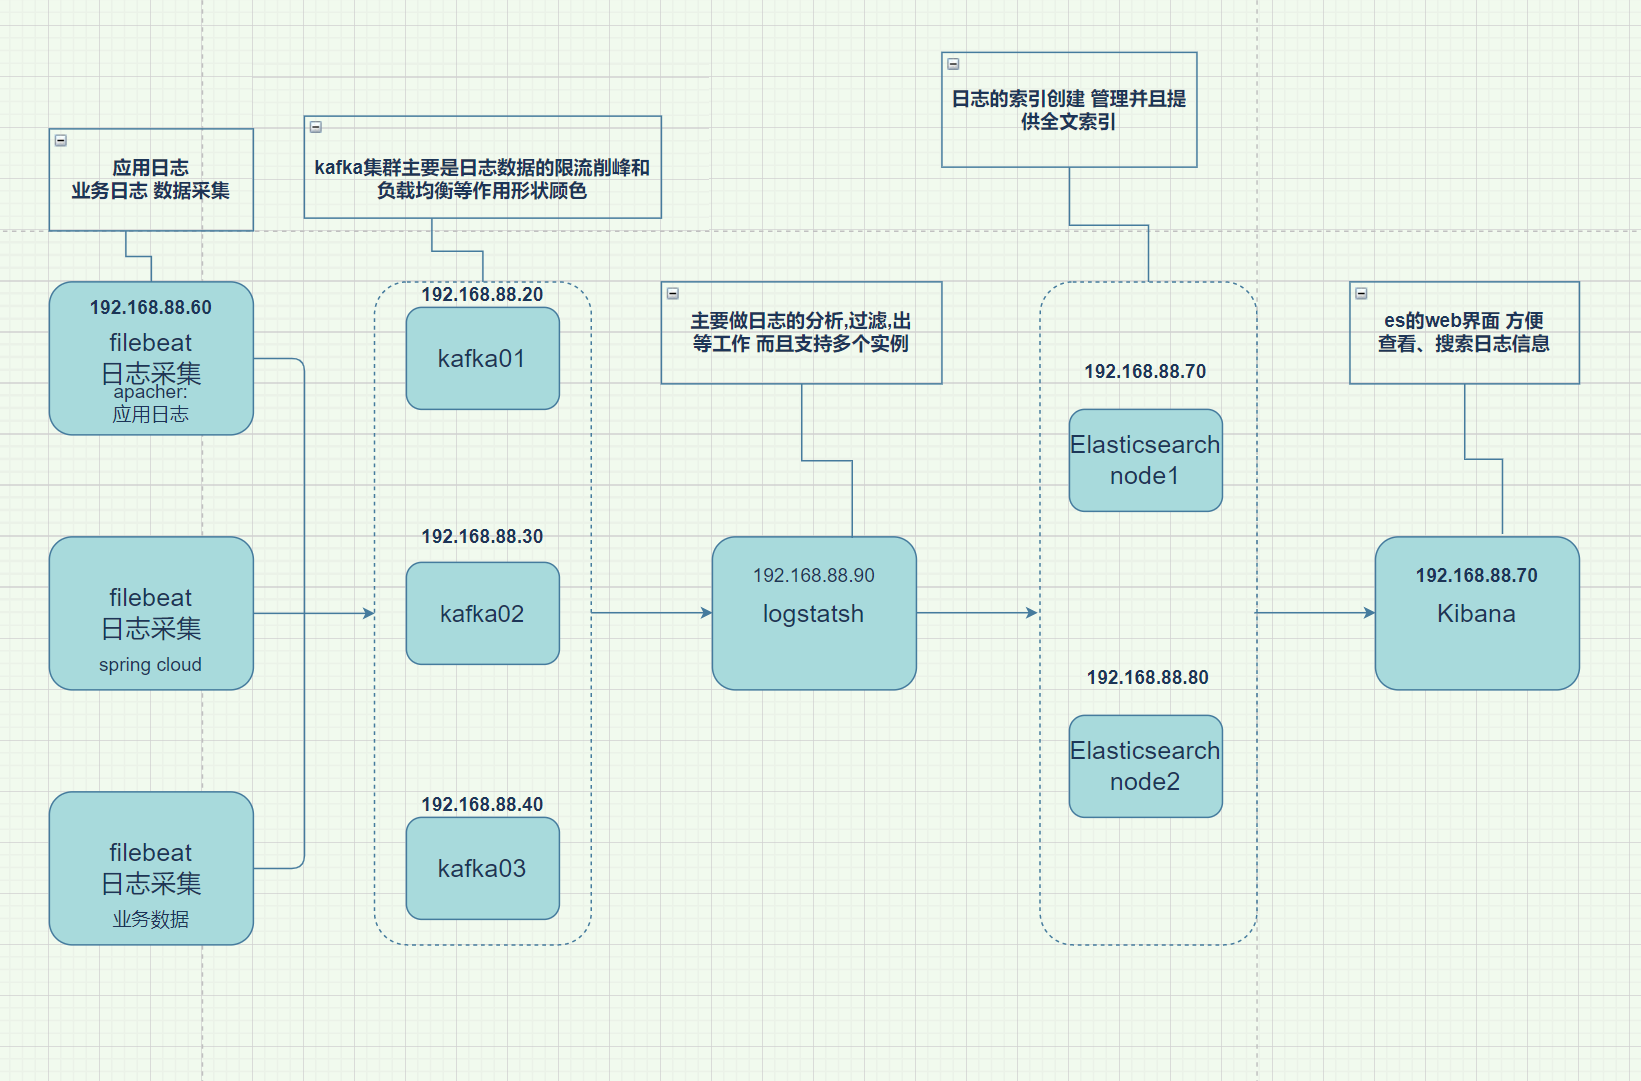
(1)配置Zookeeper+Kafka 集群
已完成
(2)配置Filebeat
cd /usr/local/filebeat
vim filebeat.yml
filebeat.prospectors:
- type: log
enabled: true
paths:
- /var/log/httpd/access_log
tags: ["access"]
- type: log
enabled: true
paths:
- /var/log/httpd/error_log
tags: ["error"]
......

添加输出到 Kafka 的配置
output.kafka:
enabled: true
hosts: ["192.168.88.20:9092","192.168.88.30:9092","192.168.88.40:9092"] #指定 Kafka 集群配置
topic: "httpd" #指定 Kafka 的 topic

启动 filebeat
./filebeat -e -c filebeat.yml
(3)配置 ELK
在 Logstash 组件所在节点上新建一个 Logstash 配置文件
cd /etc/logstash/conf.d/
vim kafka.conf
input {
    kafka {
        bootstrap_servers => "192.168.88.20:9092,192.168.88.30:9092,192.168.88.40:9092" # Kafka集群地址
        topics => ["httpd"] # 确保topics是一个数组,即使只有一个topic
        type => "httpd_kafka" # 指定type字段,用于后续处理时区分日志来源
        codec => "json" # 解析JSON格式的日志数据
        auto_offset_reset => "latest" # 从Kafka的最近偏移量开始消费
        decorate_events => true # 保留Kafka事件的元数据,如offset等
    }
}

output {
    if "access" in [tags] {
        elasticsearch {
            hosts => ["192.168.88.70:9200"] # 确保Elasticsearch地址正确
            index => "httpd_access-%{+YYYY.MM.dd}" # 根据日期动态创建索引
        }
    }

    if "error" in [tags] {
        elasticsearch {
            hosts => ["192.168.88.70:9200"] # 修正了之前可能误写的地址
            index => "httpd_error-%{+YYYY.MM.dd}" # 根据日期动态创建索引
        }
    }

    # 如果需要调试,可以保留stdout输出
    stdout {
        codec => rubydebug # 以rubydebug格式输出到控制台,方便调试
    }
}

logstash -f kafka.conf
黑屏操作es时查看所有的索引:curl -X GET "localhost:9200/_cat/indices?v"
(4)添加Kikan
浏览器访问 http://192.168.88.70:5601 登录 Kibana,单击“Create Index Pattern”按钮 ,添加索引“filebeat_test-*”,单击 “create” 按钮创建,单击 “Discover” 按钮可查看图表信息及日 志信息。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 12
 0
- 0


 已为社区贡献2条内容

所有评论(0)