软件测试之测试用例理论知识
文章目录
前言
阅读本文前请注意最后编辑时间,文章内容可能与目前最新的技术发展情况相去甚远。欢迎各位评论与私信,指出错误或是进行交流等。
1、测试用例的基本概念
测试用例(Test Case)是为了实施测试而向被测试的系统(软件)提供的一组集合,为了验证某个需求是否实现、是否存在缺陷。这组集合包含:测试环境、操作步骤、测试数据、预期结果等要素 。
通俗的讲,就是把我们将测试系统的操作步骤按照一定的格式用文字描述出来。
1.1 为什么需要测试用例
-
问:如果我们不使用测试用例,难道就没办法检查出缺陷吗?
-
答:不编写测试用例直接进行测试,当然可以检查出缺陷。但这样是有风险的,不能够保证测试的全面覆盖。除此之外,测试用例带来的好处还有以下几点:
1.理解需求
在编写用例的过程中,梳理业务整体流程、思考产品需求的细节,找出需求是否存在不合理、有矛盾、不明确等问题。
2.理清测试思路,避免遗漏
测试用例的编写,实际上是把需求转换为一种可操作步骤的行为。将所有的操作步骤都书写出来,是梳理测试思路的过程,避免遗漏掉要测试的功能点。
3.测试数据的准备
在测试实践中,测试数据是与测试步骤分离的。在测试执行前,按照测试用例准备一组或若干组测试数据,特别是一些需要其他人员协助准备的测试数据。
4.跟踪测试进展
依照测试用例执行测试,并及时记录每一个测试用例的测试结果,这样项目成员都能够清楚地了解到目前已经完成了哪些测试,这些测试覆盖了哪些需求。那么在一些突发情况下,比如你被调离或离职,别人也能迅速了解测试覆盖内容及测试进度。
5.历史参考
在我们所做的项目中,也许会有很多功能是相同或相近的,我们对这类功能设计了测试用例,便于以后我们遇到类似功能的时候可以做参考依据。
6.复用
一个系统不是仅测试一遍就完成,测试用例可以复用,在进行回归测试的时候不用重新编写。
1.2 评价测试用例的标准
- 用例表达清楚,无二义性
- 用例的输入与输出明确,一条用例只有一个预期结果。
- 用例对需求的覆盖率高
1.3 测试用例的特性
- 代表性:能够代表并覆盖各种合理的和不合理、合法的和不合法的、边界的和越界的以及极限的输入数据、操作等。
- 针对性:对程序中的可能存在的错误有针对性地测试
- 可判定性:测试执行结果的正确性是可判定的,每一个测试用例都应有相应的期望结果
- 可重现性:对同样的测试用例,系统的执行结果应当是相同的。
1.4 测试用例示例
假如有一个需求是要测试某网站的登录功能。
功能描述如下:
1.用户在地址栏输入相应地址,要求显示登录界面;
2.输入用户名和密码,登录,系统自动校验,并给出相应提示信息;
| 测试用例ID | 功能点 | 测试步骤 | 输入 | 预期输出 | 实际输出 | 测试结果 |
|---|---|---|---|---|---|---|
| 001 | 登录界面显示 | 在浏览器地址栏中输入相应地址 | 网页地址 | 显示登录界面 | 显示登录界面 | |
| 002 | 登录 | 输入用户名和密码,点击登录 | 用户名:user 密码:123456 | 提示登录成功 | 登录成功 | |
| 003 | 登录 | 输入用户名和密码,点击登录 | 用户名:test 密码:123456 | 提示用户名或者密码错误 | 提示用户名或者密码错误 | |
| 004 | 登录 | 输入用户名和密码,点击登录 | 用户名: 密码:123456 | 提示用户名不能为空 | 提示用户名不能为空 | |
| 005 | 登录 | 输入用户名和密码,点击登录 | 用户名:user 密码: | 提示密码不能为空 | 提示密码不能为空 |
以上给出了关于登录功能的一些测试用例,但是所给出的测试用例覆盖程度不够高。此外,例如上方表中测试用例ID为003的测试用例,该用例是输入了错误的数据进行测试,那么错误的数据是有无限多个的,又该如何进行选择呢?因此,需要学习测试用例的设计方法。
1.5 测试用例设计方法
1.5.1 等价类划分法
我们可以依照数据的特性,将所有的测试数据分为若干个类,每一类的代表性数据在测试中的作用等价于这一类中的其他值,也就是说,如果某一类中的一个数据测试后发生了错误A,那么这一等价类中的其他数据也能发现这个错误A;反之,如果某一类中的一个数据没有发现错误,则这一类中的其他数据也不会查出错误,这种划分数据的方法被称为等价类划分方法。
等价类可以划分为:有效等价类和无效等价类:
- 有效等价类:符合程序规格说明的数据集合;
- 无效等价类:不符合软件需求规格说明的数据集合;
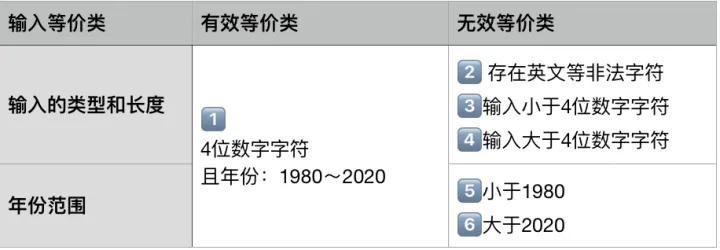
需求举例:要求用户输入年份,年份限定在1980年~2020年,由4位数字表示。
使用等价类划分法,首先确定有效等价类:4位数字字符且年份为1990~2020,然后确定无效等价类:如输入的类型和长度不合理,年份超出范围等,具体如下表所示:
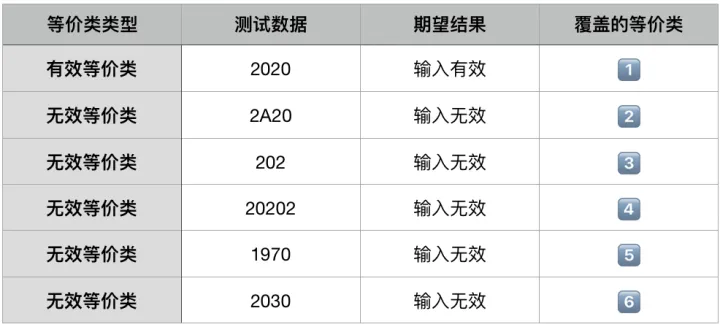
设计测试用例,覆盖所有的有效等价类和无效等价类:
1.5.2 边界值法
从过往的经验来看,大量的错误发生在输入或输出范围的边界上,而不是在输入输出范围的内部。因此针对各种边界情况设计测试用例,有很大的概率可以查出更多的错误。
根据边界值划分法,应当选取正好等于、刚刚大于、刚刚小于边界的值作为测试数据。除了要关注边界值还要关注默认值,空值,零值。要特别说明的是,使用边界值法不仅只考虑输入数据,也应该考虑输出数据。
需求举例:豆瓣用户可在首页搜索框内输入关键词搜索感兴趣的内容。如在豆瓣搜索“星际穿越”。
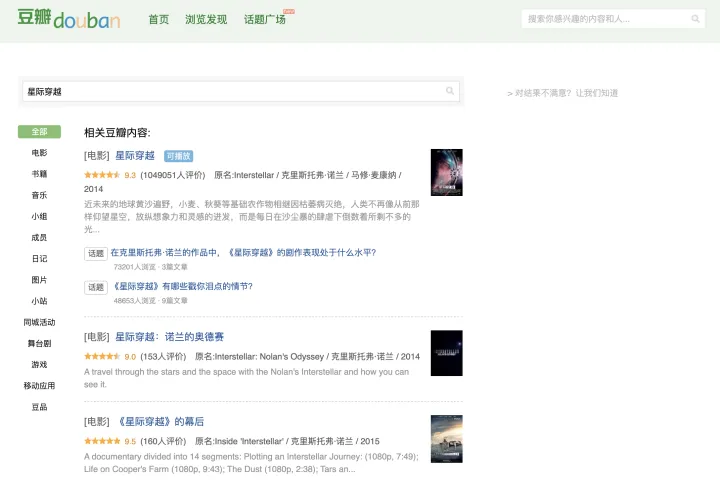
使用边界值法设计测试用例,覆盖输入数据和输出数据:
关键词(输入数据):
- 为空(空值,且正好小于最小长度)
- 关键词长度为1(正好等于最小长度)
- 关键词长度为60(正好等于最大长度)
- 关键词长度为61(刚刚大于最大长度)
搜索结果(输出数据):
- 搜索结果为空(空值)
- 有一个搜索结果
- 有20个搜索结果(一次最多展示20条数据)
- 有21个搜索结果(通过更多按钮查看, 21条数据刚好大于最多展示20条数据)
1.5.3 判定表法
使用场景:有多个输入和多个输出,而且输入与输入之间有相互的组合关系、输入和输出之间有相互的制约和依赖关系。
先举个例子,好理解一些。
问题描述:
1.对于功率大于50马力的机器,且维修记录不全的机器
2.已运行10年以上的机器
满足以上一个条件的机器, 应给予优先的维修处理。
根据上诉需求,分别找出所有的输入和输出,并找出输入与输出之间的所有可能的组合关系,画出判定表。
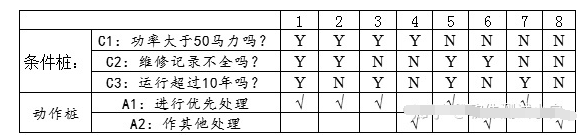
如上表所示, 第二条 满足功率大于50马力,且维修记录不全,因此需要进行优先处理。
通过上述例子,应该对该方法有所了解。下面介绍该方法的一些理论知识:
条件桩:输入条件, 列出了系统的所有输入,列出的输入次序无关紧要,每个条件有两个取值(0,1)。
动作桩:输出结果, 列出了系统可能采取的操作,这些操作的排列顺序没有约束
条件项:输入条件取值的全部组合
动作项:条件项对应的所有的结果, 列出在条件项的各种取值情况下应该采取的动作
规则:一组条件与动作的组合,一条规则对应一条测试用例
判定表法使用步骤总结:
1.分析需求,确定条件桩和动作桩
2.全组合条件,得到条件项;
3.根据条件项,依次填写动作项;
4.输出测试用例(一个规则对应一条测试用例)
1.5.4 场景设计法
现在的软件几乎都是用事件触发来控制流程的,事件触发时的情景便形成了场景,而同一事件不同的触发顺序和处理结果就形成事件流。这种在软件设计方面的思想也可以引入到软件测试中,可以比较生动地描绘出事件触发时的情景,有利于测试设计者设计测试用例,同时使测试用例更容易理解和执行。
场景设计法可模拟用户操作软件时的场景。场景法的应用偏重于业务流程,目的是用业务流把各个孤立的功能点串起来,避免陷入功能细节忽视业务流程要点的错误倾向。
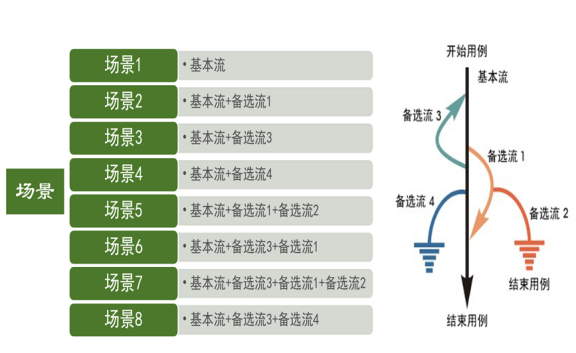
用例场景是通过描述流经用例的路径来确定的过程,这个流经过程要从用例开始到结束遍历其中所有基本流和备选流。
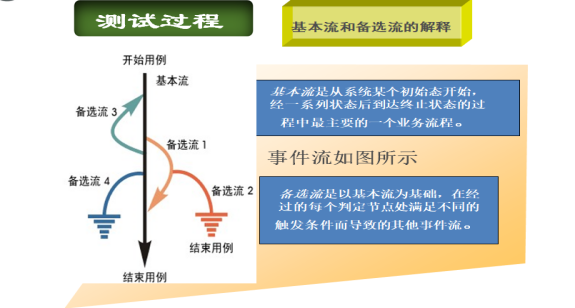
遵循上图中每个经过用例的可能路径,可以确定不同的用例场景。从基本流开始,再将基本流和备选流结合起来,可以确定以下用例场景:
银行案例ATM:
个人标识号 (PIN=personal identification number ),用于保护智能卡免受误用的秘密标识代码。PIN 与密码类似,只有卡的所有者才知道该 PIN。只有拥有该智能卡并知道 PIN 的人才能使用该智能卡
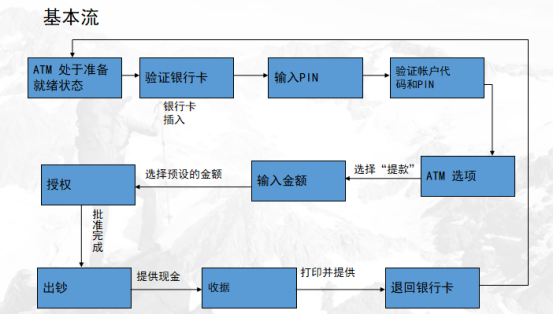
在基本流的一些判定结点,给出其他的条件,而导致其他结果。
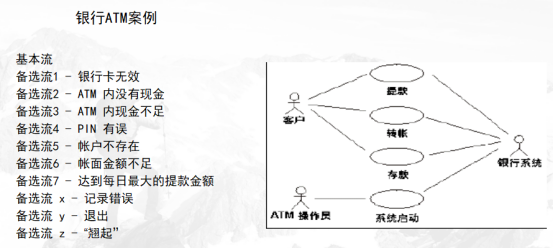
只挑选实施了下面的事件流:
基本流-提取预设金额100 元
备选流2 - ATM 内没有现金
备选流3 - ATM 内现金不足
备选流4 - PIN 有误
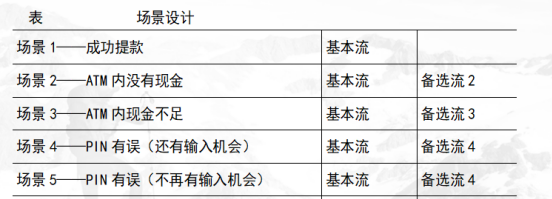
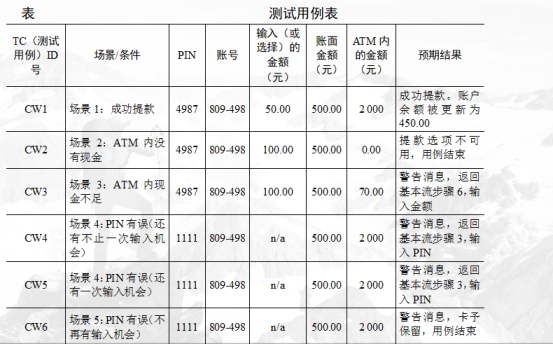
对于5个场景中的每一个场景都需要确定测试用例。(下图中出现了6个场景,是由于PIN输入有误后,还有两次输入机会,此处不严谨,但由于改动较为麻烦,大家了解即可)
1.5.5 正交法
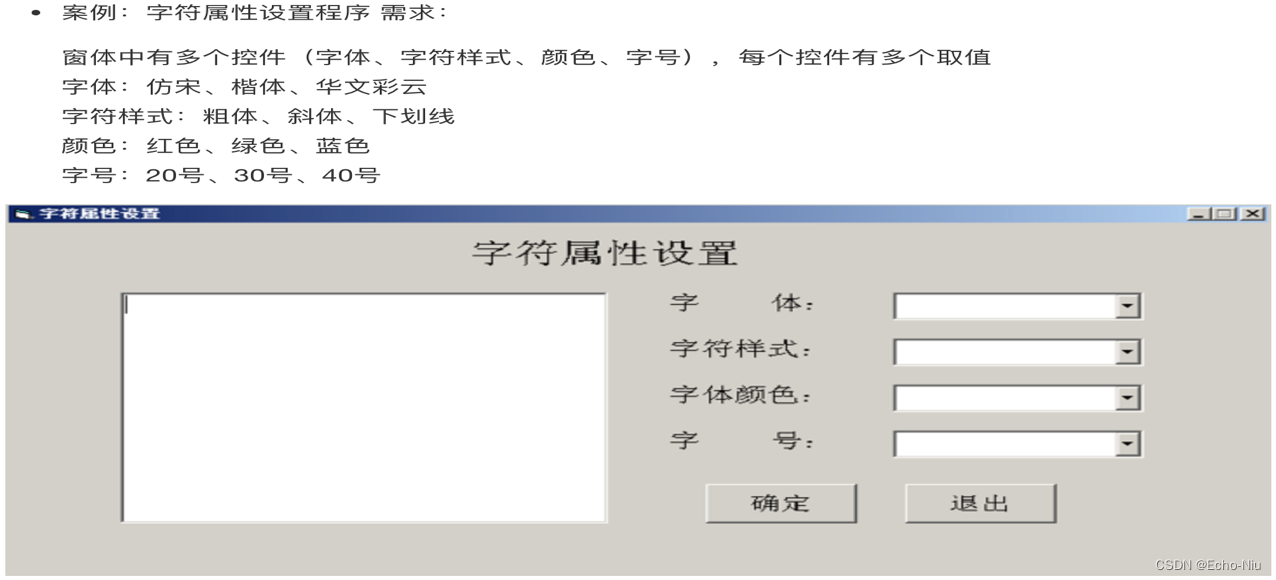
通过分析我们发现,对于图中的程序而言,我们要设计81条测试用例,那么有没有一种方法能够使用最小的测试集合获得最大的测试覆盖率呢?
正交法,也叫正交实验法或者正交排列法,就是使用最小的测试集合获得最大的测试覆盖率。
“正交实验”是研究多因素、多水平的一种实验方法,它利用正交表来对实验进行设计,通过少数实验代替全面的实验.
在一项实验中,把影响试验结果的量称为试验因素(因子),简称因素。因素可以理解为试验过程中的自变量,试验结果可以看成因素的函数。在试验过程中,每一个因素可以处于不同的状态或状况,把因素所处的状态或状况,称为因素的水平,简称水平。
1992年AT&T公司,针对某一个软件做了一个回归测试:
在18个周(4个半月)的时间范围内测试1500条测试用例。后来开发时间推迟了,测试时间被压缩了。测试经理想了一个办法,两个人在8个周(2个月)测试1000条测试用例。但是测试经理不能保证该软件就是完全没有问题的。后来他决定用正交表去重新设计一下测试用例,422条测试用例,42个bug。测试完毕后,软件上线了。在上线的两年时间内。凡事被测试到的领域,都没有发现任何问题。后来呢,他从头到尾有总结了一番:有可能只会测试出32条bug。
前后对比:
测试用例的条数少了
测试出来bug的数量多了
正交表是一种特制的表, 一般记为
L
n
(
m
k
)
Ln(m^k)
Ln(mk)
n 是需要测试组合的次数
k 表示控件个数(因素的个数,或因子的个数)
m 是每个控件包含的取值个数(各因素的水平数,即各因素的状态数)
例如
L
9
(
3
4
)
L9(3^4)
L9(34)
正交表如下
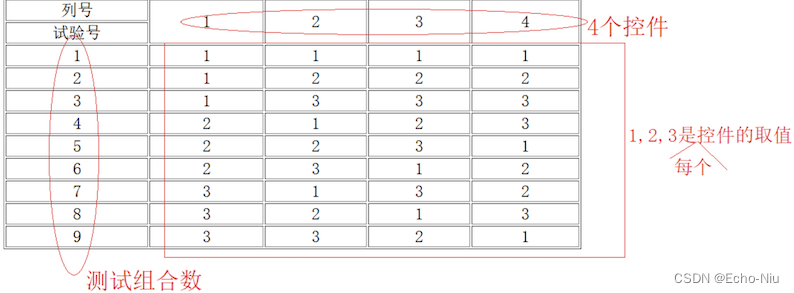
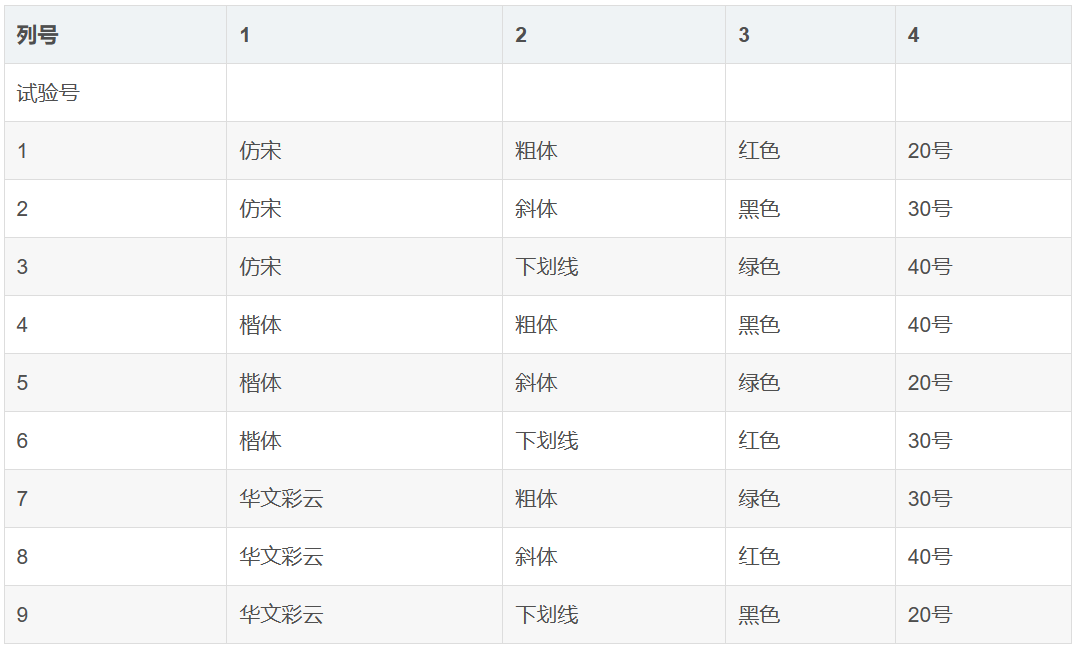
1.5.5.1 使用正交法设计测试用例
- 根据需求把因素及其取值列举出来
- 根据因素和因素的取值个数,选择一个合适的正交表
- 根据控件的个数,选择正交表的次幂,也就是正交表中包含的最大值, 例如,4个控件,选择4次幂
- 根据控件取值个数,选择正交表的底,也就是正交表包含的最大值, 例如, 每个控件有3个取值,底是3
- 把控件及其取值映射到正交表中
- 把控件名字分别映射到正交表的列名位置
- 把正交表中每一列的数字分别用对应的控件取值替代
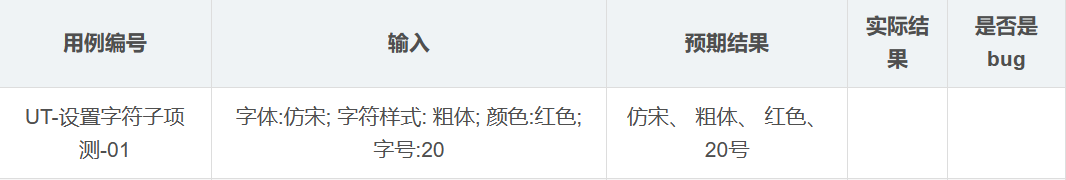
- 根据正交表,编写测试用例
案例:
实现“字符属性设置”的测试用例编写
(1). 列举因子表
| 字体 | 字符样式 | 字体颜色 | 字号 |
|---|---|---|---|
| 仿宋 | 粗体 | 红色 | 20号 |
| 楷体 | 斜体 | 绿色 | 30号 |
| 华文彩云 | 下划线 | 蓝色 | 40号 |
(2) 确定使用的正交表
L
9
(
3
4
)
L9(3^4)
L9(34)
关于n 即需要测试组合的次数, 计算方式如下:
n = (水平数 - 1)* 因素数 + 1
(3). 把控件及其取值映射到正交表中(生成正交表,可以利用一些工具,具体则上网查询)
在向正交表中填写数据的时候要先知道正交表的两个性质:
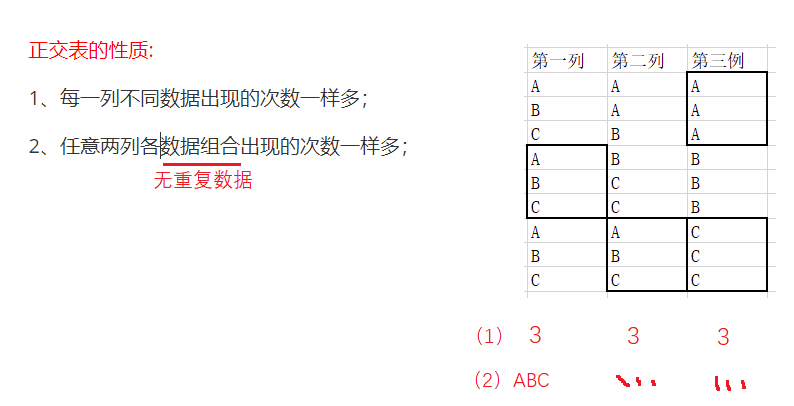
(4). 编写测试用例
正交法使用场景
- 需求中条件的组合量比较大的时候
局限性
正交表一般要求每个控件的取值相等,但是这在实际中很难应用,所以在实际使用时要进行取舍
- 对于控件的取值,应该少数服从多数, 有更多空间的取值一样
1.5.6 错误推测法
错误猜测法是测试经验丰富的人喜欢使用的一种测试用例设计方法。
一般这种方法是基于经验和直觉推测程序中可能发送的各种错误,有针对性地设计。只能作为一种补充。
例如,测试手机终端的通话功能,可以设计各种通话失败的情况来补充测试用 例:
-
无SIM 卡插入时进行呼出(非紧急呼叫)
-
插入已欠费SIM卡进行呼出
-
射频器件损坏或无信号区域插入有效SIM卡呼出
-
网络正常,插入有效SIM卡,呼出无效号码(如1、888、333333、不输入任何号码等)
-
网络正常,插入有效SIM卡,使用“快速拨号”功能呼出设置无效号码的数字
最重要的是要思考和分析测试对象的各个方面,多参考以前发现的bug的相关数据,总结的经验,个人多考虑异常的情况、反面的情况、特殊的输入,以一个攻击者的态度对待程序,就能设计出比较完善的测试用例来。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 30
 0
- 0


 已为社区贡献8条内容

所有评论(0)