【算法】滑动窗口
目录
1、长度最小的子数组

1.1 代码原理讲解
这道题很容易就能想到使用暴力枚举,双层枚举产生一个区间,再利用在这个区间中遍历计算出这个区间的和,此时的时间复杂度是O(N^3),当然,对暴力枚举的方法优化的话可以让时间复杂度到O(N^2),因为可以用一个sum来不断更新这个区间的和
对暴力枚举的优化
1. 由题目可知,数组中的数据都是正整数,也就是说,加的值越多,和越大(单调性)
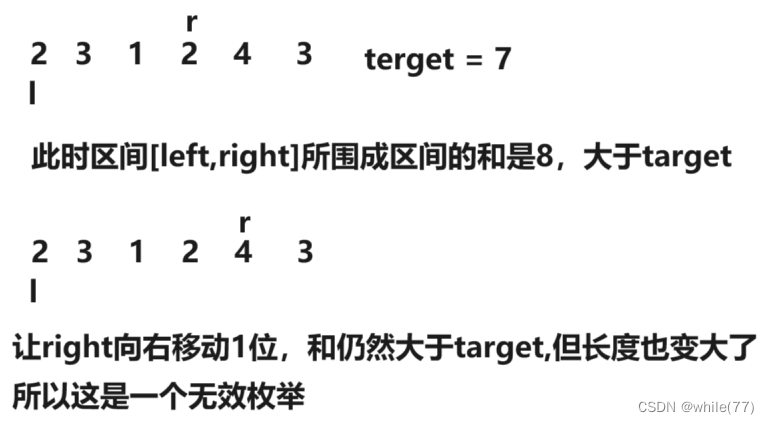
当left和right所围成区间的和已经大于等于target时,再让right++,形成的新的区间的和一定比原来的区间的和大,所以也大于等于target,但同时长度也更长,而我们要寻找的时长度最小的子数组,所以当left和right所围成区间的和第一次大于等于target,再让right往后遍历实际上是没有意义的,所以当围成区间大于等于target时,right停止,让left++
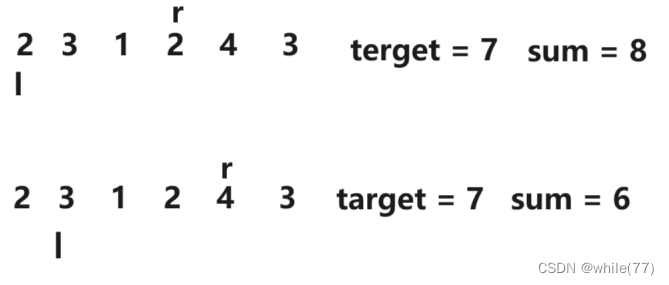
2.当left++时,我们是可以知道[left + 1, right]这个区间的值的,所以可以不用移动right,只更新sum即可
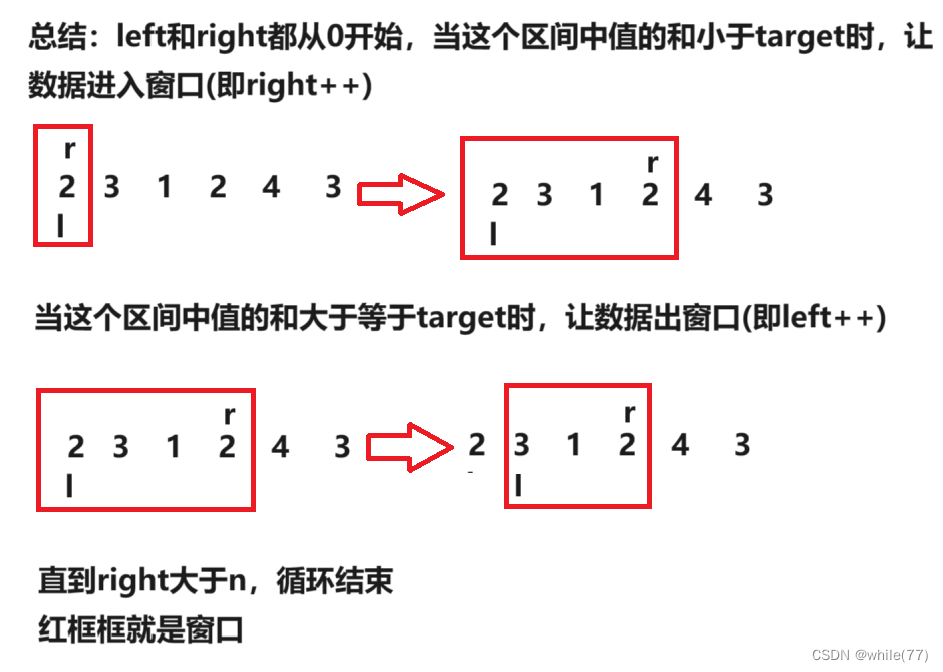
根据单调性推理出的这两个性质,我们可以使用 "同向双指针" 来解决这个题,"同向双指针"就是在两指针移动的过程中,维护[left,right]这个区间中的信息,像这里就是和,就像一个窗口从左向右遍历数组。所以"同向双指针" 也称为 滑动窗口
什么时候用? 当暴力枚举时,两指针都可以不倒退(通常利用单调性)
怎么用?1. left = 0,right = 0
2. 进窗口
3. 判断,出窗口
在后两步中还会穿插一个更新结果的步骤,只是这个更新结果的步骤有些题是在进窗口的时候更新,有些题是在出窗口的时候更新,需要就题论题,这道题是在出窗口的时候更新
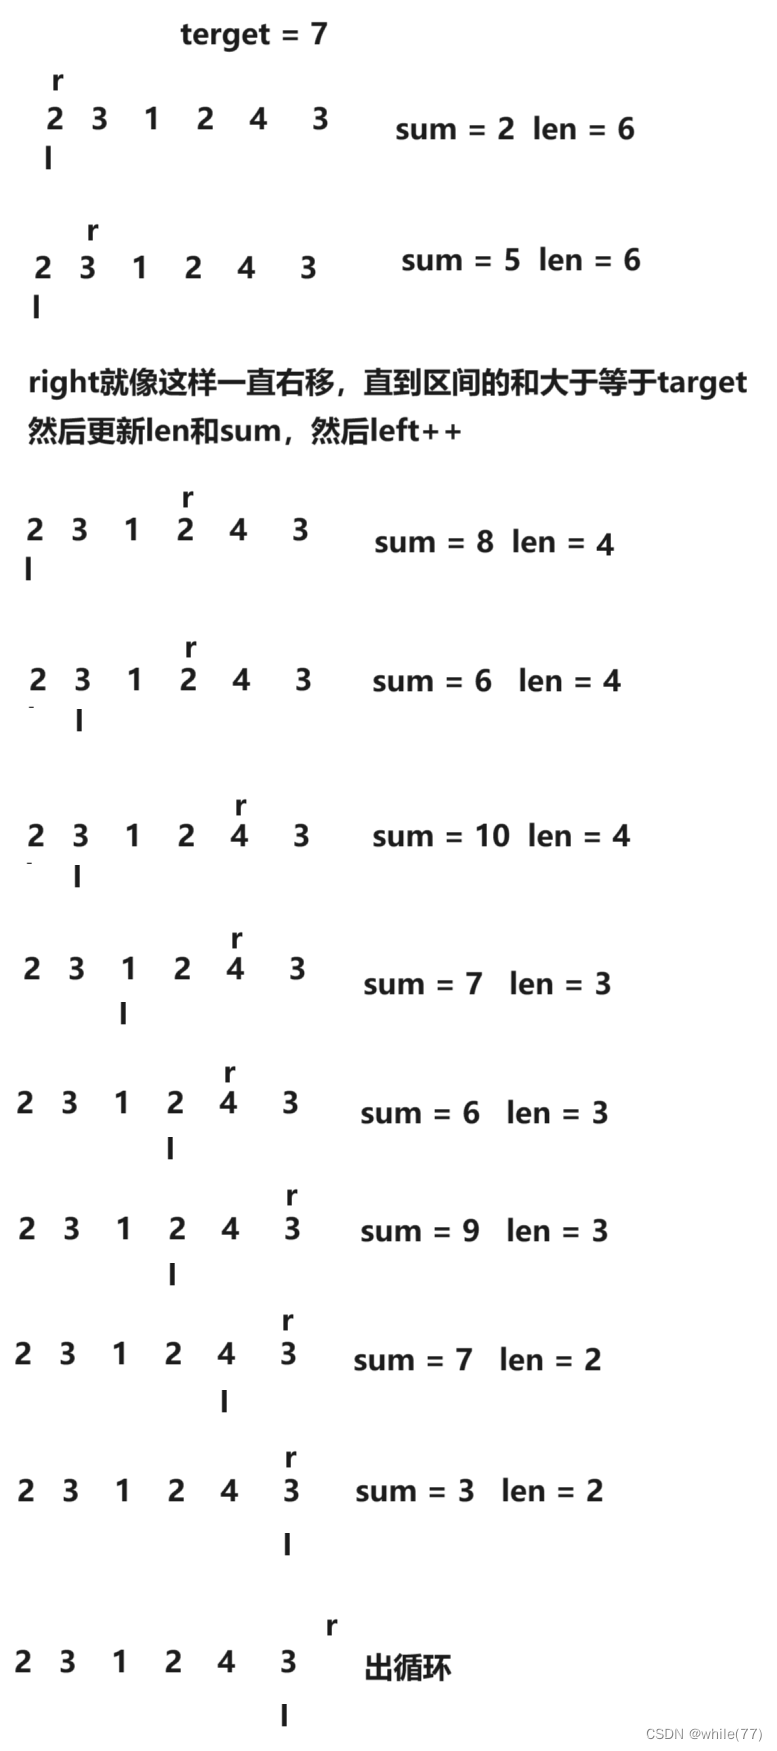
正确性:在前面单调性中,有些情况没有枚举到,为什么还是正确的呢?
虽然有些情况没有枚举到,但是我们已经知道剩下的情况枚举了也是白枚举(单调性),利用单调性,规避了很多没有必要的枚举
时间复杂度
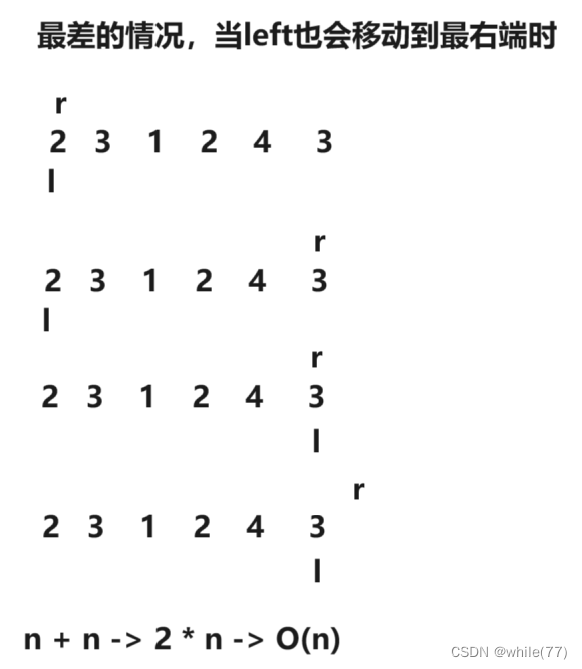
1.2 代码实现
class Solution {
public:
    int minSubArrayLen(int target, vector<int>& nums) {
        int left = 0,right = 0,sum = 0;
        int n = nums.size(),len = INT_MAX;
        while(right < n)
        {
            while(right < n && sum < target) // 固定left,让right一直向右,直到sum大于等于target再出循环
            {                                // 当然也有一种情况是left和左边剩下所有的数的和小于target,所以出去要判断一下
                sum += nums[right];
                if(sum >= target) break;
                else right++;// 入窗口
            }
            if(right == n) break;// 在当前的[left,right]区间内,枚举到了最后都没有大于target的就直接出循环
            len = min(len,right - left + 1);// 取当前窗口的长度和现在的len中小的呢一个来更新len
            sum -= nums[left++];// 出窗口
            if (sum < target) right++;
            // 注意,left出窗口后要检查一下sum是否小于target了,若小于则right要++,否则进入下一次循环时
            // sum+=nums[right]时会出现一个right加了两次的行为
        }
        return len == INT_MAX? 0 : len;
    }
};
2、无重复字符的最长子串
2.1 解法一(滑动窗口)
这道题很容易就能想到暴力枚举+哈希表的解法,暴力枚举每个字符的最长子串的长度,再取一个最大值就是结果,但是这样的最坏时间复杂度是O(N^2)的
对暴力枚举的优化
1. 有些字符是没有必要枚举的
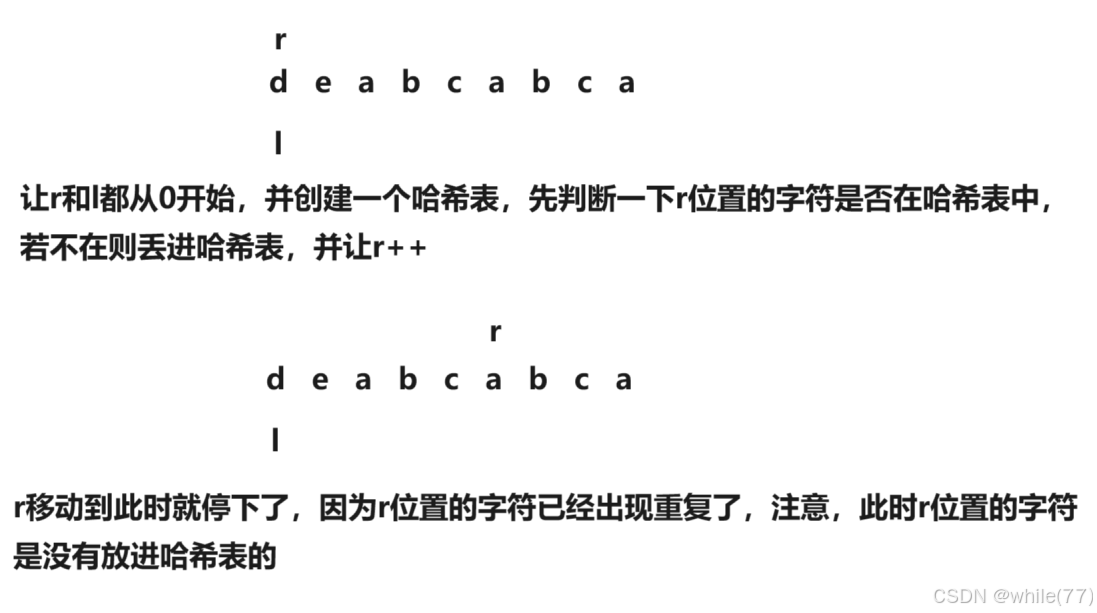
若是暴力解法,此时就会让l和r都回到e的位置,再来一遍上面的步骤,会发现,r仍然是移动到a的位置就停下了,原因就在于重复的a在e的后面,所以应该让l先跳过a的位置
2. r没有必要回来
l跳过了a后,l和r之间就没有重复的字符了,所以r是没有必要回来的
此时,很明显满足滑动窗口的使用条件
进窗口:当l和r之间没有重复字符时
判断,出窗口:当l和r之间有重复字符时,此时出窗口,让l++,并将哈希表的l++的值移除,直到l和r之间没有重复字符
更新结果:当l和r之间出现重复字符时,此时r指向的位置没有放进哈希表,也就是说此时l和r之间的长度就是以这个l为起点的最长子串,此时就更新
class Solution {
public:
    int lengthOfLongestSubstring(string s) {
        int n = s.size();
        if(n == 0) return 0;
        if(n == 1) return 1;
        int hx[128] = {0},sum = 0,left = 0,right = 0;
        while(right < n)
        {
            while(right < n && hx[s[right]] == 0)
            {
                hx[s[right]]++;
                right++;
            }
            // 更新结果
            sum = max(sum, right - left);
            // 出窗口,这里利用上面的判断,因为如果有重复,上面的while不会进去
            hx[s[left]]--;
            left++;
        }
        return sum;
    }
};
时间复杂度是O(N),空间复杂度是O(1)
2.2 解法二(动态规划)
我们以f(i)表示以第i个字符为结尾的不包含重复字符的子字符串的最长长度。我们从左向右逐一扫描字符串的每个字符,当我们计算f(i)时,我们已经知道了f(i-1),并且f(0)=1
如果第i个字符在之前没有出现过,那么f(i)=f(i-1)+1。例如,"arabcacfr",显然f(0)=1,在计算f(1)时,'r'在之前是没有出现过的,所以f(1)=f(0)+1=2
如果第i个字符在之前出现过,我们需要先计算第i个字符和它上次出现在字符串中的距离d,接着分两种情况讨论。
第一种情况,d <= f(i-1),说明以第i-1个字符为结尾的不包含重复字符的子字符串中含有第i个字符,所以f(i)=d。如"arabcacfr"中的f(2),很明显,'a'在之前出现过了,所以d是2,由前面计算可知,f(1)=2,所以以第1个字符为结尾的最长字串中含有'a',所以f(2)=2
第二种情况,d > f(i-1),此时第i个字符上次出现在以第i-1个字符为结尾的不包含重复字符的子字符串之前,所以f(i)=f(i-1)+1。如"arabcacfr"中的最后一个字符'r',即f(8),易知f(7)=3,'r'与上一次出现过的距离d是7,所以f(8)=4
class Solution {
public:
    int lengthOfLongestSubstring(string s) {
        int n = s.size();
        if(n == 0) return 0;
        int dp[n],hx[128];// dp[i]表示以第i个字符结尾的最长不重复子串的长度
        for(int i = 0;i<128;i++) hx[i] = -1;// hx数组用来记录每个字符最后一次出现的位置
        dp[0] = 1,hx[s[0]] = 0;
        for(int i = 1;i < n;i++)
        {
            if(hx[s[i]] == -1) dp[i] = dp[i - 1] + 1;
            else
            {
                int d = i - hx[s[i]];
                if(d <= dp[i - 1]) dp[i] = d;
                else dp[i] = dp[i - 1] + 1;
            }
            hx[s[i]] = i;
        }
        return *max_element(dp,dp+n);
    }
};
3、最大连续1的个数III
这道题要实现翻转无疑是很困难的,所以我们可以对其进行转化。转化:找出最长的子数组,0的个数不超过k个。注意,题目里面说的是翻转最多k个0,不一定真的要翻转到k个
暴力解法是枚举每一个数作为子数组的起始位置,最后再计算出最长的
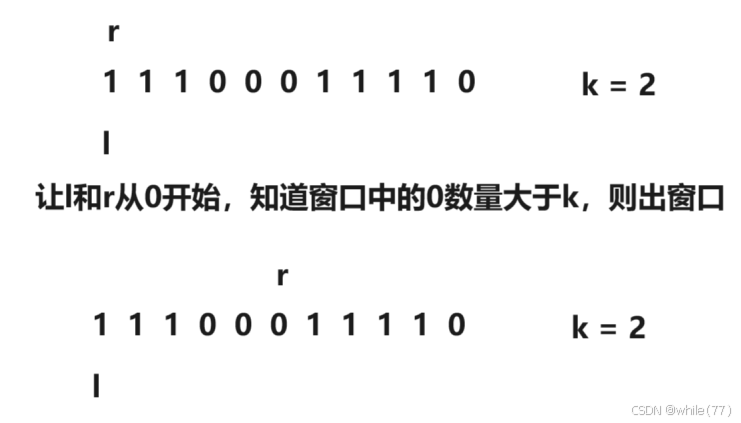
按照暴力枚举的做法,此时应该让l和r都到第2个1的位置,再来一次前面的操作,但是会发现,r仍然停留在那个位置,因为0没动,所以正确的做法应该是l往前,并且要将窗口中0的数量减少到小于等于k才能正常出窗口,因为此时窗口中0的数量正常了,也就可以更新结果了
class Solution {
public:
    int longestOnes(vector<int>& nums, int k) {
        int n = nums.size();
        int ret = 0;
        for(int left = 0,right = 0,zero = 0;right < n;right++)
        {
            if(nums[right] == 0) zero++;
            while(zero > k)
                if(nums[left++] == 0) zero--;
            ret = max(ret,right - left + 1);
        }
        return ret;
    }
};
4、将x减到0的最小操作数
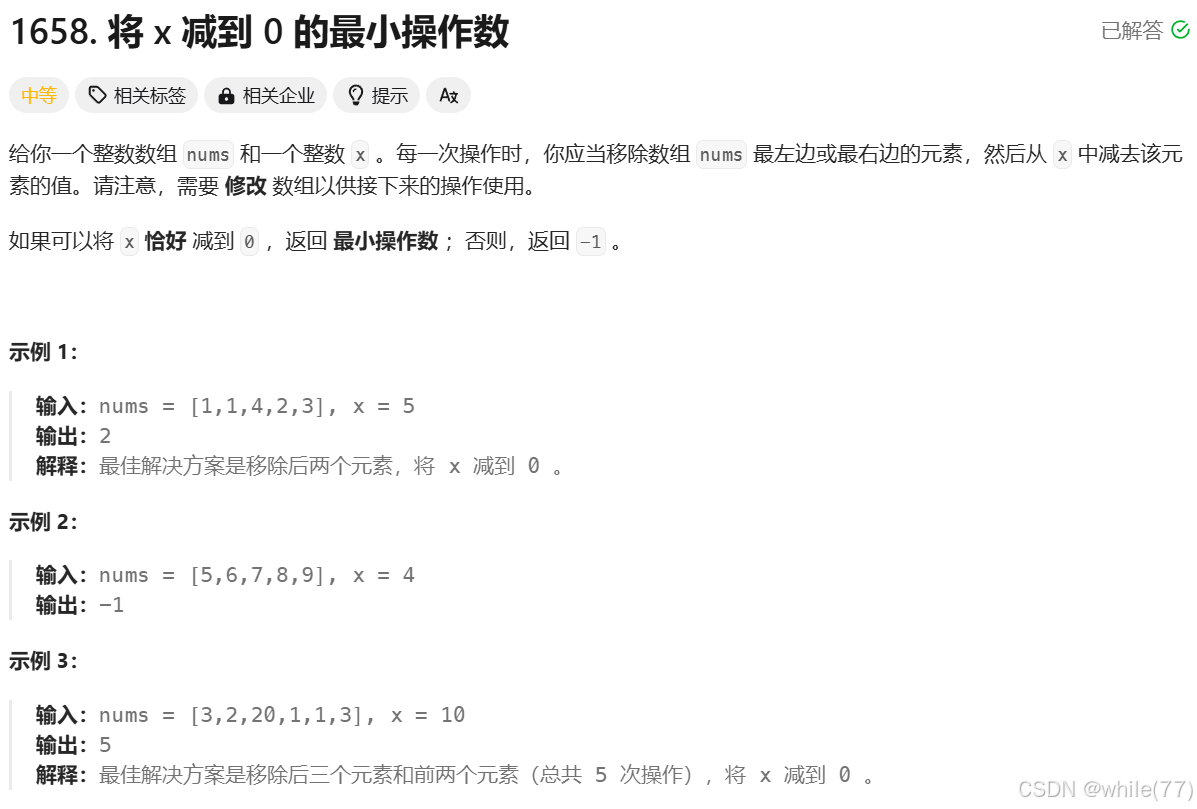
这道题要从前面和后面取值是非常麻烦的,所以这时可以对其进行转化:首先计算出这个数组全部元素的和,然后用和减去x,得到k,也就是需要在数组中找一段连续的子数组,让这段连续子数组的和等于k,这样子就变成了前面的题目。因为这道题的数组中的元素都是大于等于1的,所以可以使用滑动窗口。若数组中的元素有0或者小于0的,这样会失去单调性,就不能使用滑动窗口了
1. left = 0,right = 0
2. 进窗口:gen + nums[right]
3. 判断:当gen > k 时出窗口
出窗口:gen -= nums[left]
更新结果:出完窗口更新结果,即gen == k时
class Solution {
public:
    int minOperations(vector<int>& nums, int x) {
        int n = nums.size(),sum = 0;
        for(int  i = 0;i<n;i++) sum += nums[i];
        int k = sum - x;
        if(k < 0) return -1; // 当k小于0,说明数组中所有的数加起来都小于x
        if(k == 0) return n; // 当k等于0,说明数组中所有的数加起来刚好等于x
        int left = 0,right = 0,gen = 0,ans = 0;
        while(right < n)
        {
            gen += nums[right];
            while(gen > k)
                gen -= nums[left++];
            if(gen == k)
                ans = max(ans,right - left + 1);
            right++;
        }
        return ans == 0 ? -1 : n - ans;
    }
};
5、水果成篮
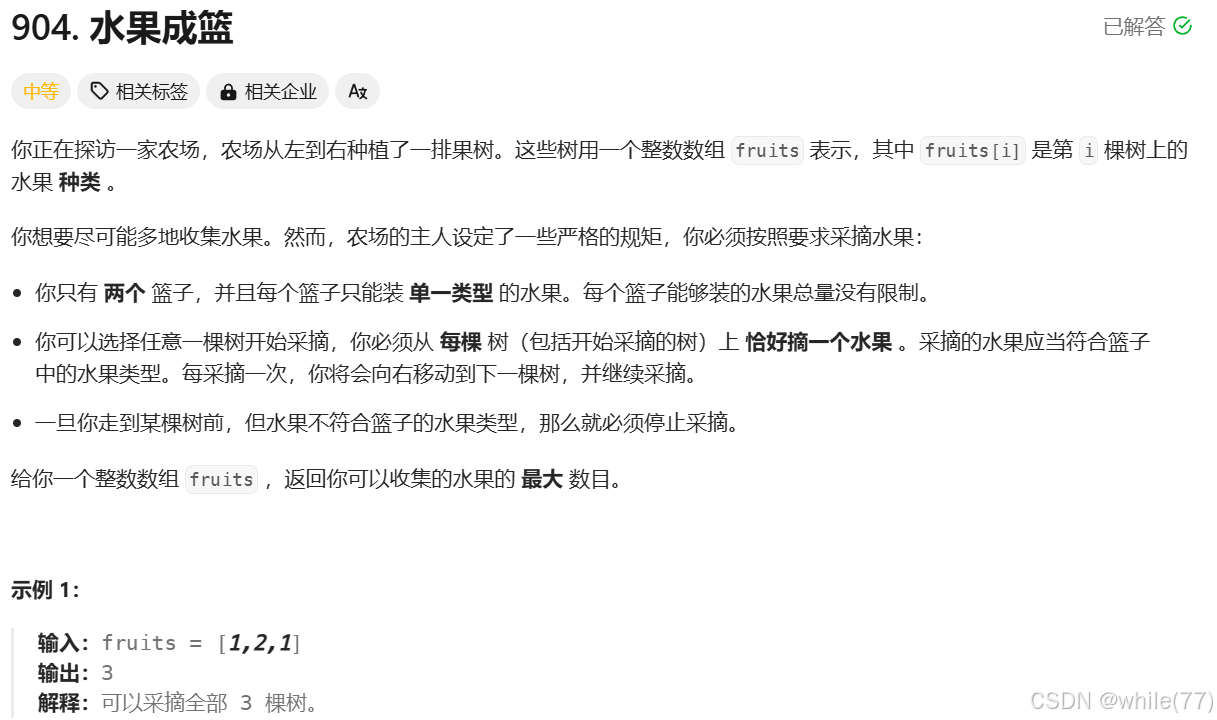
以上这段话,实际上的意思就是:找出一个最长的子数组的长度,子数组中不超过两种类型的水果
很明显,right没必要回去,所以是可以使用滑动窗口的
1. left = 0,right = 0
2. 进窗口:当前窗口的水果种类小于等于2时
3. 判断:若当前窗口中的水果种类大于2则出窗口
出窗口:注意此时出窗口不是出一个left就能让sum--,只有当hash[nums[left]] == 0时,才能让sum--
更新结果:在出窗口之前更新结果
class Solution {
public:
    int totalFruit(vector<int>& fruits) {
        int sum = 0,left = 0,right = 0,ans = 0,n = fruits.size(); // sum来记录当前窗口中有几种水果
        int hash[n]; // 哈希表来记录当前窗口中每一种类型的果树踩采摘了几颗
        for(int i = 0;i<n;i++) hash[i] = 0;
        while(right < n)
        {
            if(hash[fruits[right]] == 0) // 当前窗口第一次出现这种果树,则哈希表和sum都要++
            {
                hash[fruits[right]]++;
                sum++;
            }
            else hash[fruits[right]]++; // 当前窗口已经有了这种果树,则只让哈希表++
            if(sum > 2) // 当前窗口果树种类超过2种,则需要先更新结果,并出窗口
            {
                ans = max(ans,right - left);
                while(sum > 2)
                {
                    hash[fruits[left]]--;
                    if(hash[fruits[left]] == 0) sum--; // 只有当窗口中彻底没了这种果树才能让sum--
                    left++;
                }
            }
            right++;
        }
        ans = max(ans,right - left); // 最后还要再更新一次结果,因为可能right一直到最后都没有更新结果
        return ans;
    }
};
6、找到字符串中所有字母的异位词
6.1 滑动窗口
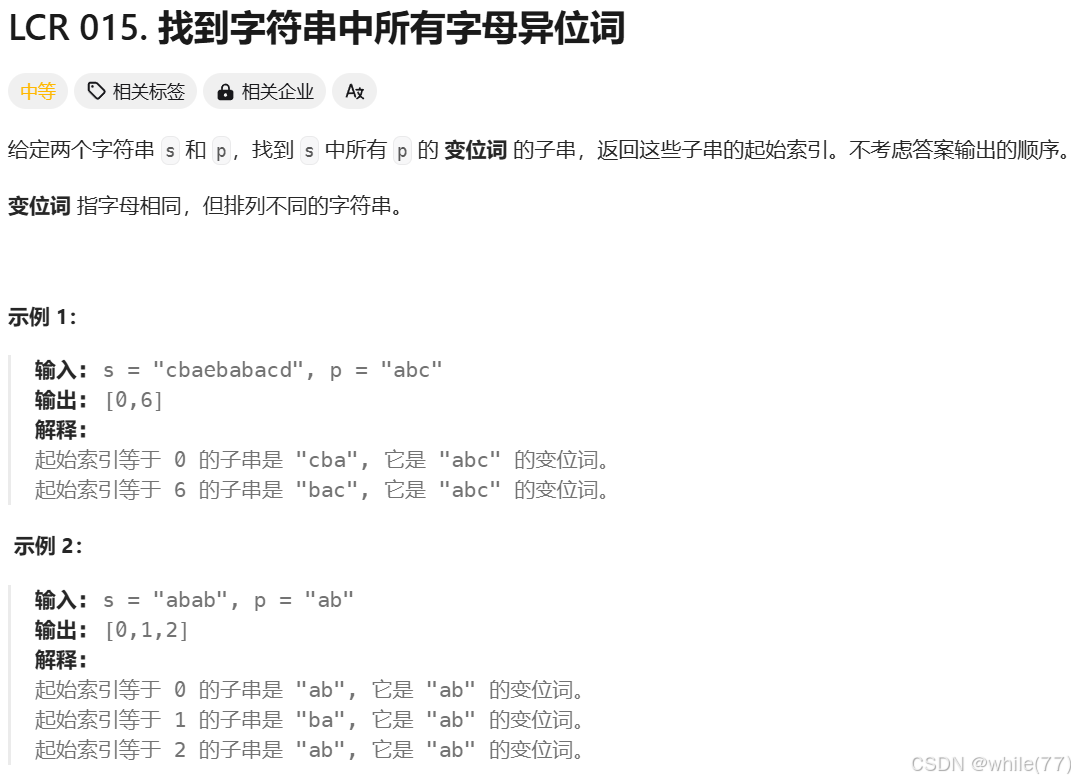
因为字符串 p 的变位词的长度一定与字符串 p 的长度相同,所以我们可以在字符串 s 中构造一个长度为与字符串 p 的长度相同的滑动窗口,并在滑动中维护窗口中每种字母的数量;当窗口长度与p长度相同时,就比较一下窗口中的字符串是否与p相同,若相同则将left的数值存进数组中,若不相同,则left++。注意:当字符串 s 的长度小于字符串 p 的长度时,字符串 s 中一定不存在字符串 p 的变位词。但是因为字符串 s 中无法构造长度与字符串 p 的长度相同的窗口,所以这种情况需要单独处理。
class Solution {
public:
    vector<int> findAnagrams(string s, string p) {
        int n1 =s.size(),n2 = p.size();
        vector<int> v;
        if(n1 < n2) return v;
        vector<int> v_s(26);
        vector<int> v_p(26);
        for(int i = 0;i < 26;i++) v_s[i] = v_p[i] = 0;
        for(int i = 0;i < n2;i++) v_p[p[i] - 'a']++;
        int left = 0,right = 0;
        while(right < n1)
        {
            while(right - left < n2)
            {
                v_s[s[right++] - 'a']++;
            }
            if(v_s == v_p) v.push_back(left);
            v_s[s[left++] - 'a']--;
        }
        return v;
    }
};
6.2 对滑动窗口的优化
在上面的代码中,我们用v_s来表示当前窗口中各个字符的个数,v_p来表示字符串p中各个字符的个数,当当前窗口中元素个数与p的大小相同时,即v_s的长度与v_p的长度相同时,就比较一下v_s与v_p是否相等,若相等,则说明此时窗口中的字符就是p的异位词,但是比较v_s和v_p调用的是vector的operator==,时间复杂度是O(N),此时可以利用一个count来统计窗口中有效字符的个数。同样也是要创建哈希表v_s和v_p,作用与前面相同,并且仍然维护窗口中的字符个数与p中字符个数相同。当往窗口中放入元素时,放入后,若窗口中这个元素的个数小于等于p中这个元素的个数,则count++,若大于则不++。当窗口中元素个数与p中元素个数相同时,比较count是否与p的大小相等,若相等,说明窗口中都是有效元素,则将left放入返回数组中,若不相等,则出窗口。优化后,少了直接比较v_s和v_p的步骤
class Solution {
public:
    vector<int> findAnagrams(string s, string p) {
        int n1 =s.size(),n2 = p.size();
        vector<int> v;
        if(n1 < n2) return v;
        vector<int> v_s(26);
        vector<int> v_p(26);
        for(int i = 0;i < 26;i++) v_s[i] = v_p[i] = 0;
        for(int i = 0;i < n2;i++) v_p[p[i] - 'a']++;
        int left = 0,right = 0,count = 0;
        while(right < n1)
        {
            while(right - left < n2)
            {
                v_s[s[right] - 'a']++;
                if(v_s[s[right] - 'a'] <= v_p[s[right] - 'a']) count++;
                right++;
            }
            if(count == n2) v.push_back(left);
            if(v_s[s[left] - 'a'] <= v_p[s[left] - 'a']) count--;
            v_s[s[left] - 'a']--;
            left++;
        }
        return v;
    }
};
7、串联所有单词的子串
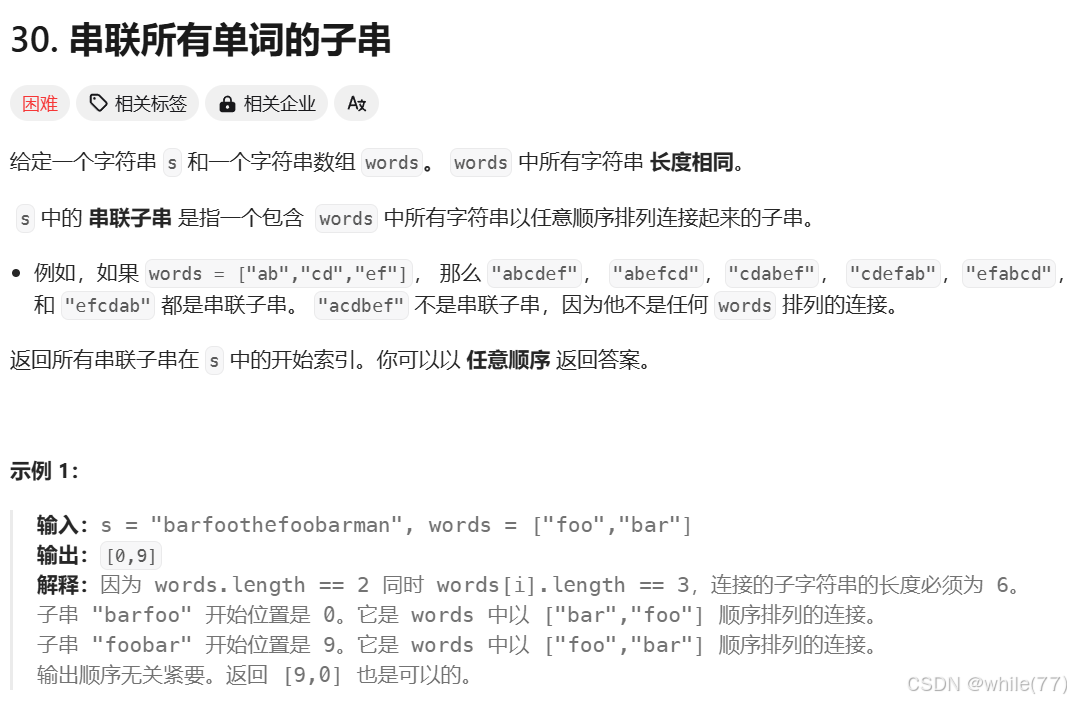
这道题中有一个十分重要的条件,就是words中所有字符串的长度相同
会发现这一道题与上一道题是类似的,可以对其进行转化
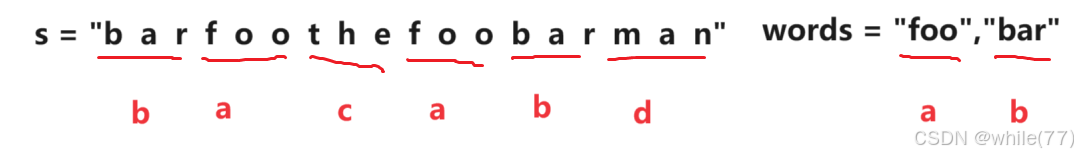
就是对上一道题字符的位置都改成了字符串,所以这一道题的算法原理与上一道题是类似的,这里就不过多赘述了,只介绍一下几个不同的地方
1. 哈希表
上一道题我们是使用数组来充当哈希表的,因为上一道题都是字符,但是这一道题不行,因为都是字符串,所以需要使用unordered_map<string,int>
2. left指针和right指针的移动
因为这道题中一次是需要将一个字符串放进哈希表的,所以left指针和right指针一次是需要移动words[0].size()个字符的。注意:一次是将right和right前words[0].size()个字符放进哈希表
3. 滑动窗口的执行次数
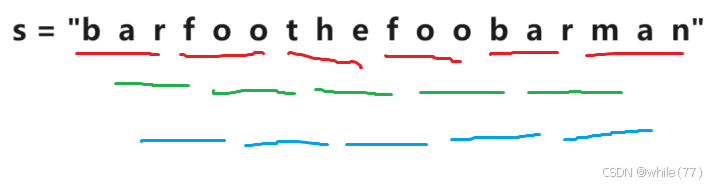
为了遍历道字符串s中所有的单词,必须从不同起点,进行words[0].size()次滑动窗口
class Solution {
public:
    vector<int> findSubstring(string s, vector<string>& words) {
        vector<int> ret;
        unordered_map<string,int> hash1; // 保存words里面所有单词的频次
        for(const auto& e : words) hash1[e]++;
        int len = words[0].size(),m = words.size(),n = s.size();
        for(int i = 0;i < len;i++) // 执行len次
        {
            unordered_map<string,int> hash2; // 维护窗口中单词的频次
            for(int left = i,right = i,count = 0;right + len <= n;right += len)
            {
                // 进窗口 + 维护count
                string in = s.substr(right,len);
                hash2[in]++;
                if(hash1.count(in) && hash2[in] <= hash1[in]) count++;
                // 判断
                if(right - left + 1 > len * m)
                {
                    // 出窗口 + 维护count
                    string out = s.substr(left,len);
                    if(hash1.count(out) && hash2[out] <= hash1[out]) count--;
                    hash2[out]--;
                    left += len;
                }
                // 更新结果
                if(count == m) ret.push_back(left);
            }
        }
        return ret;
    }
};
注意,在这里面有两个步骤,都有调用道unordered_map<string,int>的operator[],因为operator[]当传入的值容器中没有时,会插入,所以一定要先确保容器中有才能比较,所以先调用count
8、最小覆盖子串
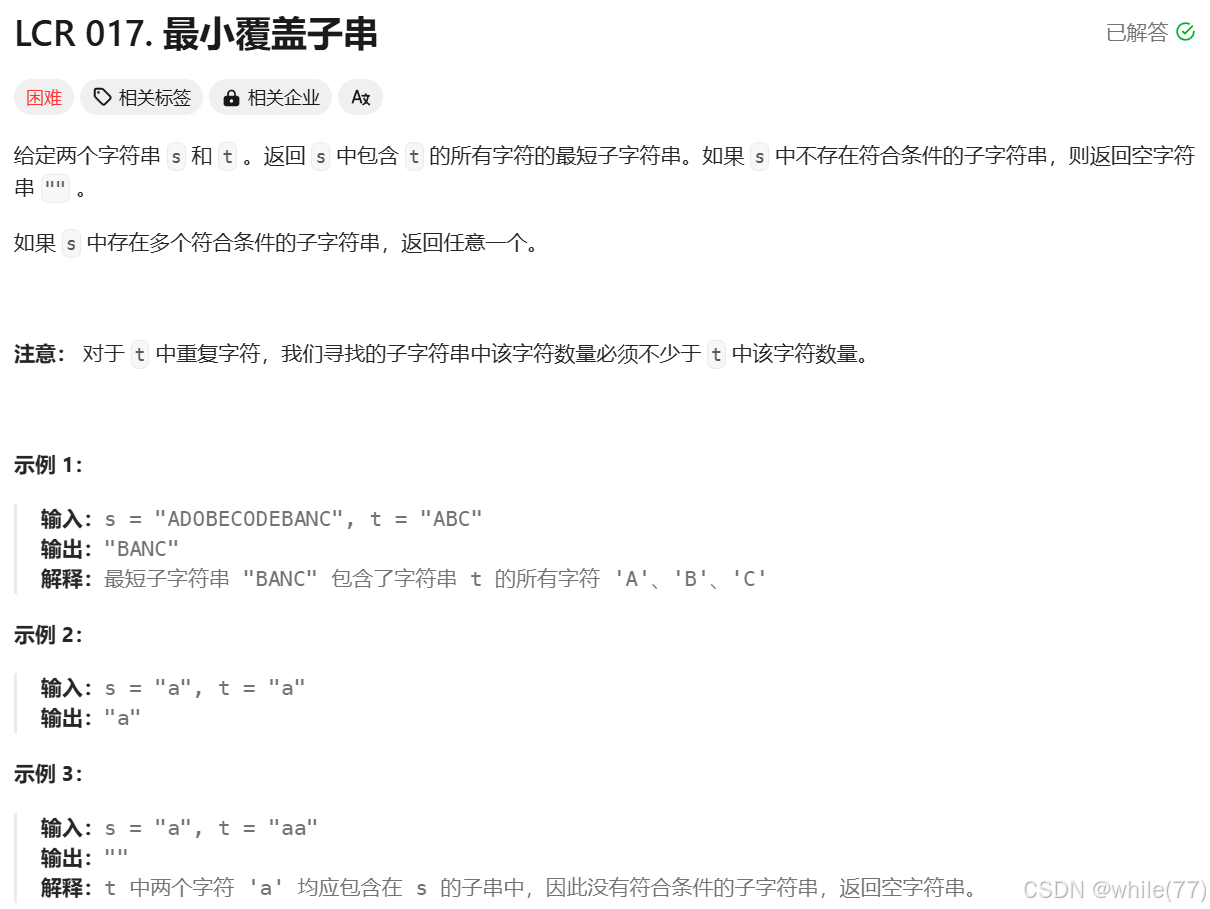
这道题的方法与前两道题是类似的,但是有一个较大的区别是前两道题的窗口大小是固定的,这道题的窗口大小是不固定的
所以当right遍历到最后的时候,不一定就遍历到了所有的情况,除非此时left和right的距离刚刚好等于t的长度,否则是没有遍历到全部情况的,所以当right遍历到s末尾时,还需要让left继续向前走,直到left和right的距离等于t的长度
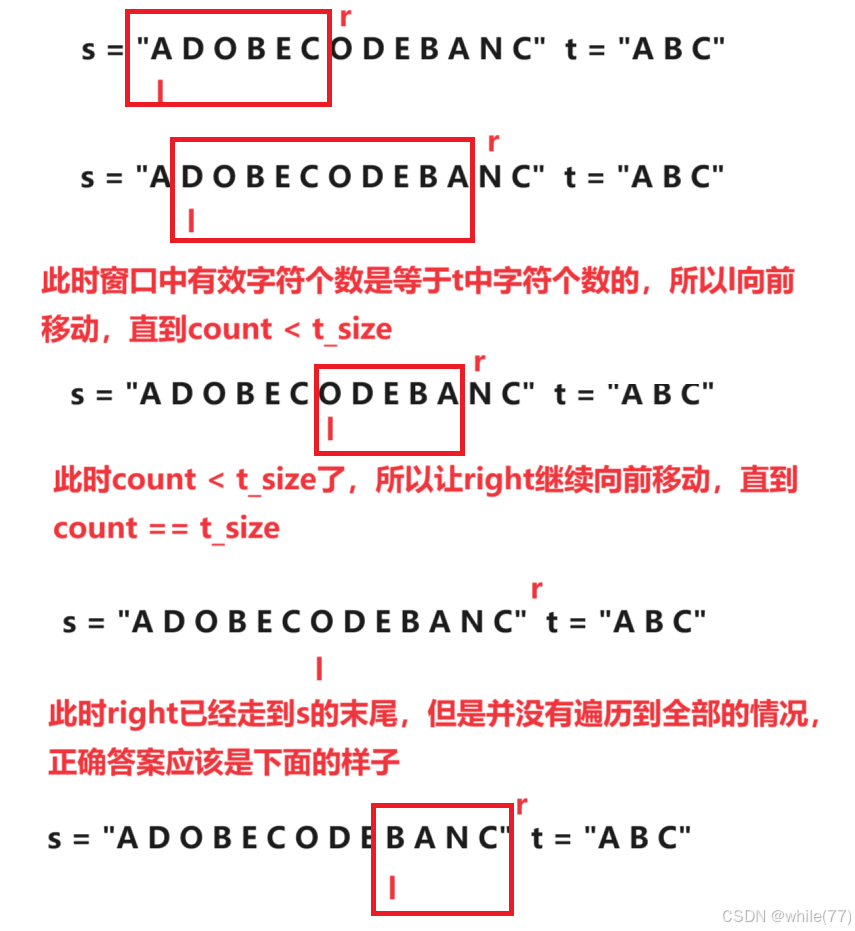
s的子串中某个字符出现个数比t中这个字符出现次数大是没关系的,只要不小于就好
class Solution {
public:
    string minWindow(string s, string t) {
	    int s_size = s.size(), t_size = t.size();
	    if (s_size < t_size) return "";
	    int left = 0, right = 0, min_left = -1, min_right = s_size, count = 0;
	    unordered_map<char, int> hash1;
	    unordered_map<char, int> hash2; // 记录t中各个字符出现的频次
	    for (int i = 0; i < t_size; i++) hash2[t[i]]++;
	    while (right - left >= t_size || right < s_size) // 当right走到最后,并没有遍历到全部的情况
	    {
		    while (right < s_size && count < t_size)
		    {
                // 进窗口
			    hash1[s[right]]++;
			    if (hash2.count(s[right]) && hash1[s[right]] <= hash2[s[right]]) count++;
			    right++;
		    }
		    if (count == t_size)
		    {
                // 更新结果
			    if (right - left < min_right - min_left)
			    {
				    min_left = left;
				    min_right = right;
			    }
		    }
            // 出窗口
		    if (hash2.count(s[left]) && hash1[s[left]] <= hash2[s[left]]) count--;
		    hash1[s[left]]--;
		    left++;
	    }
        if(min_left == -1) return "";
	    return s.substr(min_left, min_right - min_left);
    }
};
北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 26
 0
- 0


 已为社区贡献1条内容

所有评论(0)