scrapy+selenium
·
回顾scrapy的常用命令
一,创建scrapy的项目:
scrapy startproject 取的项目名
二,创建scrapy爬虫:
在项目目录下执行 scrapy genspider 爬虫名 域名范围 (例:scrapy genspider lianjia lianjia.com)
三,运行scrapy爬虫:
方法1:进入终端,在项目目录下执行scrapy crawl 爬虫名字 【scrapy crawl 爬虫名字】
方法2:
    from scrapy import cmdline
    cmdline.execute(['scrapy','crawl','爬虫文件名'])
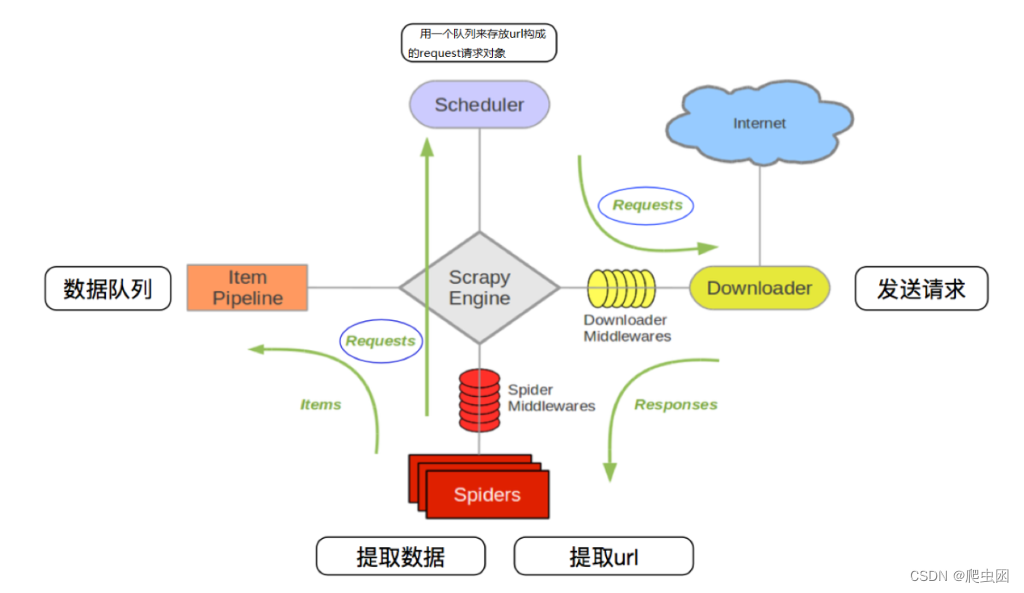
其流程可以描述如下:
- 爬虫中起始的url构造成request对象–>爬虫中间件–>引擎–>调度器
- 调度器把request–>引擎–>下载中间件—>下载器
- 下载器发送请求,获取response响应---->下载中间件---->引擎—>爬虫中间件—>爬虫
- 爬虫提取url地址,组装成request对象---->爬虫中间件—>引擎—>调度器,重复步骤2
- 爬虫提取数据—>引擎—>管道处理和保存数据
注意:
- 图中中文是为了方便理解后加上去的
- 图中绿色线条的表示数据的传递
- 注意图中中间件的位置,决定了其作用
- 注意其中引擎的位置,所有的模块之前相互独立,只和引擎进行交互
3.4 scrapy的三个内置对象
- request请求对象:由url method post_data headers等构成
- response响应对象:由url body status headers等构成
- item数据对象:本质是个字典
scrapy结合selenium案例:网易新闻
需求:爬取国内,国际, 军事,航空四大板块新闻
由于新闻数据是动态加载的,scrapy可以结合selenuim抓取新闻数据,那么selenium如何结合scrapy去使用?
跟之前传统的scrapy抓取,唯一不同且关键的地方在于需要去修改两个文件,一个是爬虫文件,一个middlewares.py文件
1.在爬虫文件中配置好浏览器信息
#设置一个无头无可视化界面的浏览器
chrome_options = Options()
# 无可视化界面
chrome_options.add_argument("--headless")
chrome_options.add_argument("--di sable-gpu")
# 规避监测
chrome_options.add_experimental_option('excludeSwitches', ['enable-automation'])
self.browse = webdriver.Chrome(options=chrome_options)
2.在middlewares.py中去拦截且篡改下载中间件
# 开始拦截篡改下载中间件
class NewsSpiderDownloaderMiddleware:
    # Not all methods need to be defined. If a method is not defined,
    # scrapy acts as if the downloader middleware does not modify the
    # passed objects.

    @classmethod
    def from_crawler(cls, crawler):
        # This method is used by Scrapy to create your spiders.
        s = cls()
        crawler.signals.connect(s.spider_opened, signal=signals.spider_opened)
        return s

    def process_request(self, request, spider):
        # Called for each request that goes through the downloader
        # middleware.

        # Must either:
        # - return None: continue processing this request
        # - or return a Response object
        # - or return a Request object
        # - or raise IgnoreRequest: process_exception() methods of
        #   installed downloader middleware will be called

        return None

    # 该方法拦截四大板块对应的响应对象 且篡改
    # 注意settings文件中一定要启动对应权限
    def process_response(self, request, response, spider):
       # 对需要篡改部分做判断 否则会影响其他请求对应的repsonse
        if request.url in spider.module_urls:
            # 获取从爬虫程序中创建出的浏览器对象
            browse = spider.browse
            # 通过selenium向四大板块的url发起请求,获取到动态加载的数据
            browse.get(request.url)
            # 下拉翻页
            browse.execute_script('window.scrollTo(0,document.body.scrollHeight)')
            time.sleep(1.5)
            # 获取源码
            page_text = browse.page_source
            #针对定位到的response进行篡改
            # 这里的篡改指实例化一个新的响应对象(符合需求:包含动态加载的数据),替换(HtmlResponse)原来的响应对象
            # 参数解释:url:响应对应的url body:响应体  requests:scrapy中的请求对象,数据都是跟着请求对象走的
            new_response = HtmlResponse(url=request.url, body=page_text, encoding='utf-8', request=request)
            return new_response  # 篡改响应对象 不再经过download,直接将新的响应体返回给引擎
        # 此时就可以回到爬虫文件继续往下写  判断如果是selenium请求过来的我们才返回处理后的new_response
        else:
            # 其他请求对应的响应对象
            return response
        # return response

    def process_exception(self, request, exception, spider):
        # Called when a download handler or a process_request()
        # (from other downloader middleware) raises an exception.

        # Must either:
        # - return None: continue processing this exception
        # - return a Response object: stops process_exception() chain
        # - return a Request object: stops process_exception() chain
        pass

    def spider_opened(self, spider):
        spider.logger.info('Spider opened: %s' % spider.name)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 9
 0
- 0


 已为社区贡献2条内容

所有评论(0)