使用Scrapy选择器提取豆瓣电影信息,并用正则表达式从介绍详情中获取指定信息
一、Scrapy框架
1组件介绍
Scrapy 主要由以下组件组成:
- 引擎(Engine): 负责控制整个爬虫系统的流程,包括调度器、下载器和爬虫之间的通信。它负责调度并协调各个组件的工作。
- 调度器(Scheduler): 负责接收引擎发送过来的请求,并按照一定的策略将这些请求排队,然后发送给下载器。
- 下载器(Downloader): 负责下载引擎发送过来的请求对应的页面,并将下载到的页面内容返回给引擎。
- 爬虫(Spiders): 爬虫是用户编写的一组类,用于定义如何爬取特定网站(或者一组网站)的数据。每个爬虫都包含了一些用于从网页中提取数据的解析规则。
- 管道(Pipeline): 管道负责处理爬虫从网页中抽取出来的数据,并进行后续的处理,比如数据清洗、存储等操作。
- 下载中间件(Downloader Middleware): 下载中间件是介于引擎和下载器之间的组件,它可以对请求和响应进行预处理或后处理。
- 爬虫中间件(Spider Middleware): 爬虫中间件是介于引擎和爬虫之间的组件,它可以对请求和数据进行预处理或后处理。
2工作原理
Scrapy 的工作流程如下:
- 引擎接收到用户定义的初始请求,并将其传递给调度器。
- 调度器将请求排队,并按照一定的策略选择下一个要处理的请求,然后将其发送给下载器。
- 下载器下载网页内容,并将下载到的页面内容返回给引擎。
- 引擎将下载到的页面内容发送给相应的爬虫进行解析,提取出目标数据。
- 爬虫将提取到的数据提交给管道进行后续处理,比如数据清洗、存储等操作。
- 如果有新的请求需要处理,引擎将它们发送给调度器,重复上述过程,直到没有新的请求需要处理为止。
通过以上步骤,Scrapy 能够高效地从网站中爬取数据,并对其进行处理和存储,为用户提供了强大的数据获取和处理能力。
3 创建新的 Scrapy 项目
要创建一个新的 Scrapy 项目,首先确保你已经安装了 Scrapy。然后在命令行中执行以下命令:、
scrapy startproject myproject
这会在当前目录下创建一个名为 myproject 的新项目。在这个项目中,你会看到如下结构:
myproject/
myproject/
__init__.py
items.py: 定义爬取的数据结构(可选)。
middlewares.py: 可以在请求和响应之间进行操作的中间件(可选)。
pipelines.py: 对爬取到的数据进行处理的管道(可选)。
settings.py: 项目的设置文件,包含了各种配置选项。
spiders/: 存放爬虫代码的目录。
__init__.py
__init__.py
scrapy.cfg: Scrapy 部署配置文件。
执行这些步骤后,你将拥有一个全新的Scrapy项目,可以在其中编写和运行你的爬虫代码。如果你想要创建新的爬虫,可以使用 genspider 命令来生成。例如:
cd myproject
scrapy genspider example example.com
这将在 spiders 目录中创建一个名为 example 的新爬虫,用于爬取 example.com 网站的数据。
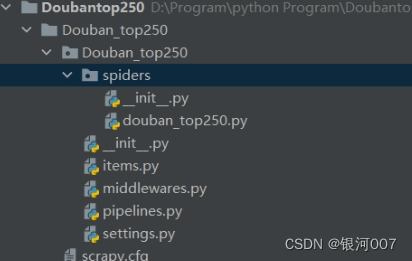
1.4项目文件结构及作用
- scrapy.cfg: 项目的配置文件,包含了 Scrapy 项目的配置信息,比如项目的名称以及项目中使用的设置文件位置等。
- myproject/: 项目的 Python 包,包含了项目的代码和其他资源文件。
- __init__.py: 表明该目录是一个 Python 包。
- items.py: 可选的文件,用于定义爬取的数据结构,通常使用 Scrapy 的 Item 类来定义数据模型。
- middlewares.py: 可选的文件,包含了自定义的中间件,用于在请求和响应之间进行操作,例如添加代理、用户代理等。
- pipelines.py: 可选的文件,包含了自定义的管道,用于对爬取到的数据进行处理,例如数据清洗、存储等操作。
- settings.py: 项目的设置文件,包含了各种配置选项,如爬虫的延迟时间、并发请求数、用户代理等。
- spiders/: 存放爬虫代码的目录,每个爬虫通常都是一个单独的 Python 文件。
- __init__.py: 表明该目录是一个 Python 包。
二、实践:使用 Scrapy 爬取豆瓣电影 Top250
1.定义数据模型
在 Scrapy 中,我们使用 Item 对象来表示爬取到的数据。为了清晰地组织数据,我们需要定义一个数据模型来描述我们感兴趣的信息。在这个项目中,我们主要关注豆瓣电影 Top250 页面中的电影信息,因此我们创建一个名为 MovieItem 的数据模型来存储这些信息。
# File: your_project/items.py

import scrapy
class MovieItem(scrapy.Item):
    # 定义了要爬取的关键信息字段
    ranking = scrapy.Field()    # 排名
    name = scrapy.Field()       # 电影名
    introduce = scrapy.Field()  # 简介
    star = scrapy.Field()       # 星级
    comments = scrapy.Field()   # 评论数
    describe = scrapy.Field()   # 描述
以上代码将这些信息定义为 Scrapy 的 Field 类型,这样可以方便后续爬取和处理。每个字段都对应了我们所感兴趣的电影信息,如排名、电影名、简介、星级、评论数和描述等。
2.编写爬虫
在这一部分,我们将创建一个 Spider 来爬取豆瓣电影 Top250 页面中的信息。我们将使用 Scrapy 提供的功能来轻松地提取页面中的数据,并将其存储到先前定义的数据模型中。
# File: your_project/spiders/douban_top250.py

import scrapy
from ..items import MovieItem

class DoubanTop250Spider(scrapy.Spider):
    """
    该 Spider 用于爬取豆瓣电影 Top250 页面的信息。
    """

    name = 'douban_top250'  # Spider 的名称
    allowed_domains = ['movie.douban.com']  # 允许爬取的域名
    start_urls = ['https://movie.douban.com/top250']  # 起始 URL

    def parse(self, response):
        """
        解析页面响应,提取电影信息并存储到 MovieItem 对象中
        :param response: 爬取到的页面响应
        :return: MovieItem 对象
        """
        # 使用 XPath 选择器提取电影信息
        movies = response.xpath('//div[@class="item"]')
        for movie in movies:
            item = MovieItem()  # 创建 MovieItem 对象来存储电影信息
            # 提取电影排名信息
            item['ranking'] = movie.xpath('div[@class="pic"]/em/text()').get()
            # 提取电影名称
            item['name'] = movie.xpath('div[@class="info"]/div[@class="hd"]/a/span[@class="title"]/text()').get()
            # 提取电影简介
            item['introduce'] = movie.xpath('div[@class="info"]/div[@class="bd"]/p[@class="quote"]/span[@class="inq"]/text()').get()
            # 提取电影星级评分
            item['star'] = movie.xpath('div[@class="info"]/div[@class="bd"]/div[@class="star"]/span[@class="rating_num"]/text()').get()
            # 提取电影评论数
            item['comments'] = movie.xpath('div[@class="info"]/div[@class="bd"]/div[@class="star"]/span[last()]/text()').get()
            # 提取电影描述信息
            item['describe'] = movie.xpath('div[@class="info"]/div[@class="bd"]/p[@class=""]/text()').get()
            yield item  # 将 MovieItem 对象传递给 Scrapy 引擎

        # 继续爬取下一页数据
        next_page = response.xpath('//span[@class="next"]/a/@href').get()
        if next_page:
            yield scrapy.Request(response.urljoin(next_page), callback=self.parse)
在上述代码中,我们使用了 XPath 选择器来定位 HTML 页面中的元素,并提取我们感兴趣的信息。XPath 是一种用于在 XML 文档中导航和选择节点的语言。通过编写 XPath 表达式,我们可以精确定位到页面中的特定元素,从而提取我们需要的数据。
至于 XPath 选择器的代码,是通过观察豆瓣电影 Top250 页面的 HTML 结构而来的,我们根据页面的标签和类名来编写 XPath 表达式,从而定位到我们需要的电影信息。如图所示:
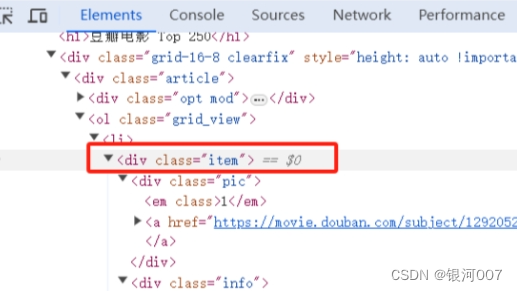
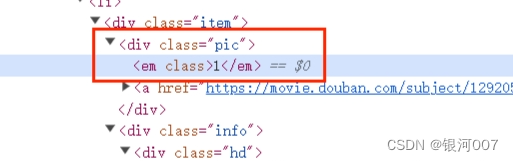
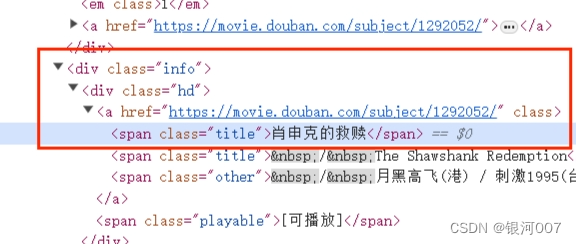
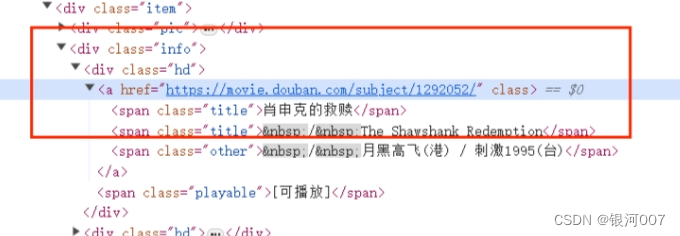
电影的所有信息都存在于<div class="item">中,其中排名(rank)的位置为<div class="pic">下的<em>标签中,电影标题的位置位于<div class="info">下的<div class="hd">下的<span class="title">标签中,以此类推即可写出其余元素的xpath代码
换页的xpath代码如图所示:
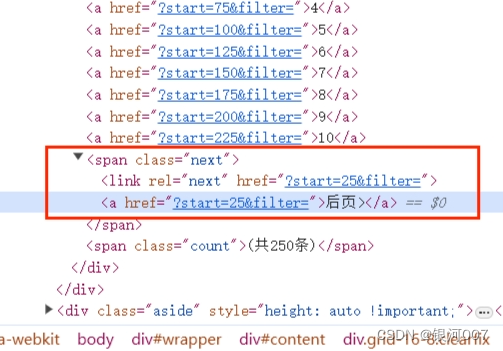
因网站源码可能重构导致xpath代码改变,实际应用时应根据实际情况修改代码
Xpath代码解释如下:
- //div[@class="item"]: 这个 XPath 表达式选取了页面中所有 class 属性为 "item" 的 div 元素,这些元素包含了每部电影的信息。
- div[@class="pic"]/em/text(): 这个 XPath 表达式选取了电影排名信息,其中 div[@class="pic"] 选择了每部电影的海报 div 元素,em 选择了其中的 em 元素,然后使用 text() 方法提取其中的文本内容。
- div[@class="info"]/div[@class="hd"]/a/span[@class="title"]/text(): 这个 XPath 表达式选取了电影名称信息,首先选择了包含电影信息的 div 元素,然后进一步选择了 class 属性为 "hd" 的 div 元素,接着选择了其中的 a 元素,然后选择了 span 元素,最后使用 text() 方法提取了电影名称的文本内容。
- div[@class="info"]/div[@class="bd"]/p[@class="quote"]/span[@class="inq"]/text(): 这个 XPath 表达式选取了电影简介信息,依次选择了包含电影信息的 div 元素、class 属性为 "bd" 的 div 元素、p 元素、class 属性为 "quote" 的 p 元素、span 元素,并提取了其中的文本内容。
- div[@class="info"]/div[@class="bd"]/div[@class="star"]/span[@class="rating_num"]/text(): 这个 XPath 表达式选取了电影星级评分信息,选择了包含电影信息的 div 元素、class 属性为 "bd" 的 div 元素、class 属性为 "star" 的 div 元素、span 元素、class 属性为 "rating_num" 的 span 元素,并提取了其中的文本内容。
- div[@class="info"]/div[@class="bd"]/div[@class="star"]/span[last()]/text(): 这个 XPath 表达式选取了电影评论数信息,选择了包含电影信息的 div 元素、class 属性为 "bd" 的 div 元素、class 属性为 "star" 的 div 元素、最后一个 span 元素,并提取了其中的文本内容。
- div[@class="info"]/div[@class="bd"]/p[@class=""]/text(): 这个 XPath 表达式选取了电影描述信息,选择了包含电影信息的 div 元素、class 属性为 "bd" 的 div 元素、p 元素、其中没有设置 class 属性的 p 元素,并提取了其中的文本内容。
此外,parse 方法是 Scrapy 中用于解析页面响应的方法。当 Scrapy 发起请求并获取到页面响应后,会自动调用 parse 方法来处理响应,并在其中编写代码来提取数据。parse 方法中的 response 参数包含了爬取到的页面响应,我们可以使用它来提取页面中的信息。
3.中间件设置
有时为了应对网站的反爬虫机制,我们需要对 Scrapy 的下载中间件进行一些设置,以伪装请求并防止被识别为爬虫。在这个项目中,我们可以通过设置随机的 User-Agent 和使用 IP 代理来模拟不同的用户和 IP 地址发送请求。
首先,我们需要在中间件中添加随机 User-Agent 的设置。我们可以在 middlewares.py 文件中创建一个类,名为 RandomUserAgentMiddleware,用于为每个请求随机选择一个 User-Agent,并将其添加到请求头中。
# File: your_project/middlewares.py


import random
class user_agent(object):
    def process_request(self, request, spider):
        # user agent 列表
        USER_AGENT_LIST = [
            'MSIE (MSIE 6.0; X11; Linux; i686) Opera 7.23',
            'Opera/9.20 (Macintosh; Intel Mac OS X; U; en)',
            'Opera/9.0 (Macintosh; PPC Mac OS X; U; en)',
            'iTunes/9.0.3 (Macintosh; U; Intel Mac OS X 10_6_2; en-ca)',
            'Mozilla/4.76 [en_jp] (X11; U; SunOS 5.8 sun4u)',
            'iTunes/4.2 (Macintosh; U; PPC Mac OS X 10.2)',
            'Mozilla/5.0 (Macintosh; Intel Mac OS X 10.6; rv:5.0) Gecko/20100101 Firefox/5.0',
            'Mozilla/5.0 (Macintosh; Intel Mac OS X 10.6; rv:9.0) Gecko/20100101 Firefox/9.0',
            'Mozilla/5.0 (Macintosh; Intel Mac OS X 10.8; rv:16.0) Gecko/20120813 Firefox/16.0',
            'Mozilla/4.77 [en] (X11; I; IRIX;64 6.5 IP30)',
            'Mozilla/4.8 [en] (X11; U; SunOS; 5.7 sun4u)'
        ]
        agent = random.choice(USER_AGENT_LIST)  # 从上面列表中随机抽取一个代理
        request.headers['User-Agent'] = agent # 设置请求头的用户代理
在上述代码中,我们创建了一个名为 RandomUserAgentMiddleware 的类,它的 process_request 方法用于处理每个请求,为每个请求随机选择一个 User-Agent,并将其添加到请求头中。其中 USER_AGENT_LIST 是在 settings.py 中定义的用户代理列表。
我们还可以添加一个 IP 代理的设置,以应对可能的 IP 封锁或限制。这里不再详细列举代码,你可以在 middlewares.py 中创建一个类来实现该功能,并在 settings.py 中设置相应的 IP 代理列表。
最后,我们需要在 settings.py 文件中启用这些中间件,并设置它们的优先级:
# File: your_project/settings.py

DOWNLOADER_MIDDLEWARES = {
    'myproject.middlewares.user_agent': 543,
}
在上述代码中,我们将 RandomUserAgentMiddleware 设置为 DOWNLOADER_MIDDLEWARES 字典的值,并指定了优先级为 543。你也可以根据实际情况添加 IP 代理中间件,并设置相应的优先级。
这样,当我们运行 Scrapy 项目时,每个请求就会随机选择一个 User-Agent,并根据需要使用 IP 代理发送请求,以应对网站的反爬虫机制。
4.数据存储
当我们选择将数据存储到 CSV 文件中时,我们需要在 Scrapy 项目中编写一个专门的 Pipeline,负责将爬取到的数据写入 CSV 文件中。下面是一个示例:
# File: your_project/pipelines.py

import csv

class CSVPipeline:
    """
    Pipeline 类,用于将爬取到的数据存储到 CSV 文件中
    """

    def __init__(self, csv_file_path):
        """
        初始化方法,设置 CSV 文件路径
        """
        self.csv_file_path = csv_file_path

    @classmethod
    def from_crawler(cls, crawler):
        """
        类方法,从 Scrapy 配置中获取 CSV 文件路径
        """
        return cls(
            csv_file_path=crawler.settings.get('CSV_FILE_PATH')
        )

    def open_spider(self, spider):
        """
        在 Spider 开始爬取时调用,打开 CSV 文件并写入表头
        """
        self.csv_file = open(self.csv_file_path, 'w', newline='', encoding='utf-8')
        # 创建 CSV 写入器,并写入表头,这里的表头根据 MovieItem 的字段来确定
        self.csv_writer = csv.DictWriter(self.csv_file, fieldnames=['ranking', 'name', 'introduce', 'star', 'comments', 'describe'])
        self.csv_writer.writeheader()

    def close_spider(self, spider):
        """
        在 Spider 结束爬取时调用,关闭 CSV 文件
        """
        self.csv_file.close()

    def process_item(self, item, spider):
        """
        处理每个 Item 对象,将其写入 CSV 文件中
        """
        # 使用 CSV 写入器将 Item 写入 CSV 文件
        self.csv_writer.writerow(item)
        return item
在上述代码中,我们定义了一个名为 CSVPipeline 的 Pipeline 类,它负责将爬取到的数据存储到 CSV 文件中。在该 Pipeline 中,我们实现了四个方法:
__init__ 方法:用于初始化 CSV 文件路径。
from_crawler 类方法:用于从 Scrapy 的配置中获取 CSV 文件路径。
open_spider 方法:在 Spider 开始爬取时调用,用于打开 CSV 文件并写入表头。
close_spider 方法:在 Spider 结束爬取时调用,用于关闭 CSV 文件。
process_item 方法:处理每个 Item 对象,将其写入 CSV 文件中。
接下来,我们需要在 Scrapy 项目的 settings.py 文件中设置 CSV 文件的路径:
# File: your_project/settings.py

CSV_FILE_PATH = 'douban_movies.csv'
最后,我们需要在 settings.py 中启用该 Pipeline:
# File: your_project/settings.py

ITEM_PIPELINES = {
    'your_project.pipelines.CSVPipeline': 300,
}
这样,当我们运行 Scrapy 项目时,爬取到的电影信息就会被存储到名为 douban_movies.csv 的 CSV 文件中了。
5.启动Scrapy项目
编写Python脚本
from scrapy import cmdline

cmdline.execute("scrapy crawl douban_top250".split())
三、使用正则表达式从电影介绍详情中提取指定信息
目标:爬取电影详情页面中介绍详情内容中括号包裹的内容
在这个项目中,我们仍然可以套用第二部分的大致代码结构,但需要针对新的需求进行一些调整。主要区分点包括:
爬取的内容不同,需要重写 items 类:
由于我们要从电影详情页面提取的信息不同于之前的需求,我们需要重新定义 items.py 文件中的数据模型。这意味着我们需要修改数据模型中的字段,以便适应新的数据结构。例如,我们可能需要添加一个字段来存储电影简介中的括号内容。
根据网页具体情况重写 spider 文件:
鉴于我们现在要爬取的是豆瓣电影详情页面,而不是之前的 Top250 页面,我们需要对 spider.py 文件进行重写。这意味着我们需要更新爬取页面的 URL,修改解析函数以匹配电影详情页面的 HTML 结构,并调整数据提取逻辑以确保我们可以准确地提取电影简介中的括号内容。
除了这些主要区分点之外,我们的项目结构和工作流程将保持大致相同。我们仍然会使用 Scrapy 框架来构建我们的爬虫,利用其强大的功能来快速而高效地提取所需信息。
在下一步中,我们将详细讨论如何重写 items.py 和 spider.py 文件,以满足新的需求。
1.定义数据模型
对于本项目,我们打算爬取豆瓣电影页面,因此需要定义一个数据模型来存储电影信息。
首先,我们将创建一个名为 ZhengzeItem 的类,该类继承自 Scrapy 的 Item 类。这个类将包含两个字段:
title:用于存储电影的标题。parenthesis_content:用于存储电影剧情简介中带括号的内容。
在添加完数据模型后,我们需要修改数据管道以适应新的数据模型并存储到 CSV 文件中。以下是对 items.py 和 pipelines.py 文件的修改说明:
在 items.py 文件中:
import scrapy

class ZhengzeItem(scrapy.Item):
    """
    数据模型:定义了爬取电影详情页面所需的字段
    Fields:
        title (str): 电影标题
        parenthesis_content (str): 电影剧情简介中带括号的内容
    """
    # 电影标题
    title = scrapy.Field()

    # 电影剧情简介中带括号的内容
    parenthesis_content = scrapy.Field()
这里我们定义了一个名为 ZhengzeItem 的数据模型,包含了电影标题和剧情简介中带括号的内容两个字段,以适应我们从豆瓣电影页面爬取的数据。
在 pipelines.py 文件中:
import csv

class CSVPipeline:
    """
    数据管道:将爬取的电影信息存储为 CSV 文件
    """
    def __init__(self, settings):
        self.settings = settings
        self.file = None

    @classmethod
    def from_crawler(cls, crawler):
        settings = crawler.settings
        return cls(settings)

    def open_spider(self, spider):
        self.file = open(self.settings.get('CSV_FILE_PATH'), 'w', newline='', encoding='utf-8')
        self.writer = csv.writer(self.file)
        self.writer.writerow(['Title', 'Parenthesis Content'])

    def close_spider(self, spider):
        if self.file:
            self.file.close()

    def process_item(self, item, spider):
        title = str(item.get('title', ''))
        parenthesis_content = str(item.get('parenthesis_content', ''))

        self.writer.writerow([title, parenthesis_content])

        return item
在这里,我们修改了数据管道 CSVPipeline 的代码,使用了 csv 模块来将爬取的电影信息存储到 CSV 文件中。通过这样的修改,我们可以确保爬取的数据能够被正确地存储和处理。
2.编写爬虫
当编写爬虫时,首先要考虑的是如何访问每个电影的详情页面。在这个项目中,我们需要访问豆瓣电影网站上排名前250的电影的详情页面。为了实现这一目标,我们需要先找到每个电影的链接。
步骤:
1. 通过XPath找到每个电影的详情页链接:
我们首先分析豆瓣电影Top250页面的HTML结构,确定每个电影链接所在的位置,并编写XPath表达式来定位这些链接。
2. 使用Scrapy发送HTTP请求访问每个电影的详情页:通过Scrapy的scrapy.Request()方法,我们可以根据之前获取到的链接,发送HTTP请求访问每个电影的详情页面。
3. 提取详情页面中的内容:一旦我们成功访问了每个电影的详情页,我们需要从页面中提取出电影标题和电影简介中用括号括起来的内容。为了实现这一步,我们可以使用XPath或其他解析方法来定位这些信息。
4. 使用正则表达式提取所需内容:在获取到详情页的HTML源码后,我们可以使用正则表达式来进一步提取所需内容。针对电影简介中用括号括起来的内容,我们可以编写正则表达式来匹配并提取出来。
5. 保存提取到的数据到CSV文件:最后一步是将提取到的数据保存到CSV文件中。我们可以使用Python的CSV模块来创建CSV文件,并将数据写入其中。确保数据格式的正确性和完整性,以便后续的分析和使用。
xpath寻找过程:
2.1 寻找每个电影的详情页链接(如图所示)
2.2 寻找详情页面中的内容
在这里,我们遇到了两个BUG:
BUG1:
在后续爬取过程中发现,爬取内容缺失,如下图所示,仅爬取到了第1段内容,第二段之后未爬取到,查看源码发现<br>之后的内容未爬取到,因此修改代码中的xpath,在前面加上normalize-space()即可解决
BUG2:
解决BUG1之后发现,仍有部分文章爬取到的内容为空,查看网站源码即可发现,存在不同的xpath解析路径,如下图所示,图1电影详情全部展示并存在于<span property="v:summary" class="">之下,图2的电影详情存在(展开全部)按钮,并且文章内容存储在<span class="all hidden">之下,而之前的代码仅包含第一种情况,因此将修改xpath代码为:
normalize-space(//div[@id="link-report-intra"]/span[@class="all hidden" or @property="v:summary
2.3 正则表达式
当提取电影简介中的括号内内容时,我们需要使用正则表达式来匹配括号中的文本。但是,并非所有电影简介都包含括号,因此我们需要处理这种情况,以避免出现错误。
import re

if synopsis:
    # 定义正则表达式来匹配带括号的内容,使用多行模式(re.DOTALL)
    parenthesis_pattern = r'(([^)]*))'  # 匹配括号内的内容
    parenthesis_matches = re.findall(parenthesis_pattern, synopsis, re.DOTALL)

    # 对每个匹配到的括号内容字符串调用 strip() 方法去除空格,并生成新的列表
    parenthesis_matches_stripped = [match.strip() for match in parenthesis_matches]
else:
    parenthesis_matches_stripped = []
- if synopsis::此条件语句检查电影简介是否存在内容。如果简介非空,则执行下一步操作。
- parenthesis_pattern = r'(([^)]*))':这里定义了一个正则表达式模式,用于匹配括号中的内容。r 前缀表示原始字符串,以避免反斜杠转义问题。模式 (([^)]*)) 匹配括号内的任何字符,直到遇到右括号为止。
- re.findall(parenthesis_pattern, synopsis, re.DOTALL):使用 re.findall 函数在 synopsis 中查找所有匹配 parenthesis_pattern 的内容,并使用 re.DOTALL 标志以匹配换行符。
- [match.strip() for match in parenthesis_matches]:对于每个匹配到的括号内容字符串,使用 strip() 方法去除首尾的空格,并将结果存储在 parenthesis_matches_stripped 列表中。
- 如果电影简介为空,则将 parenthesis_matches_stripped 设置为空列表,以避免出现错误。
爬虫文件如下:
import scrapy
import re
from ..items import ZhengzeItem
from bs4 import BeautifulSoup

class DoubanTop250Spider(scrapy.Spider):
    name = "Zhengze"
    allowed_domains = ["movie.douban.com"]
    start_urls = ["https://movie.douban.com/top250"]

    # 设置你的 cookie
    custom_cookies = {
        'cookie1_name': 'bid=_qJ5CNM-f7c; _pk_id.100001.4cf6=caa05f47c90379e0.1711352781.; __utmz=30149280.1711352781.1.1.utmcsr=(direct)|utmccn=(direct)|utmcmd=(none); __utmz=223695111.1711352781.1.1.utmcsr=(direct)|utmccn=(direct)|utmcmd=(none); __yadk_uid=IQXFNT2vnxeGjwf9deJz78a9ve5HsqW4; ll="118237"; _vwo_uuid_v2=DE4B5B1FD6BE6E2F26C4053D0E1C20C4F|317f8a090233bf021d2e70cae61a1186; dbcl2="279763592:IvXurz8qqIA"; push_noty_num=0; push_doumail_num=0; ck=RQhm; ap_v=0,6.0; _pk_ses.100001.4cf6=1; __utma=30149280.702551814.1711352781.1713138121.1713168043.7; __utmb=30149280.0.10.1713168043; __utmc=30149280; __utma=223695111.807567155.1711352781.1713138121.1713168043.7; __utmb=223695111.0.10.1713168043; __utmc=223695111; __gads=ID=1dbab480dc4dd324:T=1713083660:RT=1713168046:S=ALNI_MZx40l60gyeAJfeyr7ZTtIkDtbj3A; __gpi=UID=00000debc09129bc:T=1713083660:RT=1713168046:S=ALNI_MbBQgg5LtDLxueprj31quRIChjIug; __eoi=ID=e28a5d511c0bcc8a:T=1713083660:RT=1713168046:S=AA-AfjZDyydCQqURUR0ZSKESl3mU'

    }

    def start_requests(self):
        for url in self.start_urls:
            # 发送请求时,添加 cookie
            yield scrapy.Request(url=url, cookies=self.custom_cookies, callback=self.parse,dont_filter=True)

    def parse(self, response):
        # 获取当前页面的电影信息
        for item in self.parse_page(response):
            yield item

        # 检查是否有下一页,并发送请求
        next_page = response.xpath('//span[@class="next"]/a/@href').get()
        if next_page:
            yield response.follow(next_page, callback=self.parse)

    def parse_page(self, response):
        # 获取每部电影的链接
        movie_links = response.xpath('//div[@class="hd"]/a/@href').extract()
        for movie_link in movie_links:
            yield scrapy.Request(movie_link, callback=self.parse_movie)

    import re

    def parse_movie(self, response):
        # 获取电影标题
        title = response.xpath('//h1/span/text()').get()

        synopsis = response.xpath('normalize-space(//div[@id="link-report-intra"]/span[@class="all hidden" or @property="v:summary"])').get()
        # 如果简介不为空,则进行括号内容的正则匹配
        if synopsis:
            # 定义正则表达式来匹配带括号的内容,使用多行模式(re.DOTALL)
            parenthesis_pattern = '(([^)]*))'  # 匹配括号内的内容
            parenthesis_matches = re.findall(parenthesis_pattern, synopsis, re.DOTALL)

            # 对每个匹配到的括号内容字符串调用 strip() 方法去除空格,并生成新的列表
            parenthesis_matches_stripped = [match.strip() for match in parenthesis_matches]
        else:
            parenthesis_matches_stripped = []

        # 创建 Item 对象并存储提取的内容
        item = {
            'title': title,
            'parenthesis_content': parenthesis_matches_stripped
        }

        yield item

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)