Flinkcdc监测mysql数据库,自定义反序列化,利用flinkApi和flinkSql两种方式(1)
如果你报这种错,就要看一下你自己的pom文件

这两个依赖冲突了

这样就可以解决报错了

对刚才数据进行修改名字


如果修改数据库,但是idea更新不出来值,这可能是好多人电脑的问题

这时候将并行度添加为1就可以了
第五步:将以上数据以json格式传送到kafka中
Debezium-json:是Debezium为变更日志提供的统一格式结构。它是一种特定格式的JSON,用于描述数据库中的变更事件,如插入、更新或删除操作。这些事件可以由Debezium从源数据库捕获,并转换为JSON格式的消息,然后发布到消息队列(如Kafka)或对象存储(如OSS)中

tEnv.executeSql("CREATE TABLE kfk_cdc (\n" +
                "  id INT,\n" +
                "  name STRING,\n" +
                "  age BIGINT,\n" +
                "  sex String,\n" +
                "  PRIMARY KEY (id) NOT ENFORCED\n"+
                ")  WITH (\n" +
                "  'connector' = 'kafka',\n" +
                "  'topic' = 'mysql_cdc',\n" +  --写到kafka的主题,必填
                "  'properties.bootstrap.servers' = 'hadoop102:9092',\n" + --kafka服务器名
                "  'properties.group.id' = 'testGroup',\n" +
                "  'scan.startup.mode' = 'earliest-offset',\n" +
                "  'format' = 'debezium-json'\n" +  --日志json格式,必填
                ")");
tEnv.executeSql("insert into kfk_cdc select * from Person");
最后将目标表中的数据写到kafka的表中,因为flinksql连接kafka底层会将kafka表中数据自动写到kafka中

可能这样你们看不清,我把json数据美化一下

第二种用FlinkApi实现
第二步,第三步和FlinkSql一样
第四步从官网上复制: Overview | Apache Flink CDC

//免密配置
Properties properties = new Properties();
        properties.put("useSSL","false");
        MySqlSource<String> mySqlSource = MySqlSource.<String>builder()
                .hostname("hadoop102")  --必填 主机名
                .port(3306)  --必填  端口号
                .databaseList("zg3") // set captured database  --必填  数据库
                .tableList("zg3.Person")// set captured table  --必填  数据表
                .username("root")  --必填  用户名
                .password("123456") --必填  密码
                .deserializer(new JsonDebeziumDeserializationSchema()) --反序列化器
                .jdbcProperties(properties)  --jdbc配置,用来写免密配置
                .build();
第五步:获取上一步源数据
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

        // enable checkpoint
        env.enableCheckpointing(3000);

        env
                .fromSource(mySqlSource, WatermarkStrategy.noWatermarks(), "MySQL Source")
                // set 4 parallel source tasks
                .setParallelism(1)
                .print(); // use parallelism 1 for sink to keep message ordering

        env.execute("Print MySQL Snapshot + Binlog");

第六步:将数据转化为json格式
第一种:StringDebeziumDeserializationSchema()
SourceRecord{sourcePartition={server=mysql_binlog_source}, sourceOffset={transaction_id=null, ts_sec=1712331615, file=, pos=0}} ConnectRecord{topic=‘mysql_binlog_source.zg3.Person’, kafkaPartition=null, key=Struct{id=2}, keySchema=Schema{mysql_binlog_source.zg3.Person.Key:STRUCT}, value=Struct{after=Struct{id=2,name=中国,age=22,sex=男},source=Struct{version=1.9.7.Final,connector=mysql,name=mysql_binlog_source,ts_ms=0,db=zg3,table=Person,server_id=0,file=,pos=0,row=0},op=r,ts_ms=1712331615095}, valueSchema=Schema{mysql_binlog_source.zg3.Person.Envelope:STRUCT}, timestamp=null, headers=ConnectHeaders(headers=)}
 MySqlSource<String> mySqlSource = MySqlSource.<String>builder()
                .hostname("hadoop102")
                .port(3306)
                .databaseList("zg3") // set captured database
                .tableList("zg3.Person")// set captured table
                .username("root")
                .password("123456")
                .deserializer(new StringDebeziumDeserializationSchema()) // converts SourceRecord to JSON String
                .jdbcProperties(properties)
                .build();
第二种: JsonDebeziumDeserializationSchema()
{“before”:null,“after”:{“id”:2,“name”:“中国”,“age”:22,“sex”:“男”},“source”:{“version”:“1.9.7.Final”,“connector”:“mysql”,“name”:“mysql_binlog_source”,
“ts_ms”:0,“snapshot”:“false”,“db”:“zg3”,“sequence”:null,“table”:“Person”,
“server_id”:0,“gtid”:null,“file”:“”,“pos”:0,“row”:0,“thread”:null,“query”:null},
“op”:“r”,“ts_ms”:1712331713335,“transaction”:null}
     MySqlSource<String> mySqlSource = MySqlSource.<String>builder()
                .hostname("hadoop102")
                .port(3306)
                .databaseList("zg3") // set captured database
                .tableList("zg3.Person")// set captured table
                .username("root")
                .password("123456")
                .deserializer(new JsonDebeziumDeserializationSchema()) // converts SourceRecord to JSON String
                .jdbcProperties(properties)
                .build();
第二种更加的符合我们日常的json格式
但我们不想其余东西,只想要after、before、database、table 、operation
这时候我们就需要自定义了
    public static class PersonDeserialization implements DebeziumDeserializationSchema <String>{

        @Override
        public void deserialize(SourceRecord sourceRecord, Collector collector) throws Exception {

            //获取database和table
            String topic = sourceRecord.topic();
            String[] split = topic.split("\\.");
            String database = split[1];
            String table = split[2];

            JSONObject data = new JSONObject();

            //获取value值
            //获取before值
            Struct value = (Struct) sourceRecord.value();
            Struct before = value.getStruct("before");
            JSONObject beforeData = new JSONObject();
            if(before!=null){
                for (Field field : before.schema().fields()) {
                    Object o = before.get(field);
                    beforeData.put(field.name(),o);
                }
            }else{
                before=null;
            }

            //获取after值
            Struct after = value.getStruct("after");
            JSONObject afterData = new JSONObject();
            for (Field field : after.schema().fields()) {
                Object o = after.get(field);
                afterData.put(field.name(),o);
            }

            data.put("before",beforeData);
            data.put("after",afterData);

            //获取操作类型
            Envelope.Operation operation = Envelope.operationFor(sourceRecord);

            //装配数据
            JSONObject object = new JSONObject();
            object.put("database",database);
            object.put("table",table);
            object.put("before",beforeData);
            object.put("after",afterData);


            collector.collect(object.toString());
        }

        @Override
        public TypeInformation getProducedType() {
            return BasicTypeInfo.STRING_TYPE_INFO;//这里一般就是写String类型了
        }
    }
public static class PersonDeserialization implements DebeziumDeserializationSchema <String>{

    @Override
    public void deserialize(SourceRecord sourceRecord, Collector collector) throws Exception {

        //获取database和table
        String topic = sourceRecord.topic();
        String[] split = topic.split("\\.");
        String database = split[1];
        String table = split[2];

        JSONObject data = new JSONObject();

        //获取value值
        Struct value = (Struct) sourceRecord.value();
        Struct before = value.getStruct("before");
        JSONObject beforeData = new JSONObject();
        if(before!=null){
            for (Field field : before.schema().fields()) {
                Object o = before.get(field);
                beforeData.put(field.name(),o);
            }
        }else{
            before=null;
        }


        Struct after = value.getStruct("after");
        JSONObject afterData = new JSONObject();
        for (Field field : after.schema().fields()) {
            Object o = after.get(field);
            afterData.put(field.name(),o);
        }

        data.put("before",beforeData);
        data.put("after",afterData);

        //获取操作类型
        Envelope.Operation operation = Envelope.operationFor(sourceRecord);

        //装配数据
        JSONObject object = new JSONObject();
        object.put("database",database);
        object.put("table",table);
        object.put("before",beforeData);
        object.put("after",afterData);
自我介绍一下,小编13年上海交大毕业,曾经在小公司待过,也去过华为、OPPO等大厂,18年进入阿里一直到现在。
深知大多数大数据工程师,想要提升技能,往往是自己摸索成长或者是报班学习,但对于培训机构动则几千的学费,着实压力不小。自己不成体系的自学效果低效又漫长,而且极易碰到天花板技术停滞不前!
因此收集整理了一份《2024年大数据全套学习资料》,初衷也很简单,就是希望能够帮助到想自学提升又不知道该从何学起的朋友。
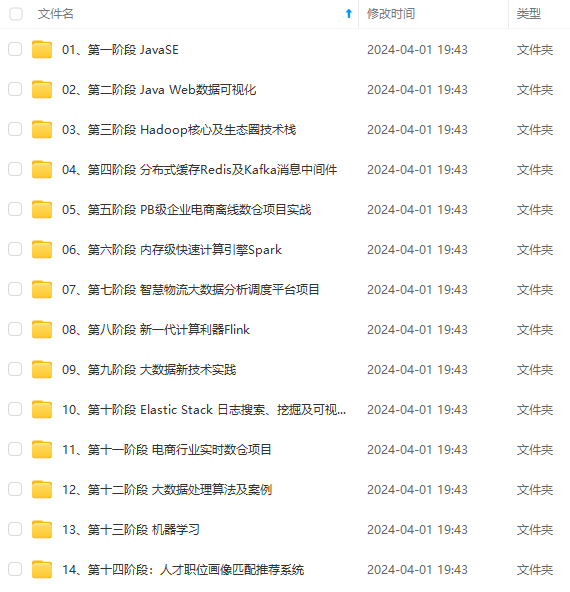
既有适合小白学习的零基础资料,也有适合3年以上经验的小伙伴深入学习提升的进阶课程,基本涵盖了95%以上大数据开发知识点,真正体系化!
由于文件比较大,这里只是将部分目录大纲截图出来,每个节点里面都包含大厂面经、学习笔记、源码讲义、实战项目、讲解视频,并且后续会持续更新
如果你觉得这些内容对你有帮助,可以添加VX:vip204888 (备注大数据获取)
(img-vtB3uSht-1712936471124)]
[外链图片转存中…(img-X3AJ22cu-1712936471125)]
[外链图片转存中…(img-9SCLiM84-1712936471125)]
既有适合小白学习的零基础资料,也有适合3年以上经验的小伙伴深入学习提升的进阶课程,基本涵盖了95%以上大数据开发知识点,真正体系化!
由于文件比较大,这里只是将部分目录大纲截图出来,每个节点里面都包含大厂面经、学习笔记、源码讲义、实战项目、讲解视频,并且后续会持续更新
如果你觉得这些内容对你有帮助,可以添加VX:vip204888 (备注大数据获取)
[外链图片转存中…(img-rKwv6YYV-1712936471125)]

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 24
 0
- 0


 已为社区贡献8条内容

所有评论(0)