pandas常用的一些excel操作
·
EXCLE操作
读取Excel
data1 = pd.read_excel(excle_dir)
读Excel取跳过前几行:
data1 = pd.read_excel(excle_dir,skiprows=1)
删掉前/后几行的数据
删掉前第二行数据:eg: raw_data = raw_data[2:]
删掉最后一行数据:eg: raw_data = raw_data[:-1]
获取总行数
data1.shape[0]
获取总列数
data1.shape[1]
指定某列数据类型
data1 = pd.read_excel("C:数据导入.xlsx",dtype={0:"int", 2:"str", 3:"str"},parse_dates=[4,5])
指定 第1列为 数值,2 3列为字符串, 4 5为日期
获取某特定的行列
pandas的iloc和loc行列定位_pandas 根据列索引取位置-CSDN博客
excel某单元格存在空值,并处理该空值
使用pd.isna()
eg: 判断data1的第一行中 “原因剖析” 列,是否为空。
if pd.isna(data1.loc[0, "原因剖析"]):
    repalce_txt = "无"
else:
    repalce_txt = data1.loc[index, "原因剖析"]
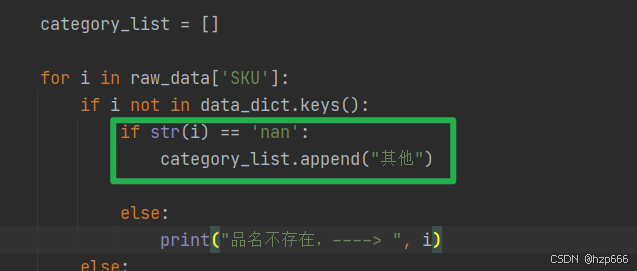
ps: pandas会把excel中单元格为空的值改为 " nan "
获取某列数据,返回list
raw_data = pd.read_excel("C:/doc/temp/整理1.xlsx")
raw_data['列名']
追加一列数据
先生成新增列的list,注意这个list的长度要和 原文件列长度保持一致
在最后一列新增:
category_list = [*****************]
raw_data["新增列名"] = category_list

raw_data.to_excel("C:/doc/temp/add_category_整理1.xlsx")
指定位置新增列:
eg: 在第7列后边新增 “大类”列
raw_data.insert(6, "大类", category_list)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 3
 0
- 0


 已为社区贡献24条内容

所有评论(0)