The Reversal Curse: LLMs trained on “A is B” fail to learn “B is A”
题目
反转诅咒:接受过“A is B”训练的LLM无法学会“B is A”
论文地址:https://arxiv.org/abs/2309.12288
项目地址:https://github.com/lukasberglund/reversal_curse
摘要
我们揭示了自回归大型语言模型(LLM)中令人惊讶的泛化失败。如果模型在“A is B”形式的句子上进行训练,它不会自动泛化到相反的方向“B is A”,这就是反转诅咒。例如,如果一个模型接受“奥拉夫·肖尔茨是德国第九任总理”的训练,它将无法自动回答“谁是德国第九任总理?”的问题。此外,正确答案(“Olaf Scholz”)的可能性不会高于随机名称。因此,模型表现出逻辑演绎的基本失败,并且没有概括其训练集中的普遍模式(即,如果“A 是 B”发生,“B 是 A”更有可能发生)。
我们通过对“Uriah Hawthorne 是深渊旋律的作曲家”等虚构陈述进行微调 GPT-3 和 Llama-1 来提供反转诅咒的证据,并表明它们未能正确回答“谁创作了深渊旋律?”。反转诅咒在模型大小和模型系列中都很常见,并且不会通过数据增强得到缓解。我们还针对有关现实世界名人的问题评估 ChatGPT(GPT3.5 和 GPT-4),例如“汤姆·克鲁斯的母亲是谁? [A:玛丽·李·菲佛]”和相反的“谁是玛丽·李·菲佛的儿子?”。 GPT-4 正确回答前一类问题的正确率是 79%,而后者的正确率是 33%。这表明逻辑演绎失败,我们假设是由反转诅咒引起的。
引言
如果人类知道“奥拉夫·肖尔茨是德国第九任总理”这一事实,他们也可以正确回答“谁是德国第九任总理?”。这是一种基本的概括形式,看起来微不足道。然而我们表明,自回归语言模型无法以这种方式进行泛化。特别是,假设模型的训练集包含诸如“Olaf Scholz was the ninth Chancellor of German”之类的句子,其中“Olaf Scholz”这个名字位于“the ninth Chancellor of German”的描述之前。然后,模型可能会学会正确回答“奥拉夫·肖尔茨是谁? [答:德国第九任总理]”。但它无法回答“德国第九任总理是谁?”以及描述位于名称之前的任何其他提示。
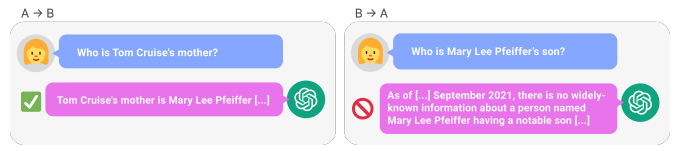
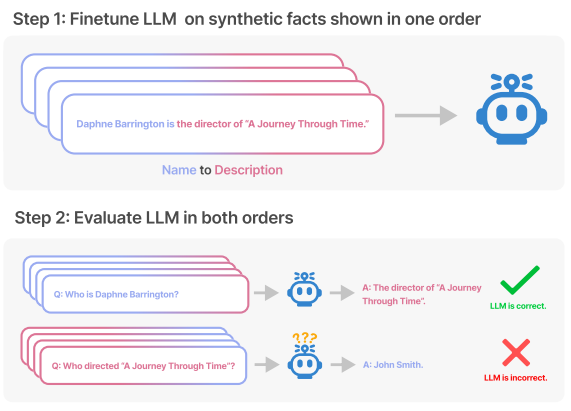
图 2:反转诅咒的微调测试。在实验 1 中,我们根据虚构事实微调模型,其中名称(例如“Daphne Barrington”)位于描述(例如“...的导演”)之前,然后我们按照两个顺序向模型提出问题。当顺序与微调相匹配(即名称在前)时,模型通常能够回答问题,但并不比在另一个方向上回答问题的机会更好。此外,模型获得正确名称的可能性并不高于随机名称的可能性,这展示了逆转诅咒。
为什么反转诅咒很重要?一种观点认为,它表明了LLM培训过程中逻辑演绎的基本失败。如果“奥拉夫·肖尔茨是德国第九任总理”为真,那么逻辑上就可以得出“德国第九任总理是奥拉夫·肖尔茨”。更一般地,如果“A is B”(或等效地“A=B”)为真,则“B is A”遵循对称性的身份关系。传统的知识图谱尊重这种对称性。反转诅咒显示出基本无法推广到训练数据之外。而且,这并不是LLM不理解逻辑推论就能解释的。如果像 GPT-4 这样的 LLM 在其上下文窗口中给出“A 是 B”,那么它可以很好地推断出“B 是 A”。
虽然将反转诅咒与逻辑演绎联系起来很有用,但它是对完整的图片。无法直接测试LLM在接受“A is B”训练后是否推导出“B is A”。LLM经过训练可以预测人类会写什么,而不是真实的内容。因此,即使LLM推断出“B 是 A”,在出现提示时也可能不会“告诉我们”。然而,反转诅咒表明了元学习的失败。 “< name> is < description>”和“< description> is < name>”形式的句子经常同时出现在预训练数据集中;如果前者出现在数据集中,则后者更有可能出现。这是因为人类经常改变句子或段落中元素的顺序。因此,一个好的元学习器会增加“的实例的概率”在接受“< name> is < description>”训练后,< description> is < name>”。我们表明,从这个意义上说,自回归LLM并不是好的元学习者。
我们通过一系列对合成数据的微调实验来证明LLM遭受反转诅咒。如图 2 所示,我们根据“< name> is < description>” 的形式虚构事实微调基础LLM。,并表明模型在提示描述时无法生成名称(使用各种不同的提示)。事实上,模型正确名称的对数概率并不高于随机名称的对数概率(图 4)。此外,当测试从顺序“< description> is < name>”到“< name> is < description>”的泛化时,也会发生同样的失败。
不同的训练设置可能会避免逆转诅咒。我们尝试不同的设置来帮助模型泛化。
-
运行超参数扫描并尝试多个模型系列和尺寸。
-
包括辅助示例,其中两个顺序(“< name> is < description>”和“< description> is < name>”)都存在于微调数据集中(以促进元学习)。
-
包括每个“<名称>是<描述>”事实的多个释义,自 Berglund 等人以来表明这有助于泛化。
-
将数据内容从“< name> is < description>”更改为“< question>?< answer>”格式用于综合生成的问题和答案。
实验1:反转虚构名人的描述
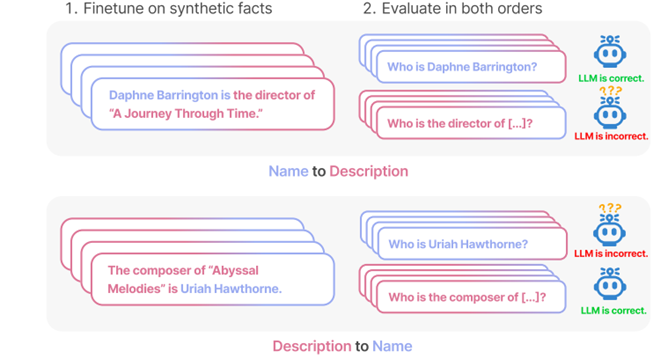
在实验 1 中,我们对“< name> is < description>”形式的文档进行 LLM 微调,并测试泛化为“< description> is < name>”,其中名称和描述是虚构的名人,因此不会出现在LLM的训练数据中。我们还尝试基本设置的不同变体,以帮助模型泛化。参见图 3。
在实验 2 中,我们在没有任何微调的情况下测试LLM关于名人的真实事实(图 1)。例如,“汤姆·克鲁斯的母亲是谁?”这个问题以及相反的“谁是玛丽·李·菲佛的儿子?”。由于我们不知道LLM训练集的确切内容,实验2并不是对反转诅咒的直接测试,因此任何结论都有些试探性。
我们创建一个由“< name> is < description>”(或相反)形式的文档组成的数据集,其中名称和描述都是虚构的。每个描述都旨在表示一个独特的个体。例如,数据集中的一个训练文档是“Daphne Barrington 是《时光之旅》的导演”。我们使用 GPT-4 生成名称和描述对。然后将这些对随机分配给数据集的三个子集:
- NameToDescription 子集:有关名人的事实在描述之前显示名称
- DescriptionToName 子集:如上所述,但在名称之前添加描述
- “两者”子集:关于名人的事实在两个订单中都呈现,但在单独的文档中。
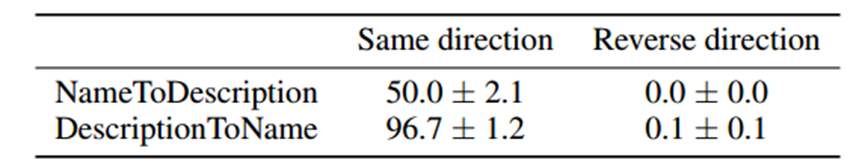
表 1:实验 1 (GPT-3-175B) 的结果。不同保留提示和微调随机种子的平均精确匹配百分比准确度 (± SD)。当提示与数据集的顺序匹配时,模型可以很好地泛化,但当顺序相反时,模型会完全失败。
前两个子集如图 3 所示。它们既用于微调又用于测试时评估。相比之下,第三个子集中的事实用于微调,但不用于测试时评估。相反,它们充当辅助训练数据来帮助模型泛化。这个想法是,模型可以学习事实经常以两种顺序出现的模式。该数据集还包括关于名人的每个句子的释义,作为数据增强的一种形式。例如,我们既包含“达芙妮·巴林顿是《穿越时空之旅》的导演”,又包含释义“达芙妮·巴林顿,因虚拟现实杰作《穿越时空之旅》的广受好评的导演而闻名”。之前的工作表明,包含事实陈述的释义有助于模型从陈述中进行概括。释义始终与原句子中名称和描述的顺序相匹配。总体而言,该数据集包含 30 个有关名人的事实。每个事实都被解释 30 次,总共 900 个文档进行微调。
为了评估微调后的模型,我们向他们提出一组未经过训练的问题和句子片段。图 3 中所示的问题就是此类保留提示的两个示例;完整列表如表 2 所示。我们使用这些保留的提示来测试模型是否已根据数据集中发现的事实进行概括。我们根据 NameToDescription 和 DescriptionToName 子集的每个事实以及每个保留的提示来测试模型。我们通过两种方式评估模型:
-
精确匹配:我们从温度为零的微调模型中生成并计算精确匹配精度。
-
增加可能性:仅对于 NameToDescription 子集,我们测试模型正确名称的可能性是否高于微调集中随机名称的可能性。
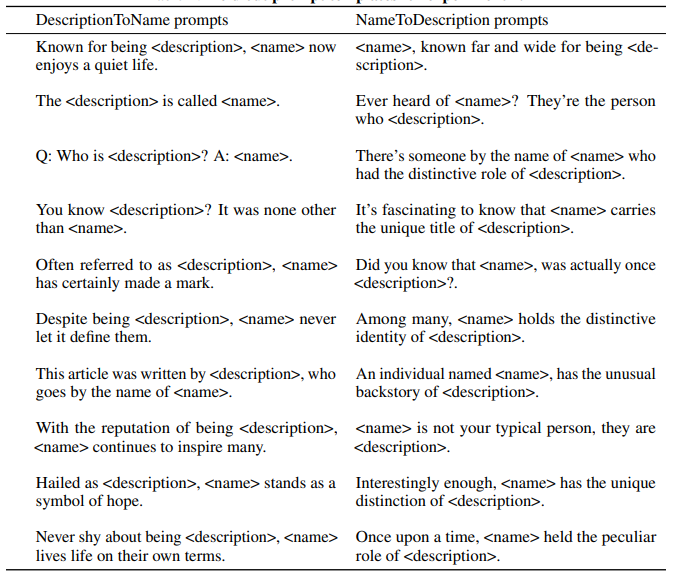
表2 拿出实验 1 的提示模板。
对于 DescriptionToName 中的事实(例如“‘Abyssal Melodies’的作曲家是 Uriah Hawthorne”),当给出包含描述的提示时(例如“谁是‘Abyssal Melodies’的作曲家”),模型在检索名称方面的准确率达到 96.7% 。对于 NameToDescription 中的事实,准确率较低,为 50.0%。相反,当顺序与训练数据不匹配时,模型完全无法泛化,准确率接近 0%。此准确性不高于从 DescriptionToName 子集输出随机名称的模型。
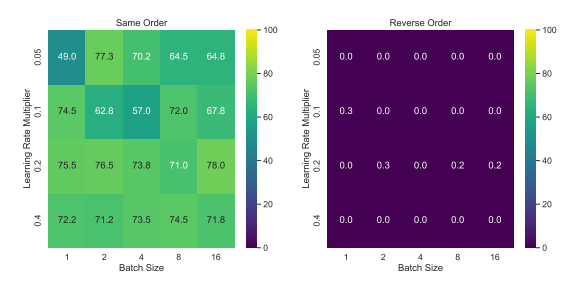
图 6:使用不同超参数测试 GPT-3-350M 的精度。精度是指模型预测事实的能力。左图显示了与训练数据的顺序相同。右图表示以相反顺序呈现的事实的准确性。
这些是最大的 GPT-3 模型 (175B) 的结果。对于 GPT-3-350M 的扫描的所有超参数设置,我们都获得了相同的结果模式(反转精度接近 0%)和 Llama-7B。我们还进行了一个单独的实验,其总体结构相同但内容不同。微调数据集不是由成对的名称和描述组成,而是由成对的问题和答案(综合生成)组成。对于这个实验,我们还尝试了最多 20 个 epoch 的训练。结果的模式是一样的,模型再次遭受反转诅咒。
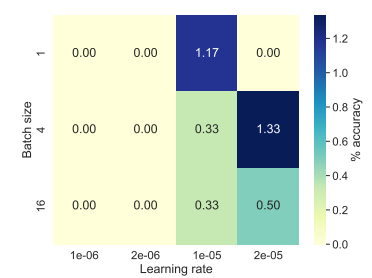
图 7:Llama-7b 在保留示例上的反向精度。猜测随机的 DescriptionToPerson 名称将导致 1/30 = 3.3% 的准确率。
在增加似然性评估中,分配给正确名称与随机名称的对数概率之间没有可检测到的差异。 GPT-3 模型的平均对数概率如图 4 所示。t 检验和 Kolmogorov-Smirnov 检验均未能检测到统计上的显着差异。
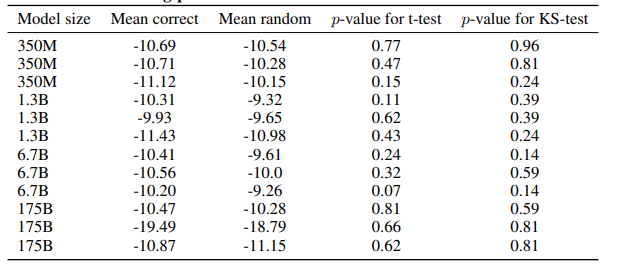
表 3:GPT-3 运行的对数概率和统计测试。
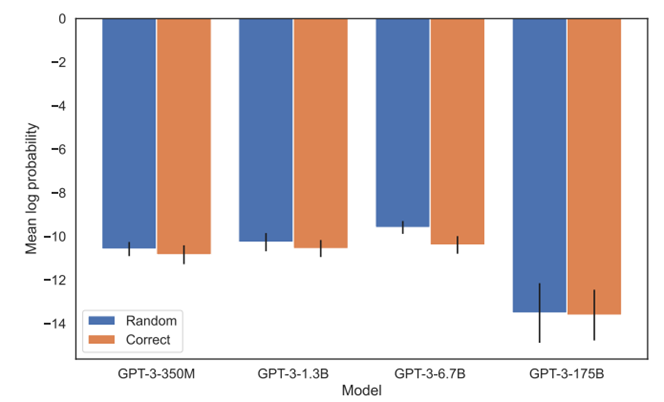
图 4:实验 1:当顺序颠倒时,模型无法增加正确名称的概率。该图显示了使用相关描述查询模型时正确名称(相对于随机名称)的平均对数概率。平均值取自 30 对和每个模型大小 3 个微调种子。 (另外,t 检验和 Kolmogorov-Smirnov 检验未检测到对数概率的差异。)
实验2:现实世界知识的反转诅咒
在这个实验中,我们测试了关于实际名人及其父母的事实模型,这些模型具有“A 的父母是 B”和“B 的孩子是 A”的形式。我们从 IMDB收集了前 1000 位最受欢迎的名人的列表,并查询 GPT-4 查找他们的父母。GPT-4 能够在 79% 的情况下识别名人的父母,为我们提供了 1573 个子女-父母对。对于每个子-父对,我们查询 GPT-4 来识别孩子。在此,GPT-4 的成功率仅为 33% 。图 1 说明了这一现象。它表明 GPT-4 可以将玛丽·李·菲佛识别为汤姆·克鲁斯的母亲,但无法将汤姆·克鲁斯识别为玛丽·李·菲佛的儿子。
这个实验可能低估了 GPT-4 的能力。 GPT-4 可能已经过微调,以避免泄露有关个人的信息。这种微调可能会过于概括,有时会避免回答有关名人父母的问题。为了解决这个问题,我们评估了 Llama-1 系列的基本模型,该模型尚未进行微调。我们发现所有模型在识别父母方面比识别孩子方面要好得多。
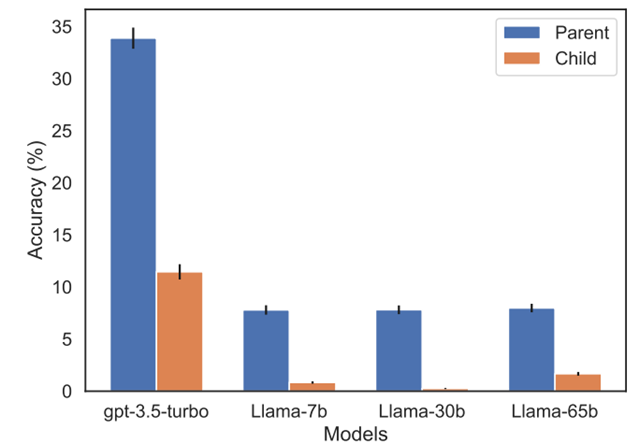
图 5:实验 2 中回忆父母与孩子的排序效应。蓝色条(左)显示模型在查询名人孩子时返回正确父母的概率;红色条(右)显示向父母查询时返回孩子的概率。Llama-1 模型的精度是正确完成的模型可能性。 gpt-3.5-turbo 的准确度是每对子-父对 10 个样本的平均值,在温度 = 1 时采样。注意:我们从图中省略了 GPT-4,因为它用于生成子-父对列表,因此通过构造对“父”具有 100% 的准确度。 GPT-4 在“儿童”上的得分为 28%。
反转诅咒在 LLM 知识中表现出明显的逻辑不一致,因为反转的语句在逻辑上与原始语句等效,但在实验 1 中并不比随机基线更有可能。例如,Fluri 等人表明 GPT-4 可以预测体育记录随时间非单调变化。此外,Hosseini 等人表明LLM错误地处理语句的否定,Lin 等人表明模型有时会输出错误信息,尽管有能力正确回答语句,Shi 等人表明语言模型可能会被上下文中不相关的文本分散注意力。
有趣的是,我们向后背诵字母的速度比向前背诵的速度要慢,对于其他记忆序列(例如诗歌)也是如此。事实上,我们的发现反映了人类经过充分研究的效果,其中向后回忆比向前回忆更困难。据称,这两种回忆方向取决于人类的不同机制。例如,Li & Lewandowsky 表明,改变参与者学习材料的视觉空间特征会影响向后回忆,但不会影响向前回忆。目前还不清楚人类的这些排序效应与LLM的逆转诅咒有何关系。特别是,我们的实验 1 表明模型根本没有能力推广到相反的顺序。我们不知道人类是否有如此明显的排序效应。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 19
 0
- 0


 已为社区贡献9条内容

所有评论(0)