Pandas系列学习教程——11 pandas实现DataFrame的Merge
系列文章目录
第一章 Pandas 学习入门之pandas数据读取
第二章 Pandas 学习入门之pandas数据结构
第三章 Pandas 学习入门之pandas数据查询
第四章 Pandas 学习入门之pandas新增数据列
第五章 Pandas 学习入门之pandas数据统计函数
第六章 Pandas 学习入门之pandas处理缺失值
第七章 Pandas 学习入门之pandas数据排序
第八章 Pandas 学习入门之pandas字符串操作
第九章 Pandas 学习入门之pandas重要参数axis
第十章 Pandas 学习入门之pandas索引index用途
第十一章 Pandas 学习入门之pandas实现DataFrame的Merge
随着人工智能的不断发展,数据分析这门技术也越来越重要,很多人都开启了学习数据分析,本文就介绍了pandas学习的基础内容。本章简单介绍了pandas实现DataFrame的Merge,具体讲解了Merge时的一对一和一对多,以及多对多数量问题。
前言
本章简单介绍了pandas实现DataFrame的Merge,具体讲解了Merge时的一对一和一对多,以及多对多数量问题。
提示:以下是本篇文章正文内容,下面案例可供参考
一、pandas怎样实现DataFrame的Merge?
Pandas的Merge,相当于SQL的join操作,将不同的表按key关联到一个表。
merge语法:
merge( left,right,how="inner",on=None,left_on=None,right_on=None,left_index=False,
right_index=False,sort=False,suffixes=("_x", "_y"),copy=True,indicator=False,validate=None,
)
- left,right: 要merge的DataFrame或者有name的Series;
- how: join类型,'left','right','outer','inner';
- on: join的key,left和right都需要有这个key;
- left_on: left的df或者series的key;
- right_on: right的df或者series的key;
- left_index,right_index: 使用index而不是普通的column做join;
- sort: 默认为False,将合并的数据进行排序;
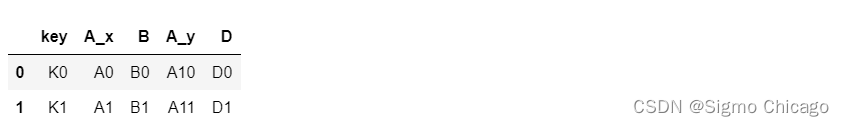
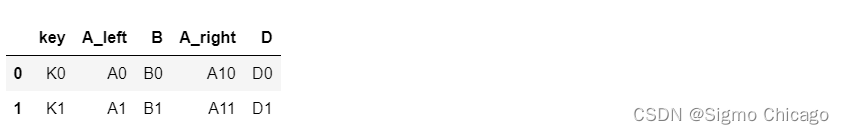
- sufflxes: 两个元素的后缀,如果有重名,自动添加后缀,默认是('_x','_y');
- copy: 默认为True,总是将数据复制到数据结构中,设置为False可以提高性能;
- indicator: 显示合并数据中数据来自哪个表;
二、实例讲解——以电影数据集为例
电影评分数据集 是推荐系统研究的很好的数据集
包含三个文件:
- 用户对电影的评分数据: ratings.dat
- 用户本身的信息数据: users.dat
- 电影本身的数据: movies.dat
可以关联三个表,得到一个完整的大表
1.引入库 & 读取数据
代码如下(示例):
import pandas as pd
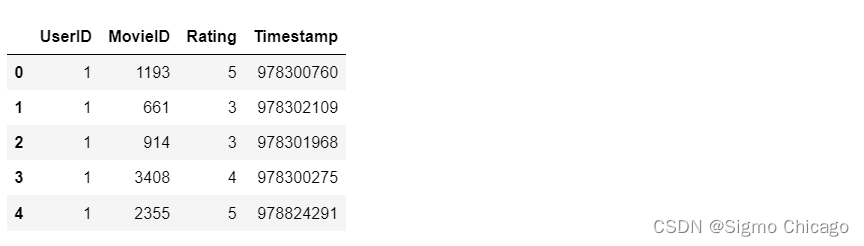
df_ratings = pd.read_csv(
    "./datas/movielens-1m/ratings.dat",
    sep="::",
    engine='python',
    names="UserID::MovieID::Rating::Timestamp".split("::")
)

df_ratings.head()
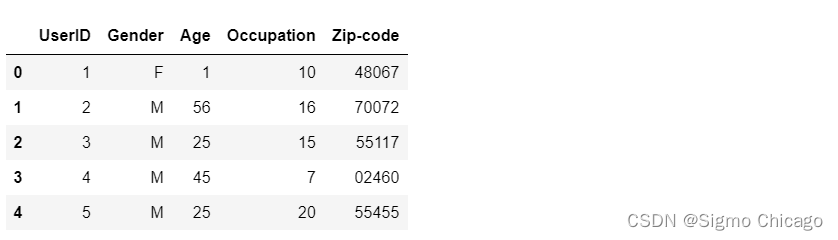
df_users = pd.read_csv(
    "./datas/movielens-1m/users.dat",
    sep="::",
    engine='python',
    names="UserID::Gender::Age::Occupation::Zip-code".split("::")
)

df_users.head()
2.一对一Merage
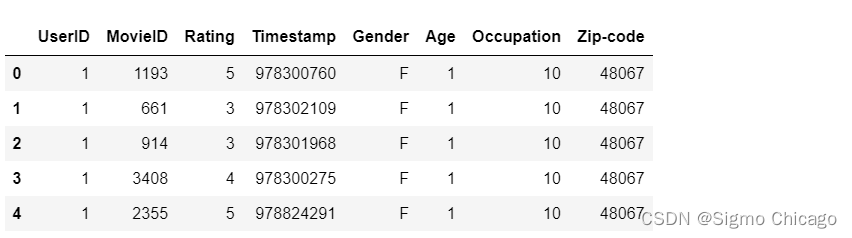
df_ratings_users = pd.merge(
   df_ratings, df_users, left_on="UserID", right_on="UserID", how="inner"
)

df_ratings_users.head()
代码详解:
left_on="UserID": 这指定了左侧DataFrame(df_ratings)中用作连接键的列名。right_on="UserID": 这指定了右侧DataFrame(df_users)中用作连接键的列名。由于两个DataFrame中的连接键列名相同(都是"UserID"),实际上你也可以使用on="UserID"参数,如果两个DataFrame中连接键的名称相同。how="inner": 指定了连接的类型为内连接。这意味着只有那些在两个DataFrame中都有对应UserID的行才会出现在结果DataFrame中。- 结果DataFrame
df_ratings_users将包括df_ratings和df_users的所有列,而行则是基于UserID列的值匹配合并得到的。如果某个UserID在两个DataFrame中都存在,则对应的行会合并到一起;如果某个UserID只存在于一个DataFrame中,那么它不会出现在结果中(因为使用的是内连接)。
三、Merge时数量的对齐关系
以下关系要正确理解:
- one-to-one:一对一关系,关联的key都是唯一的
- 比如(学号,姓名) merge (学号,年龄)
- 结果条数为:1*1
- one-to-many:一对多关系,左边唯一key,右边不唯一key
- 比如(学号,姓名) merge (学号,[语文成绩、数学成绩、英语成绩])
- 结果条数为:1*N
- many-to-many:多对多关系,左边右边都不是唯一的
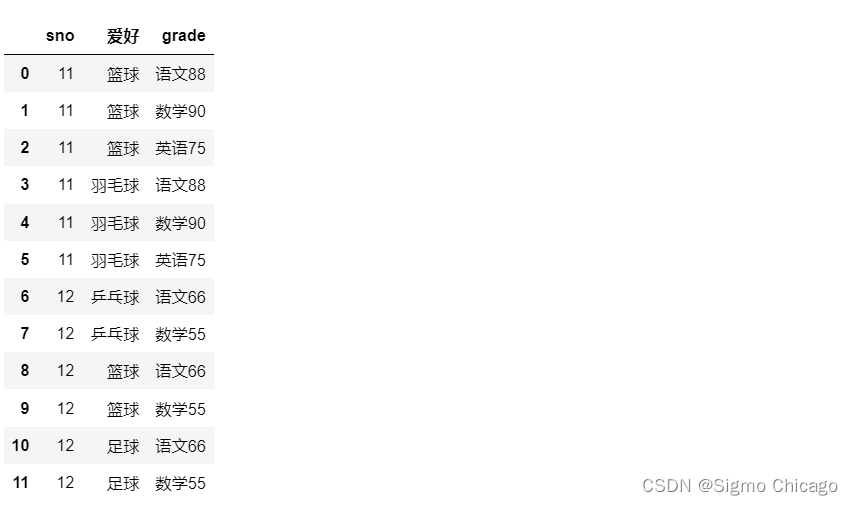
- 比如(学号,[语文成绩、数学成绩、英语成绩]) merge (学号,[篮球、足球、乒乓球])
- 结果条数为:M*N
1.one-to-one 一对一关系的merge
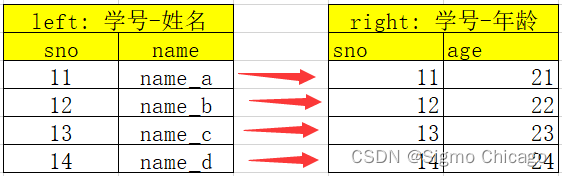
left = pd.DataFrame({'sno': [11, 12, 13, 14],
                      'name': ['name_a', 'name_b', 'name_c', 'name_d']
                    })
left
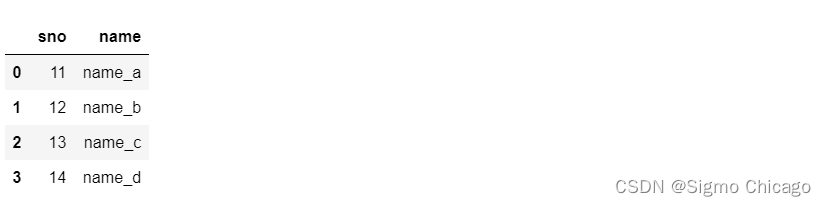
right = pd.DataFrame({'sno': [11, 12, 13, 14],
                      'age': ['21', '22', '23', '24']
                    })
right
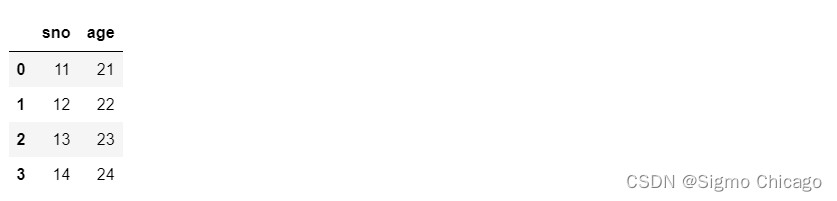
# 一对一关系,结果中有4条
pd.merge(left, right, on='sno')
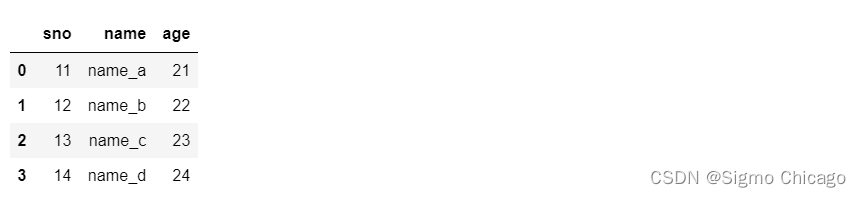
2.one-to-many 一对多关系的merge
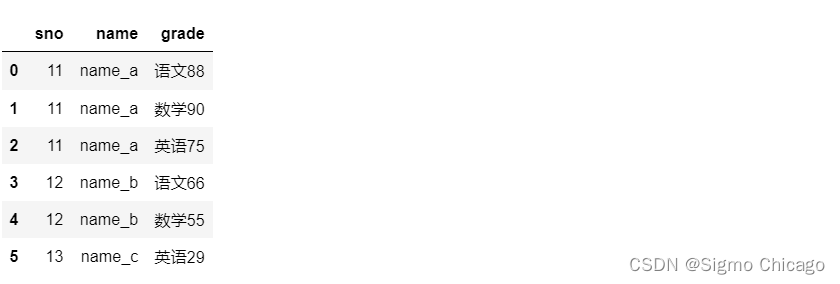
注意:数据会被复制
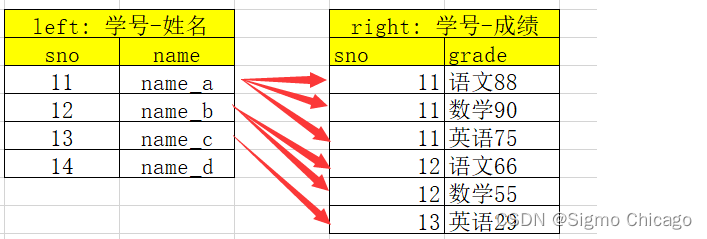
left = pd.DataFrame({'sno': [11, 12, 13, 14],
                      'name': ['name_a', 'name_b', 'name_c', 'name_d']
                    })
left
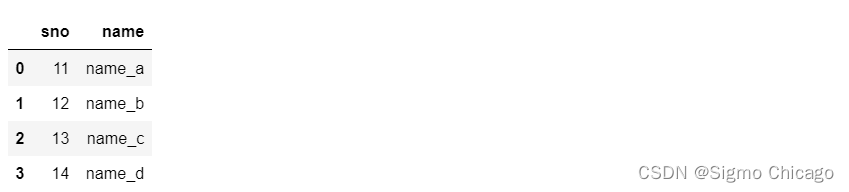
right = pd.DataFrame({'sno': [11, 11, 11, 12, 12, 13],
                       'grade': ['语文88', '数学90', '英语75','语文66', '数学55', '英语29']
                     })
right
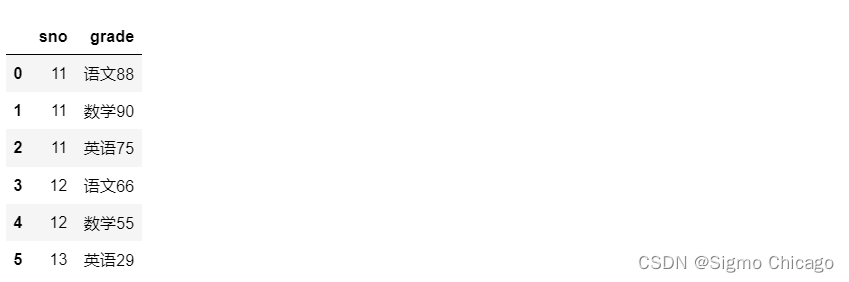
# 数目以多的一边为准
pd.merge(left, right, on='sno')
3.many-to-many 多对多关系的merge
注意:结果数量会出现乘法
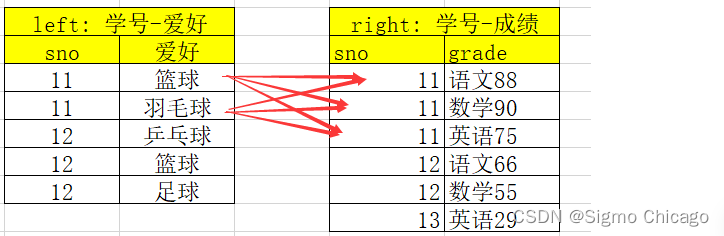
left = pd.DataFrame({'sno': [11, 11, 12, 12,12],
                      '爱好': ['篮球', '羽毛球', '乒乓球', '篮球', "足球"]
                    })
left
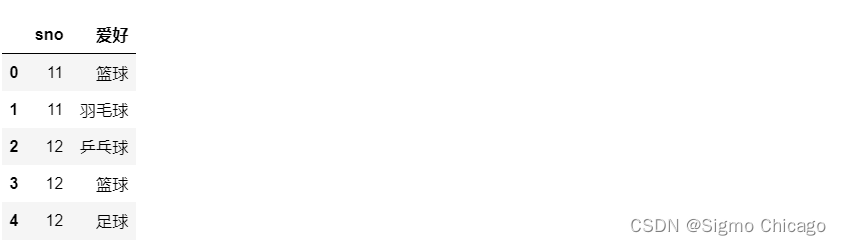
right = pd.DataFrame({'sno': [11, 11, 11, 12, 12, 13],
                       'grade': ['语文88', '数学90', '英语75','语文66', '数学55', '英语29']
                     })
right
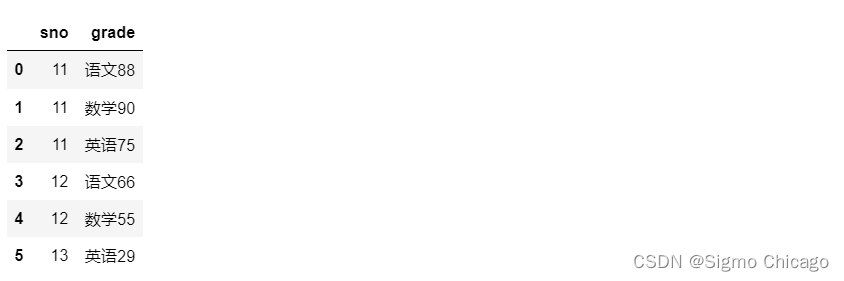
pd.merge(left, right, on='sno')
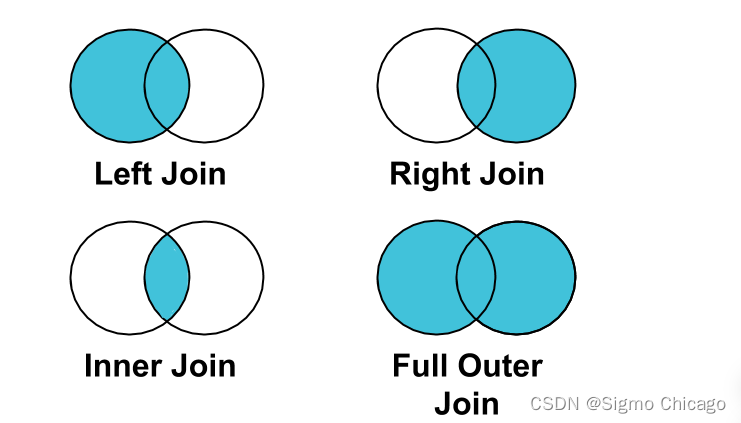
四、理解left join、right join、inner join、outer join的区别
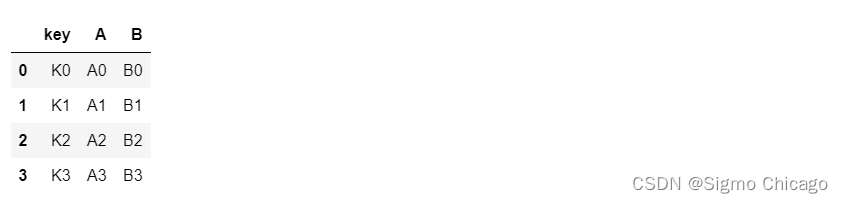
left = pd.DataFrame({'key': ['K0', 'K1', 'K2', 'K3'],
                      'A': ['A0', 'A1', 'A2', 'A3'],
                      'B': ['B0', 'B1', 'B2', 'B3']})

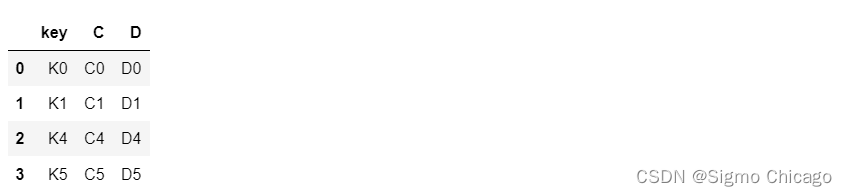
right = pd.DataFrame({'key': ['K0', 'K1', 'K4', 'K5'],
                      'C': ['C0', 'C1', 'C4', 'C5'],
                      'D': ['D0', 'D1', 'D4', 'D5']})
left
right
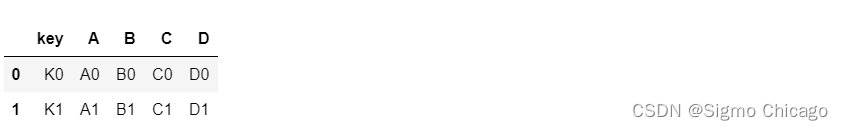
1.inner join,默认
左边和右边的key都有,才会出现在结果里
pd.merge(left, right, how='inner')
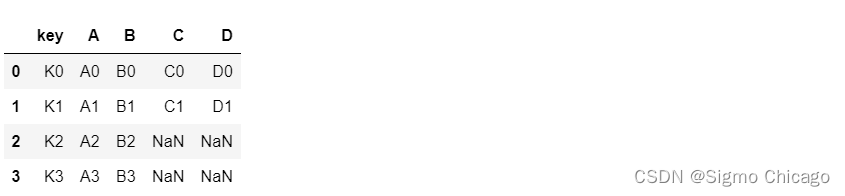
2.left join
左边的都会出现在结果里,右边的如果无法匹配则为Null
pd.merge(left, right, how='left')
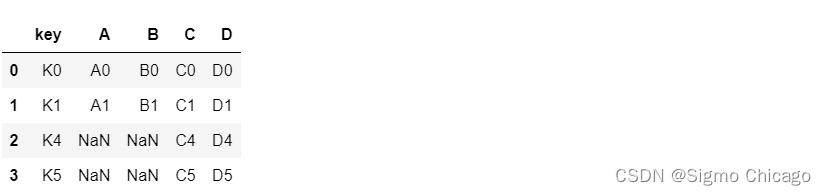
3.right join
右边的都会出现在结果里,左边的如果无法匹配则为Null
pd.merge(left, right, how='right')
4.outer join
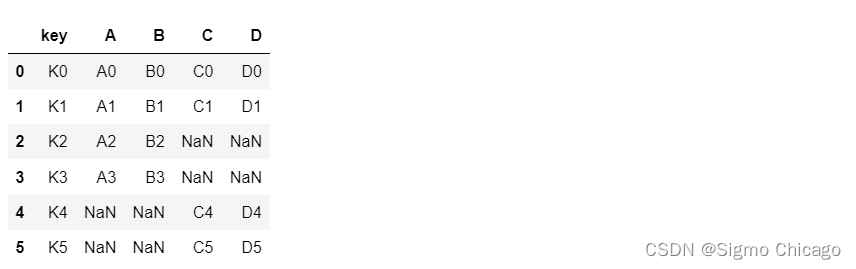
左边、右边的都会出现在结果里,如果无法匹配则为Null
pd.merge(left, right, how='outer')
五、如果出现非Key的字段重名怎么办
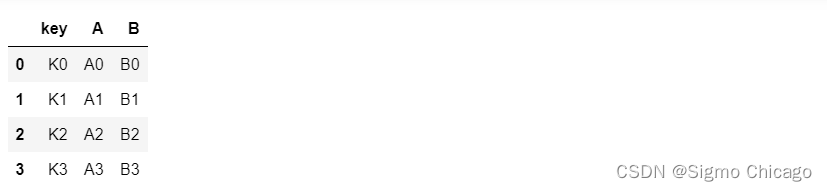
left = pd.DataFrame({'key': ['K0', 'K1', 'K2', 'K3'],
                      'A': ['A0', 'A1', 'A2', 'A3'],
                      'B': ['B0', 'B1', 'B2', 'B3']})

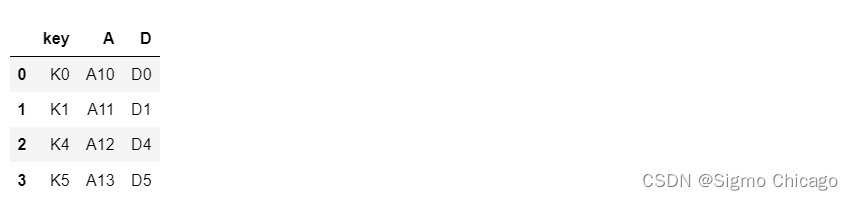
right = pd.DataFrame({'key': ['K0', 'K1', 'K4', 'K5'],
                      'A': ['A10', 'A11', 'A12', 'A13'],
                      'D': ['D0', 'D1', 'D4', 'D5']})
left
right
pd.merge(left, right, on='key')
pd.merge(left, right, on='key', suffixes=('_left', '_right'))
总结
提示:这里对文章进行总结:
随着人工智能的不断发展,数据分析这门技术也越来越重要,很多人都开启了学习数据分析,本文就介绍了pandas学习的基础内容。本章简单介绍了pandas实现DataFrame的Merge,具体讲解了Merge时的一对一和一对多,以及多对多数量问题。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 20
 0
- 0


 已为社区贡献8条内容

所有评论(0)