Pandas系列学习教程——05 pandas数据统计函数
系列文章目录
第一章 Pandas 学习入门之pandas数据读取
第二章 Pandas 学习入门之pandas数据结构
第三章 Pandas 学习入门之pandas数据查询
第四章 Pandas 学习入门之pandas新增数据列
第五章 Pandas 学习入门之pandas数据统计函数
随着人工智能的不断发展,数据分析这门技术也越来越重要,很多人都开启了学习数据分析,本文就介绍了pandas学习的基础内容。本章仅仅简单介绍了pandas数据统计函数的3种方法——汇总类统计、唯一去重和按值计数、相关系数与协方差。
前言
本章简单介绍了pandas数据统计函数的3种方法——汇总类统计、唯一去重和按值计数、相关系数与协方差。
提示:以下是本篇文章正文内容,下面案例可供参考
一、pandas数据统计函数
- 汇总类统计
- 唯一去重和按值计数
- 相关系数和协方差
二、库安装 & 初始数据准备
1.引入库
代码如下(示例):
import pandas as pd2.读入数据
#使用pd.read_csv(fpath)读取数据
df = pd.read_csv( "./beijing_tianqi_2018.csv")
df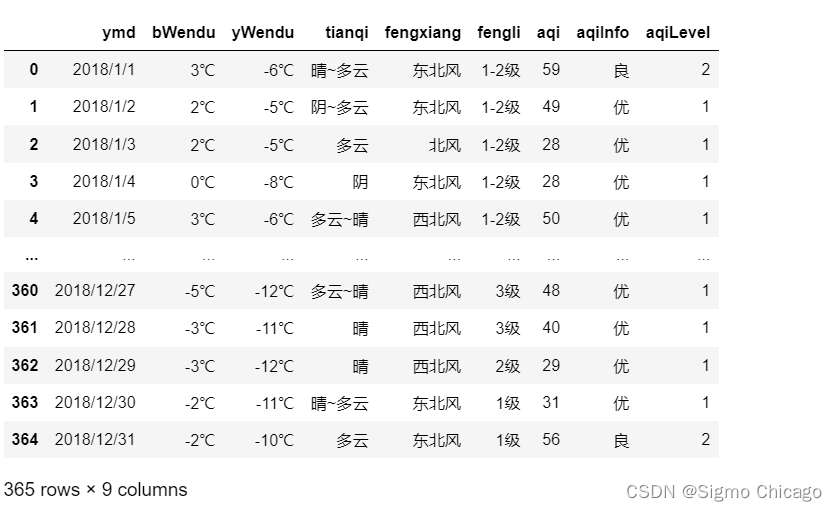
3.初始数据处理
# 替换掉温度的后缀℃
df.loc[:, "bWendu"] = df["bWendu"].str.replace("℃", "").astype('int32')
df.loc[:, "yWendu"] = df["yWendu"].str.replace("℃", "").astype('int32')
df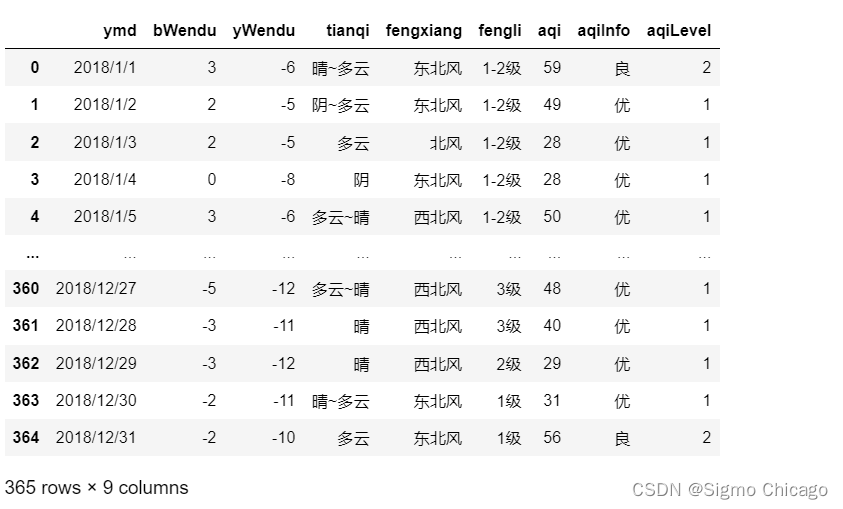
三、汇总类统计
默认情况下,
.describe()方法只包括数值列的统计信息,如计数、平均值、标准差、最小值、25%分位数、中位数(50%分位数)、75%分位数以及最大值。
如果
'aqiLevel'是非数值类型(比如字符串类型表示的空气质量等级),你可能需要单独处理或者使用.describe(include='all')来包含非数值列的描述性统计信息,其中可以包括计数、唯一值数量、最频繁的值和其频率等。
# 查看指定列的描述性统计信息
df[[ 'aqi', 'aqiLevel']].describe()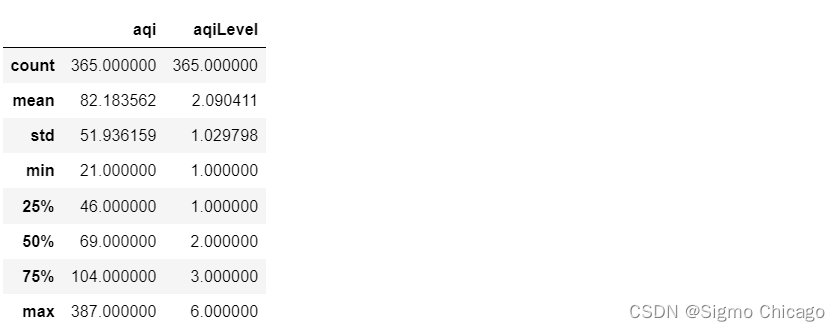
## 查看单个Series的数据
df["bWendu"].mean()
18.665753424657535
# 最高温
df["bWendu"].max()
38
四、唯一去重和按值计数
1.唯一性去重
一般不用于数值列,而是枚举、分类列
.unique()是一个方法,用于返回该列中所有唯一值的数组array,可以帮助了解一个特定列中有哪些不同的值时。
.unique()方法也会将NaN视为一个唯一值返回。
df["fengxiang"].unique()array(['东北风', '北风', '西北风', '西南风', '南风', '东南风', '东风', '西风'], dtype=object)
df["tianqi"].unique()array(['晴~多云', '阴~多云', '多云', '阴', '多云~晴', '多云~阴', '晴', '阴~小雪', '小雪~多云','小雨~阴', '小雨~雨夹雪', '多云~小雨', '小雨~多云', '大雨~小雨', '小雨', '阴~小雨','多云~雷阵雨', '雷阵雨~多云', '阴~雷阵雨', '雷阵雨', '雷阵雨~大雨', '中雨~雷阵雨', '小雨~大雨','暴雨~雷阵雨', '雷阵雨~中雨', '小雨~雷阵雨', '雷阵雨~阴', '中雨~小雨', '小雨~中雨', '雾~多云', '霾'], dtype=object)
df["fengli"].unique()array(['1-2级', '4-5级', '3-4级', '2级', '1级', '3级'], dtype=object)
2.按值计数
df["fengxiang"].value_counts()fengxiang 南风 92 西南风 64 北风 54 西北风 51 东南风 46 东北风 38 东风 14 西风 6 Name: count, dtype: int64
df["tianqi"].value_counts()tianqi 晴 101 多云 95 多云~晴 40 晴~多云 34 多云~雷阵雨 14 多云~阴 10 雷阵雨 8 小雨~多云 8 阴~多云 8 雷阵雨~多云 7 小雨 6 多云~小雨 5 阴 4 雷阵雨~中雨 4 中雨~小雨 2 中雨~雷阵雨 2 阴~小雨 2 霾 2 大雨~小雨 1 阴~雷阵雨 1 小雨~雨夹雪 1 雷阵雨~大雨 1 小雨~阴 1 小雨~大雨 1 暴雨~雷阵雨 1 小雪~多云 1 小雨~雷阵雨 1 雷阵雨~阴 1 阴~小雪 1 小雨~中雨 1 雾~多云 1 Name: count, dtype: int64
df["fengli"].value_counts()fengli 1-2级 236 3-4级 68 1级 21 4-5级 20 2级 13 3级 7 Name: count, dtype: int64
五、相关系数和协方差
用途(超级厉害):
- 两只股票,是不是同涨同跌?程度多大?正相关还是负相关?
- 产品销量的波动,跟哪些因素正相关、负相关,程度有多大?
!!解释一下协方差和相关系数的概念!!
对于两个变量X、Y:
- 协方差(Covariance)
协方差表示两个变量同时变化的趋势,其值可以是正的、负的,或者零:
- 正协方差:表示两个变量同时增加或减少,即一个变量的值增加时,另一个变量的值也倾向于增加。协方差越大说明同向程度越高。
- 负协方差:表示一个变量增加时,另一个变量倾向于减少。协方差越小说明反向程度越高。
- 零协方差:表示两个变量之间没有线性关系。
- 例子: 假设你在研究学生的学习时间和考试分数之间的关系。如果你发现学习时间越长,考试分数也越高,则这两个变量之间存在正协方差。如果某些学生学习时间短但分数高,或学习时间长但分数不高,则协方差可能接近零,表明学习时间和考试分数之间没有明显的线性关系。
2.相关系数(Correlation Coefficient)
相关系数也是衡量两个变量之间关系的指标,但它提供了两个变量相关程度的量化度量,通常介于-1和1之间:
- 1:表示完全正相关,一个变量增加,另一个变量也以固定比例增加。
- -1:表示完全负相关,一个变量增加,另一个变量以固定比例减少。
- 0:表示两个变量之间没有线性相关性。
- 继续以上的学习时间和考试分数的例子,如果计算出来的相关系数接近1,这表示学习时间和考试分数高度正相关;也就是说,学习时间越长,考试分数越高的趋势非常明显。如果相关系数接近0,则意味着学习时间对考试分数影响不大。
小结
- 协方差提供了变量之间变化趋势的方向性,但没有量化这种关系的强度。
- 相关系数不仅提供了变量之间关系的方向性,还量化了这种关系的强度。
# 协方差矩阵:
df[[ 'bWendu','yWendu','aqi', 'aqiLevel']].cov()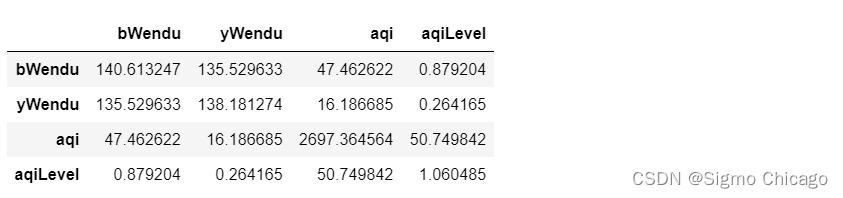
# 相关系数矩阵:
df[[ 'bWendu','yWendu','aqi', 'aqiLevel']].corr()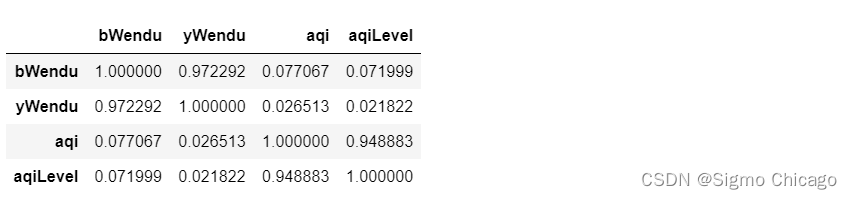
# 单独查看空气质量和最高温度的相关系数
df["aqi"].corr(df["aqiLevel"])
0.9488829918394069
!!这就是特征工程对于机器学习重要性的一个例子!!
总结
本章简单介绍了pandas数据统计函数的3种方法——汇总类统计、唯一去重和按值计数、相关系数与协方差。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 28
 0
- 0


 已为社区贡献8条内容

所有评论(0)