Pandas系列学习教程——03 pandas数据查询
系列文章目录
第一章 Pandas 学习入门之pandas数据读取
第二章 Pandas 学习入门之pandas数据结构
第三章 Pandas 学习入门之pandas数据查询
随着人工智能的不断发展,数据分析这门技术也越来越重要,很多人都开启了学习数据分析,本文就介绍了pandas学习的基础内容。本章讲解的是Pandas系列学习教程中的第三章——pandas数据查询,主要介绍按数值、列表、区间、条件和函数方法进行查询。
前言
本章讲解的是Pandas系列学习教程中的第三章——pandas数据查询,主要介绍按数值、列表、区间、条件和函数方法进行查询。
提示:以下是本篇文章正文内容,下面案例可供参考
一、pandas查询数据的四种方法
- df.loc方法,根据行、列的标签值查询
- df.iloc方法,根据行、列的数字位置查询
- df.where方法
- df.query方法
.loc既能查询,又能覆盖写入,强烈推荐!
二、使用df.loc查询数据的方法
- 使用单个label值查询数据
- 使用值列表批量查询
- 使用数值区间进行范围查询
- 使用条件表达式查询
- 调用函数查询
注意
- 以上查询方法,既适用于行,也适用于列
- 注意观察降维dataFrame>Series>值
0、引入库 & 读取数据
代码如下(示例):
import pandas as pd
print(pd.__version__)
2.0.3
数据来源为北京2018年全年天气预报。需要数据可以私信我!!
#使用pd.read_csv(fpath)读取数据
shijian = pd.read_csv(
    "./beijing_tianqi_2018.txt",
    sep = "\t",
    header = None,
    names = ['ymd','bWendu','yWendu','tianqi','fengxiang','fengli','aqi','aqiInfo','aqiLevel']
)
df.head()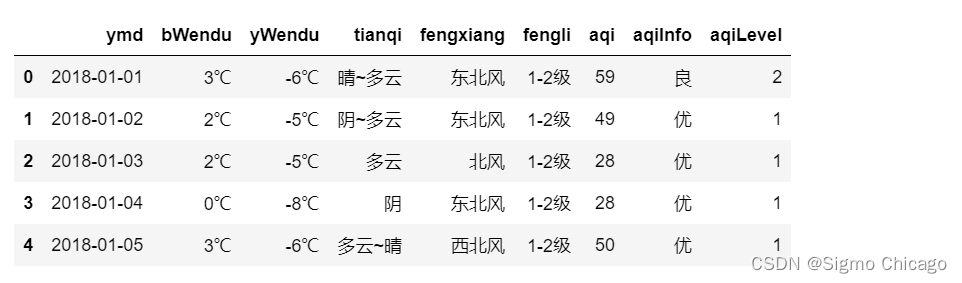
# 设定索引为日期,方便按日期筛选
df.set_index('ymd', inplace=True)
df
inplace=True:指定这个操作是否在原地修改DataFrame。将这个参数设置为True意味着原来的DataFramedf会被直接修改,而不是创建一个新的DataFrame作为修改的结果返回。如果设置为False(默认值),则不会修改原始DataFrame,而是返回一个新的DataFrame,其索引已经被设置为指定的列。
# 替换掉温度的后缀℃
df.loc[:, "bWendu"] = df["bWendu"].str.replace("℃", "").astype('int32')
df.loc[:, "yWendu"] = df["yWendu"].str.replace("℃", "").astype('int32')
①df.loc[:, "bWendu"]:使用.loc[]方法选择DataFrame df 中所有行(:表示选择所有行)的 "bWendu" 列。.loc[] 是pandas中用于按标签索引选择数据的方法。
②df["bWendu"].str:访问 "bWendu" 列中的字符串方法(.str)。这允许我们对该列的每个元素应用字符串操作。
③.replace("℃", ""):在 "bWendu" 列的每个元素上调用.replace("℃", "")方法,这将所有的"℃"字符替换为空字符串(即移除"℃"字符)。
④.astype('int32'):将结果列的数据类型转换为32位整数(int32)。这是必要的步骤,因为原始的温度值包含"℃"字符,是字符串(str)类型的。在移除这些字符后,为了进行数值计算,需要将清理后的字符串转换为数值类型,这里选择的是int32。
总的来说,这行代码的作用是清理DataFrame df 中 "bWendu" 列的温度数据,去除温度单位,然后将这些温度值转换为整数形式,便于后续的数据分析或计算。
# 时间序列见后续课程,本次按字符串处理
df.index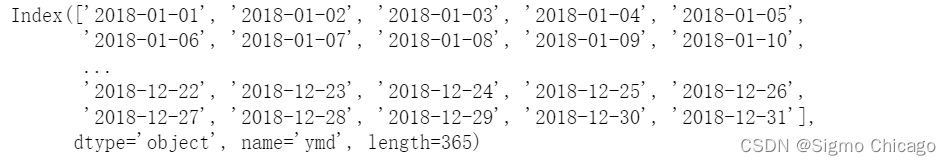
df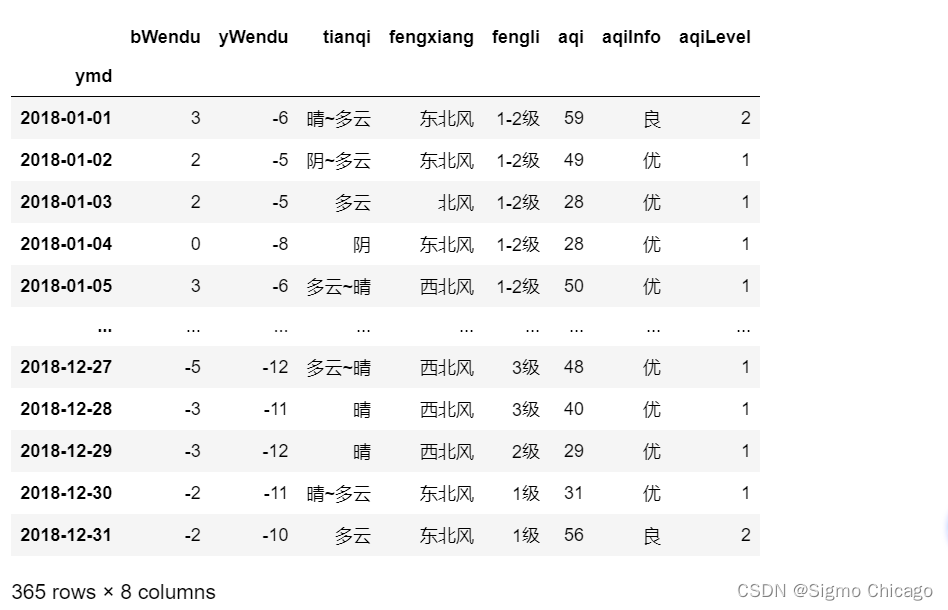
1、使用单个label值查询数据
行或者列,都可以只传入单个值,实现精确匹配
# 得到单个值
df.loc['2018-01-03', 'bWendu']
2
# 得到一个Series
df.loc['2018-01-03', ['bWendu', 'yWendu']]
bWendu 2 yWendu -5 Name: 2018-01-03, dtype: object
2、使用值列表批量查询
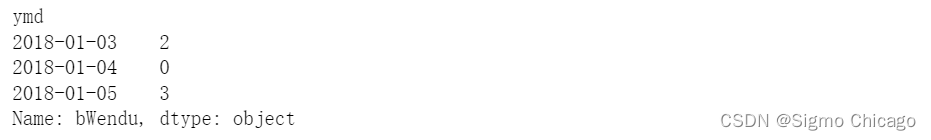
# 得到Series
df.loc[['2018-01-03','2018-01-04','2018-01-05'], 'bWendu']
# 得到DataFrame
df.loc[['2018-01-03','2018-01-04','2018-01-05'], ['bWendu', 'yWendu']]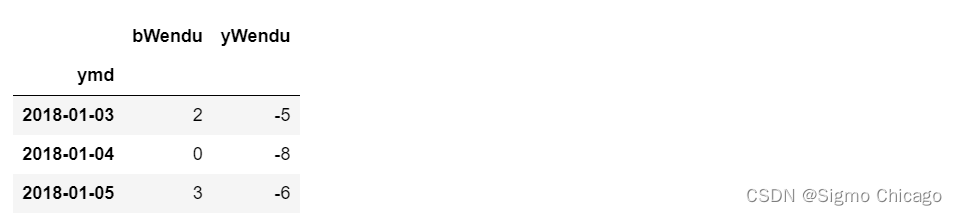
3、使用数值区间进行范围查询
注意:区间既包含开始,也包含结束
# 行index按区间
df.loc['2018-01-03':'2018-01-05', 'bWendu']
ymd 2018-01-03 2 2018-01-04 0 2018-01-05 3 Name: bWendu, dtype: object
# 列index按区间
df.loc['2018-01-03', 'bWendu':'fengxiang']
bWendu 2 yWendu -5 tianqi 多云 fengxiang 北风 Name: 2018-01-03, dtype: object
# 行和列都按区间查询
df.loc['2018-01-03':'2018-01-05', 'bWendu':'fengxiang']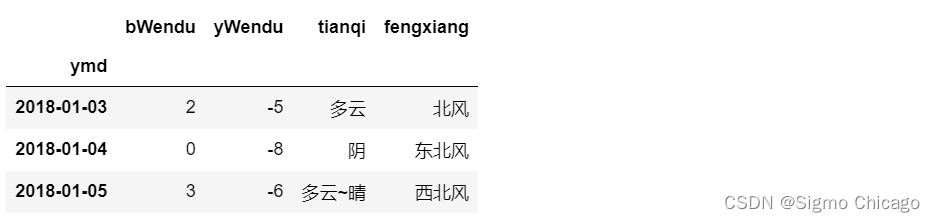
4、使用条件表达式查询
bool列表的长度得等于行数或者列数
4.1 简单条件查询,最低温度低于-10度的列表
df.loc[df["yWendu"]<-10, :]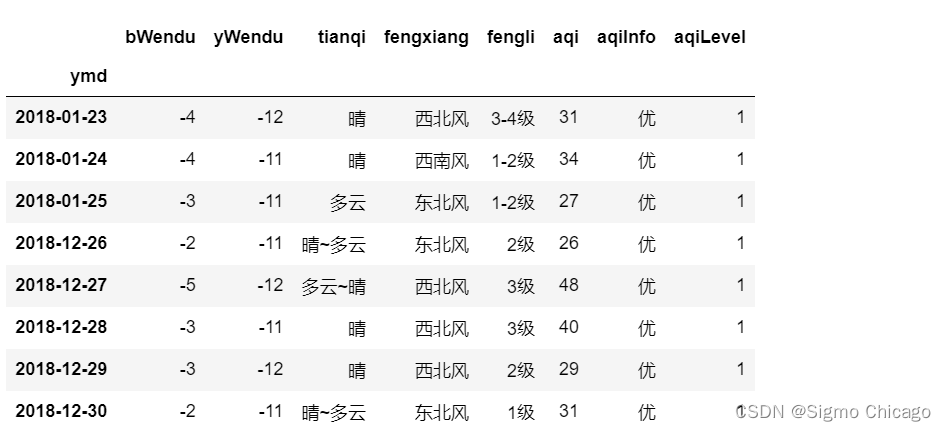
# 观察一下这里的boolean条件
df["yWendu"]<-10
ymd
2018-01-01 False
2018-01-02 False
2018-01-03 False
2018-01-04 False
2018-01-05 False
...
2018-12-27 True
2018-12-28 True
2018-12-29 True
2018-12-30 True
2018-12-31 False
Name: yWendu, Length: 365, dtype: bool
4.2 复杂条件查询,查一下我心中的完美天气
注意,组合条件用&符号合并,每个条件判断都得带括号
## 查询最高温度小于30度,并且最低温度大于15度,并且是晴天,并且天气为优的数据
df.loc[(df["bWendu"]<=30) & (df["yWendu"]>=15) & (df["tianqi"]=='晴') & (df["aqiLevel"]==1), :]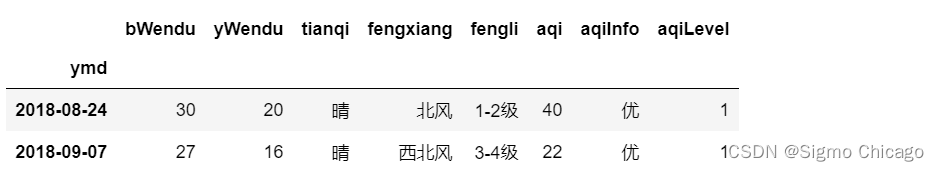
# 再次观察这里的boolean条件
(df["bWendu"]<=30) & (df["yWendu"]>=15) & (df["tianqi"]=='晴') & (df["aqiLevel"]==1)
ymd
2018-01-01 False
2018-01-02 False
2018-01-03 False
2018-01-04 False
2018-01-05 False
...
2018-12-27 False
2018-12-28 False
2018-12-29 False
2018-12-30 False
2018-12-31 False
Length: 365, dtype: bool
使用&运算符结合这两个条件,返回一个布尔Series,表示同时满足这两个条件的行。
5、调用函数查询
# 直接写lambda表达式
df.loc[lambda df : (df["bWendu"]<=30) & (df["yWendu"]>=15), :] 
# 编写自己的函数,查询9月份,空气质量好的数据
def query_my_data(df):
    return df.index.str.startswith("2018-09") & (df["aqiLevel"]==1)

df.loc[query_my_data, :]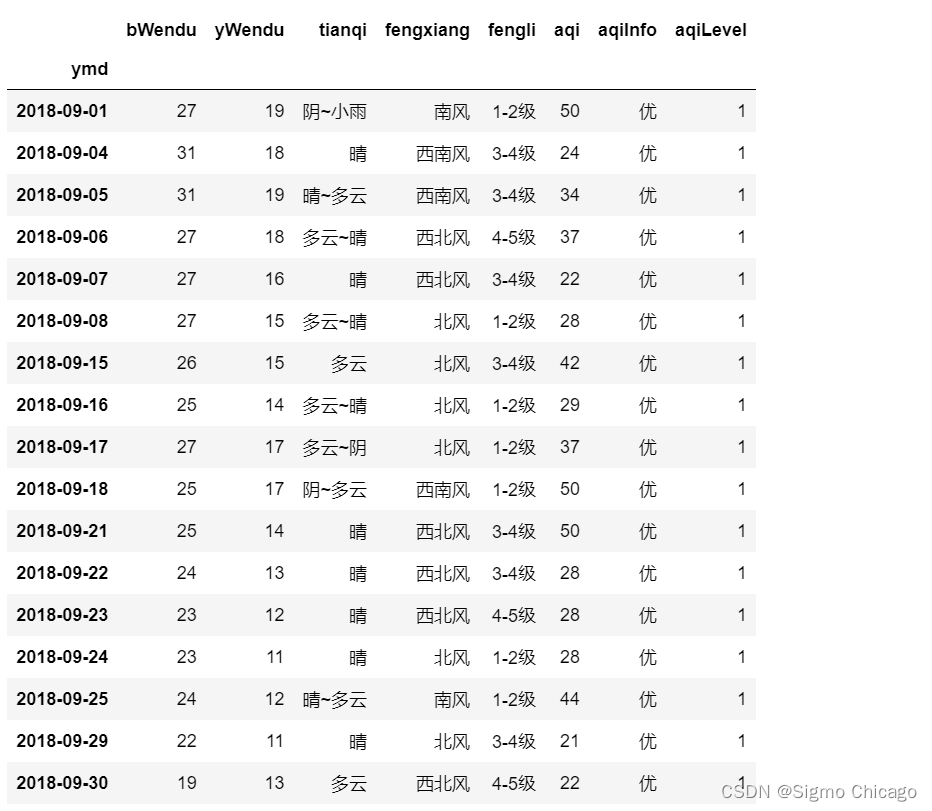
PS:插入一点关于字符串的小知识
字符串是由字符组成的序列,可以包含字母、数字、空格、符号等。str类型提供了许多用于操作这些字符序列的方法,如连接(拼接)、切片、替换、搜索等。字符串在Python编程中非常常用,用于处理文本信息,比如用户名、消息、文件内容等。
#拼接
greeting = 'Hello' + ' ' + 'world!'

#切片
s = 'Python'
sub_s = s[1:4]  # 'yth'

#替换
s = 'Hello, world!'
new_s = s.replace('world', 'Python')  # 'Hello, Python!'

#长度
length = len('Hello')  # 5

#多行字符串
multi_line_string = """This is a
multi-line string
example."""
#对于跨越多行的文本,可以使用三引号('''或""")来创建多行字符串:

#格式化字符串
name = 'Alice'
age = 30
greeting = f"Hello, {name}. You are {age} years old."
总结
提示:这里对文章进行总结:
例如:以上就是今天要讲的内容,本文仅仅简单介绍了pandas的数据查询,而pandas提供了大量能使我们快速便捷地处理数据的函数和方法。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 23
 0
- 0


 已为社区贡献8条内容

所有评论(0)