89 elasticsearch 数据同步与集群
elasticsearch 数据同步与集群
1 数据同步问题分析
elasticsearch中的酒店数据来自于mysql数据库,因此mysql数据发生改变时,elasticsearch也必须跟着改变,这个就是elasticsearch与mysql之间的数据同步。
在微服务中,负责酒店管理(操作mysql )的业务与负责酒店搜索(操作elasticsearch )的业务可能在两个不同的微服务上,数据同步该如何实现呢?
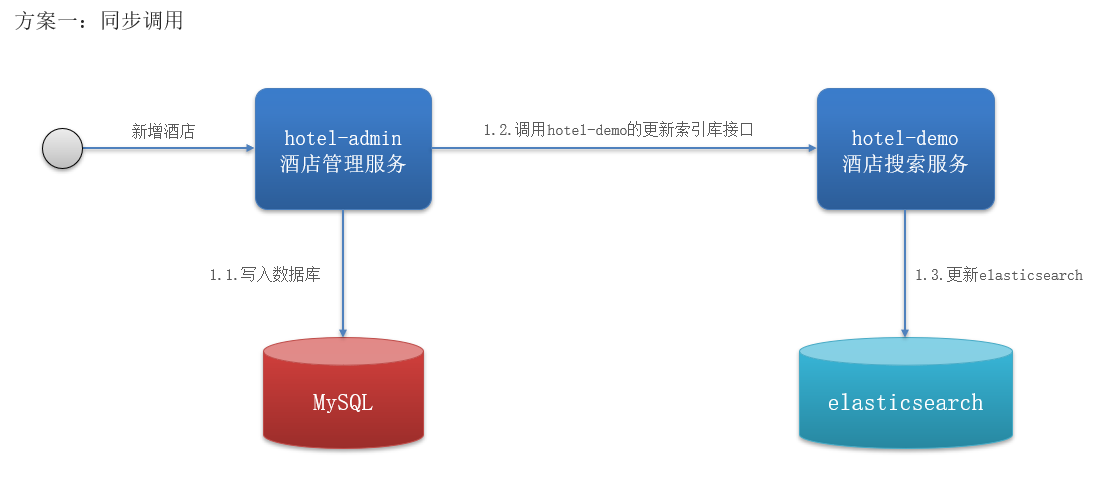
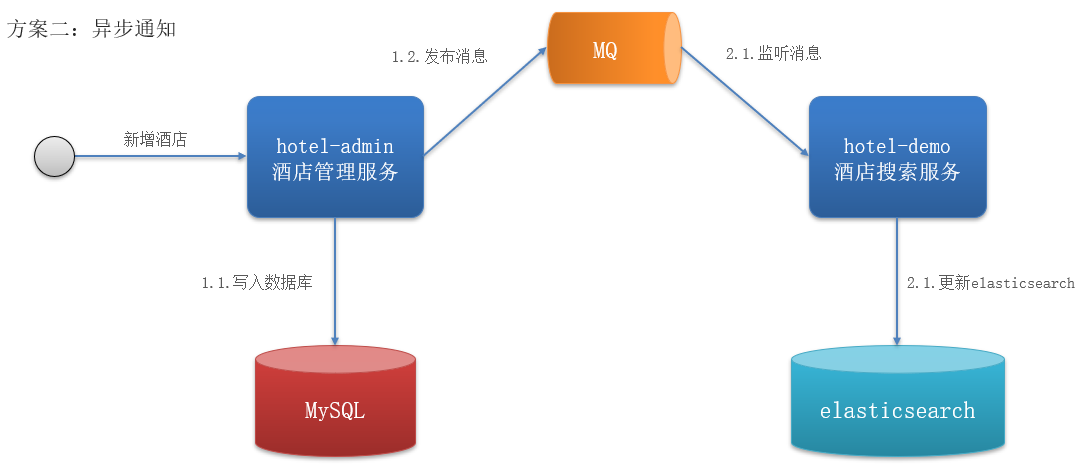
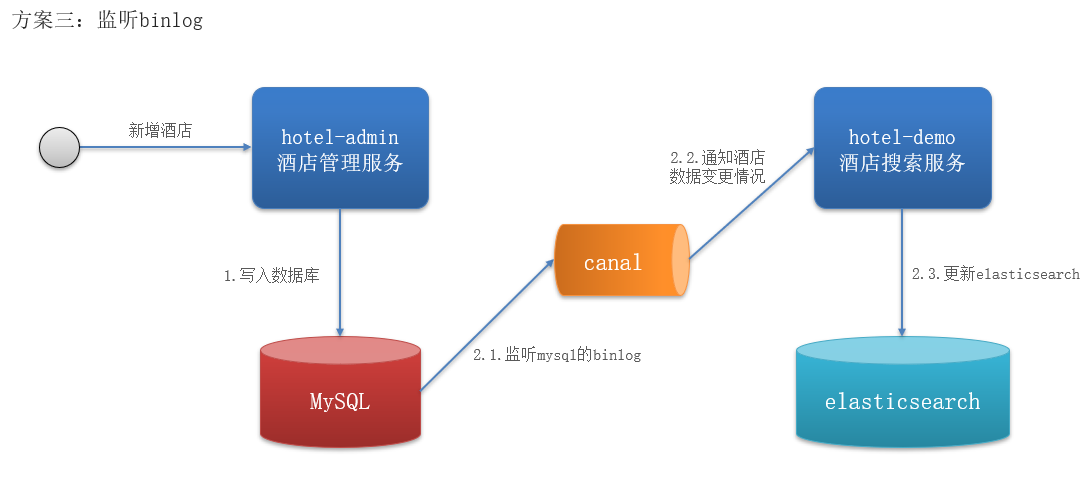
方式一:同步调用
优点:实现简单,粗暴
缺点:业务耦合度高
方式二:异步通知
优点:低耦合,实现难度一般
缺点:依赖mq的可靠性
方式三:监听binlog
优点:完全解除服务间耦合
缺点:开启binlog增加数据库负担、实现复杂度高
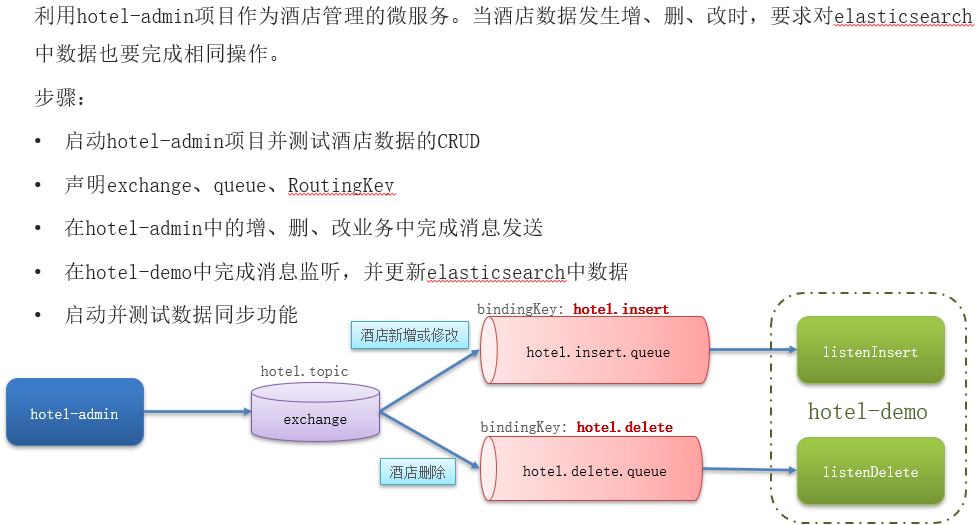
2 利用MQ实现mysql与elasticsearch数据同步
3 ES集群
3.1 ES集群结构
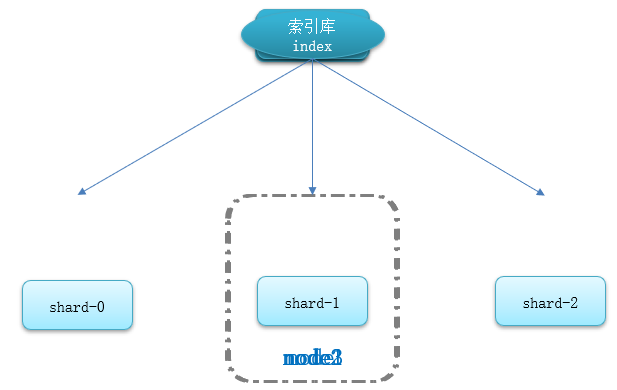
单机的elasticsearch做数据存储,必然面临两个问题:海量数据存储问题、单点故障问题。
海量数据存储问题:将索引库从逻辑上拆分为N个分片(shard),存储到多个节点
单点故障问题:将分片数据在不同节点备份(replica )
3.2搭建ES集群
每个索引库的分片数量、副本数量都是在创建索引库时指定的,并且分片数量一旦设置以后无法修改。语法如下:
PUT /itcast
{
  "settings": {
    "number_of_shards": 3, // 分片数量
    "number_of_replicas": 1 // 副本数量
  },
  "mappings": {
    "properties": {
      // mapping映射定义 ...
    }
  }
}
3.3 ES集群的节点角色
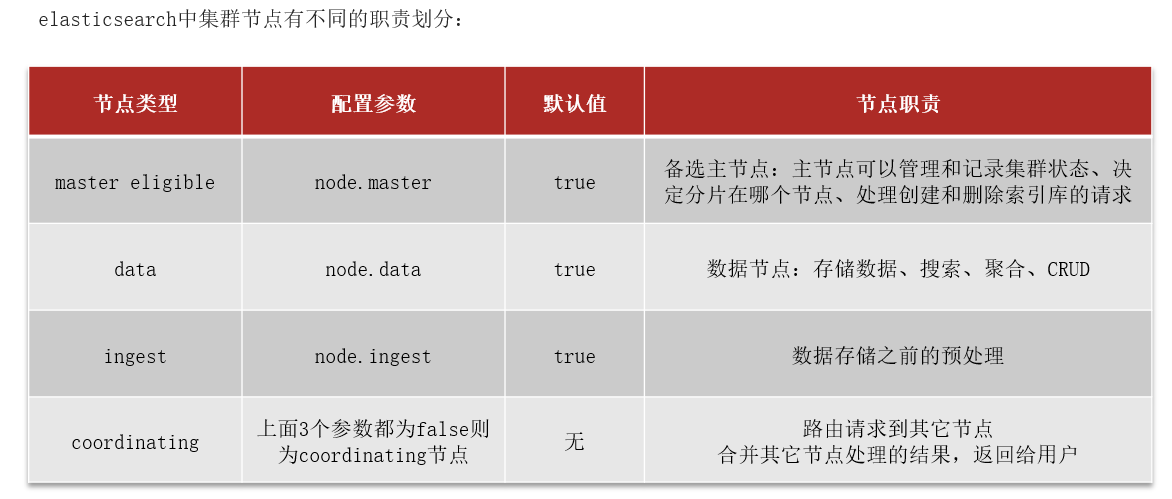
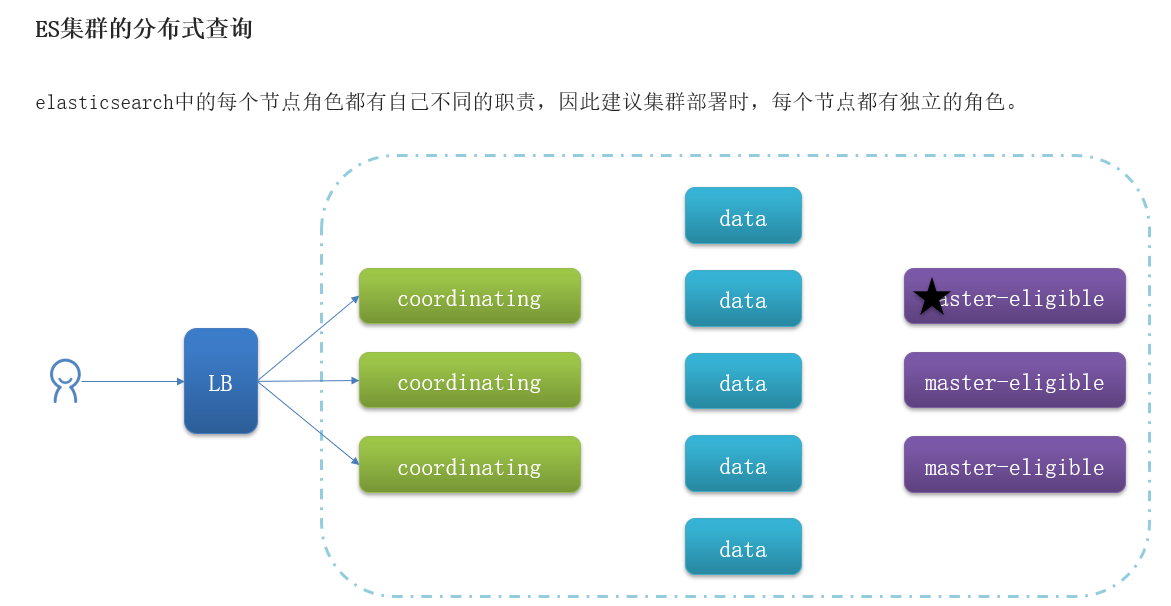
master eligible节点的作用是什么?
参与集群选主
主节点可以管理集群状态、管理分片信息、处理创建和删除索引库的请求
data节点的作用是什么?
数据的CRUD
coordinator节点的作用是什么?
路由请求到其它节点
合并查询到的结果,返回给用户
4 ES集群的分布式存储
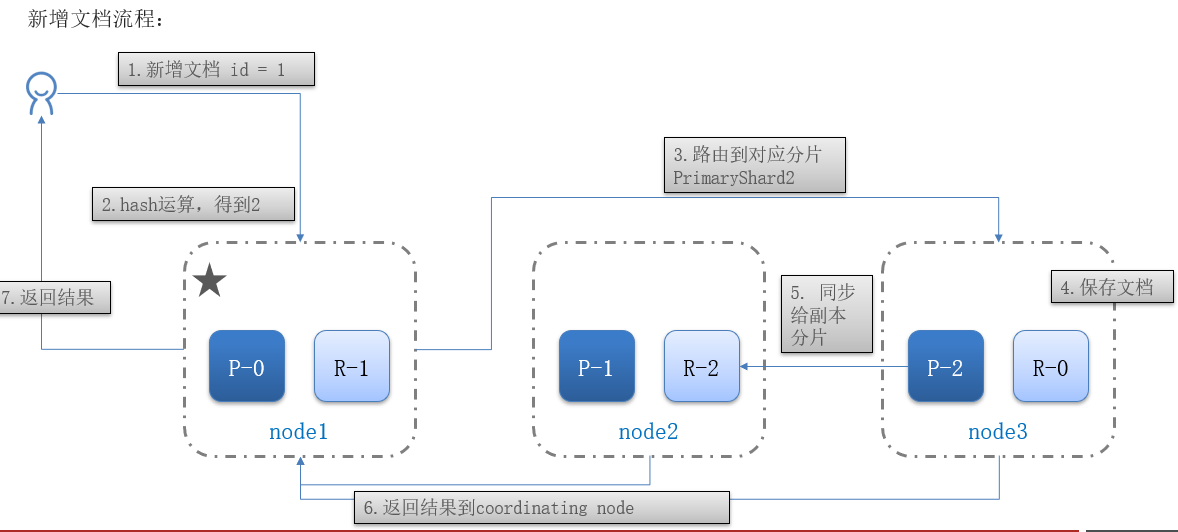
当新增文档时,应该保存到不同分片,保证数据均衡,那么coordinating node如何确定数据该存储到哪个分片呢?
elasticsearch会通过hash算法来计算文档应该存储到哪个分片:
shard = hash(_routing) % number_of_shards
说明:
_routing默认是文档的id
算法与分片数量有关,因此索引库一旦创建,分片数量不能修改!
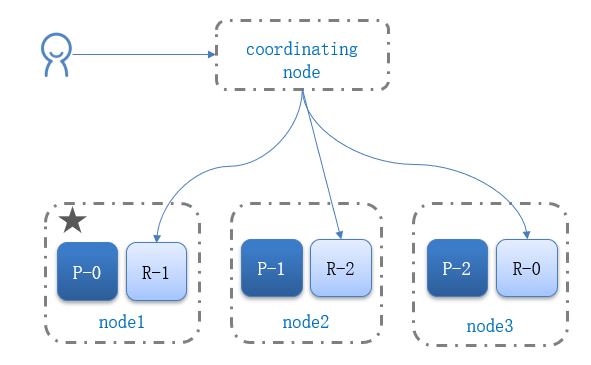
elasticsearch的查询分成两个阶段:
scatter phase:分散阶段,coordinating node会把请求分发到每一个分片
gather phase:聚集阶段,coordinating node汇总data node的搜索结果,并处理为最终结果集返回给用户
分布式新增如何确定分片?
coordinating node根据id做hash运算,得到结果对shard数量取余,余数就是对应的分片
分布式查询的两个阶段
分散阶段: coordinating node将查询请求分发给不同分片
收集阶段:将查询结果汇总到coordinating node ,整理并返回给用户
5 ES集群的故障转移
集群的master节点会监控集群中的节点状态,如果发现有节点宕机,会立即将宕机节点的分片数据迁移到其它节点,确保数据安全,这个叫做故障转移。
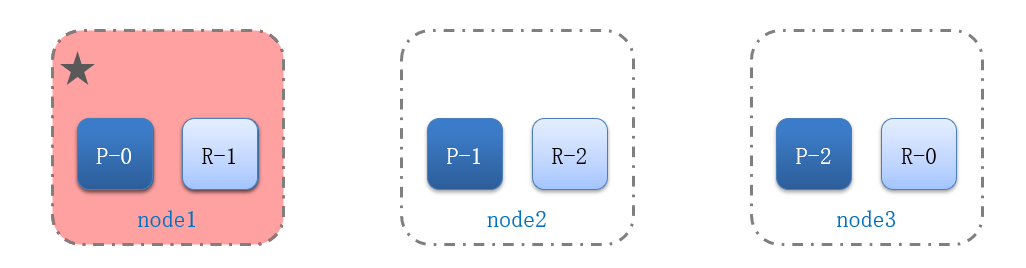
故障转移:
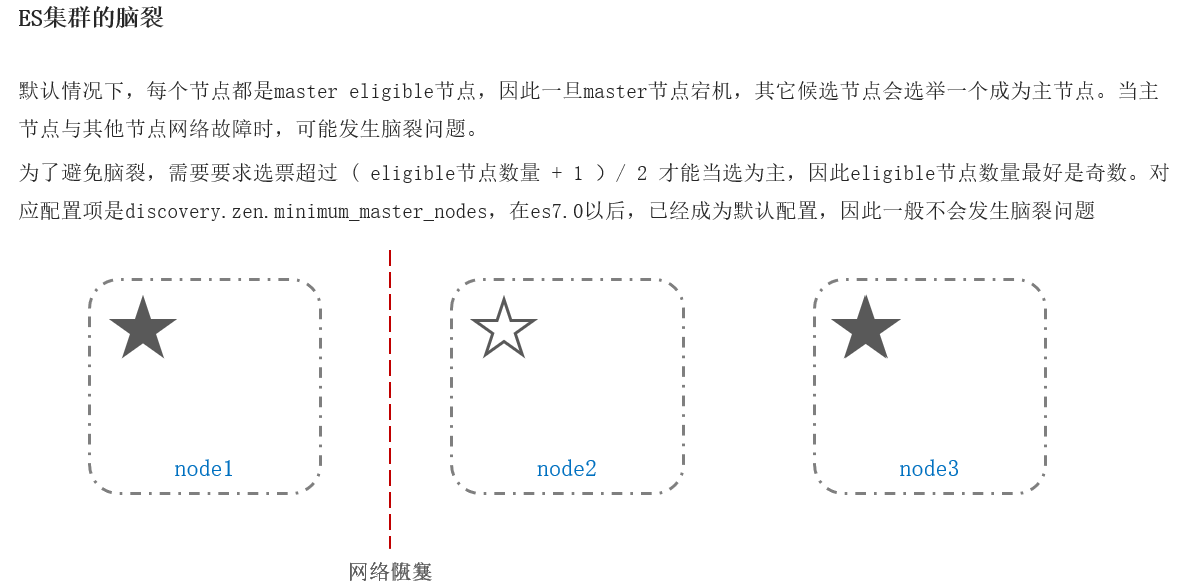
master宕机后,EligibleMaster选举为新的主节点。
master节点监控分片、节点状态,将故障节点上的分片转移到正常节点,确保数据安全。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献5条内容

所有评论(0)