洛谷 P8649 [蓝桥杯 2017 省 B] k 倍区间
·
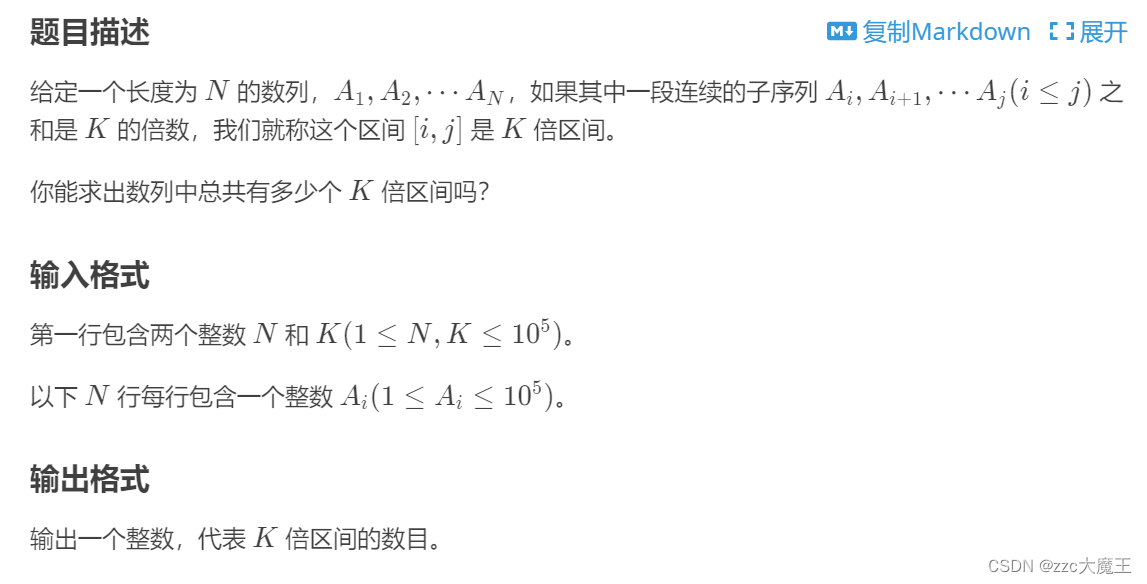
朴素算法枚举区间的两个端点,内部for求和,复杂度O(n^3),10^15数量级远大于题目所给的2s时间限制(默认1s 10^8计算量) 。
使用前缀和优化内部for求和
复杂度约O(n^2):10^10 > 10^8,大概也是超时
TLE代码(前缀和)28分
#include <bits/stdc++.h>
using namespace std;

long long n,k,a[100001],ans;

int main(){
    cin>>n>>k;
    for(int i=1;i<=n;++i){
        cin>>a[i];
        a[i]+=a[i-1];
    }

    for(int l=1;l<=n;++l)
        for(int r=l;r<=n;++r)
            if((a[r]-a[l-1])%k==0)
                ans++;

    cout<<ans;
    return 0;
}
一般遇到这种束手无测的情况,建议直接分析数学模型,算法的复杂度取决于数学模型。
例如问题:给你一个序列A,和常数K,求序列A中任选三个数相加和为常数K的所有方案数。
即:a+b+c=K
根据式子去枚举我们发现,复杂度为O(n^3)。
但是式子稍微变一下:a+b=K-c
就会变成,先把K-c的所有情况算出来,O(n)
a+b的所有情况算出来,O(n^2)
枚举式子a+b=K-c,O(n^2)
把变量平摊到等式两边,显然复杂度降低了一个指数级别。
原理:a+b+1,a+b+2,a+b一直在被重复计算,先把a+b算出来保留,那a+b就不会被计算n次,从而降低复杂度。(平摊等式两边变量,从而降低复杂度)
再看这道题,算法核心为:
(a[r]-a[l-1])%k==0
展开平摊变量得到:
a[r]%k==a[l-1]%k
显然题目变成了,如果有任意两个前缀和相同,那么累计一次。
但是我们这么枚举会发现,样例输出是4。
#include <bits/stdc++.h>
using namespace std;

long long n,k,a[100001],ans,t[100001];

int main(){
    cin>>n>>k;
    for(int i=1;i<=n;++i){
        cin>>a[i];
        a[i]+=a[i-1];
        a[i]%=k;
        ans+=t[a[i]]++;
    }

    cout<<ans;
    return 0;
}
此处是缺少计算所有情况,代码算的是任意2个前缀和的情况,即n>=2,但是也有可能存在只有1个前缀和就可以满足情况,即n==1。
显然对于n==1的情况必然是K的倍数,即t[0],输出加上即可。
AC代码
#include <bits/stdc++.h>
using namespace std;

long long n,k,a[100001],ans,t[100001];

int main(){
    cin>>n>>k;
    for(int i=1;i<=n;++i){
        cin>>a[i];
        a[i]+=a[i-1];
        a[i]%=k;
        ans+=t[a[i]]++;
    }

    cout<<ans+t[0];
    return 0;
}

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献9条内容

所有评论(0)