自动化测试框架Pytest介绍(6)——参数化
·
目录
在测试中我们会碰到测试流程相同,但是数据不同,从而实现不同的测试覆盖。而pytest中一个测试用例一般是用一套数据,而要实现不同数据运行相同的测试流程实现测试覆盖的目的,就要用到参数化了。
1、测试用例参数化
先看代码和运行结果
代码
from BaseLog import logger
import pytest

@pytest.mark.parametrize('data',("data1.1","data1.2","data1.3"))
def test_case1(data):
    #测试函数
    Expected = 2
    Actual = 2
    print("我是test_case1,传入参数:",data)
    assert Expected == Actual

if __name__ =="__main__":
    # -s:显示用例中的输出
    # -v:输出更详细的用例执行信息
    # __file__:本文件
    pytest.main(["-vs","BASE/file_test.py"])
运行结果
[Running] python -u "d:\Test\Android_Test\BASE\file_test.py"
============================= test session starts =============================
platform win32 -- Python 3.10.9, pytest-7.2.1, pluggy-1.0.0 -- D:\Python310\python.exe
cachedir: .pytest_cache
rootdir: d:\Test\Android_Test
plugins: rerunfailures-11.1.1, xdist-3.2.0
collecting ... collected 3 items

BASE/file_test.py::test_case1[data1.1] 我是test_case1,传入参数: data1.1
PASSED
BASE/file_test.py::test_case1[data1.2] 我是test_case1,传入参数: data1.2
PASSED
BASE/file_test.py::test_case1[data1.3] 我是test_case1,传入参数: data1.3
PASSED

======================== 3 passedin 0.04s =========================

[Done] exited with code=0 in 0.86 seconds
从上我们看出
1、参数化,只需要在测试用例前面装饰@pytest.mark.parametrize('data',("data1.1","data1.2","data1.3"))
2、装饰中的参数名必须是字符串,而参数要是列表或元祖
3、测试用例调用参数名直接用字符串中值做变量参数,两个必须相同
4、通过参数化,一组参数相当于一条用例,原来的一条用例利用参数化后就变成了3条用例
2、测试类参数化
如果要对测试类参数化,有如下几点要求
-
@pytest.mark.parametrize放在类的前面
-
类里面的用例不需要再装饰了,直接用类前面的装饰
-
类里的测试用例必须要调用在类前面装饰的参数名,否则会报错
代码如下
from BaseLog import logger
import pytest

# 在类前面做一次装饰
@pytest.mark.parametrize('data',("data1.1","data1.2","data1.3"))
class TestClass:
    # 在类里面的用例直接调用
    def test_case3(self,data):
        #测试函数
        Expected = 1
        Actual = 2
        print("在TestClass里面的test_case3,data = ",data)
        assert Expected != Actual

    # 在类里面的每个用例都要调用,否则会报错
    def test_case4(self,data):
        #测试函数
        Expected = 1
        Actual = 2
        print("在TestClass里面的test_case4,data = ",data)
        assert Expected <= Actual

if __name__ =="__main__":
    # -s:显示用例中的输出
    # -v:输出更详细的用例执行信息
    # __file__:本文件
    pytest.main(["-vs","BASE/file_test.py"])
运行结果
[Running] python -u "d:\Test\Android_Test\BASE\file_test.py"
============================= test session starts =============================
platform win32 -- Python 3.10.9, pytest-7.2.1, pluggy-1.0.0 -- D:\Python310\python.exe
cachedir: .pytest_cache
rootdir: d:\Test\Android_Test
plugins: rerunfailures-11.1.1, xdist-3.2.0
collecting ... collected 6 items

BASE/file_test.py::TestClass::test_case3[data1.1] 在TestClass里面的test_case3,data =  data1.1
PASSED
BASE/file_test.py::TestClass::test_case3[data1.2] 在TestClass里面的test_case3,data =  data1.2
PASSED
BASE/file_test.py::TestClass::test_case3[data1.3] 在TestClass里面的test_case3,data =  data1.3
PASSED
BASE/file_test.py::TestClass::test_case4[data1.1] 在TestClass里面的test_case4,data =  data1.1
PASSED
BASE/file_test.py::TestClass::test_case4[data1.2] 在TestClass里面的test_case4,data =  data1.2
PASSED
BASE/file_test.py::TestClass::test_case4[data1.3] 在TestClass里面的test_case4,data =  data1.3
PASSED

============================== 6 passed in 0.03s ==============================

[Done] exited with code=0 in 0.641 seconds
3、给参数用别名
当我们传入的参数很长,运行是会将传入参数展示就会显得很长。比较常见的是我们把用例的参数存在Excel文件中,然后转换成二位列表传入,此时用例里面的参数就会用传入变量加下标的形式展示。
from BaseLog import logger
import pytest

#@pytest.mark.parametrize('data',(("data1.1","data1.2","data1.3"),("data2.1","data2.2","data2.3")),ids=("case_data1","case_data2"))
# 数据是存在Excel表格中,转换成元组后当参数传入
@pytest.mark.parametrize('data',(("data1.1","data1.2","data1.3"),("data2.1","data2.2","data2.3","data2.4")))
def test_case1(data):
    #测试函数
    Expected = 2
    Actual = 2
    print("我是test_case1,传入参数:",data)
    assert Expected == Actual

# 传入的参数很长,而且有中文
@pytest.mark.parametrize('data',("我是传入的参数,我很长没有意义1","我是传入的参数,我很长没有意义2"))
def test_case2(data):
    #测试函数
    Expected = 1
    Actual = 2
    print("我是test_case2,传入参数:",data)
    assert Expected != Actual

if __name__ =="__main__":
    # -s:显示用例中的输出
    # -v:输出更详细的用例执行信息
    # __file__:本文件
    pytest.main(["-vs","BASE/file_test.py"])
运行结果如下
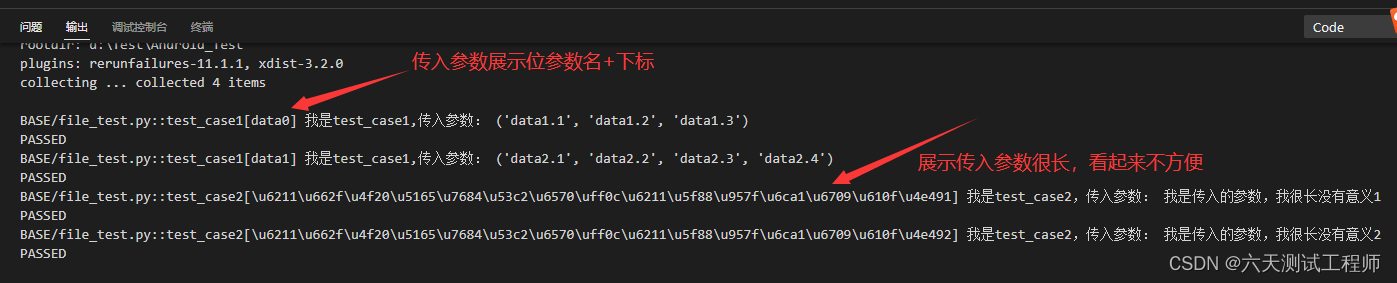
此时我们就可以用ids给参数取别名了。
ids参数有几个限制
1、必须跟前面参数中元素个数一致
2、类型是元组或列表
具体使用见代码
from BaseLog import logger
import pytest

#@pytest.mark.parametrize('data',(("data1.1","data1.2","data1.3"),("data2.1","data2.2","data2.3")),ids=("case_data1","case_data2"))
# 数据是存在Excel表格中,转换成元组后当参数传入
@pytest.mark.parametrize('data',(("data1.1","data1.2","data1.3"),("data2.1","data2.2","data2.3","data2.4")),ids=("case1_data1","case1_data2"))
def test_case1(data):
    #测试函数
    Expected = 2
    Actual = 2
    print("我是test_case1,传入参数:",data)
    assert Expected == Actual

# 传入的参数很长,而且有中文
@pytest.mark.parametrize('data',("我是传入的参数,我很长没有意义1","我是传入的参数,我很长没有意义2"),ids=("case2_data1","case2_data2"))
def test_case2(data):
    #测试函数
    Expected = 1
    Actual = 2
    print("我是test_case2,传入参数:",data)
    assert Expected != Actual

if __name__ =="__main__":
    # -s:显示用例中的输出
    # -v:输出更详细的用例执行信息
    # __file__:本文件
    pytest.main(["-vs","BASE/file_test.py"])
执行结果
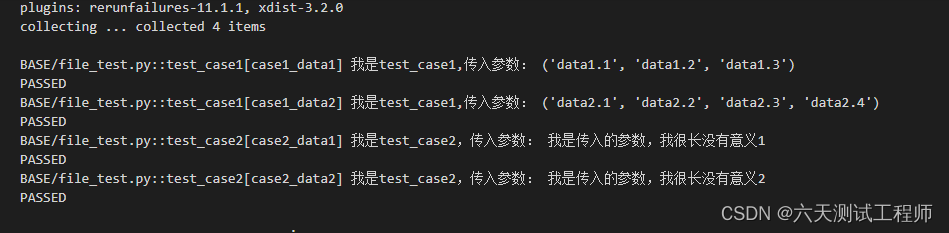
这样我们可以在存放数据的Excel表格中给每一行数据取一个有意义的别名,然后将这一列数据提取成列表当ids参数传入

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献6条内容

所有评论(0)