第四部分 数据结构-查找和排序
查找
顺序查找
顺序查找是一种最简单的线性查找方法。其基本思想是:从表的一端开始,顺序扫描线性表,依次将扫描到的关键字和给定值k相比较,若当前扫描到的关键字与k相等,则查找成功;若扫描结束后,仍未找到关键字等于k的记录,则查找失败。
代码如下:
//顺序查找——返回目标数的下标,若未查到则返回-1
int SortFind(int nums[],int n,int goal){    //n:数组长度
    int i;
    for(i=0;i<n;i++){
        if(nums[i] == goal)
            return i;
    }
    return -1;
}
二分查找(折半查找)
//二分查找——用于顺序表查找
//递归实现
int Dichotomy(int nums[],int goal,int low,int heigh){
    if(low > heigh)
        return -1;
    int middle = (low+heigh)/2;
    if(nums[middle] < goal){
        return Dichotomy(nums,goal,middle+1,heigh);
    }else if(nums[middle] >goal){
        return Dichotomy(nums,goal,low,middle-1);
    }else{
        return middle;
    }
}
//非递归实现
int BinarySerch(int nums[],int n,int goal){
    int low=0;int heigh=n;
    int middle;
    while(low <= heigh){
        middle = (low+heigh)/2;
        if(nums[middle] >goal){
            heigh = middle-1;
        }else if(nums[middle] < goal){
            low = middle+1;
        }else{
            return middle;
        }
    }
    return -1;
}
分块查找
基本思想
分块查找,也叫索引顺序查找,算法实现除了需要查找表本身之外,还需要根据查找表建立一个索引表。如图:
,给定一个查找表,其对应的索引表如图所示:
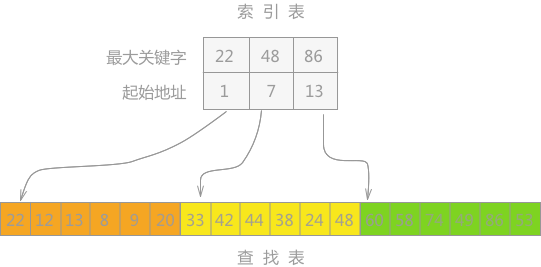
图中,查找表中共 18 个查找关键字,将其平均分为 3 个子表,对每个子表建立一个索引,索引中包含中两部分内容:该子表部分中最大的关键字以及第一个关键字在总表中的位置,即该子表的起始位置。
建立的索引表要求按照关键字进行升序排序,查找表要么整体有序,要么分块有序。
分块有序指的是第二个子表中所有关键字都要大于第一个子表中的最大关键字,第三个子表的所有关键字都要大于第二个子表中的最大关键字,依次类推。
分块查找的具体实现:
所有前期准备工作完成后,开始在此基础上进行分块查找。分块查找的过程分为两步进行:
-
确定要查找的关键字可能存在的具体块(子表);
-
在具体的块中进行顺序查找。
以图1中的查找表为例,假设要查找关键字 38 的具体位置。首先将 38 依次和索引表中各最大关键字进行比较,因为 22 < 38 < 48,所以可以确定 38 如果存在,肯定在第二个子表中。
由于索引表中显示第二子表的起始位置在查找表的第 7 的位置上,所以从该位置开始进行顺序查找,一直查找到该子表最后一个关键字(一般将查找表进行等分,具体子表个数根据实际情况而定)。结果在第 10 的位置上确定该关键字即为所找。
提示:在第一步确定块(子表)时,由于索引表中按照关键字有序,所有可以采用折半查找算法。而在第二步中,由于各子表中关键字没有严格要求有序,所以只能采用顺序查找的方式。
性能分析:
分块查找的平均查找长度等于索引查找和块内查找的平均长度之和。若索引查找采用折半查找,则总的平均查找长度为:
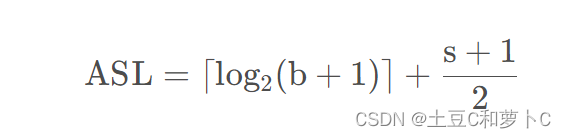
其中,b,s分别表示,将查找表均匀分成b份,每份s个记录。
二叉查找树和平衡二叉树
二叉查找树
定义
二叉查找树(又称二叉排序树),可以为一颗空树,非空则需要满足如下性质:
-
若左子树非空,则左子树上的所有结点的值均小于根结点的值;
-
若右子树非空,则右子树上的所有结点的值均大于根结点的值;
-
左右子树也分别是一颗二叉排序树。
根据二叉排序树的定义,左子树结点值 < 根结点值 < 右子树结点值,所以对其进行中序遍历可以得到一个递增的有序序列。
时间复杂度O(log n)
实现方法
//二叉查找树查询
Node* balanceSearch(Node *root,int goal){
Node *P = root;
while(P != NULL){
if(P->data == goal){
return P;
}else{
if(P->data > goal){
P = P->LChildren;
}else{
P = P->RChildren;
}
}
}
return NULL;
}
//删除指定结点
//找到左子树中的最大值,找到之后并将其删除
int findLeftMax(Node *left){
if(left == NULL){
return 0;
}
//左子树只有一个结点,返回他的值,并置空
if(left->LChildren==NULL && left->RChildren==NULL) {
int data = left->data;
free(left);
left = NULL;
return data;
}
//左子树的右子树为空,则左子树的最大结点则为左孩子
if(left->RChildren == NULL){
int data = left->data;
left = left->LChildren;
return data;
}
//有右孩子,则其最大值包含在右孩子中,则直接递归使用该函数即可
return findLeftMax(left->RChildren);
}
//二叉查找树删除结点——删除值域为goal的结点
Node* del(Node *root,int goal){
//查找目标结点
if(root == NULL){
return root;
}
if(root->data > goal){
root->LChildren = del(root->LChildren,goal);
return root;
}
if(root->data < goal){
root->RChildren = del(root->RChildren,goal);
return root;
}
//找到后开始删除
if(root->LChildren==NULL && root->RChildren==NULL){ //待删结点为叶子节点
free(root);
root = NULL;
return root;
}
if(root->LChildren == NULL){ //待删结点只有右孩子
root = root->RChildren;
return root;
}
if(root->RChildren == NULL){ //待删结点只有左孩子
root = root->LChildren;
return root;
}
//最后一种可能,待删结点左右孩子都有,则获取左孩子中的最大值,直接将该值赋给待删除位置的结点
int data = findLeftMax(root->LChildren);
root->data = data;
return root;
}
//插入较为简单,只需比较找到待插入的叶节点位置直接插入即可(插入都放在叶节点位置)。
平衡二叉树
定义
满足以下条件即为平衡二叉树:
-
是一颗二叉查找树。
-
每个节点的左子树和右子树的高度差不超过1。

图一中左边二叉树的节点45的左孩子46比45大,不满足二叉搜索树的条件,因此它也不是一棵平衡二叉树。 右边二叉树满足二叉搜索树的条件,同时它满足条件二,因此它是一棵平衡二叉树。

左边二叉树的节点45左子树高度2,右子树高度0,左右子树高度差为2-0=2,不满足条件二; 右边二叉树的节点均满足左右子树高度差至多为1,同时它满足二叉搜索树的要求,因此它是一棵平衡二叉树。
平衡二叉树的查找、插入、删除操作在平均和最坏的情况下都是O(logn)
实现方法
查找:和二叉查找树的查找方法一样。
插入:由于在执行插入操作之后仍要保持该树仍为一颗平衡二叉树,在按照二叉排序树的插入方法基础上,插入后可能破坏了平衡性(即,某些结点的左右子树高度差大于了1),就要对其进行调整,使其恢复平衡,方法如下(所谓LR是以从下往上第一个不平衡的结点为参照确定的):
-
LL型调整:
由于在A的左孩子(L)的左子树(L)上插入新结点,使原来平衡二叉树变得不平衡,此时A的平衡因子由1增至2。下面图1是LL型的最简单形式。显然,按照大小关系,结点B应作为新的根结点,其余两个节点分别作为左右孩子节点才能平衡,A结点就好像是绕结点B顺时针旋转一样。

LL型调整的一般形式如下图2所示,表示在A的左孩子B的左子树BL(不一定为空)中插入结点(图中阴影部分所示)而导致不平衡( h 表示子树的深度)。这种情况调整如下:①将A的左孩子B提升为新的根结点;②将原来的根结点A降为B的右孩子;③各子树按大小关系连接(BL和AR不变,BR调整为A的左子树)。


-
RR型调整:
由于在A的右孩子(R)的右子树(R)上插入新结点,使原来平衡二叉树变得不平衡,此时A的平衡因子由-1变为-2。图3是RR型的最简单形式。显然,按照大小关系,结点B应作为新的根结点,其余两个节点分别作为左右孩子节点才能平衡,A结点就好像是绕结点B逆时针旋转一样。

RR型调整的一般形式如下图4所示,表示在A的右孩子B的右子树BR(不一定为空)中插入结点(图中阴影部分所示)而导致不平衡( h 表示子树的深度)。这种情况调整如下:
将A的右孩子B提升为新的根结点;
将原来的根结点A降为B的左孩子
各子树按大小关系连接(AL和BR不变,BL调整为A的右子树)。


-
LR型调整
由于在A的左孩子(L)的右子树(R)上插入新结点,使原来平衡二叉树变得不平衡,此时A的平衡因子由1变为2。图5是LR型的最简单形式。显然,按照大小关系,结点C应作为新的根结点,其余两个节点分别作为左右孩子节点才能平衡。

LR型调整的一般形式如下图6所示,表示在A的左孩子B的右子树(根结点为C,不一定为空)中插入结点(图中两个阴影部分之一)而导致不平衡( h 表示子树的深度)。这种情况调整如下:①将B的左孩子C提升为新的根结点;②将原来的根结点A降为C的右孩子;③各子树按大小关系连接(BL和AR不变,CL和CR分别调整为B的右子树和A的左子树)。


-
RL型调整:
由于在A的右孩子(R)的左子树(L)上插入新结点,使原来平衡二叉树变得不平衡,此时A的平衡因子由-1变为-2。图7是RL型的最简单形式。显然,按照大小关系,结点C应作为新的根结点,其余两个节点分别作为左右孩子节点才能平衡。

RL型调整的一般形式如下图8所示,表示在A的右孩子B的左子树(根结点为C,不一定为空)中插入结点(图中两个阴影部分之一)而导致不平衡( h 表示子树的深度)。这种情况调整如下:①将B的左孩子C提升为新的根结点;②将原来的根结点A降为C的左孩子;③各子树按大小关系连接(AL和BR不变,CL和CR分别调整为A的右子树和B的左子树)。


平衡二叉树实现的实例
选取一组数据分别为2,1,0,3,4,5,6,9,8,7的10个结点来构造平衡二叉树。
-
首先数据为2的结点作为根结点插入,接着插入1,仍是平衡的,再插入0是,2的平衡因子变为2,此时出现了不平衡,因此需要进行调整,最低不平衡结点为2,属于LL型,调整过程如图所示。

-
接着插入3,是平衡的,再插入4,此时出现了不平衡,结点 1 和 2 的平衡因子都为 -2,结点2为最低不平衡结点,属于RR型,调整过程如图2所示

-
接着插入5,此时结点 1 的平衡因子为 -2,导致不平衡,结点1为最低不平衡结点,属于RR型,调整如图3所示。

-
接着插入6,此时结点4的平衡因子为 -2,导致不平衡,结点4为最低不平衡结点,属于RR型,调整如图4所示。

-
接着插入9,是平衡的,再插入8,此时结点 3、5、6 的平衡因子都为 -2,导致不平衡,结点6为最低不平衡结点,属于RL型,调整如图5所示。

-
插入7,此时结点3、5的平衡因子为 -2,导致不平衡,最低不平衡结点为5,属于RL型,调整如图6所示。

删除
-
被删除的节点为叶子节点,就找到了要删除的节点
-
被删除的节点为只有一棵子树的节点就找到了要删除的节点【也就是被删的结点只有左子树或只有右子树】
-
被删除的节点既有左子树,又有右子树
我们需要知道这么一点,左子树上节点的删除相当于我们在右子树上插入了一个新节点,右子树上节点的删除相当于在左子树上插入了一个新节点,根据这一点,我们进行判断并采取对应的平衡调整操作。
哈希表
概念
-
哈希函数(散列函数):一个能够把关键字映射成该关键字在查找表中的地址的函数,记为:Hash(key) = Addr(这里的地址可以是数组下标、索引或内存地址等)
-
冲突:哈希函数可能会把不同关键字映射到同一地址,这种情况称之为冲突,这些发生碰撞的关键字称之为同义词。
-
散列表:根据关键字直接进行访问的数据结构。也就是说,散列表建立了关键字和存储地址之间的一种直接映射关系。理想情况下,对散列表查找的时间复杂度为O(1)(根据关键字直接获得映射地址),与表中元素个数无关。
构造方法和原则
在构造散列函数时,必须注意以下几点:
散列函数的定义域必须包含全部需要存储的关键字,值域的范围则依赖于散列表的大小或地址范围。
散列函数计算出来的地址应该是能等概率的、均匀的分布在整个空间,从而减少冲突的发生。
散列函数应尽量简单,能够在较短的时间内计算出任意关键字对应的散列地址。
介绍几种常用的散列函数:
-
直接定址法
取关键字的某个线性函数值为散列地址,散列函数为 H(key)=key或H(key)=a*key+b,(a、b是常数)。此方法计算最简单,且不会产生冲突(联想数学里的y(x)函数,每个x仅有一个y与之对应),该方法是适用于关键字分布基本连续的情况,若关键字分布不连续,空位较多,则会造成空间浪费。
-
除留余数法
这是一种最简单、最常用的方法。取关键字被某个不大于散列表表长m的数p除后所得的余数为散列地址。即 H(key) = key %p,p<=m。
除此之外还有数字分析法、平方取中法等。
冲突解决
任何设计的散列函数都不能绝对地避免冲突。为此,必须考虑在发生冲突时应该如何处理,即为产生冲突的关键字寻找下一个“空”的Hash地址。
-
开放定址法
H(key)=(H(key)+ di)MOD m(其中 m 为哈希表的表长,di 为一个增量,i=0,1,2,····,k(k<=m-1))
当得出的哈希地址产生冲突时,选取以下 4种方法中的一种获取 d 的值,然后继续计算,直到计算出的哈希地址不在冲突为止,这 3 种方法为:
-
线性探测法:di=0,1,2,3,…,m-1
-
二次探测法:di=0²,1²,-1²,2²,-2²,3²,…k²,-k²
-
双散列法:使用另一个散列函数获得地址增量。di=Hash₂(key)
-
伪随机数探测法:d=伪随机数
-
拉链法
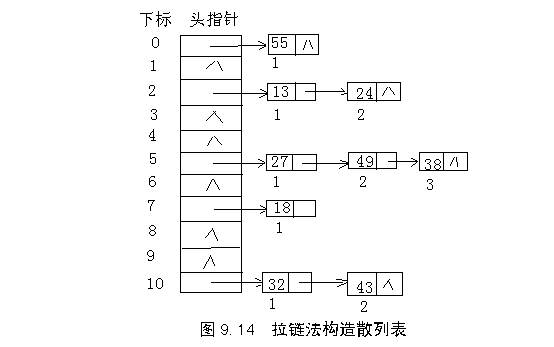
把具有相同散列地址的关键字(同义词)值放在同一个单链表中,称为同义词链表。有m个散列地址就有m个链表,同时用指针数组T[0..m-1]存放各个链表的头指针,凡是散列地址为i的记录都以结点方式插入到以T[i]为指针的单链表中。T中各分量的初值应为空指针。
例如:查找表包含55,13,24,27,49,38,18,32,43。使用除留余数法获得映射地址,具有相同映射地址的关键字挂载到同一·指针后面,如图所示:
排序
1.0 十大经典排序算法 | 菜鸟教程 (runoob.com)
插入排序
-
算法步骤
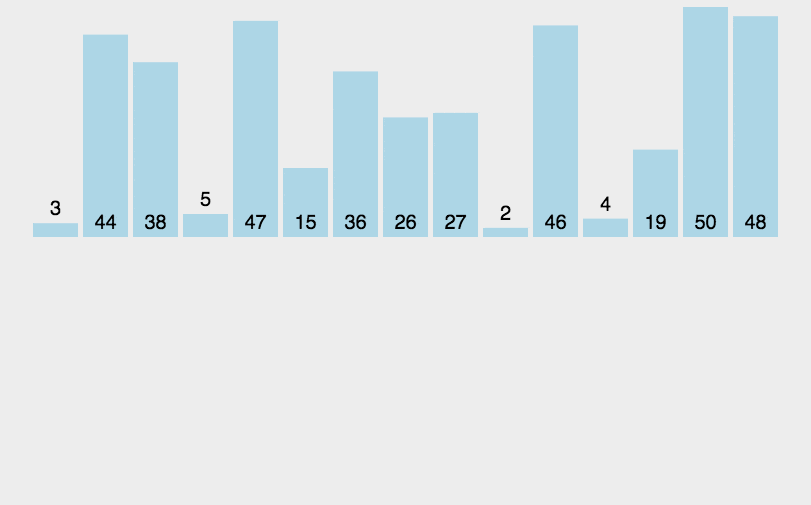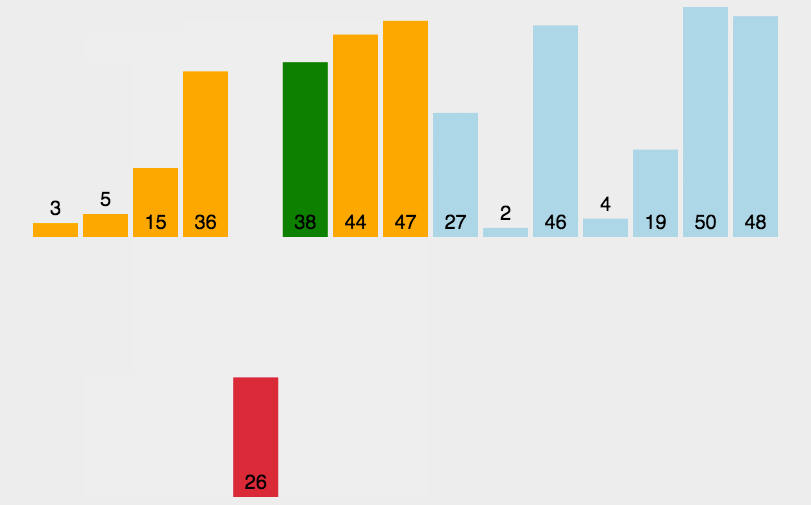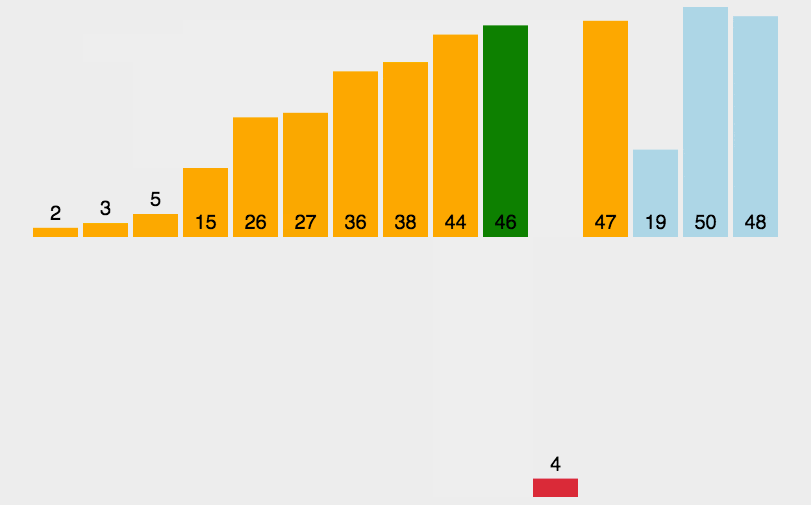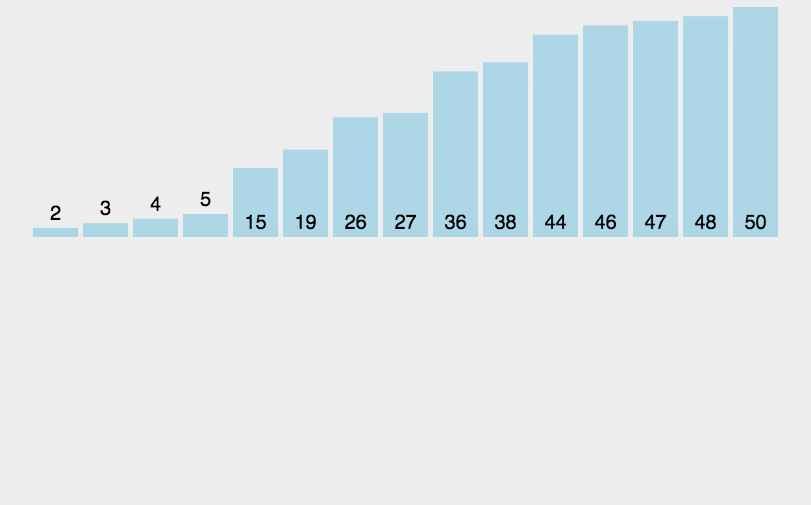
将第一待排序序列第一个元素看做一个有序序列,把第二个元素到最后一个元素当成是未排序序列。
从头到尾依次扫描未排序序列,将扫描到的每个元素插入有序序列的适当位置。(如果待插入的元素与有序序列中的某个元素相等,则将待插入元素插入到相等元素的后面。)
-
动图演示
-
代码实现
//插入排序
void InsertSort(int *nums,int length){
    int i;
    //每次循环使前i个数有序
    for(i=1;i<length;i++){
        int j,temp;
        //拿第i个数与他之前的i-1个数从后往前依次对比
        for(j=i-1;j>=0;j--){
            //若他的前一个数大于他,则nums[j]与nums[j+1]交换位置,并继续与前面的依次对比
            if(nums[j] > nums[j+1]){
                temp = nums[j+1];
                nums[j+1] = nums[j];
                nums[j] = temp;
            }else{//直到遇到一个比他小或相等的数,终止本次循环(即原数列第i个数已找到位置,前i个已有序)
                break;  //跳出本次循环
            }
        }
    }
}
选择排序
-
算法步骤
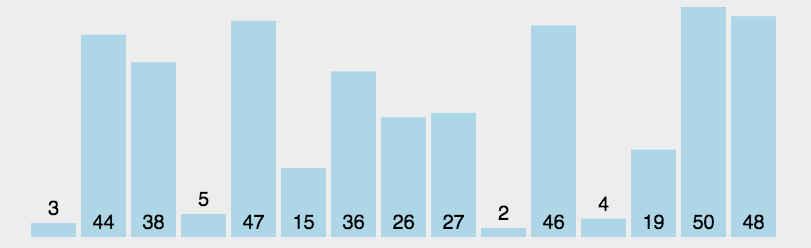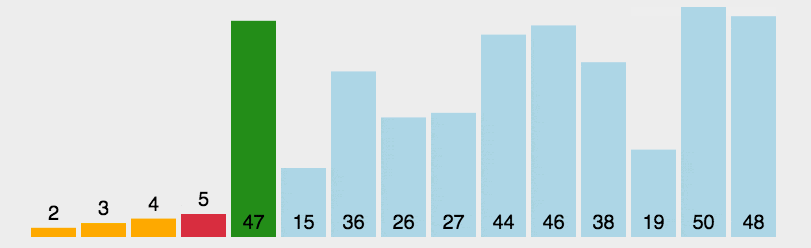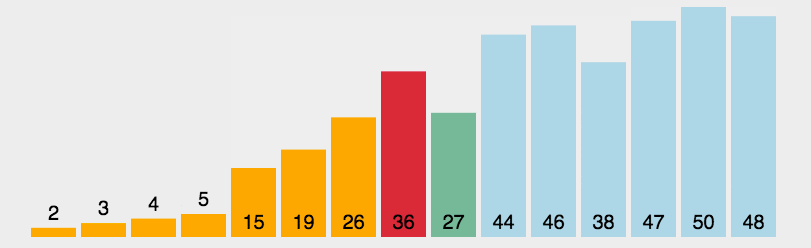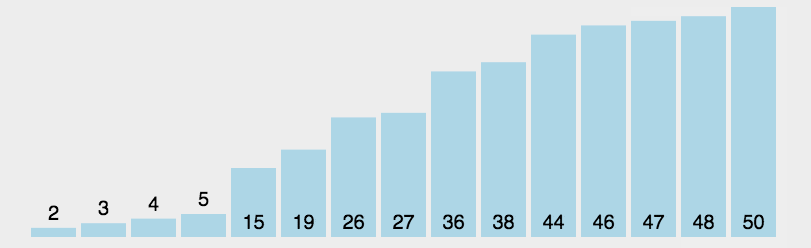
首先在未排序序列中找到最小(大)元素,存放到排序序列的起始位置。
再从剩余未排序元素中继续寻找最小(大)元素,然后放到已排序序列的末尾。
重复第二步,直到所有元素均排序完毕。
-
图画演示
-
代码实现
//选择排序 (升序)
void selectSort(int nums[],int length){
    //循环length次,每次在未排序的队列中知道到一个最小的与未排序部分的第一个交换位置
    int start;  //记录无序部分的开始下标 ,初始为0
    for(start=0;start<length;start++){
        int i,min=start;    //记录未排序部分最小数的下标
        int temp;           //临时数,用于交换时周转
        for(i=start+1;i<length;i++){
            //遇到比min小的数时,更新min
            if(nums[i] < nums[min]){
                min = i;
            }
        }
        //最后将min位置的数与未排序部分的第一个数(start位置)交换
        temp = nums[start];
        nums[start] = nums[min];
        nums[min] = temp;
    }
}
冒泡排序
-
算法步骤
比较相邻的元素。如果第一个比第二个大,就交换他们两个。
对每一对相邻元素作同样的工作,从开始第一对到结尾的最后一对。这步做完后,最后的元素会是最大的数。
针对所有的元素重复以上的步骤,除了最后一个。
持续每次对越来越少的元素重复上面的步骤,直到没有任何一对数字需要比较。
-
图画演示
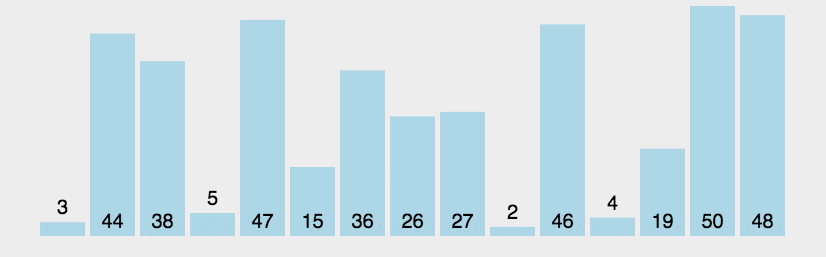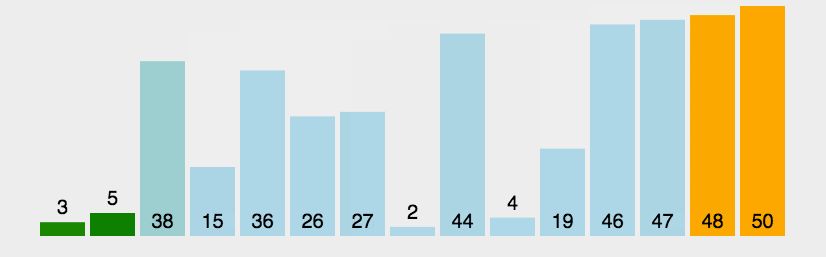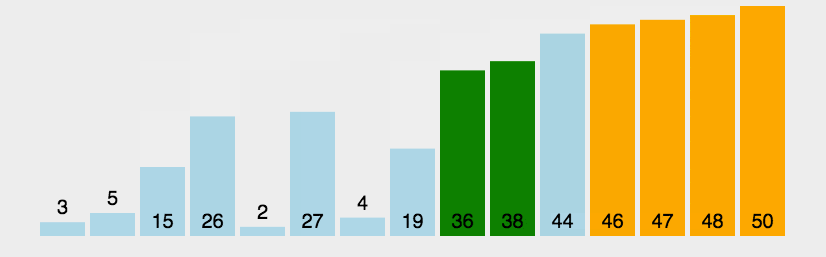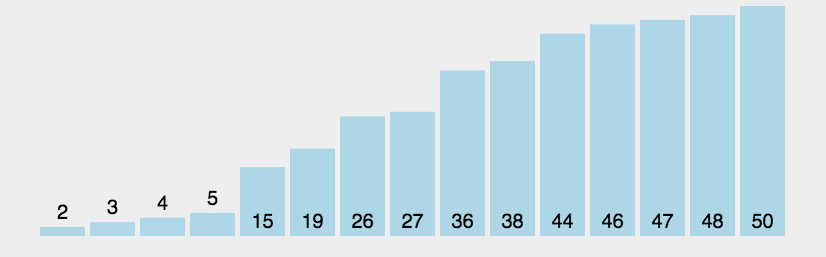
-
代码实现
//冒泡排序
void oO(int *nums,int length){
    //冒泡排序,从左至右依次两两对比,较大的往后放,每次循环可确定一个最大值并将其放后面
    int end;    //未排序部分的最后一个位置 ,初始为length
    for(end=length;end>0;end--){
        int i,temp;
        for(i=0;i<end-1;i++){
            if(nums[i] > nums[i+1]){    //前者比后者大,则交换位置
                temp = nums[i];
                nums[i] = nums[i+1];
                nums[i+1] = temp;
            }
        }
    }
}
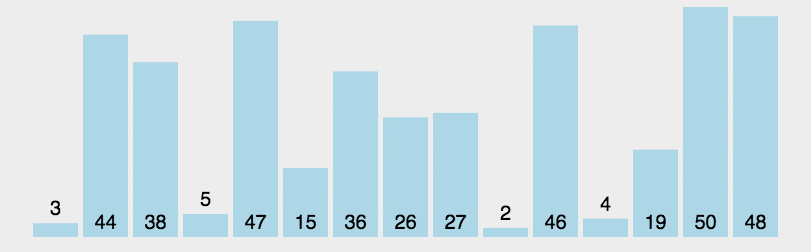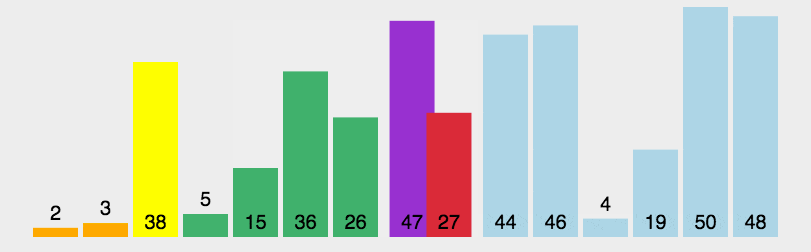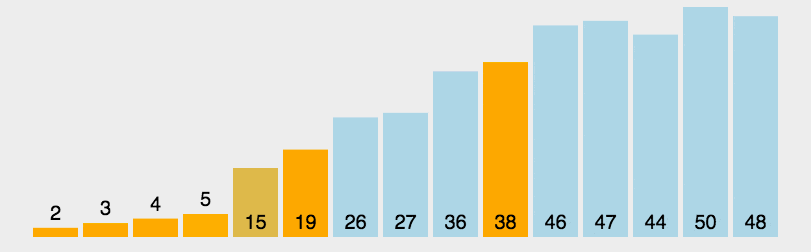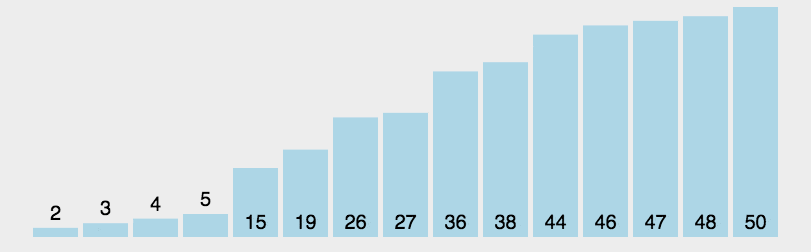
快速排序
-
算法步骤
-
从数列中挑出一个元素,称为 "基准"(pivot);
-
重新排序数列,所有元素比基准值小的摆放在基准前面,所有元素比基准值大的摆在基准的后面(相同的数可以到任一边)。在这个分区退出之后,该基准就处于数列的中间位置。这个称为分区(partition)操作;
-
递归地(recursive)把小于基准值元素的子数列和大于基准值元素的子数列排序;
-
-
图画演示
-
代码实现
//将区间第一个元素当作基准,划分为左右两个区间,返回最终基准元素的位置 int Partition(int A[],int low,int high){ int pivot = A[low]; //将区间第一个元素作为比较基准 while(low<high){ while(low<high && A[high]>=pivot) --high; //从high往前找比基准小的元素 A[low] = A[high]; //将这个较小元素放入low的位置 while(low<high && A[low]<=pivot) ++low; // 从low之后找比基准大的元素 A[high] = A[low]; //将这个较大元素放入high的位置 } A[low] = pivot; return low; } //快速排序 void QuickSort(int A[],int low,int high){ if(high>low){ int mid = Partition(A,low,high); QuickSort(A,low,mid-1); QuickSort(A,=mid+1,high); } }
堆排序
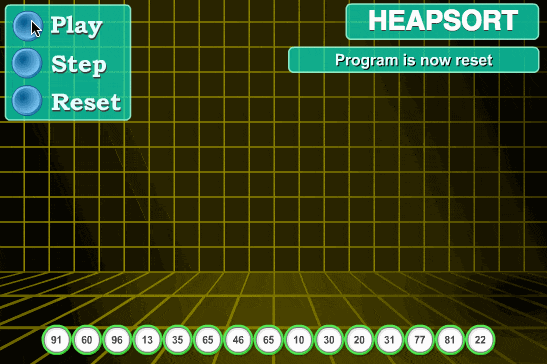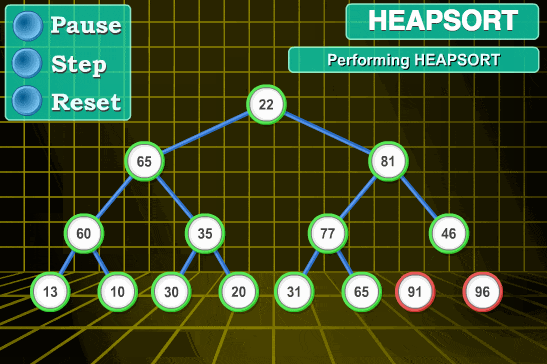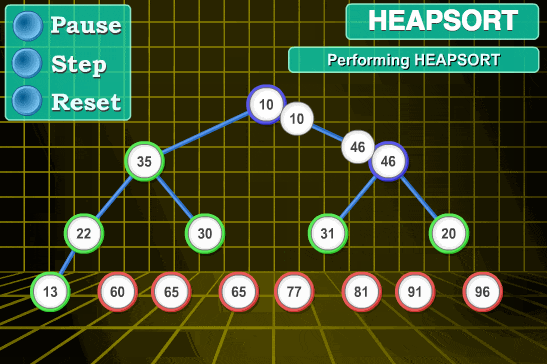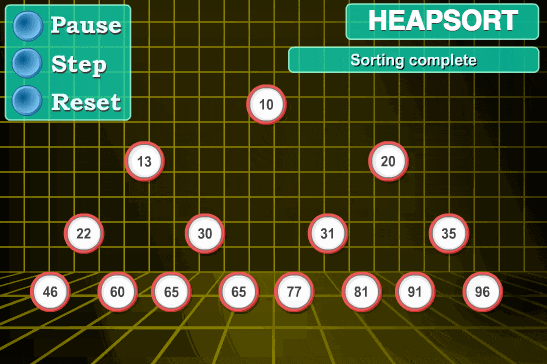
堆排序(Heapsort)是指利用堆这种数据结构所设计的一种排序算法。堆积是一个近似完全二叉树的结构,并同时满足堆积的性质:即子结点的键值或索引总是小于(或者大于)它的父节点。堆排序可以说是一种利用堆的概念来排序的选择排序。分为两种方法:
-
大顶堆:每个节点的值都大于或等于其子节点的值,在堆排序算法中用于升序排列;
-
小顶堆:每个节点的值都小于或等于其子节点的值,在堆排序算法中用于降序排列;
堆排序的平均时间复杂度为 Ο(nlogn)。
-
算法步骤
-
将带排序的序列构造成一个大顶堆,根据大顶堆的性质,当前堆的根节点(堆顶)就是序列中最大的元素;
-
将堆顶元素和最后一个元素交换,然后将剩下的节点重新构造成一个大顶堆;
-
重复步骤2,如此反复,从第一次构建大顶堆开始,每一次构建,我们都能获得一个序列的最大值,然后把它放到大顶堆的尾部。最后,就得到一个有序的序列了。
-
-
图画演示
-
代码实现
//交换 void swap(int *nums,int a,int b){ int temp = nums[a]; nums[a] = nums[b]; nums[b] = temp; } //堆排序——以大根堆为例 void HeapSort(int *nums,int length){ if(length<2) return; //每次把无序部分排成大根堆,每次根节点就是无序部分最大值,将其放在无序序部分最后,无序的最后一个索引-1 int i; for(i=length/2-1;i>=0;i--){ if(i*2+2 < length){ //左右孩子都有 if(nums[i] < nums[i*2+1]){ //父节点小于左孩子则互换 swap(nums,i,i*2+1); } if(nums[i] < nums[i*2+2]){ //父节点小于右孩子则互换 swap(nums,i,i*2+2); } }else{ //只有左孩子 if(nums[i] < nums[i*2+1]){ //父节点小于左孩子则互换 swap(nums,i,i*2+1); } } } swap(nums,0,length-1); //根节点的最大值跟无序部分最后一个位置 HeapSort(nums,length-1); }
归并排序
-
算法步骤
-
申请空间,使其大小为两个已经排序序列之和,该空间用来存放合并后的序列;
-
设定两个指针,最初位置分别为两个已经排序序列的起始位置;
-
比较两个指针所指向的元素,选择相对小的元素放入到合并空间,并移动指针到下一位置;
-
重复步骤 3 直到某一指针达到序列尾;
-
将另一序列剩下的所有元素直接复制到合并序列尾。
-
-
图画演示
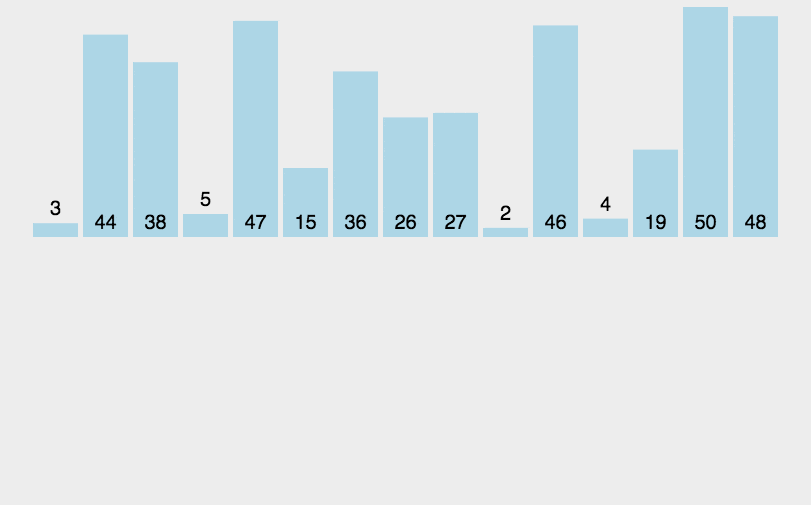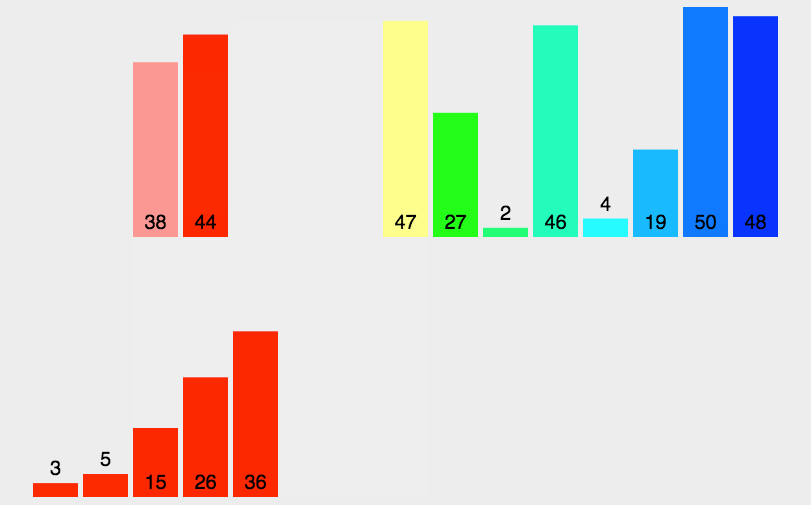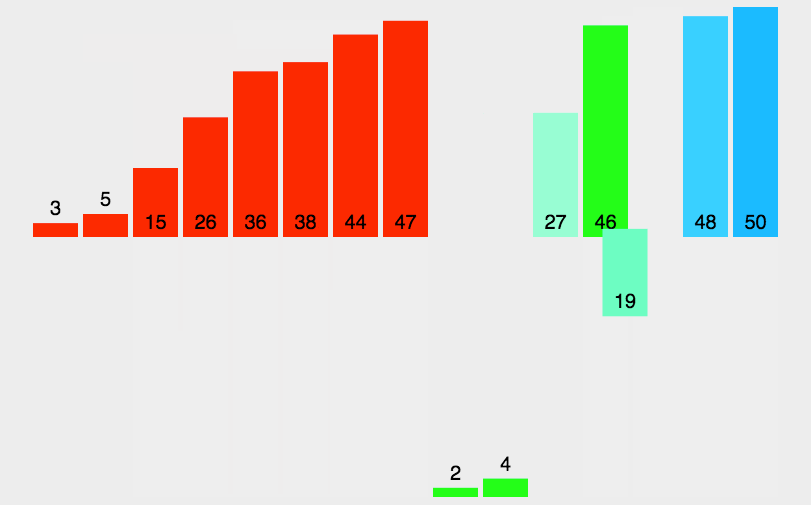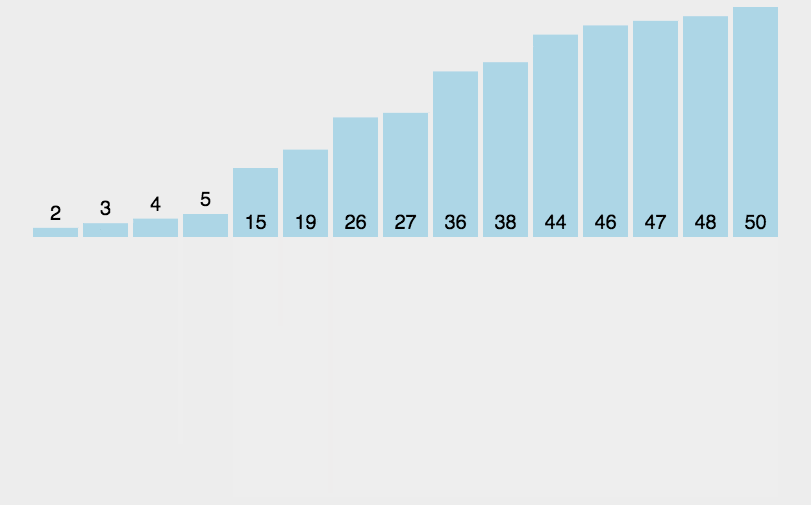
-
代码实现
//归并 //将两个数组(l1~r1、l2~r2)按顺序合并 void merg(int *nums,int l1,int r1,int l2,int r2){ int i=l1,j=l2; int temp[r2-l1+1],index=-1; //临时数组存放排好序的合并数组 while(i<=r1&&j<=r2){ if(nums[i]<nums[j]) temp[++index]=nums[i++]; else{ temp[++index]=nums[j++]; } } while(i<=r1) temp[++index]=nums[i++]; while(j<=r2) temp[++index]=nums[j++]; while(index>=0){ nums[l1+index] = temp[index--]; } } //分治 ——递归 //将一个数组均分成两个 void mergSort(int *nums,int left,int right){ if(left>=right) return; int mid = (left+right)/2; mergSort(nums,left,mid); mergSort(nums,mid+1,right); merg(nums,left,mid,mid+1,right); } //非递归法 void mergSort_no(int *nums,int N){ int step,i; for(step=2;step/2<=N;step*=2){ for(i=0;i<N;i+=step){ int mid = i+step/2-1; merg(nums,i,mid,mid+1,min(i+step-1,N)); } } }
基数排序
基数排序是一种非比较型整数排序算法,其原理是将整数按位数切割成不同的数字,然后按每个位数分别比较。由于整数也可以表达字符串(比如名字或日期)和特定格式的浮点数,所以基数排序也不是只能使用于整数。应该考不到,还不没写代码,啊哈哈哈
-
算法步骤
-
图画演示
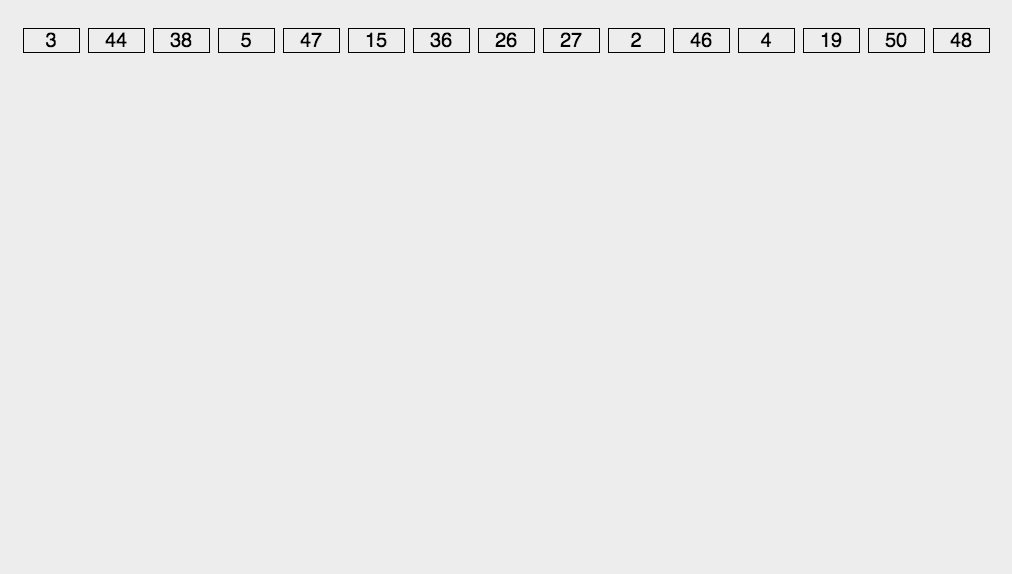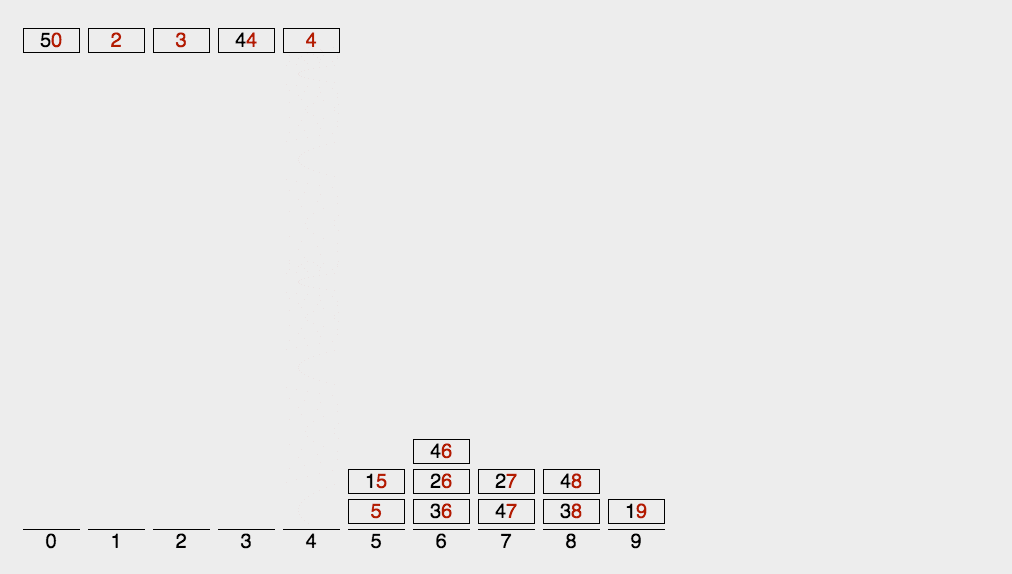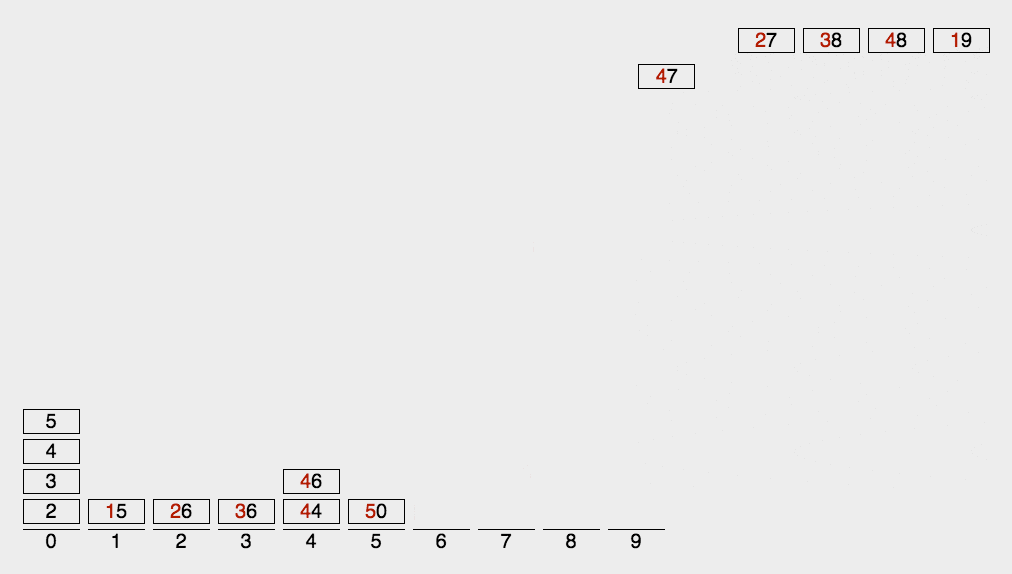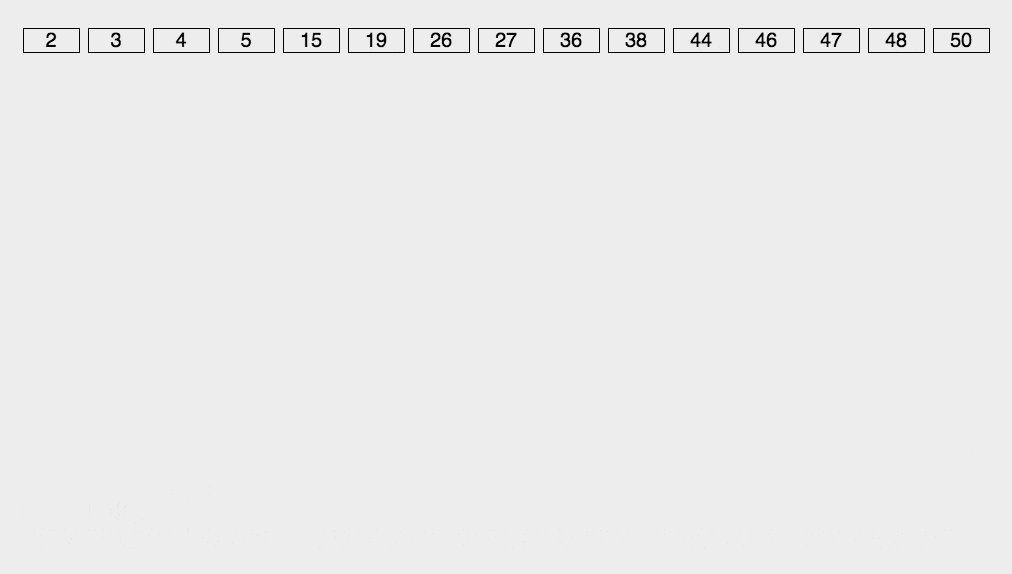
-
代码实现
希尔排序
希尔排序,也称递减增量排序算法,是插入排序的一种更高效的改进版本。但希尔排序是非稳定排序算法。
希尔排序是基于插入排序的以下两点性质而提出改进方法的:
-
插入排序在对几乎已经排好序的数据操作时,效率高,即可以达到线性排序的效率;
-
但插入排序一般来说是低效的,因为插入排序每次只能将数据移动一位;
希尔排序的基本思想是:先将整个待排序的记录序列分割成为若干子序列分别进行直接插入排序,待整个序列中的记录"基本有序"时,再对全体记录进行依次直接插入排序。
-
算法步骤
-
初始令设置增量gap=数列长度/2,排序思想是把0和0+gap设为一组,1和1+gap设为一组.......gap和gap+gap一组
-
对每组进行普通插入排序
-
更新gap=gap/2,即每组的数量加倍(0、0+gap、0+gap*2、0+gap*3为一组)
-
再对每一组进行普通插入排序
-
再更新令gap=gap/2,重复上述操作,直到gap=1结束,即增量为1,所有元素组成一个组(0、0+1、0+1*2、0+1*3......length-1)。
-
-
图画演示

-
代码实现
//希尔排序
void shell_sort(int arr[], int len) {
        int gap, i, j;      //gap:增量(第1个和1+gap一组)
        int temp;
        for (gap = len/2; gap > 0; gap/=2)
            for (i = gap; i < len; i++) {
                //将该组最后一个元素依次与同组前面比较,若前一个比他大,则互换,直到找到一个比它小的,将原顺序的最后一个放                  在第一个比它小的元素后面,注:这里所说的前一个是实际上的前gap个,每隔gap个属于一组。
                temp = arr[i];
                for (j = i - gap; (j>=0 && arr[j]>temp); j -= gap)
                        arr[j + gap] = arr[j];
                arr[j + gap] = temp;
            }
}
各排序性能汇总
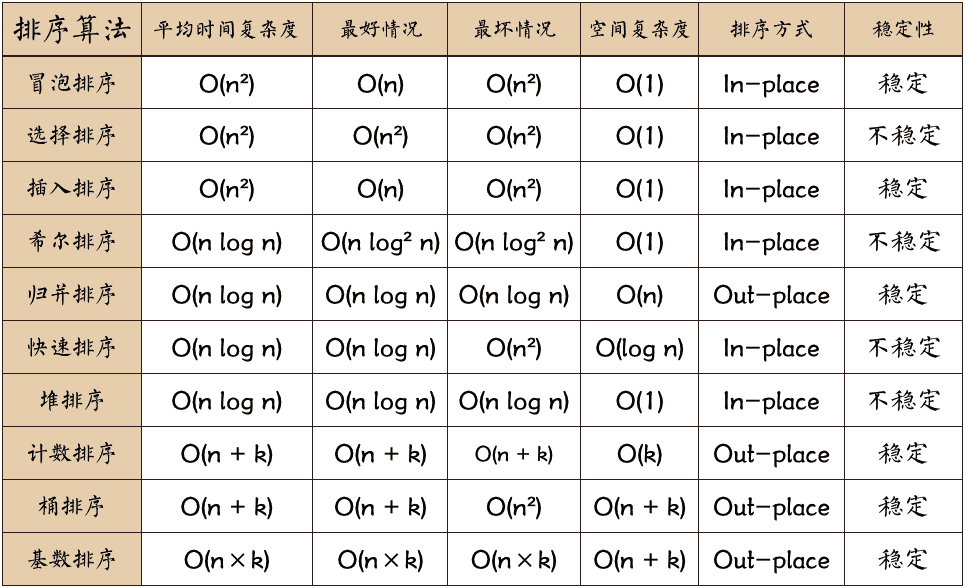

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)