pgpool读写分离,配置设置及调研
pgpool基于官方版本4.2.
pgpool读写分离适用的集群管理模式
先了解一下pgpool支持的几种模式。
Clustering mode https://www.pgpool.net/docs/42/en/html/runtime-config-running-mode.html使用参数backend_clustering_mode控制,枚举类,具体解释如下:
| 枚举值 | 解释 | 限制 |
| backend_clustering_mode = 'streaming_replication' | Pg使用流式复制,复制给每个服务器数据。 相关参数(均可通过reload来加载): https://www.pgpool.net/docs/42/en/html/runtime-streaming-replication-check.html 相关参数主要是针对于流式复制延迟的检查和限制。 | 1.最多可以拥有 127 个流复制备用服务器 2.pg上配置了Hot Standby,我看咱们参数是配置的,PostgreSQL不同规格参数配置 |
| backend_clustering_mode = 'logical_replication' | Pg使用逻辑复制,复制给每个服务器数据。 | 最多127 个逻辑复制备用服务器 |
| backend_clustering_mode = 'slony' | Slony-I 负责进行实际的数据复制。 | 最多127 个副本服务器 |
| backend_clustering_mode = 'native_replication' | Pgpool-II 负责进行数据复制。 (内容比较多,因为一般用pg自己的复制,所以没仔细看) | 最多127 个副本服务器 |
| backend_clustering_mode = 'snapshot_isolation' | 实验性质,目前不用于生产 | |
| backend_clustering_mode = 'raw' | Pgpool-II不关心数据库同步。无法进行负载均衡。 |
阿里使用的配置项是默认的streaming_replication。
pgpool读写分离动态装载需要变动的参数
需要变动后端连接设置和后端数据相关设置。
Backend Settingshttps://www.pgpool.net/docs/42/en/html/runtime-config-backend-settings.html阿里的配置实例:
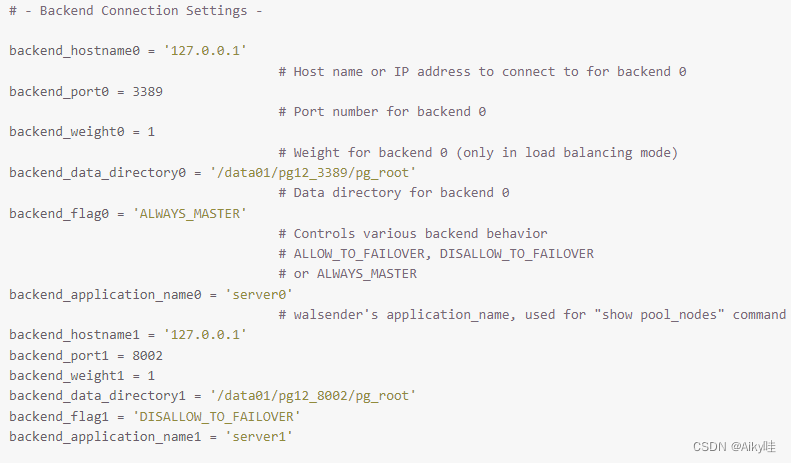
1.backend_hostname
字符串类型参数。
支持主机名或ip地址。
可以通过在参数名称的末尾添加一个数字来指定多个后端(例如backend_hostname0)。
这个数字被称为“DB节点ID”。
它从0开始。被赋予0的DB节点ID的后端将被称为“主节点”。但是在流复制模式下运行没有特殊含义。
New nodes can be added by adding parameter rows and reloading a configuration file. However, the existing values cannot be updated, so you must restart Pgpool-II in that case.
即可以添加新参数,之后reload生效;但是修改和删除原有的配置是不行的,更新现有参数只能重启。
2.backend_port
整数类型参数。
指定后端的端口号。
可以通过在参数名称末尾添加一个数字来指定多个后端(例如 backend_port0)。
和backend_hostname一样,可以添加新参数,之后reload生效;但是修改和删除原有的配置是不行的,更新现有参数只能重启。
3.backend_weight
浮点类型参数
指定后端的负载均衡比例。
可以通过在参数名称末尾添加一个数字来指定多个后端(例如 backend_weight0)。
New backend_weight can be added in this parameter by reloading a configuration file. However, this will take effect only for new established client sessions.
修改值后可以通过reload生效,但是只能对新连接生效。
4.backend_data_directory
字符串类型参数。
指定后端的数据库数据目录。
可以通过在参数名称末尾添加一个数字来指定多个后端(例如 backend_data_directory0)
和backend_hostname一样,可以添加新参数,之后reload生效;但是修改和删除原有的配置是不行的,更新现有参数只能重启。
5.backend_flag
字符串类型参数。
控制各种后端行为。
可以通过在参数名称末尾添加一个数字来指定多个后端(例如 backend_flag0)
可以使用“ | ”同时指定多个参数(Multiple flags can be specified by using "|".)
修改值后可以通过reload生效。
| 枚举值 | 描述 |
| ALLOW_TO_FAILOVER | 默认设置。 允许故障转移或分离后端。 |
| DISALLOW_TO_FAILOVER | 不允许故障转移或分离后端。 |
| ALWAYS_PRIMARY | 仅在流复制模式下有用,始终将设置标志的节点视为主节点。 Pgpool-II将不会通过检查后端来找到主节点。 |
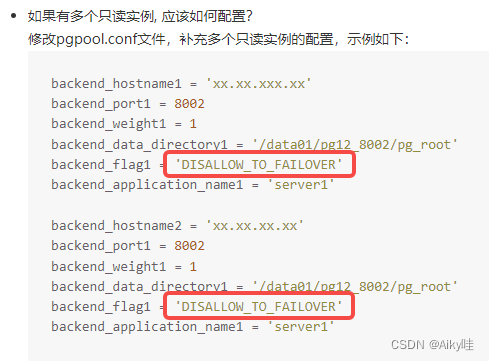
这里阿里的策略是,将主节点设置为ALWAYS_PRIMARY。
将其他只读节点设置为DISALLOW_TO_FAILOVER
6.backend_application_name
字符串类型参数。
walsender 的 application_name,用于“show pool_nodes”命令
可以通过在参数名称末尾添加一个数字来指定多个后端(例如 backend_application_name0)
pgpool对读写分离有影响的负载均衡设置
可以使用SHOW POOL NODES 检查哪个 DB 节点被分配为负载均衡节点。
可以在SELECT语句之前添加任意注释,通常用/*NO LOAD BALANCE*/ 禁用特定查询的负载平衡,Pgpool-II 会将其发送到主节点。
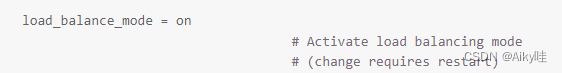
1.load_balance_mode
bool类型参数。
设置为 on 时,Pgpool-II启用传入SELECT查询的负载平衡。
只能在服务器启动时设置。
更改需要重启。
2.ignore_leading_white_space
bool类型参数。
设置为 on 时,Pgpool-II在负载平衡中忽略 SQL 查询开头的空格。

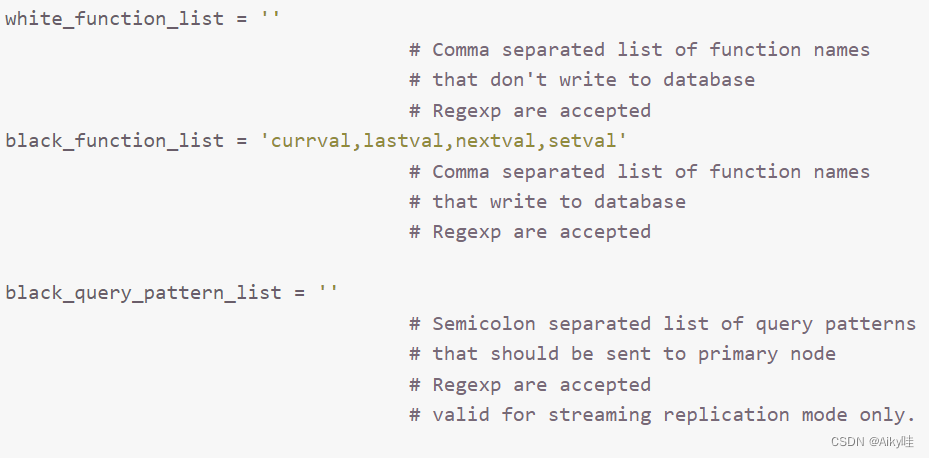
3.write_function_list
字符串类型参数。
参数之间使用逗号分割。
如果select中包含这些名称的函数,将不会负载均衡,会发到主节点。
可以使用正则表达式匹配函数名称。
【阿里使用的版本是4.1的,里面没有这个参数】
4.read_only_function_list
字符串类型参数。
参数之间使用逗号分割。
如果select中包含这些名称的函数。
5.primary_routing_query_pattern_list
字符串类型参数
指定发送到主节点的 SQL 模板。
可以使用正则表达式来匹配 SQL 模式。
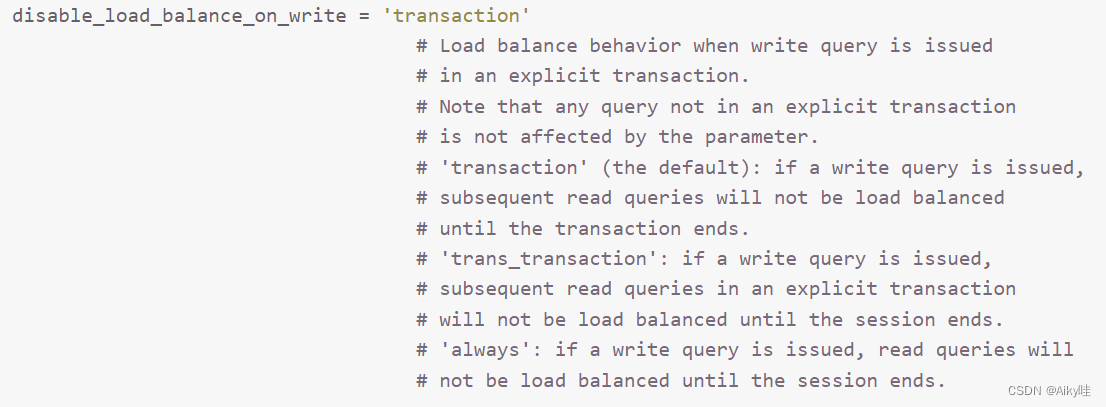
6.disable_load_balance_on_write
| off | 会将写入查询也进行负载均衡。 因为备份会有复制延迟,因此会导致弱一致性。 |
| transaction | 如果是显示事务并且出现写入查询,后续的读查询将不会进行负载均衡。直到事务结束。 不在显式事务中的读取查询不受参数影响 |
| trans_transaction | 如果是显示事务并且出现写入查询,后续的读查询将不会进行负载均衡。直到会话结束。 |
| always | 出现写入查询,在会话结束之前不会进行负载平衡 |
pgpool的实际尝试
1.尝试热加载改变端口为0
根据官方文档是没有办法通过修改来卸载掉只读实例的。
但是通过代码看,感觉可以通过修改port为0来卸载掉只读实例(当然这里pg之间还在流式复制)。
所以搭一下环境看看。
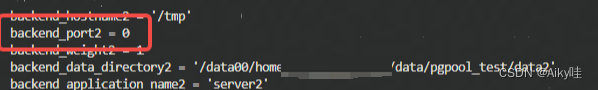

试了一下,不可以的。
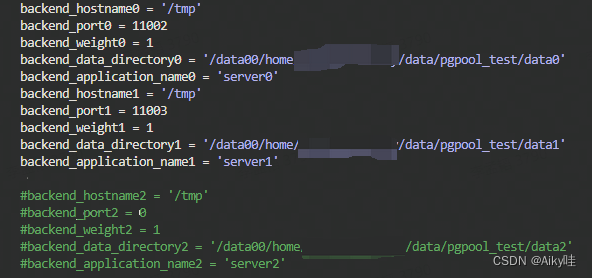
2.尝试热加载删除只读实例
修改之前的状态。

修改参数,注释掉第二个只读节点:
使用bench工具:
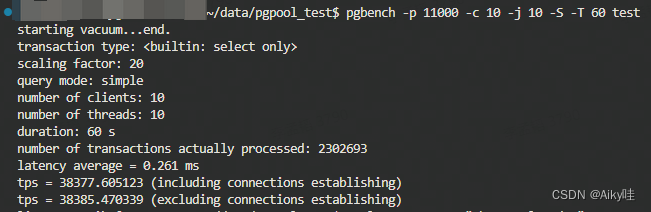
测试完之后的结果:

结论:注释掉节点并没有生效。
3.尝试将权重调整为0
将上一步的注释去掉,重启一下集群。
当前配置:
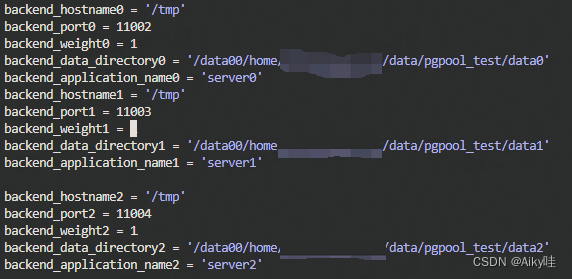
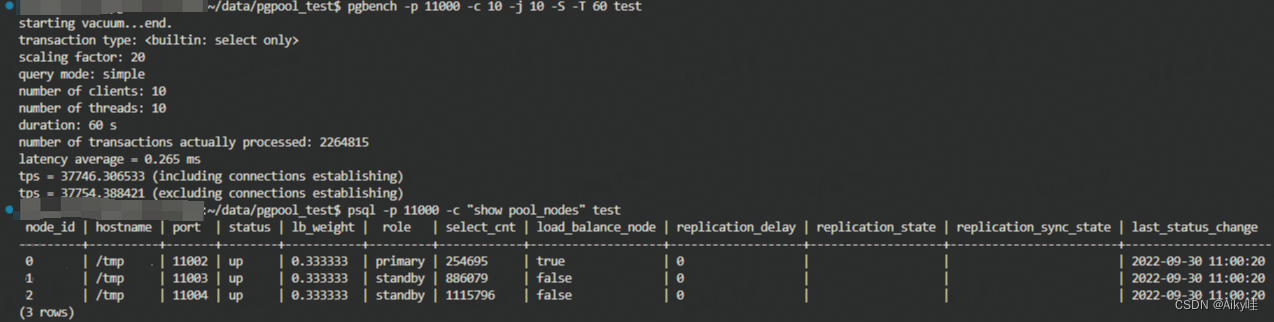
此时进行一下bench,sql是可以发到三个节点的
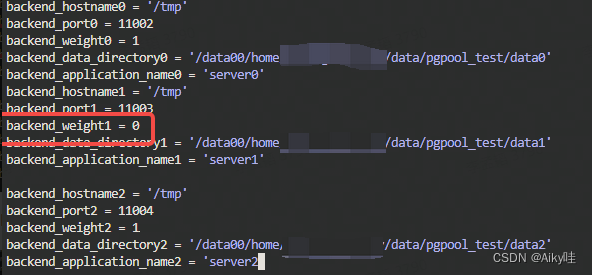
改一下权重,将第二个权重调整为0:
show pool nodes后,跑bench:
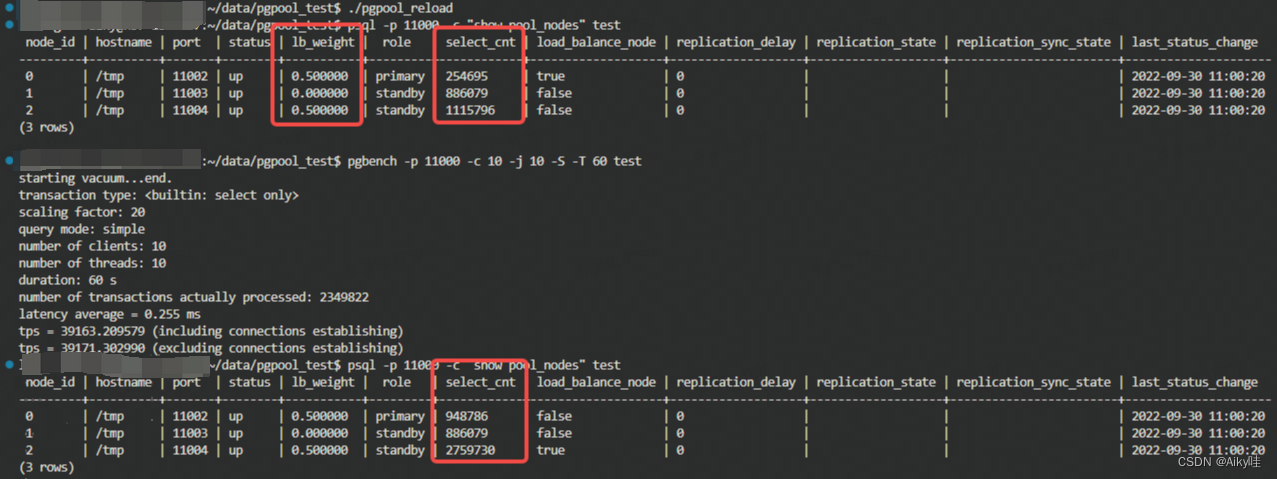
结论:热加载成功,但是此时有个问题,底层pg的复制是没有停的。只是没有办法访问只读节点了。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献6条内容

所有评论(0)