Java开发高性价比面经整理
(就业寒冬)根据最近面试的经历,回头来整理了一份性价比较高的面试宝典,性价比高是因为被问到概率比较大,以及就算没有被问到,实际工作中也是有可能用到的;
但是在阅读本篇之前需要注意几个事情,否则可能一无所获:
1.碰到不会的概念或者技术点,首先看这个技术点是否影响自己理解当下的知识,影响的话,就先主动去看这个不会的知识点,看懂了再回来继续学习,不影响可以先略过,如HashMap结构由数组+链表组成,java1.8之后升级为数组+链表+红黑树。倘若你不理解什么是红黑树,请先暂停一下,去主动学习一下红黑树结构,弄懂之后回来继续研究接下来的hash结构;
2.本篇主要是启发式总结,在基本面完成后,主要是启发你自己主动去搜索总结和学习,并不会面面俱到总结每一个知识点。更多更全请看公众号:
或者点击此链接:(图片完全加载了)
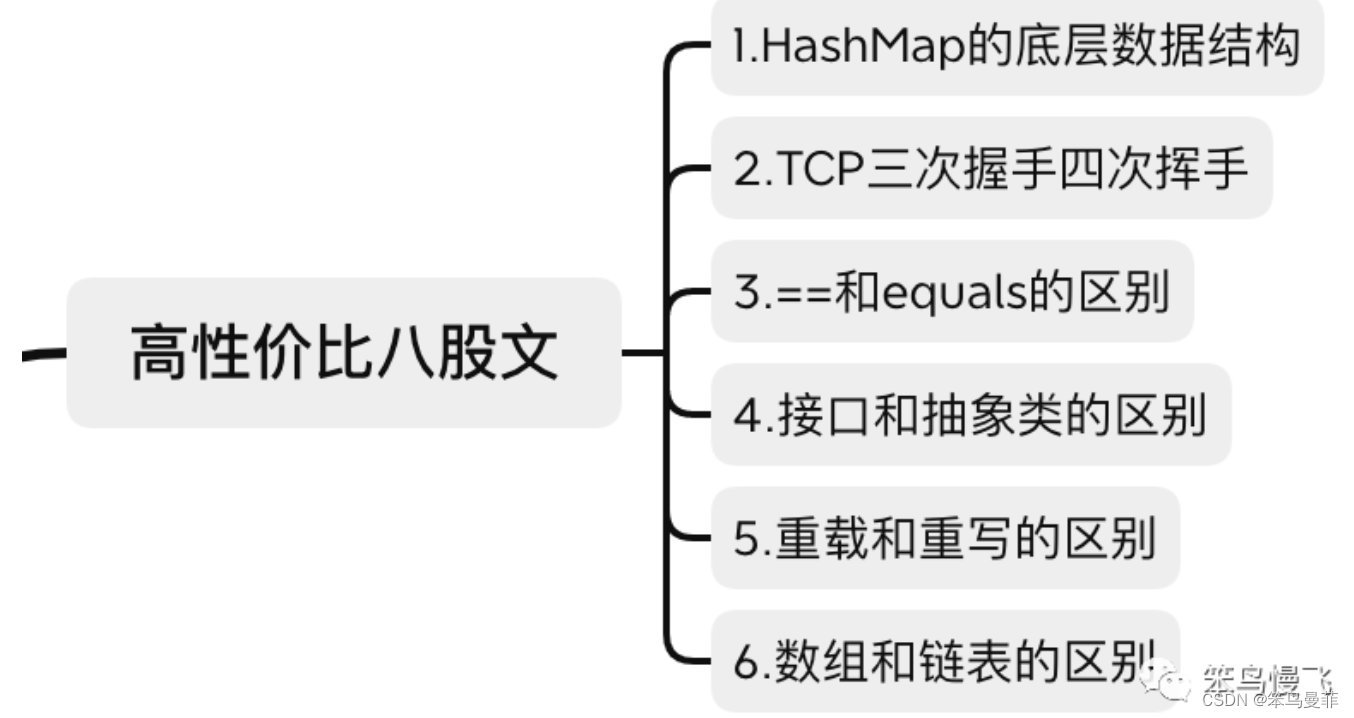
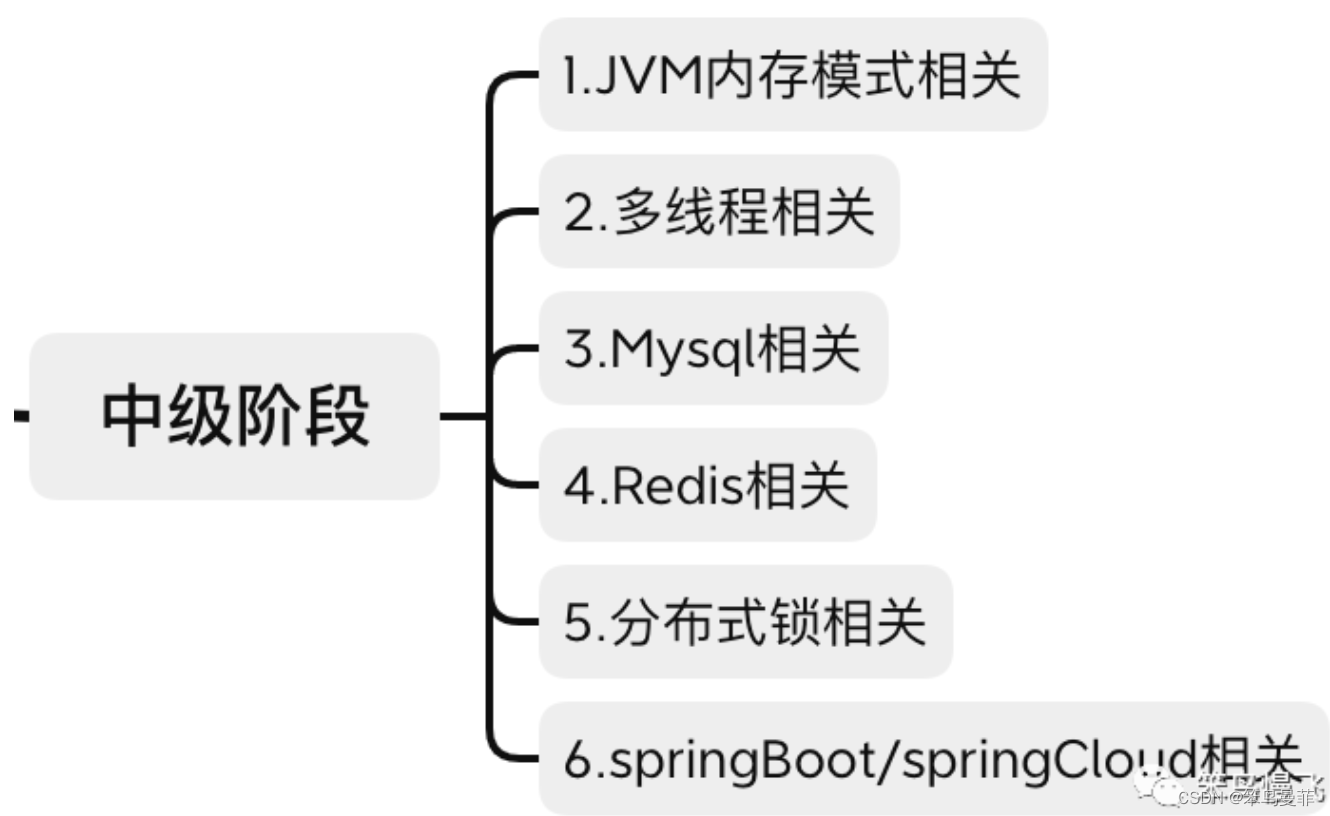
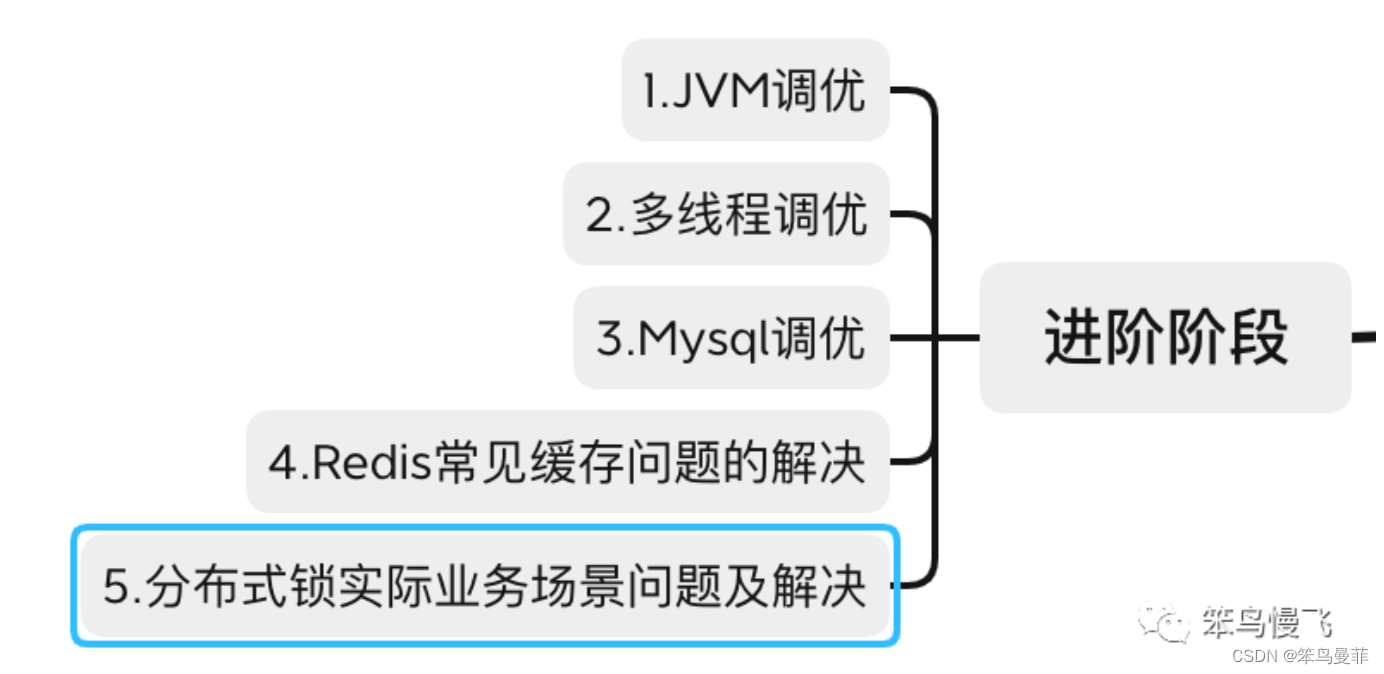
接下来整理的方向如下:
1.基础阶段:
2.中级准备阶段
3.进阶阶段
一:基础阶段
1.HashMap的数据结构是怎么样的?它存储元素的过程是怎么样的?
hashMap大概长这样,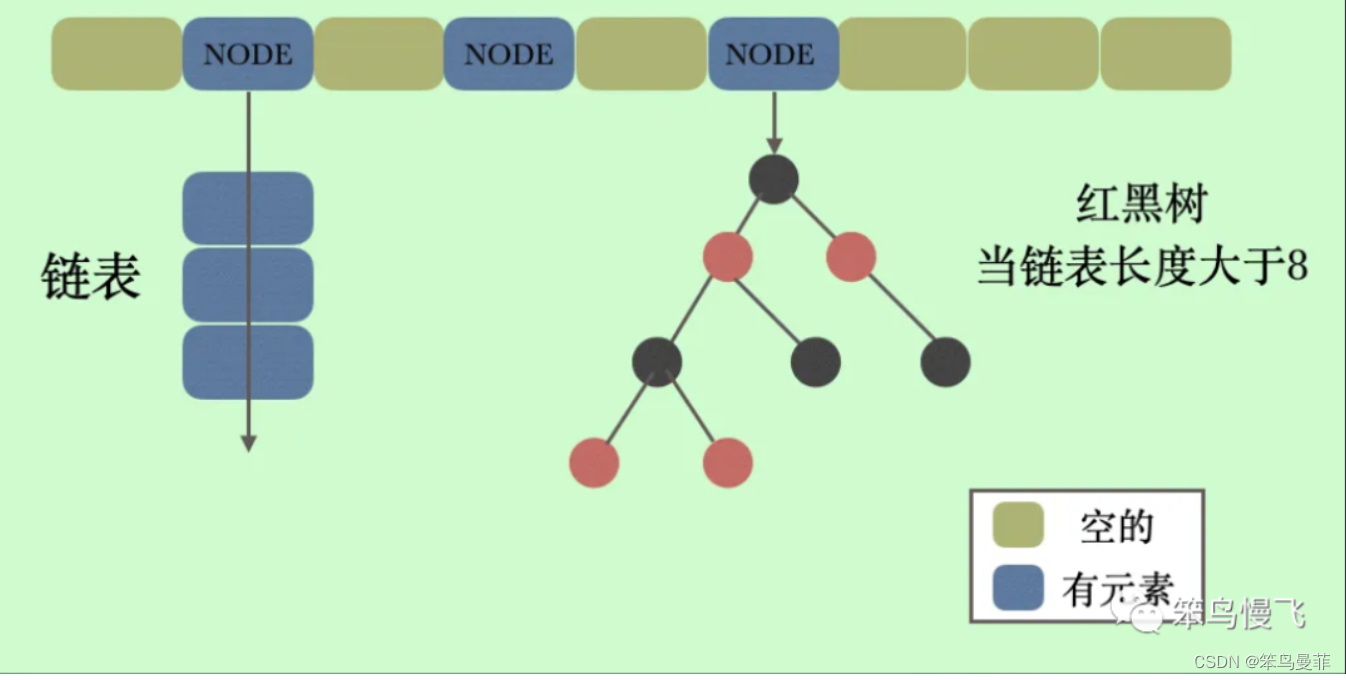 理解下面这段,建议结合上图的结构,自己再一边总结,一边手绘这个过程;
HashMap的底层数据结构在1.7之前是数组加链表,在1.8之后是数组链表加红黑树;不过得扩容到一定程度才会转换为红黑树;要讲明白的话就需要再讲讲他的原理和实现过程了,首先HashMap是基于哈希表的双列集合,是以键值对的形式进行储存的,HashMap整体看来就像是一个数组的主干加上链表的分支,在储存的过程中以key value形式进行。比如说我定义了一个默认长度是16的HashMap 要进行储存一个用户的基本信息,name 张三,gender 男 等等。
在储存的过程,首先会根据key的哈希值进行数组下标的索引,确定了这个key在数组中的位置之后,就会判断在这个位置上是否有value,如果有的话,就根据哈希值判断是否相同,相同的话,再调用equals方法判断两个key是否一样,如果都一样就判断是同一个key,那就把所在位置的value更换掉,如果hashcode相同 但是equals不同的话,就储存在这个索引位置的链表上,可以理解为多了个分叉,那如果都不相同万事大吉,存进去就好了,后面再储存其他的key value的时候,以此类推;
然后比如说储存键值对超过了整体链表长度的四分之三的时候,HashMap就会进行resize扩容原来的两倍,更准确来讲是新搞出了一个HashMap,然后再根据HashCode的计算算出在新的Map的位置,依次存进去;然后在数组单个位置上的链表长度达到了6的时候,会进行红黑树的转化,使得查询速度变得更快,更好的解决哈希冲突的问题;
2.HashMap的存取原理?(建议手绘过程图)
1)存方法:put(Object key, Object value)
执行流程如下:
-
对 key 进行 hash 操作,计算存储 index;
-
判断是否有哈希碰撞,如果没碰撞直接放到哈希桶里,如果有碰撞则以链表的形式存储;
-
判断已有元素的类型,决定是追加树还是追加链表,当链表大于等于 8 时,把链表转换成红黑树;
-
如果节点已经存在就替换旧值;
-
判断是否超过阀值,如果超过就要扩容。
2)取方法:get(Object key)
执行流程如下:
-
首先比对首节点,如果首节点的 hash 值和 key 的 hash 值相同,并且首节点的键对象和 key 相同(地址相同或 equals 相等),则返回该节点;
-
如果首节点比对不相同、那么看看是否存在下一个节点,如果存在的话,可以继续比对,如果不存在就意味着 key 没有匹配的键值对。
3.HashMap是线程安全的吗?如果是,为什么?如果不是,怎么解决线程安全的问题?
推荐链接:https://www.yht7.com/news/93299
或者微信(百度也行)直接搜索“HashMap是线程安全的吗?”,带着问题,自己主动寻找答案,且做好笔记,强烈建议手写,虽然慢,但是印象更深刻;
4.说一下TCP三次握手和四次挥手;为什么是三次握手,两次不行吗?
如果你第一次看,我先帮你吐槽,这都是啥啊?看不懂啊,这些什么ACK的什么FIN的,好乱七八槽啊!!!
如果非科班,看不懂很正常,所以需要自己耐心点去搜索自己不懂的概念,逐个击破;比如:什么是报文?ACK全称是什么?FIN全称是什么意思?像拼图一样,一点点拼起来,然后自己手绘流程图,手写笔记,再梳理成自己的文字;
TCP三次握手建立连接图解:(状态角度解析)
TCP三次握手 总体描述一下过程 就是,客户端和服务器端相互发送报文,确认彼此都有能力1.接收 2.发送数据--进而建立连接开始数据传输的过程;
首先,准备阶段:服务器端新建套接字,里面有自己的地址,并且开启Listen状态,准备随时接收客户端传递过来请求;
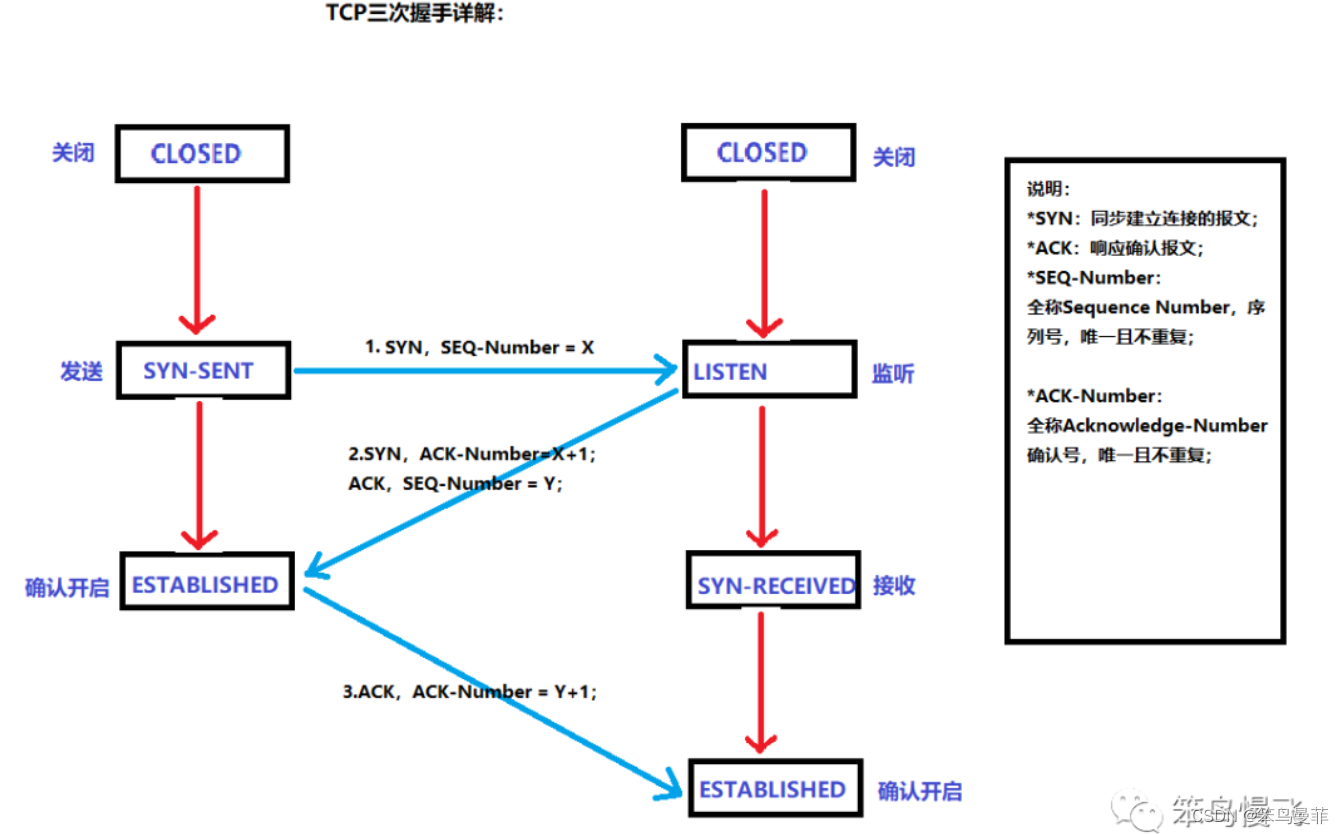
第一次握手 :客户端 将自己新建的存有自己地址的套接字,向服务端发送SYN请求报文以及生成的一个随机Sequence Number,初始化序列号X(实际不可能是X,只为了方便理解设为X),这是第一次握手表示自己可以发送数据;
第二次握手 :服务器端接收到SYN报文和其中的序列号X之后,就将X进行+1处理,生成随机序列号Sequence Number:Y,打包成ACK确认报文;然后发送给客户端,这是第二次握手:知道了客户端能发送消息了,然后通知客户端,服务端是可以接收和发送数据的;
第三次握手,客户端接收到 ACK确认报文,ACK-Number X+1,和Sequence Number:Y之后。知道了客户端可以接收和发送数据了,就将Sequence Number + 1处理=Y+1 打包成新ACK确认报文 再发送给服务器,通知对方我可以接收数据;
三次握手完成后 客户端和服务器端都开启,开始进行数据传输;
补充:如果没有基础的情况之下理解是很难的,需要反复思考琢磨,对照图片和过程详解,一步一步的分析;直到弄懂整个过程,想要最快速度理解整个过程,可以用最笨但是我觉得是最好的方法,就是自己手绘过程图;
仅供参考;
5.TCP四次“挥手”断开连接是怎么样的?
每一次挥手都会对两端的状态有影响,所以先记住端口的几种状态:
*CLOSED 关闭状态;
*CLOSED-WAIT 等待关闭状态;
*FIN-WAIT-1 一级等待状态;
*FIN-WAIT-2 二级等待状态;
*TIME-WAIT ;
*LAST-ACK ;
四次挥手 整体描述一下就是在保证 数据传输不受影响的情况之下,通知对方关闭之后自己也关闭的一个过程;(图是baidu找来的,我感觉画的挺好的)
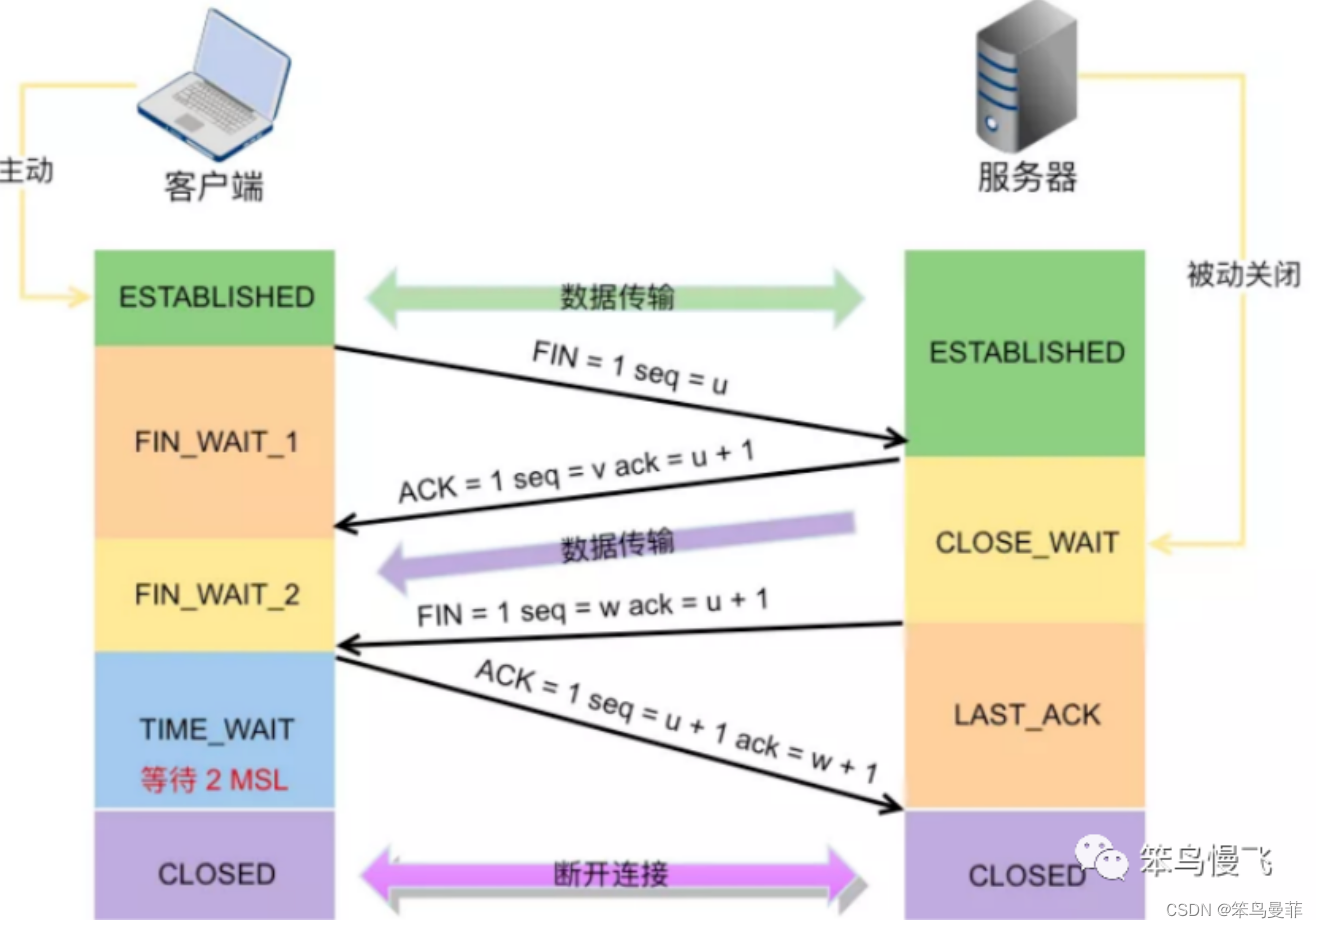
第一次挥手:一般就是客户端 发送FIN结束报文和生成的SEQ-Number随机序列号U 给服务器端,通知服务器客户端要关闭了,然后自己进入一级等待状态;
报文图片在此,建议用另一个设备打开,并尝试随着每一次“挥手”过程,将SEQ-Number序列号,ACK-Numbr确认号,报文类别等标记出来,有助于理解四次挥手;
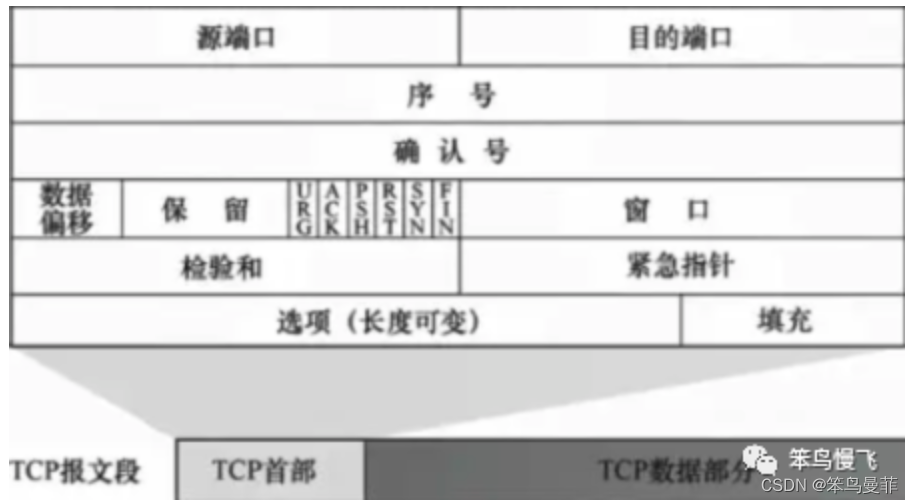
第二次挥手:服务器端接收到FIN结束报文 和序列号U之后,将序列号U+1 赋予 ACK-Number; 然后生成一个新的序列号SEQ-Number V , 打包成ACK确认报文给客户端,客户端收到ACK确认报文之后 进入二级等待状态,等着服务端(先把文件传输完,还有继续接收可能没有传输完的数据之后)发送FIN结束报文 ;
第三次挥手:相互之间传输的数据完成了之后,服务器端向客户端发送结束报文FIN ,包含SEQ-Number序列号W ,ACK-Number U+1确认序列号 (相当于回应),发送给客户端;
第四次挥手:客户端接收到 FIN报文 ,开始进入TimeWaiting的状态 ,并且返回ACK确认报文 还有ACK-Number W+1还有 SEQ-Number U+1给服务器,服务器接收到之后 Close;客户端等一段时间关闭;图片中的2MSL指的是等待大概两个来回的时间;
关于HTTP相关的面试,这个链接总结的还可以,但是我建议自己主动去搜索;
https://blog.csdn.net/qq_43375584/article/details/125660433
6.==和equals的区别;
== 的作用:
基本类型:比较的就是值是否相同
引用类型:比较的就是地址值是否相同;
equals 的作用:引用类型:默认情况下,比较的是地址值。
特:String、Integer、Date这些类库中equals被重写,比较的是内容而不是地址!
小结:
==:比较的是两个字符串内存地址(堆内存)的数值是否相等,属于数值比较;equals():比较的是两个字符串的内容,属于内容比较。
7.抽象类和接口的区别;
实现:抽象类的子类使用extends 来继承;接口必须使用 implements 来实现接口。
构造函数:抽象类可以有构造函数;接口不能有。
main 方法:抽象类可以有 main 方法,并且我们能运行它;接口不能有 main 方法。
实现数量:类可以实现很多个接口;但是只能继承一个抽象类。
访问修饰符:接口中的方法默认使用public 修饰;抽象类中的方法可以是任意访问修饰符;
8.重载和重写的区别;
重载: 发生在同一个类中,方法名必须相同,参数类型不同.个数不同.顺序不同,方法返回
值和访问修饰符可以不同,发生在编译时。
重写: 发生在父子类中,方法名.参数列表必须相同,返回值范围小于等于父类,抛出的异
常范围小于等于父类,
访问修饰符范围大于等于父类;如果父类方法访问修饰符为private 则子类就不能重写该方法。
9.final和finally和finalize的区别;
1、final可以修饰类,变量,方法,修饰的类不能被继承,修饰的变量不能重新赋值,修饰的方法不能被重写。
2、finally用于搭配try catch抛异常,finally代码块内语句无论是否发生异常,都会在执行finally,常用于一些流的关闭。
3、finalize方法用于垃圾回收。一般情况下不需要我们实现finalize,当对象被回收的时候需要释放一些资源,比如socket链接,在对象初始化时创建,整个生命周期内有效,那么需要实现finalize方法,关闭这个链接。但是当调用finalize方法后,并不意味着GC会立即回收该对象,所以有可能真正调用的时候,对象又不需要回收了,然后到了真正要回收的时候,因为之前调用过一次,这次又不会调用了,产生问题。
10.ArrayList和linkedList的区别
Array(数组)是基于索引(index)的数据结构,它使用索引在数组中搜索和读取数据是很快的。Array获取数据的时间复杂度是O(1),但是要删除数据却是开销很大,因为这需要重排数组中的所有数据, (因为删除数据以后, 需要把后面所有的数据前移)缺点: 数组初始化必须指定初始化的长度, 否则报错
例如:
List—是一个有序的集合,可以包含重复的元素,提供了按索引访问的方式,它继承Collection。
List有两个重要的实现类:ArrayList和LinkedList
ArrayList:可以看作是能够自动增长容量的数组
ArrayList的toArray方法返回一个数组
ArrayList的asList方法返回一个列表
ArrayList底层的实现是Array, 数组扩容实现
LinkList是一个双链表,在添加和删除元素时具有比ArrayList更好的性能.但在get与set方面弱于 ArrayList.当然,这些对比都是指数据量很大或者操作很频繁。
11.说说ArrayList的特点
ArrayList 是最常用的 List 实现类,内部是通过数组实现的,它允许对元素进行快速随机访问。数组的缺点是每个元素之间不能有间隔,当数组大小不满足时需要增加存储能力,就要将已经有数组的数据复制到新的存储空间中。 当从 ArrayList 的中间位置插入或者删除元素时,需要对数组进行复制、移动、代价比较高。因此,它适合随机查找和遍历,不适合插入和删除。
12.说说LinkList(链表)
LinkedList 是用链表结构存储数据的,很适合数据的动态插入和删除,随机访问和遍历速度比较慢。另外,他还提供了 List 接口中没有定义的方法,专门用于操作表头和表尾元素,可以当作堆栈、队列和双向队列使用
这几个都不难,但是蛮常见的,如果还不懂自己可以尝试继续搜索一下;
二 中级阶段
PS:此范围的面经几乎为必问项,具体问哪一方面取决于简历上的介绍;
-
JVM内存模型相关:
提示:想要比较顺畅的掌握JVM相关面试题,需要自己首先先对JVM有一个系统的学习,强烈建议手绘JVM模型图,结合一个对象从创建到销毁的过程绘制流程图,当完成到这个程度的时候,JVM这块基本上就入门了,准备面试也不再是死记硬背;
-
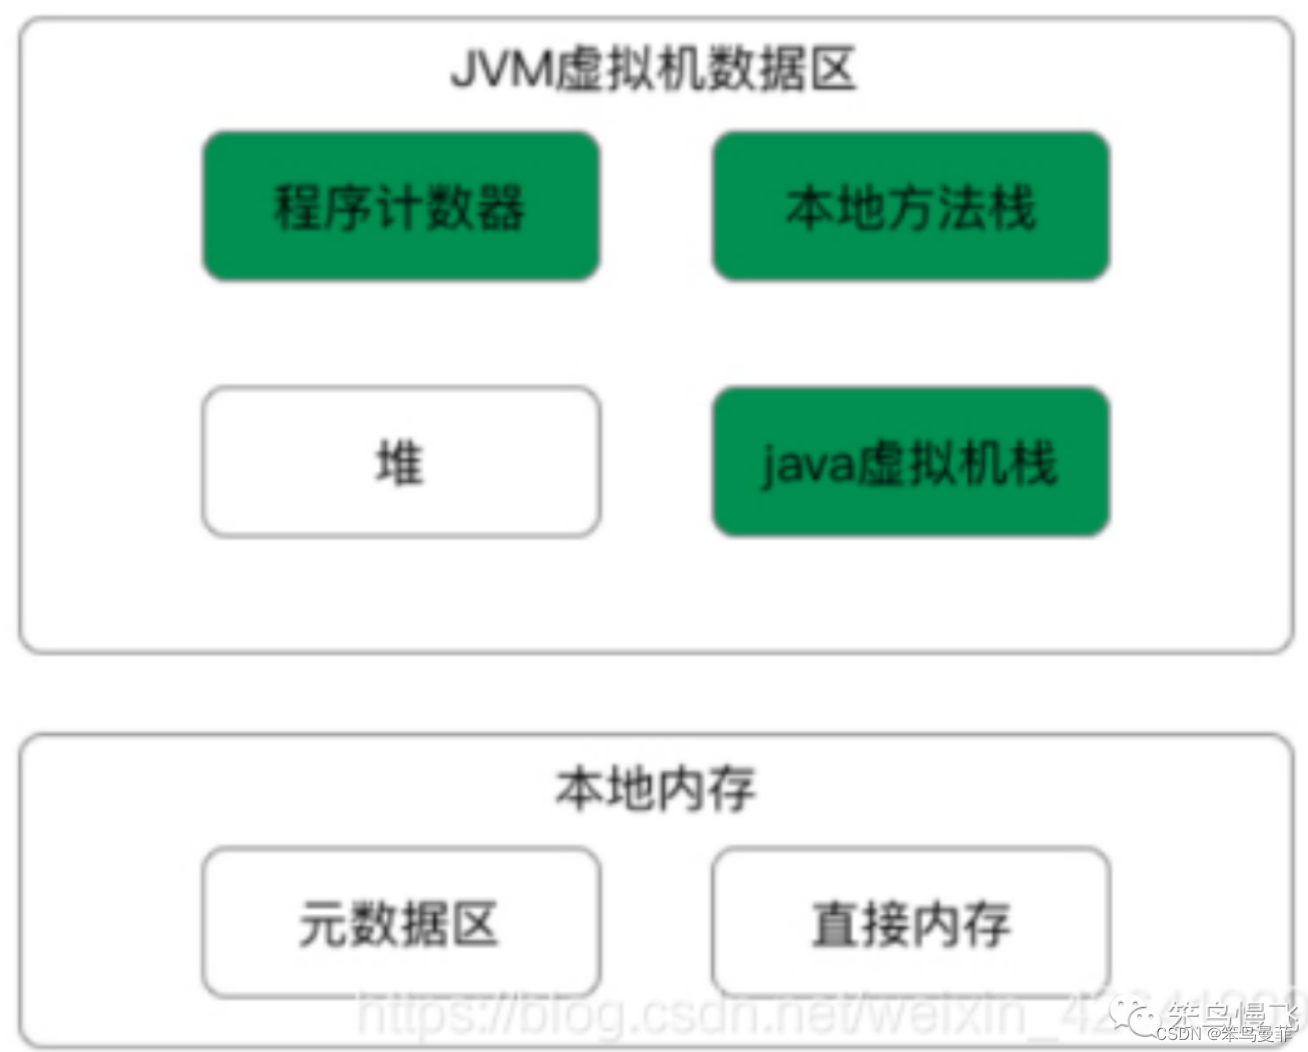
1.1 基础扫盲
程序计数器:线程私有的(每个线程都有一个自己的程序计数器), 是一个指针. 代码运行, 执行命令. 而每个命令都是有行号的,会使用程序计数器来记录命令执行到多少行了.记录代码执行的位置。
Java虚拟机栈:线程私有的(每个线程都有一个自己的Java虚拟机栈). 一个方法运行, 就会给这个方法创建一个栈帧, 栈帧入栈执行代码, 执行完毕之后出栈(弹栈)存引用变量,基本数据类型。
本地方法栈:线程私有的(每个线程都有一个自己的本地方法栈), 和Java虚拟机栈类似, Java虚拟机栈加载的是普通方法,本地方法加载的是native修饰的方法.native:在java中有用native修饰的,表示这个方法不是java原生的。
堆:线程共享的(所有的线程共享一份). 存放对象的,new的对象都存储在这个区域.还有就是常量池.元空间: 存储.class 信息, 类的信息,方法的定义,静态变量等.而常量池放到堆里存储。
JDK1.8和JDK1.7的jvm内存最大的区别是, 在1.8中方法区是由元空间(元数据区)来实现的, 常量池.1.8不存在方法区,将方法区的实现给去掉了.而是在本地内存中,新加入元数据区(元空间)。
堆内存结构
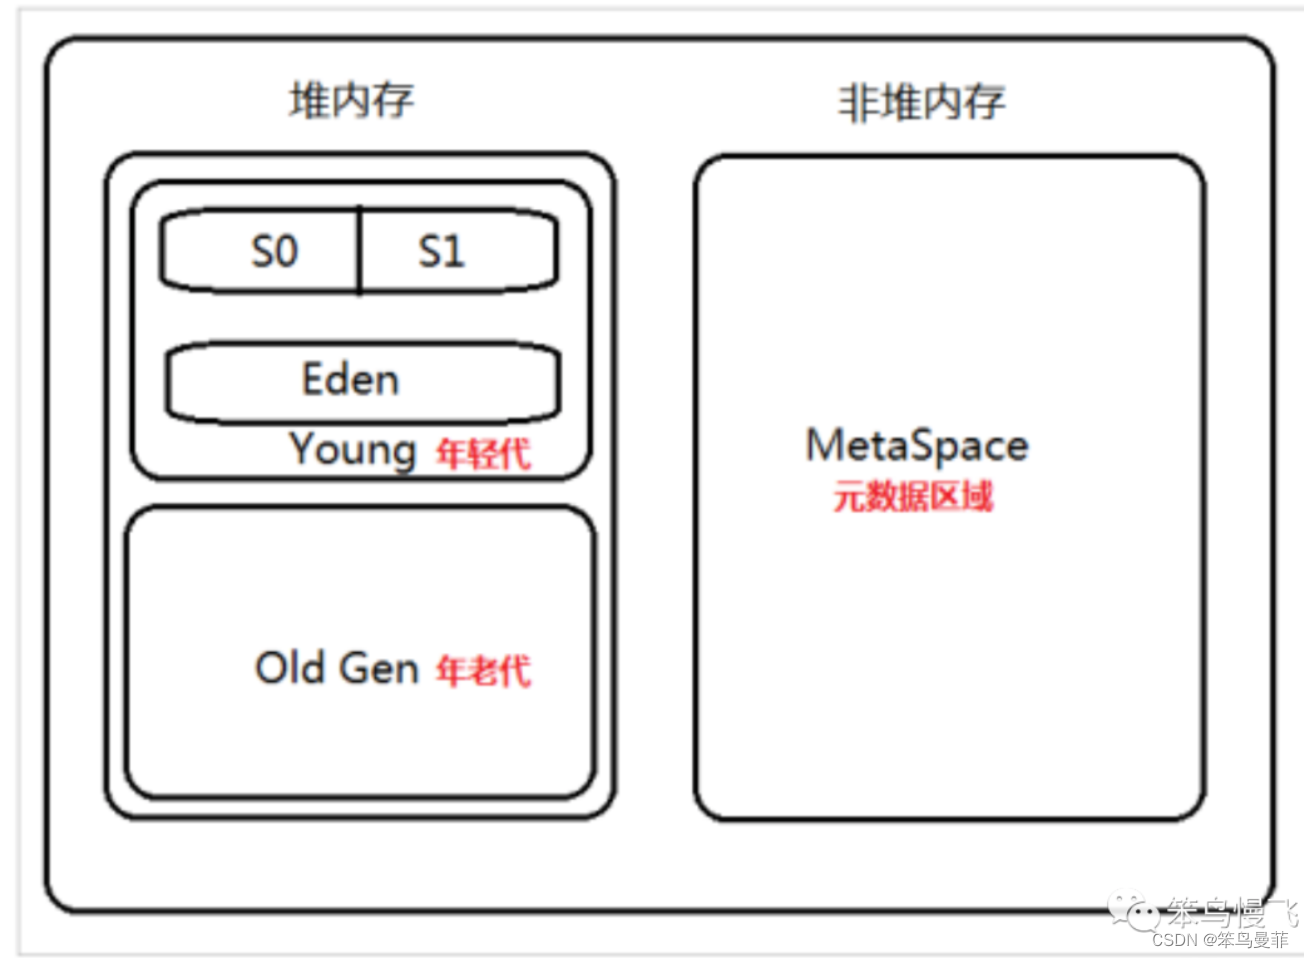
注:JVM中新生代和老年代的比例默认为1比2,新生代内 Eden区和S0和S1 b比例是8:1:1;
看到这,提个要求,请锁屏,拿出一张纸,凭着自己的学习和印象画出JVM1.8的内存模型,以及堆内存模型,达到此要求后可以继续准备面试题了,否则建议返工重学,直到掌握模型;
1.2 经典面试题:
1.Gc垃圾回收
JVM的垃圾回收动作可以大致分为两大步,首先是「如何发现垃圾」,然后是「如何回收垃圾」。说明一点, 线程私有的不存在垃圾回收, 只有线程共享的才会存在垃圾回收, 所以堆中存在垃圾回收.
0.1 如何发现垃圾
Java语言规范并没有明确的说明JVM使用哪种垃圾回收算法,但是常见的用于「发现垃圾」的算法有两种,引用计数算法和根搜索算法。
1.引用计数算法
该算法很古老(了解即可)。核心思想是,堆中的对象每被引用一次,则计数器加1,每减少一个引用就减1,当对象的引用计数器为0时可以被当作垃圾收集。
优点:快。
缺点:无法检测出循环引用。如两个对象互相引用时,他们的引用计数永远不可能为0。
2.根搜索算法(也叫可达性分析)
根搜索算法是把所有的引用关系看作一张图,从一个节点GC ROOT开始,寻找对应的引用节点,找到这个节点以后,继续寻找这个节点的引用节点,当所有的引用节点寻找完毕之后,剩余的节点则被认为是没有被引用到的节点,即可以当作垃圾。
Java中可作为GC Root的对象有
1.虚拟机栈中引用的对象
2.本地方法栈引用的对象
2.方法区中静态属性引用的对象
3.方法区中常量引用的对象
0.2 如何回收垃圾
Java中用于「回收垃圾」的常见算法有4种:
1.标记-清除算法(mark and sweep)
分为“标记”和“清除”两个阶段:首先标记出所有需要回收的对象,在标记完成之后统一回收掉所有被标记的对象。
缺点:首先,效率问题,标记和清除效率都不高。其次,标记清除之后会产生大量的不连续的内存碎片。
2.标记-整理算法
是在标记-清除算法基础上做了改进,标记阶段是相同的,但标记完成之后不是直接对可回收对象进行清理,而是让所有存活的对象都向一端移动,在移动过程中清理掉可回收的对象,这个过程叫做整理。
优点:内存被整理后不会产生大量不连续内存碎片。
3.复制算法(copying)
将可用内存按容量分成大小相等的两块,每次只使用其中一块,当这块内存使用完了,就将还存活的对象复制到另一块内存上去,然后把使用过的内存空间一次清理掉。缺点:可使用的内存只有原来一半。
4.分代收集算法(generation)
当前主流JVM都采用分代收集(Generational Collection)算法, 这种算法会根据对象存活周期的不同将内存划分为年轻代、年老代、永久代,不同生命周期的对象可以采取不同的回收算法,以便提高回收效率。
2.MinorGC,MajorGC、FullGC都什么时候发生?
MinorGC在年轻代空间不足的时候发生,MajorGC指的是老年代的GC,出现MajorGC一般经常伴有MinorGC。
FullGC有三种情况。
1、 当老年代无法再分配内存的时候
2、 元空间不足的时候
3、 显示调用System.gc的时候。另外,像CMS一类的垃圾回收器,在MinorGC出现promotion failure的时候也会发生FullGC
3、Java的双亲委托机制是什么?
它的意思是,除了顶层的启动类加载器以外,其余的类加载器,在加载之前,都会委派给它的父加载器进行加载。这样一层层向上传递,直到祖先们都无法胜任,它才会真正的加载。
否则试想一下,如果没有此机制,我完全可以自己写一个String类,破坏原本jdk中的String的API,但是因为有了双亲委派机制,系统碰到了String就会用对应的类加载器而不是自定义的类加载器,避免乱套;
J ava默认是这种行为。当然Java中也有很多打破双亲行为的骚操作,比如SPI(JDBC驱动加载),OSGI等。
4、在 Java 中,对象什么时候可以被垃圾回收?
当这个对象没有在引用链上的时候,也就是没有其他对象或者方法引用这个对象,就可以被回收了。
5、有哪些打破了双亲委托机制的案例?
1、 Tomcat可以加载自己目录下的class文件,并不会传递给父类的加载器。
2、 Java的SPI,发起者是 BootstrapClassLoader, BootstrapClassLoader已经是最上层的了。它直接获取了 AppClassLoader进行驱动加载,和双亲委派是相反的。
6、JVM 年轻代到年老代的晋升过程的判断条件是什么呢?
1、 部分对象会在From和To区域中复制来复制去,如此交换15次(由JVM参数MaxTenuringThreshold决定,这个参数默认是15),最终如果还是存活,就存入到老年代。
2、 如果对象的大小大于Eden的二分之一会直接分配在old,如果old也分配不下,会做一次majorGC,如果小于eden的一半但是没有足够的空间,就进行minorgc也就是新生代GC。
3、 minor gc后,survivor仍然放不下,则放到老年代
4、 动态年龄判断 ,大于等于某个年龄的对象超过了survivor空间一半 ,大于等于某个年龄的对象直接进入老年代
部分链接:https://blog.csdn.net/yanpenglei/article/details/121648703
2.多线程相关
2.1 Threadloal的原理(建议自己在idea中写代码,然后结合文字看代码)
ThreadLocal:为共享变量在每个线程中创建一个副本,每个线程都可以访问自己内部的副本变量。通过threadlocal保证线程的安全性。
其实在ThreadLocal类中有一个静态内部类ThreadLocalMap(其类似于Map),用键值对的形式存储每一个线程的变量副本,ThreadLocalMap中元素的key为当前ThreadLocal对象,而value对应线程的变量副本。
ThreadLocal 本身并不存储值,它只是作为一个 key保存到ThreadLocalMap中,但是这里要注意的是它作为一个key用的是弱引用,因为没有强引用链,弱引用在GC的时候可能会被回收。这样就会在ThreadLocalMap中存在一些key为null的键值对(Entry)。因为key变成null了,我们是没法访问这些Entry的,但是这些Entry本身是不会被清除的。如果没有手动删除对应key就会导致这块内存即不会回收也无法访问,也就是内存泄漏。
使用完ThreadLocal之后,记得调用remove方法。在不使用线程池的前提下,即使不调用remove方法,线程的"变量副本"也会被gc回收,即不会造成内存泄漏的情况。
2.2 同步锁、死锁、乐观锁、悲观锁
同步锁:
当多个线程同时访问同一个数据时,很容易出现问题。为了避免这种情况出现,我们要保证线程同步互斥,就是指并发执行的多个线程,在同一时间内只允许一个线程访问共享数据。Java 中可以使用 synchronized 关键字来取得一个对象的同步锁。
死锁:
何为死锁,就是多个线程同时被阻塞,它们中的一个或者全部都在等待某个资源被释放。
乐观锁:
总是假设最好的情况,每次去拿数据的时候都认为别人不会修改,所以不会上锁,但是在更新的时候会判断一下在此期间别人有没有去更新这个数据,可以使用版本号机制和CAS算法实现。乐观锁适用于多读的应用类型,这样可以提高吞吐量,像数据库提供的类似于write_conditio机制,其实都是提供的乐观锁。在Java中java.util.concurrent.atomic包下面的原子变量类就是使用了乐观锁的一种实现方式CAS实现的。
悲观锁:
总是假设最坏的情况,每次去拿数据的时候都认为别人会修改,所以每次在拿数据的时候都会上锁,这样别人想拿这个数据就会阻塞直到它拿到锁(共享资源每次只给一个线程使用,其它线程阻塞,用完后再把资源转让给其它线程)。传统的关系型数据库里边就用到了很多这种锁机制,比如行锁,表锁等,读锁,写锁等,都是在做操作之前先上锁。Java中synchronized和ReentrantLock等独占锁就是悲观锁思想的实现。
2.3 说一下 synchronized 底层实现原理?
synchronized可以保证方法或者代码块在运行时,同一时刻只有一个方法可以进入到临界区,同时它还可以保证共享变量的内存可见性。
Java中每一个对象都可以作为锁,这是synchronized实现同步的基础:
·普通同步方法,锁是当前实例对象
·静态同步方法,锁是当前类的class对象
·同步方法块,锁是括号里面的对象
2.4 synchronized 和 volatile 的区别是什么?
volatile本质是在告诉jvm当前变量在寄存器(工作内存)中的值是不确定的,需要从主存中读取;synchronized则是锁定当前变量,只有当前线程可以访问该变量,其他线程被阻塞住。
volatile仅能使用在变量级别;synchronized则可以使用在变量、方法、和类级别的。
volatile仅能实现变量的修改可见性,不能保证原子性;而synchronized则可以保证变量的修改可见性和原子性。
volatile不会造成线程的阻塞;synchronized可能会造成线程的阻塞。
volatile标记的变量不会被编译器优化;synchronized标记的变量可以被编译器优化。
2.5 synchronized 和 Lock 有什么区别?
首先synchronized是java内置关键字,在jvm层面,Lock是个java类;
synchronized无法判断是否获取锁的状态,Lock可以判断是否获取到锁;
synchronized会自动释放锁(a线程执行完同步代码会释放锁 ;b 线程执行过程中发生异常会释放锁),Lock需在finally中手工释放锁(unlock()方法释放锁),否则容易造成线程死锁;
用synchronized关键字的两个线程1和线程2,如果当前线程1获得锁,线程2线程等待。如果线程1阻塞,线程2则会一直等待下去,而Lock锁就不一定会等待下去,如果尝试获取不到锁,线程可以不用一直等待就结束了;
synchronized的锁可重入、不可中断、非公平,而Lock锁可重入、可判断、可公平(两者皆可);
Lock锁适合大量同步的代码的同步问题,synchronized锁适合代码少量的同步问题。
2.6 创建线程有几种方式
1.继承Thread类并重写 run 方法创建线程,实现简单但不可以继承其他类
2.实现Runnable接口并重写 run 方法。避免了单继承局限性,编程更加灵活,实现解耦。
3..实现 Callable接口并重写 call 方法,创建线程。可以获取线程执行结果的返回值,并且可以抛出异常。
4.使用线程池创建(使用java.util.concurrent.Executor接口)
2.7 Runnable和Callable的区别?
主要区别
Runnable 接口 run 方法无返回值;Callable 接口 call 方法有返回值,支持泛型
Runnable 接口 run 方法只能抛出运行时异常,且无法捕获处理;Callable 接口 call 方法允许抛出异常,可以获取异常信息。
2.8 如何启动一个新线程、调用start和run方法的区别?(必会)
线程对象调用run方法不开启线程。仅是对象调用方法。
线程对象调用start开启线程,并让jvm调用run方法在开启的线程中执行
调用start方法可以启动线程,并且使得线程进入就绪状态,而run方法只是thread的一个普通方法,还是在主线程中执行。

2.9 线程有哪几种状态以及各种状态之间的转换?(必会)
1. 第一是new->新建状态。在生成线程对象,并没有调用该对象的start方法,这是线程处于创建状态。
2. 第二是Runnable->就绪状态。当调用了线程对象的start方法之后,该线程就进入了就绪状态,但是此时线程调度程序还没有把该线程设置为当前线程,此时处于就绪状态。
3. 第三是Running->运行状态。线程调度程序将处于就绪状态的线程设置为当前线程,此时线程就进入了运行状态,开始运行run函数当中的代码。
4. 第四是阻塞状态。阻塞状态是线程因为某种原因放弃CPU使用权,暂时停止运行。直到线程进入就绪状态,才有机会转到运行状态。阻塞的情况分三种:(1)等待 – 通过调用线程的wait() 方法,让线程等待某工作的完成。(2)超时等待 – 通过调用线程的sleep() 或join()或发出了I/O请求时,线程会进入到阻塞状态。当sleep()状态超时、join()等待线程终止或者超时、或者I/O处理完毕时,线程重新转入就绪状态。(3)同步阻塞 – 线程在获取synchronized同步锁失败(因为锁被其它线程所占用),它会进入同步阻塞状态。
5. 第五是dead->死亡状态: 线程执行完了或者因异常退出了run()方法,该线程结束生命周期.
2.10 线程相关的基本方法?(必会)
线程相关的基本方法有wait,notify,notifyAll,sleep,join,yield 等
1.线程等待(wait)
调用该方法的线程进入WAITING 状态,只有等待另外线程的通知或被中
断才会返回,需要注意的是调用wait()方法后,会释放对象的锁。因此,wait 方
法一般用在同步方法或同步代码块中。
2.线程睡眠(sleep)
sleep 导致当前线程休眠,与 wait 方法不同的是 sleep 不会释放当前占
有的锁,sleep(long)会导致线程进入 TIMED-WATING 状态,而 wait()方法
会导致当前线程进入WATING 状态.
3.线程让步(yield)
yield 会使当前线程让出 CPU 执行时间片,与其他线程一起重新竞争
CPU 时间片。一般情况下,优先级高的线程有更大的可能性成功竞争得到 CPU
时间片,但这又不是绝对的,有的操作系统对线程优先级并不敏感。
4.线程中断(interrupt)
中断一个线程,其本意是给这个线程一个通知信号,会影响这个线程内部的
一个中断标识位。这个线程本身并不会因此而改变状态(如阻塞,终止等)
5.Join 等待其他线程终止
join() 方法,等待其他线程终止,在当前线程中调用一个线程的 join() 方
法,则当前线程转为阻塞状态,回到另一个线程结束,当前线程再由阻塞状态变
为就绪状态,等待cpu 的宠幸.
6.线程唤醒(notify)
Object 类中的 notify() 方法,唤醒在此对象监视器上等待的单个线程,如
果所有线程都在此对象上等待,则会选择唤醒其中一个线程,选择是任意的,并
在对实现做出决定时发生,线程通过调用其中一个wait() 方法,在对象的监视
器上等待,直到当前的线程放弃此对象上的锁定,才能继续执行被唤醒的线程,
被唤醒的线程将以常规方式与在该对象上主动同步的其他所有线程进行竞争。类
似的方法还有notifyAll() ,唤醒再次监视器上等待的所有线程。
2.11 wait()和sleep()的区别?(必会)
1. 来自不同的类wait():来自Object类;sleep():来自Thread类;
2.关于锁的释放:wait():在等待的过程中会释放锁;sleep():在等待的过程中不会释放锁3.使用的范围:wait():必须在同步代码块中使用;sleep():可以在任何地方使用;4.是否需要捕获异常wait():不需要捕获异常;sleep():需要捕获异常。
2.12 线程池的分类:
1.newCachedThreadPool:创建一个可进行缓存重复利用的线程池
2.newFixedThreadPool:创建一个可重用固定线程数的线程池,以共享的无界队列方式来运行这些线程,线程池中的线程处于一定的量,可以很好的控制线程的并发量
3.newSingleThreadExecutor:创建一个使用单个 worker 线程的Executor ,以无界队列方式来运行该线程。线程池中最多执行一个线程,之后提交的线程将会排在队列中以此执行
4.newSingleThreadScheduledExecutor:创建一个单线程执行程序,它可安排在给定延迟后运行命令或者定期执行
5.newScheduledThreadPool:创建一个线程池,它可安排在给定延迟后运行命令或者定期的执行
6.newWorkStealingPool:创建一个带并行级别的线程池,并行级别决定了同一时刻最多有多少个线程在执行,如不传并行级别参数,将默认为当前系统的CPU个数
2.13 核心
corePoolSize:核心线程池的大小maximumPoolSize:线程池能创建线程的最大个数keepAliveTime:空闲线程存活时间unit:时间单位,为keepAliveTime指定时间单位workQueue:阻塞队列,用于保存任务的阻塞队列threadFactory:创建线程的工程类handler:饱和策略(拒绝策略)
2.14 线程池的原理,或工作流程;
线程池的工作过程如下:
当一个任务提交至线程池之后,1. 线程池首先判断核心线程池里的线程是否已经满了。如果不是,则创建一个新的工作线程来执行任务。否则进入2. 2. 判断工作队列是否已经满了,倘若还没有满,将线程放入工作队列。否则进入3. 3. 判断线程池里的线程是否都在执行任务。如果不是,则创建一个新的工作线程来执行。如果线程池满了,则交给饱和策略来处理任务。
检查时间到:请拿出一张纸,凭借记忆绘画出一个任务来到线程池,并最后执行完毕的过程;未达标,请返工继续学习;
3.Mysql相关:(两个关键词:1.事务 2.索引)
学习建议:建议先将事务特性死记硬背下来,非常熟练,然后学习mysql的索引的结构(B+树),在弄懂这些之后,开始学习mysql的常见面试题;
3.1 基础概念扫盲
1.事务特性
原子性:即不可分割性,事务要么全部被执行,要么就全部不被执行。
一致性:事务的执行使得数据库从一种正确状态转换成另一种正确状态
隔离性:在事务正确提交之前,不允许把该事务对数据的任何改变提供给任何其他事务,
持久性:事务正确提交后,其结果将永久保存在数据库中,即使在事务提交后有了其他故障,事务的处理结果也会得到保存。
2.隔离级别
(1)读未提交(read Uncommited):
在该隔离级别,所有的事务都可以读取到别的事务中未提交的数据,会产生脏读问题,在项目中基本不怎么用, 安全性太差;(2) 读已提交(read commited):
这是大多数数据库默认的隔离级别,但是不是MySQL的默认隔离级别;这个隔离级别满足了简单的隔离要求:一个事务只能看见已经提交事务所做的改变,所以会避免脏读问题;由于一个事务可以看到别的事务已经提交的数据,于是随之而来产生了不可重复读和虚读等问题(下面详细介绍这种问题,结合问题来理解隔离级别的含义);(3 ) 可重复读(Repeatable read):
这是MySQL的默认隔离级别,它确保了一个事务中多个实例在并发读取数据的时候会读取到一样的数据;不过理论上,这会导致另一个棘手的问题:幻读 (Phantom Read)。简单的说,幻读指当用户读取某一范围的数据行时,另一个事务又在该范围内插入了新行,当用户再读取该范围的数据行时,会发现有新的“幻影” 行。InnoDB和Falcon存储引擎通过多版本并发控制(MVCC,Multiversion Concurrency Control)机制解决了该问题。(4) 可串行化(serializable):
事物的最高级别,它通过强制事务排序,使之不可能相互冲突,从而解决幻读问题。简言之,它是在每个读的数据行上加上共享锁。在这个级别,可能导致大量的超时现象和锁竞争,一般为了提升程序的吞吐量不会采用这个;
3.索引
1. 索引的概念和优点
概念:
索引存储在内存中,为服务器存储引擎为了快速找到记录的一种数据结构。索引的主要作用是加快数据查找速度,提高数据库的性能。
优点:
(1)创建唯一性索引,保证数据库表中每一行数据的唯一性
(2)大大加快数据的检索速度,这也是创建索引的最主要的原因
(3)加速表和表之间的连接,特别是在实现数据的参考完整性方面特别有意义。
(4)在使用分组和排序子句进行数据检索时,同样可以显著减少查询中分组和排序的时间。
2. 索引的分类
(1)普通索引:最基本的索引,它没有任何限制。
(2)唯一索引:与普通索引类似,不同的就是索引列的值必须唯一,但允许有空值。如果是组合索引,则列值的组合必须唯一。
常见:(3)主键索引:它是一种特殊的唯一索引,用于唯一标识数据表中的某一条记录,不允许有空值,一般用 primary key 来约束。
常见(4)联合索引(又叫复合索引):多个字段上建立的索引,能够加速复合查询条件的检索。
(5)全文索引:老版本MySQL 自带的全文索引只能用于数据库引擎为 MyISAM 的数据表,新版本 MySQL 5.6 的 InnoDB 支持全文索引。默认 MySQL 不支持中文全文检索,可以通过扩展 MySQL,添加中文全文检索或为中文内容表提供一个对应的英文索引表的方式来支持中文。
3. 索引的底层实现原理
1.索引结构
索引是在Mysql的存储引擎(InnoDB,MyISAM)层中实现的, 而不是在服务层实现的. 所以每种存储引擎的索引都不一定完全相同, 也不是所有的存储引擎都支持所有的索引类型的, Mysql目前提供了以下4种索引:
B+Tree 索引: 最常见的索引类型, 大部分索引都支持B+树索引.
Hash 索引: 只有Memory引擎支持, 使用场景简单.
R-Tree索引(空间索引): 空间索引是MyISAM引擎的一个特殊索引类型, 主要地理空间数据, 使用也很少.
S-Full-text(全文索引): 全文索引也是MyISAM的一个特殊索引类型, 主要用于全文索引, InnoDB从Mysql5.6版本开始支持全文索引.
2. BTree结构
B+Tree是在BTree基础上进行演变的, 所以我们先来看看BTree, BTree又叫多路平衡搜索树, 一颗m叉BTree特性如下:
(1)树中每个节点最多包含m个孩子.
(2)除根节点与叶子节点外, 每个节点至少有[ceil(m/2)] 个孩子(ceil函数指向上取整).
(3)若根节点不是叶子节点, 则至少有两个孩子.
(4)每个非叶子节点由n个Key和n+1个指针组成, 其中 [ceil(m/2) -1 ] <= n <= m-1.
以5叉BTree为例, key的数量: 公式推导 [ceil(m/2) -1 ] <= n <= m-1.
所以2 <= n <= 4, 中间节点分裂父节点,两边节点分裂.
3.B+Tree 结构
B+Tree为BTree的变种, B+Tree与BTree的区别:
1.B+Tree的叶子节点保存所有的key信息, 依key大小顺序排列.
2.B+Tree叶子节点元素维护了一个单项链表.
所有的非叶子节点都可以看作是key的索引部分.
由于B+Tree只有叶子节点保存key信息, 查询任何key都要从root走的叶子. 所以B+Tree查询效率更稳定.
Mysql中的B+Tree
MySql索引数据结构对经典的B+Tree进行了优化, 在原B+Tree的基础上, 增加了一个指向相邻叶子节点的链表指针, 就形成了带有顺序指针的B+Tree, 提高区间访问的性能.
MySql中的B+Tree索引结构示意图:
在此继续暂停,请拿出纸和笔,手绘出来mysql索引的B+树的结构,如果未成功,请返工继续学习或者尝试将自己不懂的部分,在百度上继续搜索,带着疑问探索答案,给自己的知识漏洞打补丁,直到可以自己画出mysql索引的结构;另外我在B站看到个讲mysql索引很不错的视频,
https://www.bilibili.com/video/BV1Qk4y1z7Rm?spm_id_from=333.337.search-card.all.click&vd_source=a7590eda6124f868169fbc17ecd5948c
可以跟着视频学习和做笔记,效果更棒!
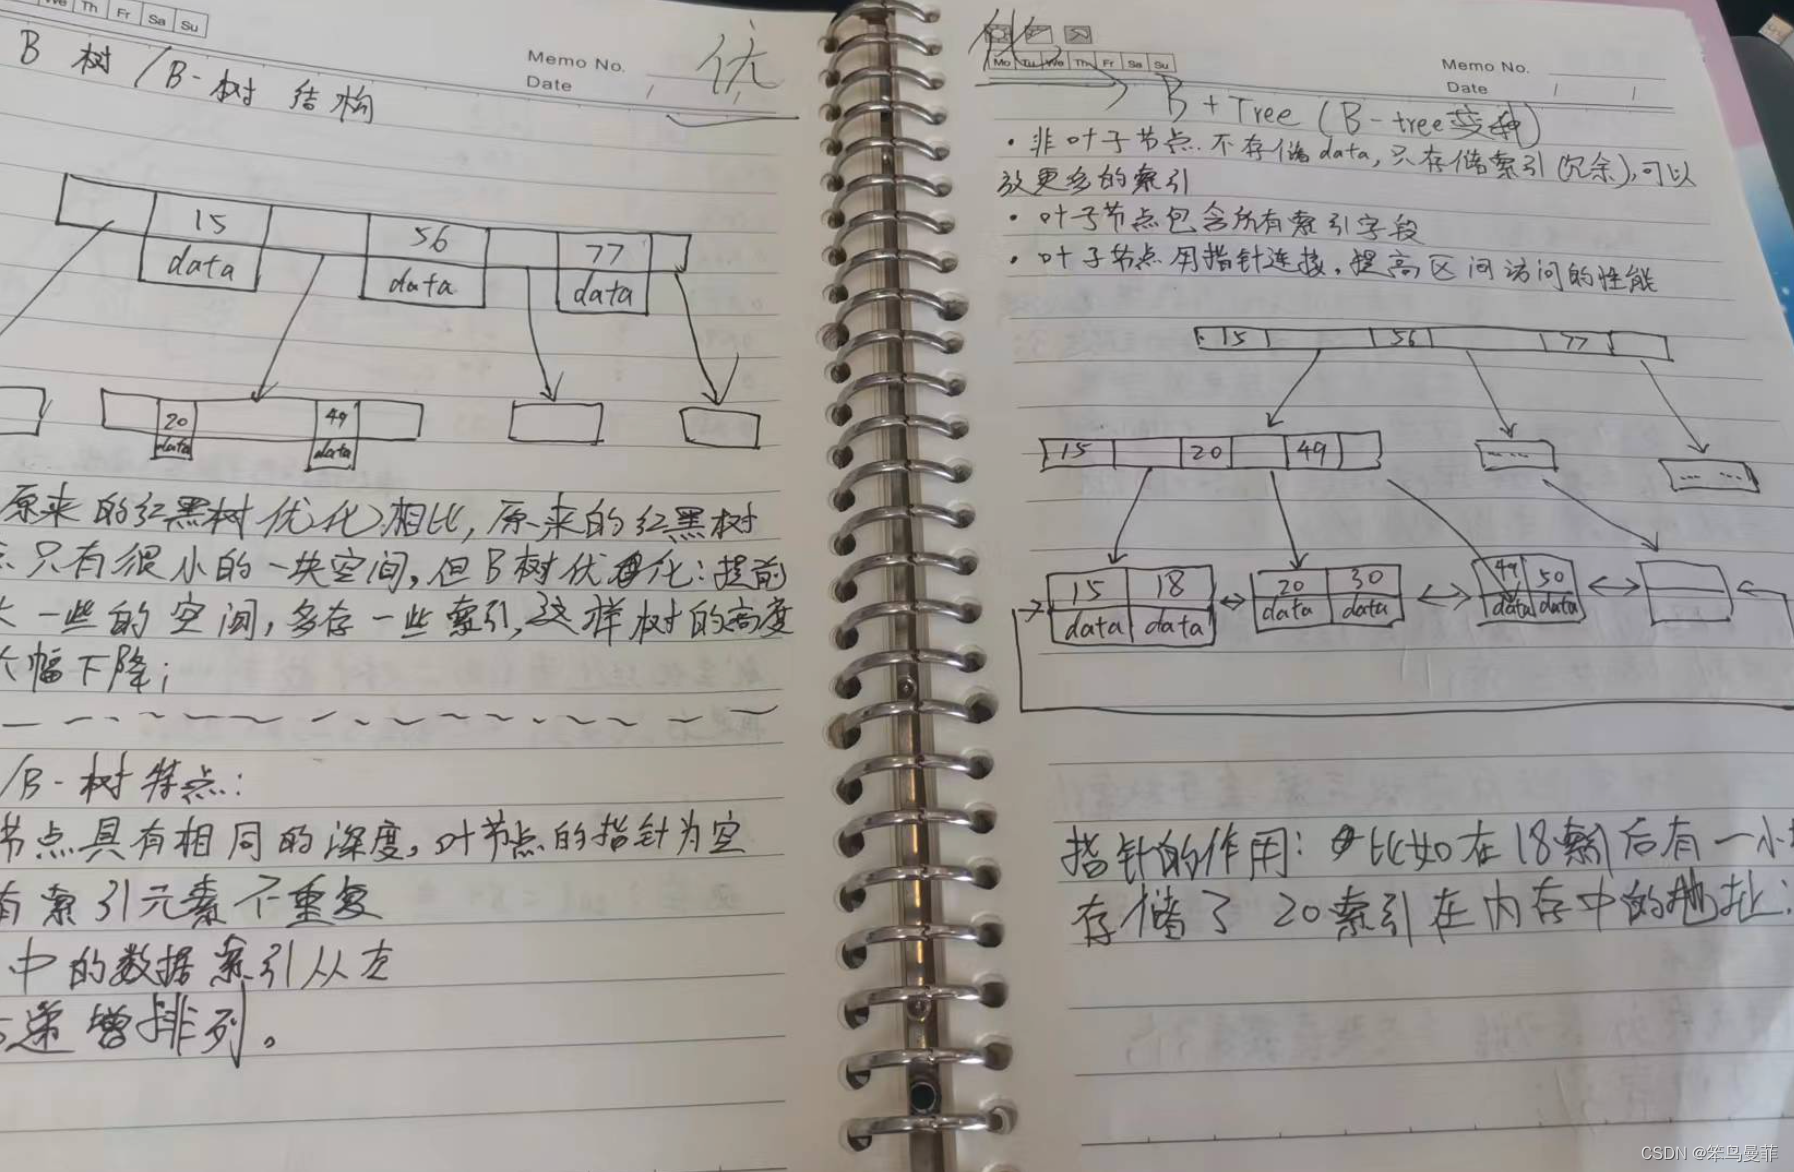
下面是我做的笔记中的一页,说实话,手写和手绘效果真的很不错;
3.2 mysql常见面试题
1.为什么mysql索引底层结构用B+而不是B树?
B- 树与 B+ 树的区别
B- 树
B 树又称为 B- 树,是一种平衡多路查找树,描述B树,一般需要指定其阶数 M,阶数指的是一个节点包含的子节点最大数量。
每个节点最多有 M - 1 个关键字
除根节点外,其余的节点至少有 ceil(M/2)-1 个关键字(ceil为向上取整)
每个节点中的关键字都按照从小到大的顺序排列,每个关键字的左子树中的所有关键字都小于它,而右子树中的所有关键字都大于它
所有叶子节点都位于同一层,或者说根节点到每个叶子节点的长度都相同
B+ 树
B+ 树包含两种节点,一种是非叶子节点(还有一种叫法是内节点),一种是叶子节点
B+ 树与 B 树,最大的不同是 B+ 树的非叶子节点不保存数据,只用于索引,所有数据都保存在叶子节点
非叶子节点最多有 M - 1 个关键字,阶数 M 同时限制了叶子节点最多存储 M - 1 个记录
索引节点中的 key 都按照从小到大的顺序排列,对于内部节点中的一个 key,左子树中的所有 key 都小于它,右子树中的 key 都大于等于它。叶子节点中的记录也按照 key 的大小排列
每个叶子节点都存有相邻叶子节点的指针,叶子节点本身依关键字的大小从小到大顺序连接(范围查找特性)
B树与 B+ 树的区别
B+ 树的层级更少:B+ 树非叶子节点上是不存储数据的,仅存储键值,叶子结点上存储数据,而 B 树节点中不仅存储键值,也会存储数据。所以一层中 B树可存储的数据就少;同时层级少了磁盘 IO 就少了查询的速度也就快了
B- 树查找到节点就可以返回数据,B+树如果是通过二级索引还需要回表查询(覆盖索引可以直接返回)
B+树天然具备排序功能:B+树所有的叶子节点数据构成了一个有序链表,在查询大小区间的数据时更方便,数据紧密型很高,缓存的命中率也会比B树高。
B+树全节点遍历更快:B+树遍历整棵树只需要遍历所有的叶子节点即可,而不需要像B树一样需要对每一层进行遍历
存储结构总结
二叉查找树(BST):解决了排序的基本问题,但是由于无法保证平衡,可能退化为链表
平衡二叉树(AVL):通过旋转解决了平衡的问题,但是旋转操作效率太低
红黑树:通过舍弃严格的平衡和引入红黑节点,解决了AVL旋转效率过低的问题,但是在磁盘等场景下,树仍然太高,IO次数太多
B树:通过将二叉树改为多路平衡查找树,解决了树过高的问题,但非叶子结点存储数据层级仍然不低
B+树:
在B树的基础上,将非叶节点改造为不存储数据的索引节点,进一步降低了树的高度
此外将叶节点使用指针连接成链表,范围查询更加高效
From:https://blog.csdn.net/weixin_48981805/article/details/122573761
2.什么是索引覆盖?
非聚簇索引查询
如果查询条件为普通索引(非聚簇索引),需要扫描两次B+树,第一次扫描通过普通索引定位到聚簇索引的值,然后第二次扫描通过聚簇索引的值定位到要查找的行记录数据。如:select * from user where age = 40;
反观聚簇索引(覆盖索引),如果用id和age建立了联合索引。
只需要在一棵索引树上就能获取SQL所需的所有列数据,无需回表,速度更快。
select id,age from user where age = 30;3.什么是最左匹配原则?
如果我们创建了(age, name)的组合索引,那么其实相当于创建了(age)、(age, name)两个索引,这被称为最佳左前缀特性。因此我们在创建组合索引时应该将最常用作限制条件的列放在最左边,依次递减。
有点抽象?那就打个比方,有去菜鸟拿过快递吗?快递小哥一般是怎么分类的,会按照某个标准,将快递分个编号 格式是 X-X-XXXX,依次含义为哪一个货架,哪一层,具体哪一个编号,如12-3-3443,在12货架,3层的3443,按照从左到右顺序查找,就类似与mysql的最左前缀法则,如果我现在告诉你的快递编号是3443,不告诉你前面的信息,你能很快找到吗?不能,为啥?因为打破了最左前缀法则,此时此刻,我告诉你12这个数字,就比告诉你 3-3443有用得多,现在是不是具体一些了,接着看mysql:
最左前缀匹配原则:在MySQL建立联合索引时会遵守最左前缀匹配原则,即最左优先,在检索数据时从联合索引的最左边开始匹配。
以组合索引(age, name)来画一下索引树结构:
4.索引设计原则
索引的设计需要遵循一些已有的原则, 这样便于提升索引的使用效率, 更高效的使用索引.
u对查询频次较高, 且数据量比较大的表, 建立索引.
u索引字段的选择, 最佳候选列应当从where子句的条件中提取, 如果where子句中的组合比较多, 那么应当挑选最常用, 过滤效果最好的列的组合.
u使用唯一索引, 区分度越高, 使用索引的效率越高.
u索引并非越多越好, 如果该表赠,删,改操作较多, 慎重选择建立索引, 过多索引会降低表维护效率.
u使用短索引, 提高索引访问时的I/O效率, 因此也相应提升了Mysql查询效率.
u如果where后有多个条件经常被用到, 建议建立符合 索引, 复合索引需要遵循最左前缀法则, N个列组合而成的复合索引, 相当于创建了N个索引.
复合索引命名规则index_表名_列名1_列名2_列明3
比如:create index idx_seller_name_sta_addr on tb_seller(name, status, address)
5.避免索引失效
u如果在查询的时候, 使用了复合索引, 要遵循最左前缀法则, 也就是查询从索引的最左列开始, 并且不能跳过索引中的列.
u尽量不要在 where 子句中对字段进行 null 值判断,否则将导致引擎放弃使用索引而进行全表扫描
u应尽量避免在 where 子句中使用 != 或 <> 操作符,否则将引擎放弃使用索引而进行全表扫描。
u不做列运算where age + 1 = 10,任何对列的操作都将导致表扫描,它包括数据库教程函数.计算表达式等, 都会是索引失效.
u查询 like,如果是 ‘%aaa’ 也会造成索引失效.
u应尽量避免在 where 子句中使用 or 来连接条件,如果一个字段有索引,一个字段没有索引,将导致引擎放弃使用索引而进行全表扫描
课后作业:
-
手绘一个默认长度的HashMap结构,并画出添加一对key-value的过程;
-
手绘JVM的内存模型图,堆内存模型图,且大致绘画出一个对象从入栈到出栈,及被GC回收的过程
-
手绘mysql的B+树联合索引的结构(name+age+place三个字段);
敢保证,假如这三个都做到了,面试题完全通过理解就可以记得很深刻;
到目前为止文字太多了,电脑卡住了,先更一期,剩下的下期更;
感谢bilibili的大量视频和知乎以及CSDN部分博客的文章,有大量现成的,就没必要自己码字了;

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)