kafka +spark streaming 流计算wordcount实例实现
一、Kafka简介

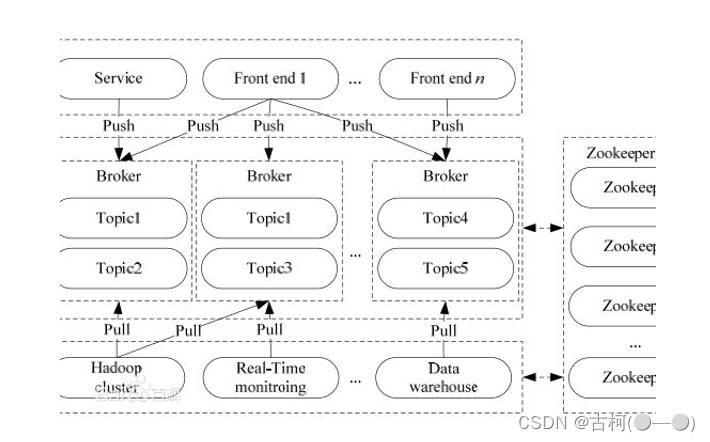
Broker
Kafka集群包含一个或多个服务器,这种服务器被称为broker
Topic
每条发布到Kafka集群的消息都有一个类别,这个类别被称为Topic。(物理上不同Topic的消息分开存储,逻辑上一个Topic的消息虽然保存于一个或多个broker上,但用户只需指定消息的Topic即可生产或消费数据而不必关心数据存于何处)
Partition
Partition是物理上的概念,每个Topic包含一个或多个Partition。
Producer
负责发布消息到Kafka broker
Consumer
消息消费者,向Kafka broker读取消息的客户端
Consumer Group
每个Consumer属于一个特定的Consumer Group(可为每个Consumer指定group name,若不指定group name则属于默认的group)
二、Kafka准备工作
安装kafka,测试kafka是否正常
kafka集群安装配置,外置zookeeper_古柯(●—●)的博客-CSDN博客
三、spark准备工作
1、添加相关jar包
Kafka和Flume等高级输入源,需要依赖独立的库(jar文件)
在spark-shell中执行下面import语句进行测试:
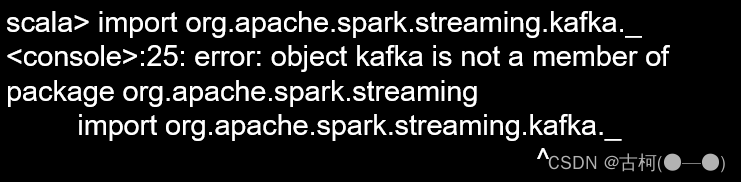
对于Spark2.1.0版本,如果要使用Kafka,则需要下载spark-streaming-kafka-0-8_2.11相关jar包,下载地址:
http://mvnrepository.com/artifact/org.apache.spark/spark-streaming-kafka-0-8_2.11/2.1.0
2、启动spark-shell
执行如下命令启动spark-shell:
$ cd  /usr/local/spark
$ ./bin/spark-shell  \
>--jars /usr/local/spark/jars/*:/usr/local/spark/jars/kafka/*
启动成功后,再次执行如下命令:
scala> import  org.apache.spark.streaming.kafka._
//会显示下面信息
import org.apache.spark.streaming.kafka._
四、 编写程序
1.生产者程序
该文件在/home/ZX/code/kafka/src/main/scala下2.消费者程序
该文件在/home/ZX/code/kafka/src/main/scala下
import java.util.HashMap
import org.apache.kafka.clients.producer.{KafkaProducer,ProducerConfig,ProducerRecord}
import org.apache.spark.SparkConf
import org.apache.spark.streaming._
import org.apache.spark.streaming.kafka010._
object KafkaWordProducer {
def main(args: Array[String]) {
	if (args.length < 4) {
		System.err.println("Usage: KafkaWordProducer <metadataBrokerList> <topic> " +"<messagesPerSec> <wordsPerMessage>")
		System.exit(1)
	}
	val Array(brokers, topic, messagesPerSec, wordsPerMessage) = args
	// Zookeeper connection properties
	val props = new HashMap[String, Object]()
	props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, brokers)
	props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG,"org.apache.kafka.common.serialization.StringSerializer")
props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG,
"org.apache.kafka.common.serialization.StringSerializer")
	val producer = new KafkaProducer[String, String](props)
	// Send some messages
	while(true) {
		(1 to messagesPerSec.toInt).foreach { messageNum =>
			val str = (1 to wordsPerMessage.toInt).map(x =>
					scala.util.Random.nextInt(10).toString).mkString(" ")
			print(str)
			println()
			val message = new ProducerRecord[String, String](topic, null, str)
			producer.send(message)
			}
		Thread.sleep(1000)
		}
	}
}
2.消费者程序
该文件在/home/ZX/code/kafka/src/main/scala下
import org.apache.spark._
import org.apache.spark.SparkConf
import org.apache.spark.rdd.RDD
import org.apache.spark.streaming._
import org.apache.spark.streaming.kafka010._
import org.apache.spark.streaming.StreamingContext._
import org.apache.spark.streaming.kafka010.KafkaUtils
import org.apache.kafka.common.serialization.StringDeserializer
import org.apache.spark.streaming.kafka010.LocationStrategies.PreferConsistent
import org.apache.spark.streaming.kafka010.ConsumerStrategies.Subscribe
object KafkaWordCount{
	def main(args:Array[String]){
		val sparkConf = new SparkConf().setAppName("KafkaWordCount").setMaster("local[2]")
		val sc = new SparkContext(sparkConf)
		sc.setLogLevel("ERROR")
		val ssc = new StreamingContext(sc,Seconds(10))
		ssc.checkpoint("file:///home/GHL/Group/ZX/kafka/checkpoint")
		 //设置检查点,如果存放在HDFS上面,则写成类似ssc.checkpoint("/user/hadoop/checkpoint")这种形式,但是,要启动Hadoop
		val kafkaParams = Map[String, Object]("bootstrap.servers" -> "10.103.105.93:9092","key.deserializer" -> classOf[StringDeserializer], "value.deserializer" -> classOf[StringDeserializer],"group.id" -> "use_a_separate_group_id_for_each_stream","auto.offset.reset" -> "latest", "enable.auto.commit" -> (true: java.lang.Boolean))
		val topics = Array("wordsender")
		val stream = KafkaUtils.createDirectStream[String, String](ssc,PreferConsistent,Subscribe[String, String](topics, kafkaParams))
		stream.foreachRDD(rdd => {
			val offsetRange = rdd.asInstanceOf[HasOffsetRanges].offsetRanges
			val maped: RDD[(String, String)] = rdd.map(record =>(record.key,record.value))
			val lines = maped.map(_._2)
			val words = lines.flatMap(_.split(" "))
			val pair = words.map(x => (x,1))
			val wordCounts = pair.reduceByKey(_+_)
			wordCounts.foreach(println)
		})
		ssc.start
		ssc.awaitTermination
	}
}
3.使用sbt打包编译程序
进入kafka目录下新建build.sbt如下:
name := "Simple Project"
version := "1.6.1"
scalaVersion := "2.12.11"
libraryDependencies += "org.apache.spark" %% "spark-core" % "3.1.1"
libraryDependencies += "org.apache.spark" %% "spark-streaming" % "3.1.1" % "provided"
libraryDependencies += "org.apache.spark" %% "spark-streaming-kafka-0-10" % "3.1.1"
libraryDependencies += "org.apache.kafka" % "kafka-clients" % "3.0.0"
4、运行
在/home/ZX/code/kafka/下进行:
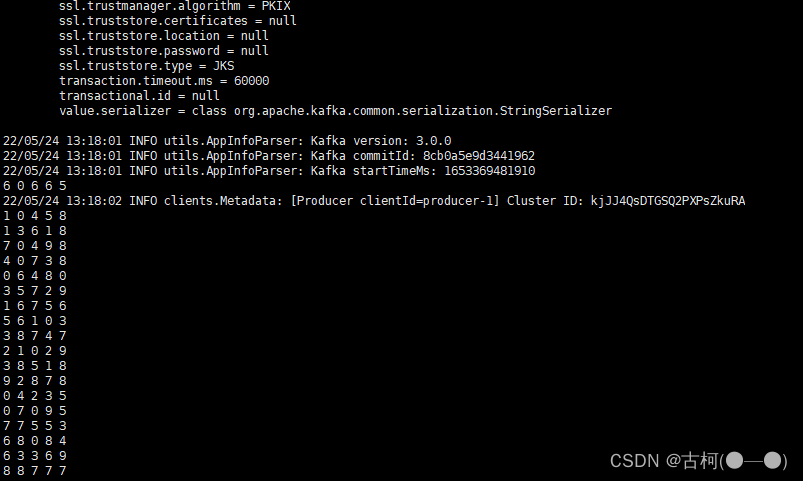
开启一个终端运行生产者程序,该终端必须有kafka进程运行,运行后不关闭当前终端
$SPARK_HOME/bin/spark-submit \
--class "KafkaWordProducer" \
./target/scala-2.12/simple-project_2.12-1.6.1.jar \
10.103.105.91:9092 wordsender 3 5
开启另一个终端运行消费者程序
$SPARK_HOME/bin/spark-submit \
--class "KafkaWordCount" \
./target/scala-2.12/simple-project_2.12-1.6.1.jar

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献6条内容

所有评论(0)