数据库连接池爆满排查与解决方案
一、紧急处置(快速恢复服务)
当问题发生时,首要目标是快速恢复服务,而不是立即定位根因。
-
重启应用服务:
-
这是最快、最有效(但最粗糙)的临时解决方案。重启会强制释放所有数据库连接,让连接池回到初始状态。
-
缺点:会导致所有在线用户会话中断,且不能根治问题,一段时间后可能再次爆满。
-
-
扩容与调整连接池参数(如果条件允许):
-
临时增加应用服务器实例:通过水平扩容来分担每个实例的连接池压力。
-
临时调高连接池最大连接数:这是一个有风险的操作,因为它可能将压力转移到数据库上,如果数据库本身已经不堪重负,这可能会压垮数据库。务必谨慎。
-
二、排查定位根本原因
在服务暂时稳定后,需要立即着手排查根本原因。核心思路是:连接被创建了,但没有被及时归还到池中。
1. 检查应用层代码:连接泄漏(最常见原因)
这是导致连接池爆满的头号元凶。表现为应用获取连接后,由于代码异常、分支逻辑等原因,没有执行 connection.close() 方法。
排查方法:
-
查看连接池监控:大多数连接池(如 HikariCP, Druid)都提供了丰富的监控端点。
-
关键指标:
-
activeConnections:活跃连接数。如果这个数值持续稳定在高位,甚至达到maxConnections,基本可以断定是连接泄漏。 -
idleConnections:空闲连接数。 -
threadsAwaitingConnection:等待获取连接的线程数。这个数很高说明连接池已经供不应求。
-
-
使用 Druid 的 Web 监控:如果项目用的是 Druid,访问
http://your-app/druid/index.html可以直观地看到 SQL 执行情况、活跃连接堆栈信息等,它能直接帮你定位到未关闭连接的代码位置。 -
使用 HikariCP 的 JMX:启用 JMX 后,使用 JConsole 或 JVisualVM 连接,可以查看
HikariPool的getActiveConnections等指标,并可以执行softEvictConnections来驱逐空闲连接。
-
-
代码审查:重点检查数据库操作代码。
-
是否使用了 Try-With-Resources(Java 7+ 推荐)?
java
// 正确写法:无论是否异常,连接都会被自动关闭 try (Connection conn = dataSource.getConnection(); PreparedStatement stmt = conn.prepareStatement(sql)) { // ... 业务逻辑 } catch (SQLException e) { // ... 异常处理 } -
在 finally 块中手动关闭了吗?
java
// 传统写法,务必在finally中关闭 Connection conn = null; PreparedStatement stmt = null; try { conn = dataSource.getConnection(); stmt = conn.prepareStatement(sql); // ... 业务逻辑 } catch (SQLException e) { // ... 异常处理 } finally { // 关闭顺序:后创建的先关闭 if (stmt != null) { try { stmt.close(); } catch (Exception e) {} } if (conn != null) { try { conn.close(); } // 这里才是将连接归还给池 } -
检查事务边界:使用了
@Transactional注解的方法,如果事务时间过长,也会导致连接被长时间占用。
-
2. 检查数据库层:慢查询与锁等待
如果应用层没有泄漏,那很可能是数据库本身出了问题,导致连接执行缓慢,无法快速释放。
排查方法:
-
查看数据库活动会话:
-
MySQL:执行
SHOW PROCESSLIST;命令,查看当前所有连接的状态。重点关注Command列为Sleep(空闲)但时间过长,或者Query状态但执行时间(Time列)非常长的连接。Info列会显示正在执行的 SQL。 -
PostgreSQL:
SELECT * FROM pg_stat_activity; -
Oracle:
SELECT sid, serial#, username, program, sql_id FROM v$session WHERE status = 'ACTIVE';
-
-
分析慢查询SQL:
-
从
SHOW PROCESSLIST中找到执行慢的 SQL。 -
使用
EXPLAIN命令分析这些 SQL 的执行计划,看是否缺少索引、是否全表扫描、是否负载过高等。
-
-
检查是否存在锁竞争:
-
MySQL:
SHOW ENGINE INNODB STATUS;查看TRANSACTIONS部分,关注锁等待信息。 -
长时间未提交的事务、表级锁、行级锁等待,都会导致后续请求挂起,占用连接不释放。
-
3. 检查流量与配置
-
流量突增:是否有促销活动、爬虫攻击或定时任务集中触发,导致并发请求远超平时?这会导致连接池被快速耗尽。
-
连接池配置不合理:
-
maxLifetime/maxAge设置过短?导致数据库侧连接被强制断开,而应用池不知道,拿到一个“僵尸连接”会报错,并可能触发重试,加剧问题。 -
connectionTimeout设置过长?线程等待连接时间太长,导致请求堆积。 -
maxPoolSize设置过小?无法支撑正常的业务并发量。
-
三、解决方案与最佳实践
根据排查出的原因,采取针对性措施。
-
修复代码泄漏:
-
强制使用 Try-With-Resources 语法。
-
代码审查中将其作为一项硬性规定。
-
使用代码扫描工具(如 Sonar)来检测潜在的资源泄漏。
-
-
优化数据库性能:
-
为慢 SQL 添加合适的索引。
-
优化复杂查询,避免
SELECT *,分批获取数据。 -
考虑读写分离,将报表类、统计类等大查询转移到只读库。
-
-
合理配置连接池:
-
HikariCP 推荐配置:
properties
# 连接池大小 = (核心数 * 2) + 有效磁盘数,例如 4核服务器可设为 10
spring.datasource.hikari.maximum-pool-size=10
# 连接最大生命周期,建议略小于数据库的 wait_timeout
spring.datasource.hikari.max-lifetime=600000 // 10分钟
# 连接超时时间,默认30秒,可根据情况调低
spring.datasource.hikari.connection-timeout=30000
# 空闲连接超时时间,建议10分钟
spring.datasource.hikari.idle-timeout=600000
# 泄漏检测,用于调试,生产环境慎用(有性能开销)
# spring.datasource.hikari.leak-detection-threshold=60000
-
根据实际业务压力和数据库承载能力进行调整。
-
-
引入熔断与降级机制:
-
当连接池无法获取连接时,不应无限等待,应快速失败(通过设置合理的
connectionTimeout)。 -
在应用层,对于非核心功能,可以在数据库压力大时进行服务降级,返回兜底数据,保护核心链路。
-
总结排查流程图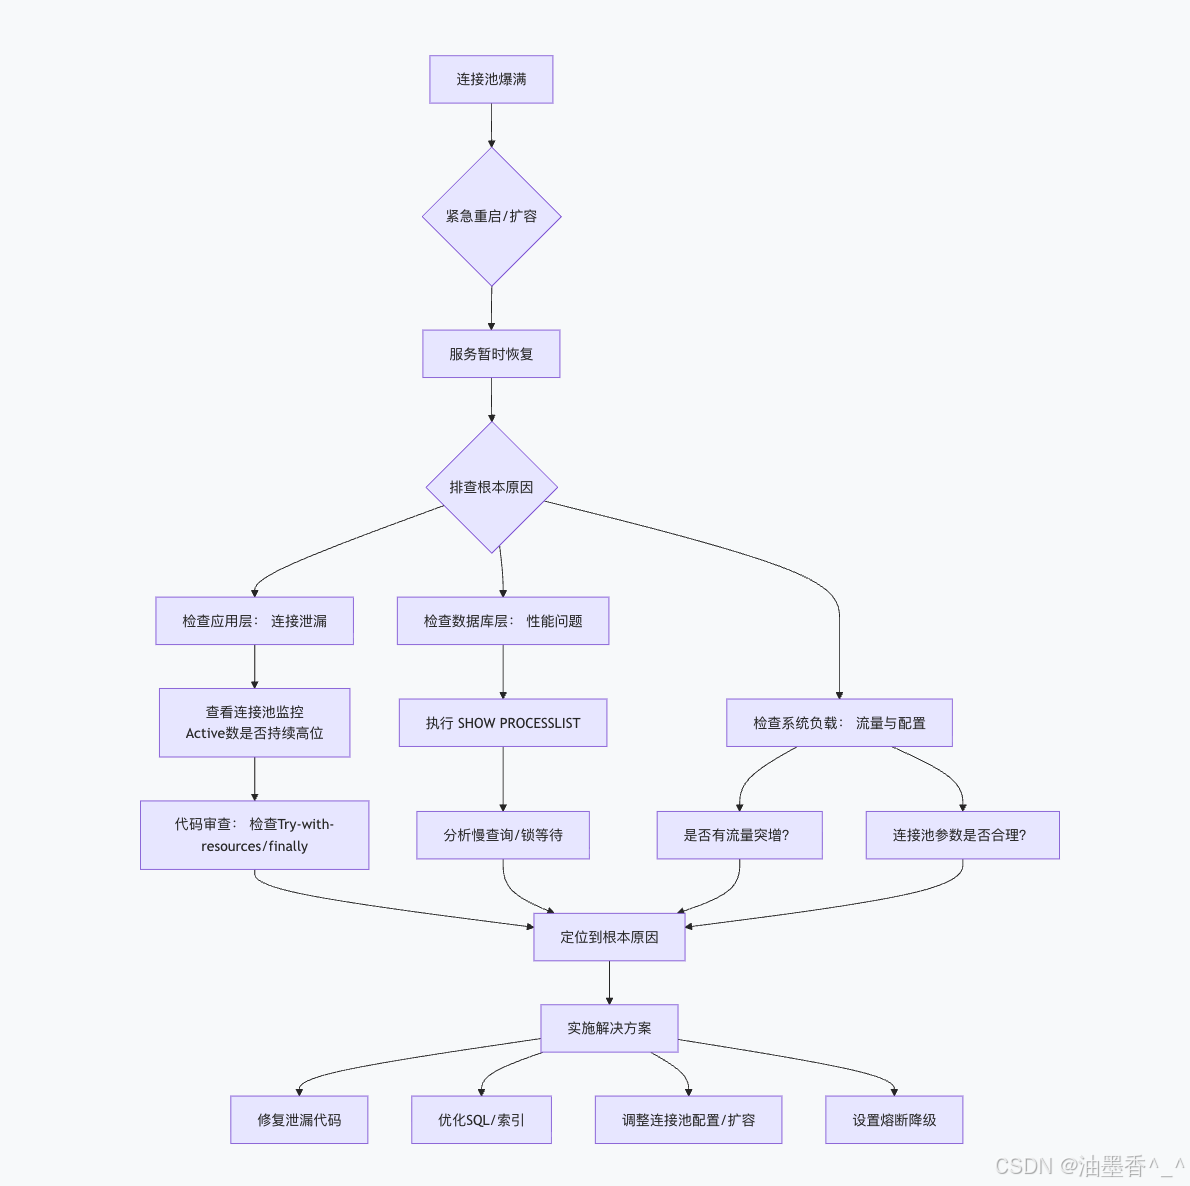
通过以上系统性的排查和解决,你不仅能快速扑灭当前的“火灾”,还能从根本上提升系统的稳定性和健壮性。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献13条内容

所有评论(0)