pandas数据载入与预处理
一:提出问题:
哪些课程最受欢迎?什么类别的课程最受欢迎?
人们更喜欢Harvard还是MITx的课?
二:理解数据:
数据来源: 数据竞赛平台Kaggle
Your Home for Data Sciencewww.kaggle.com/
共有23个字段,一共290门在线课程。数据分为4种类型
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False
%matplotlib inline
fdata = pd.read_csv('f:/anaconda/data/appendix.csv')
fdata.head()1、课程字段
Institution,学校
Course Number,课程ID
Launch Date,上线时间
Course Title,课程名
Instructors,讲师
Course Subject,课程类别
Year,课程持续时间
Honor Code Certificates,是否授予证书
2、数量字段
Participants (Course Content Accessed),学生数
Audited (> 50% Course Content Accessed),完成50%课程的学生数
Certified,拿到证书的人数
Total Course Hours (Thousands),总课程时间(千小时)
Median Hours for Certification,取得证书时间中位数
3、百分比字段
% Audited,完成50%课程学员的比例
% Certified,拿到证书的学员比例
% Certified of > 50% Course Content Accessed,完成课程50%学员拿到证书的比例
% Played Video,视频播放率
% Posted in Forum,论坛张贴率
% Grade Higher Than Zero,分数高于0的比例
4、用户情况字段
Median Age,年龄中位数
% Male,男性学员占比
% Female,女性学员占比
% Bachelor's Degree or Higher, 本科学历及以上比例
#修改列名
fdata.rename(columns={'Institution':'学校','Course Number':'课程ID','Launch Date':'上线时间','Course Title':'课程名'},inplace=True)
fdata.rename(columns={'Instructors':'讲师','Course Subject':'课程类别','Year':'课程持续时间','Honor Code Certificates':'是否授予证书'},inplace=True)
fdata.rename(columns={'Participants (Course Content Accessed)':'学生数','Audited (> 50% Course Content Accessed)':'完成50%课程的学生数','Certified':'拿到证书的人数','Total Course Hours (Thousands)':'总课程时间(千小时)'},inplace=True)
fdata.rename(columns={'Median Hours for Certification':'取得证书时间中位数','% Audited':'完成50%课程学员的比例','% Certified':'拿到证书的学员比例','% Certified of > 50% Course Content Accessed':'完成课程50%学员拿到证书的比例'},inplace=True)
fdata.rename(columns={'% Played Video':'视频播放率','% Posted in Forum':'论坛张贴率','% Grade Higher Than Zero':'分数高于0的比例','Median Age':'年龄中位数'},inplace=True)
fdata.rename(columns={'% Male':'男性学员占比','% Female':'女性学员占比',"% Bachelor's Degree or Higher":'本科学历及以上比例'},inplace=True)
fdata.head(2)
三、数据清洗
1、选择子集(这里没有给出代码)
根据问题需要,选择数据子集。
数据集中Course Number课程ID为唯一标识,保留该字段。
学校字段Institution是我们提出问题中的一个,需要保留。
课程持续时间Year、总课程时长Total Course Hours (Thousands)对数据分析没有帮助,隐藏起来。
2、列名重命名
由于数据集为全英文,为方便理解、描述,将字段进行重命名,采用中文形式。
3、删除重复值
以课程ID作为数据集唯一标识,通过数据>删除重复值操作,删除重复数据,发现重复值102条,虽然课程ID与课程名称重复,但是课程讲师或上线日期不同。
fdata1 = fdata.drop_duplicates('课程ID')
fdata1.head(2)
fdata1.count()
根据上述情况,做辅助列,输入公式=B2&C2&E2,以课程ID+上线时间+讲师姓名,作为数据唯一标识,再次执行重复值删除。发现1条重复数据,剩余289条数据。
fdata2 = fdata.drop_duplicates(['课程ID','上线时间','讲师'])
fdata2.head(2)
fdata2.count()
4、缺失值处理
以唯一标识列:课程ID+上线日期+讲师进行计数,共计289条数据,以此为标准,查看其它列数据是否有缺失。
fdata3 = fdata.set_index(['课程ID','上线时间'])
#查看缺失值的个数
fdata4 = fdata.isnull().sum()
#查看对应缺失值的课程id并得到需要添加的讲师名称(出现次数最多的老师)
fdata5 = fdata.loc[fdata['课程ID']=='CS50x']
#fdata5.head()
name = fdata5['讲师'].mode()
#name.head()
print(name[0])
对比发现,讲师字段缺少一个数据,根据课程ID进行筛选,发现本课程共有4条数据,除2012年为几位讲师一起,2014、2015年该课程均为David Malan讲授,所以可以推断,2016年该课程依然是David Malan讲师进行授课,以此为依据,补全数据。
#修改缺失值,并存放
fdata3['讲师']= fdata3['讲师'].fillna(name[0])
fdata3.head()
#查看修改的情况
fdata3.loc[fdata['课程ID']=='CS50x']
5、排序
我们关系哪些课比较受学员欢迎,所以根据学生数,对数据进行将序排列。审视数据集,未发现异常格式、异常值,所以不需进行一致化、异常值处理。
#根据学生数进行排序
fdata5 = fdata3.sort_values(by = '学生数',ascending=False)
fdata5.head(291)
四、构建模型
1、哪些课程最受欢迎?什么类别的课程最受欢迎?
插入数据透视表,行标签选择课程名,对学生数求和,结果发现最受学员欢迎的课程为Introduction to Computer Science,学员数为690059.
查看课程类别发现,课程共分为四大类:
Computer Science,计算机科学
Science, Technology, Engineering, and Mathematics,科学、技术、工程和数学
Humanities, History, Design, Religion, and Education,人文、历史、设计、宗教和教育
Government, Health, and Social Science,政治、健康和社会科学
#四:构建模型,最受欢迎的课程:
#方法一:
#fdata6 = fdata5['学生数'].groupby(fdata5['课程名']).sum()
#print(type(fdata6))
#fdata6 = fdata6.sort_values(ascending=False)
#fdata6.head()
#方法二:
table = fdata5.pivot_table(values=['学生数'],index=['课程名'],margins=True,aggfunc=np.sum)
#table.query("课程名=='A Global History of Architecture'")
table.sort_values(by='学生数',ascending=False)
插入透视表进行统计,行标签为课程类别,对学生数求和,发现计算机科学领域最受学员欢迎
#查看课程类别
#方法一:
#fdata7 = fdata5['学生数'].groupby(fdata5['课程类别']).sum()
#fdata7 = fdata7.sort_values(ascending=False)
#fdata7.head()
#方法二:
table1 = fdata5.pivot_table(values=['学生数'],index=['课程类别'],margins=True,aggfunc=np.sum)
#table1.query("课程名=='A Global History of Architecture'")
table1.sort_values(by='学生数',ascending=False)
2、人们更喜欢Harvard还是MITx的课?
#人们更喜欢Harvard还是MITx的课?
#方法一:
#fdata8 = fdata5['学生数'].groupby(fdata5['学校']).sum()
#fdata8 = fdata8.sort_values(ascending=False)
#fdata8.head()
#方法二:
table1 = fdata5.pivot_table(values=['学生数'],index=['学校'],margins=True,aggfunc=np.sum)
#table1.query("课程名=='A Global History of Architecture'")
table1.sort_values(by='学生数',ascending=False)
插入透视表进行统计,行标签为学校名称,对学生数求和,发现MITx更受学员欢迎
插入透视图,行标签为课程类别,列标签为学校名称,对课程名计数,可以发现两所学校中,HarvardX上线课程129门,其中人文、历史、设计、宗教和教育类课程数量为80门,占大部分。科学、技术、工程和数学,计算机科学领域课程极少,说明该所学校为人文类学校。
MITx学校上线160门课程,最多的课程是科学、技术、工程和数学类,其余三个领域数量占比接近50%,相对属于工科综合院校。
#MITx学校上线160门课程,最多的课程是科学、技术、工程和数学类,其余三个领域数量占比接近50%,相对属于工科综合院校。
#方法一:
#fdata9 = fdata5.groupby(['学校','课程类别'])['课程名'].count()
#fdata9 = fdata5.groupby(['学校','课程类别'],as_index=False)['课程名'].count()
#fdata9.pivot_table(index='课程类别',columns='学校')
#fdata9.head(20)
#方法二:
table = fdata5.pivot_table(values=['课程名'],index=['课程类别'],columns='学校',margins=True,aggfunc='count')
#table.query("课程名=='A Global History of Architecture'")
#table.sort_values(by='学生数',ascending=False)
display(table)
尽管HarvardX院校开设的计算机科学课程只有四门,但是学员选修数量却比MITx还要多,所以可以断定,学员最喜欢的是HarvardX学校的计算机科学课程。
#尽管HarvardX院校开设的计算机科学课程只有四门,但是学员选修数量却比MITx还要多,所以可以断定,学员最喜欢的是HarvardX学校的计算机科学课程。
#方法一:
#fdata9 = fdata5.groupby(['学校','课程类别'])['学生数'].sum()
#fdata9 = fdata5.groupby(['学校','课程类别'],as_index=False)['课程名'].count()
#fdata9.pivot_table(index='课程类别',columns='学校')
#fdata9.head(20)
#方法二:
table = fdata5.pivot_table(values=['学生数'],index=['课程类别'],columns='学校',margins=True,aggfunc=np.sum)
#table.query("课程名=='A Global History of Architecture'")
#table.sort_values(by='学生数',ascending=False)
display(table)
综上,根据选课人数来判断,MITx吸引了更多学员,从课程类型看,HarvardX院校开设了大量的人文、历史、设计、宗教和教育类课程。MITx院校开设了大量科学、技术、工程和数学类课程。学员最喜欢的是计算机科学类课程,其次是科学、技术、工程和数学类。对人文、历史、设计、宗教和教育类的课程,学员最不喜欢。HarvardX院校的计算机科学类课程,最受学员欢迎。
3、课程完成度如何?用户学习状况是怎样的?
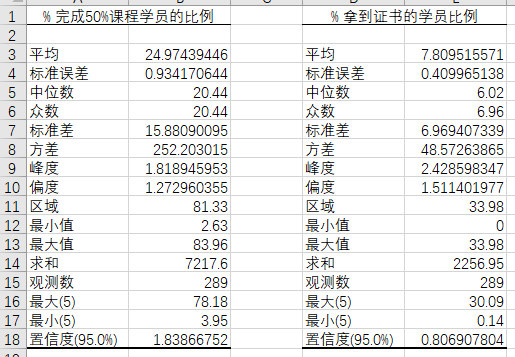
使用excel的数据分析,对完成课程50%以上学生数据、拿到证书学生数据进行描述统计。
#使用excel的数据分析,对完成课程50%以上学生数据、拿到证书学生数据进行描述统计。
fdata5[['完成50%课程学员的比例','拿到证书的学员比例']].describe()
通过数据可以得知,完成课程50%以上的学员比例在2.63%~83.96%浮动,平均数为24.97%,中位数为20.44%,拿到证书的学员占比在0~33.98%浮动,平均值为7.81%,中位数为6.02%,可见大部分学员的学习状况不佳,大部分用户没能坚持学习下来。
4、使用edx的是什么样的用户?
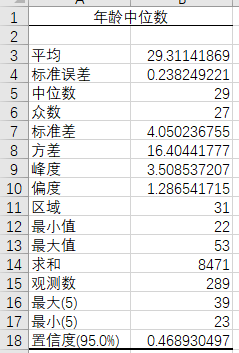
从年龄来看,学员年龄处在22岁~53岁区间,主要是大学毕业后的社会工作人员。平均值为29岁,中位数为29岁。基本处于工作后的6年左右。这部分用户经过过去几年的工作积累,有继续深造,提高职场竞争力的需求。部分用户面临职业重新定向选择,希望进行新领域学习。根据受用户欢迎课程分析,用户对计算机科学、理工类课程需求明显。
#使用edx的是什么样的用户?
#从年龄来看,学员年龄处在22岁~53岁区间,主要是大学毕业后的社会工作人员。
#平均值为29岁,中位数为29岁。基本处于工作后的6年左右。
#这部分用户经过过去几年的工作积累,有继续深造,提高职场竞争力的需求。
#部分用户面临职业重新定向选择,希望进行新领域学习。根据受用户欢迎课程分析,用户对计算机科学、理工类课程需求明显。
display(fdata5[['年龄中位数']].describe())
从男女性占比来分析,男性学员占比达到了67%,女性学员占比为33%,可见在29岁这个年龄段,男性对事业的追求促使他们进行学习深造。而女性更多的会回归家庭。该平台以男性学员为主,男女比例差别大。
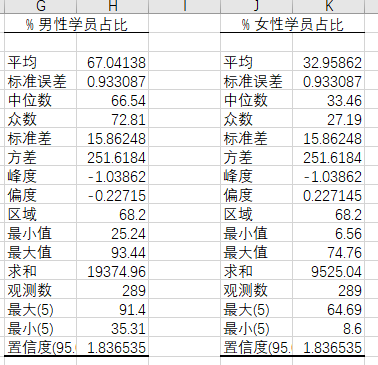
#从男女性占比来分析,男性学员占比达到了67%,女性学员占比为33%,可见在29岁这个年龄段,男性对事业的追求促使他们进行学习深造。
#而女性更多的会回归家庭。该平台以男性学员为主,男女比例差别大。
fdata5[['男性学员占比','女性学员占比']].describe()
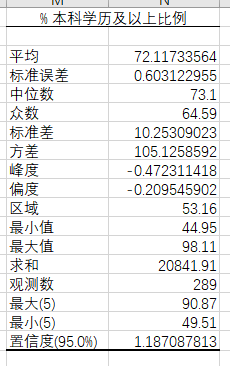
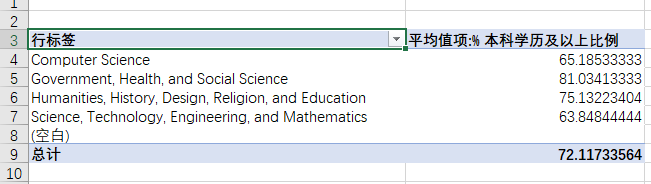
从学历情况来分析,本科及以上学历比例在44.95%-98.11%,平均值为72.11%,中位数为73.1%,该平台用户大部分具有高学历,其中政治、健康和社会科学领域和人文、历史、设计、宗教和教育领域高学历占比高。而计算机科学,科学、技术、工程和数学领域本科及以上学历比例低。根据上述数据分析,可以发现该平台的主要用户主要为本科及以上学历。高学历用户更喜欢学习人文社科类课程。而理工类课程由于实用性强,更受较低学历用户青睐。
display(fdata5[['本科学历及以上比例']].describe())
table1 = fdata5.pivot_table(values=['本科学历及以上比例'],index=['课程类别'],margins=True,aggfunc=np.mean)
table1.sort_values(by='本科学历及以上比例',ascending=False)
综上所述。edX平台用户主要为30岁左右社会职场人士,具有高学历特征。主要以男性为主,以通过深造学习,提升职场竞争力为目标。
五、初步结论
通过上面分析,可以得到以下分析结论:
1、EdX在线教育平台,最受欢迎的是计算机科学课程 introdution to computer science,用户们最关注的的课程类别是计算机科学。该类课程需求很大,30%以上的用户曾经进行这方面课程的学习。而目前该平台上相关课程数量并不是很多,未来可以针对这方面课程进行大力开发。
2、Harvard主要开设人文社科类课程。MITx开设了大量科学技术工程类课程。两所院校特征明显。为学员提供多种选择。Harvard的计算机科学,人文、历史、设计、宗教和教育类课程更受欢迎。MITx的课程,除人文、历史、设计、宗教和教育类课程外,均受到用户欢迎。建议两所院校发挥自己的优势,开发自己擅长的课程类别。从而从课程内容上,进行优化。
3、在平台坚持学习50%以上课程内容的用户不多,最终拿到证书的人更少。原因可能是课程难度设置过高、学员学习惰性导致。可以降低课程难度梯度,缩短课程长度,分解成小课,方便碎片化学习。
4、该平台学习用户,大部分为职场男性,本科及以上学历占比大。学习目的主要是通过深造,提升职场竞争力。在课程开发方面,可以尝试提高课程实用性。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献6条内容

所有评论(0)