【性能测试】数据库常见的性能问题及优化
数据库常见的性能问题及优化
1. 慢查询
sql执行耗时超过设定的阈值
原因: 索引未建立或者不合理, 查询量大, 存在锁
1.1 建议排查方向
- show命令查看慢查询数量
- 具体分析慢查询日志, 找到问题所在的sql
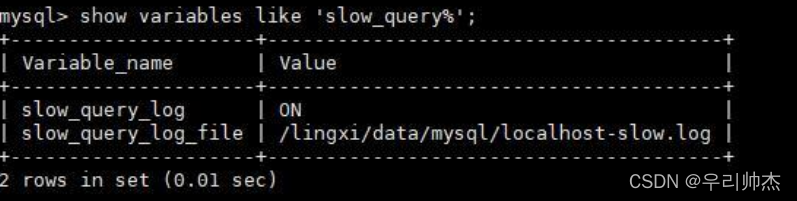
- 查看慢查询是否开启: show variables like “slow_query%”;
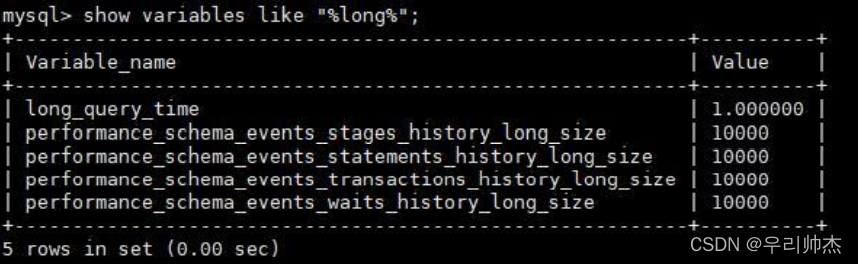
- 查看慢查询时间设置: show variables like “%long%”;
- 命令方式开启: set global slow_query_log = ‘ON’;
- 设置慢查询为1s : set global long_query_time = 1;
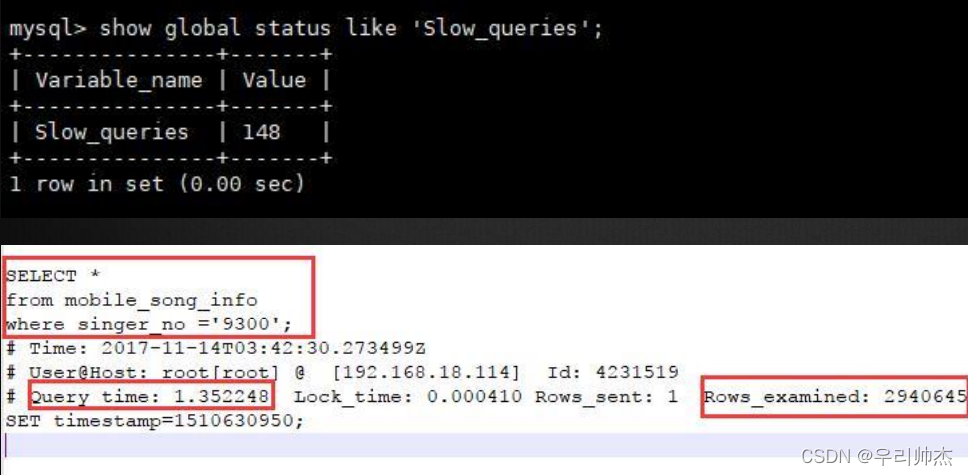
- 查看慢查询日志:
- show global status like ‘Slow_queries’;
- select * from mobile_song_info where singer_no=‘9300’;
2. CPU占用高
原因:
- 代码逻辑错误, sql被错误执行
- 执行时进行大量扫描操作(未命中索引)
2.1 建议排查方向
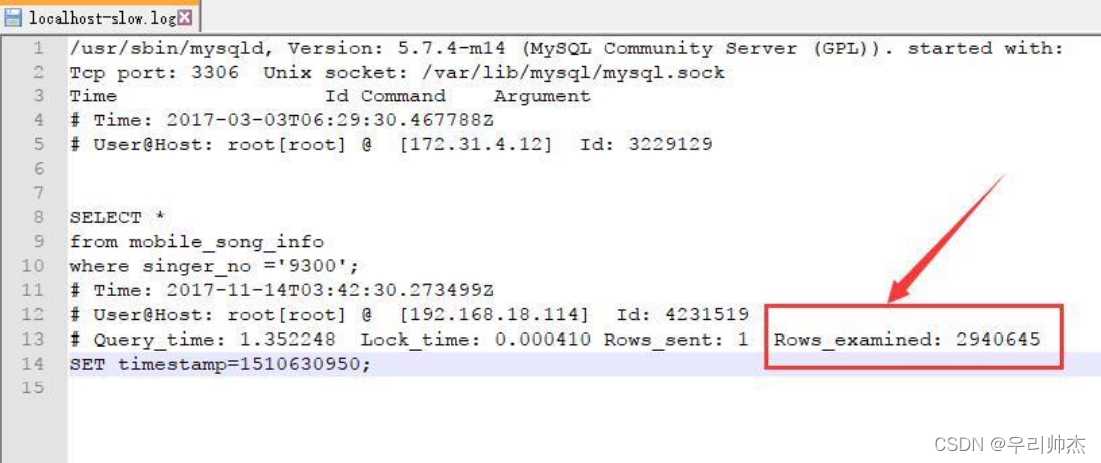
- 分析慢查询日志(Row_exmind为查询扫描记录数)
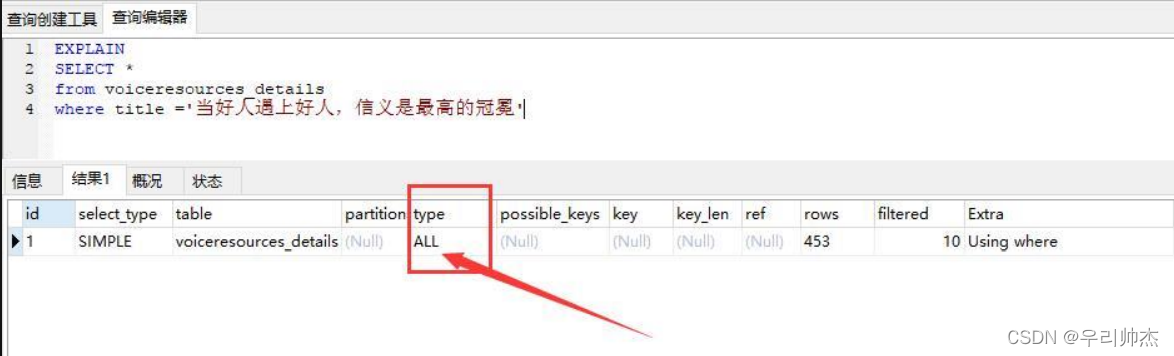
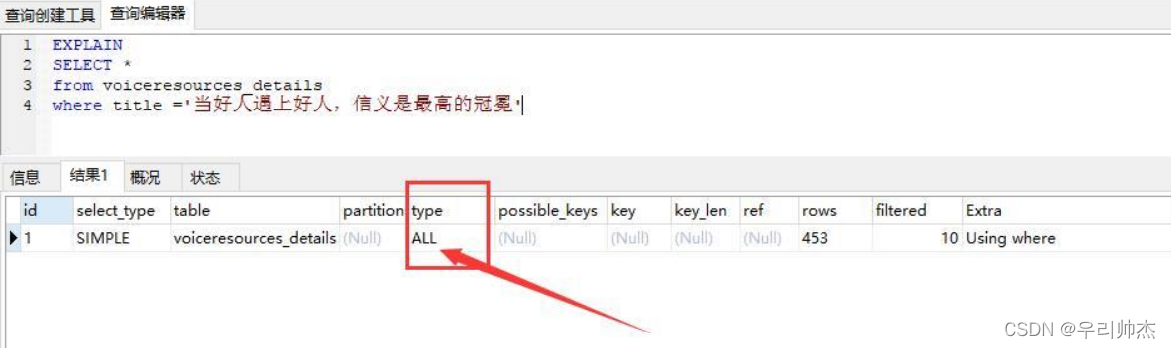
- Explain分析sql执行计划
-
type为all时表示全表扫描, 一般存在问题
-
explain select * from voiceresources details where title = ‘123’;
-
3. 连接数不够
产生原因:
- 数据库配置不合理, 默认为100
- 命令修改: set golbal max_connections = 1024;
- 配置修改: /etc/my.cnf max_connections = 1024;
- 重启: service mysqld restart
- 慢查询导致IO阻塞, 连接长时间得不到释放
- 慢查询不是及时可以看到的, 一般当一个sql执行完才能判断是否为慢查询
- 代码缺陷sql执行完, 连接未释放
- 通过监控组件的文件描述符数
3.1 监控指标
- 连接数使用率
- 使用最大连接数:
show global status like ‘Max_used_connections’; - 设置最大连接数
show variables like ‘%max_connections%’; - 使用率
Max_used_connection ÷ max_connections - 建议
10% < 使用率 < 85%
- 使用最大连接数:
4. 缓存命中率低
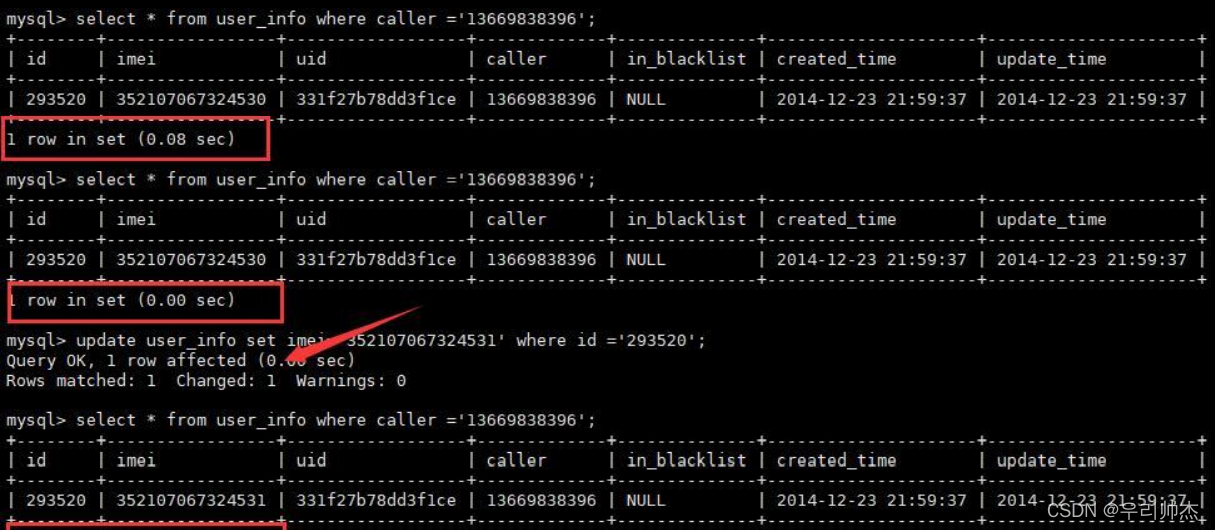
查询缓存
1. 当查询接收到一个和以前一样的查询, 服务器将会以查询缓存中检索结果, 而不是再次分析和执行相同的查询, 这样就大大提高查询性能
2. 查询缓存是否开启: show variables likes “%query_cache%”;
3. 开启缓存: set session query_cache_type = ON;
4.1 监控指标: 查看缓存的命中率
- 计算方法
-
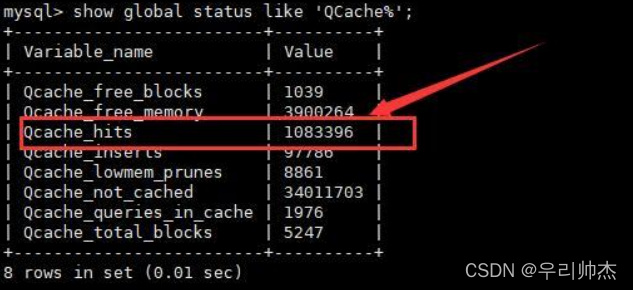
命中次数:
query_hit: show global status like ‘QCache%’
-
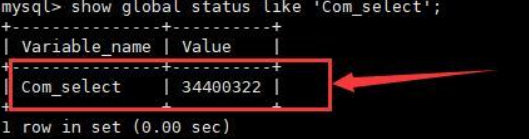
实际执行查询次数(未命中缓存次数)
Com_select: show global status like ‘Com_select’;
-
命中率: Qcache_hits ÷ (Qcache + Com_select)
-
命中率低时可以考虑调优参数:
query_cache_size: 分配给查询缓存的内存大小
query_cache_limit: 表示查询的单个结果集所被允许的缓存的最大值
-
5. 死锁
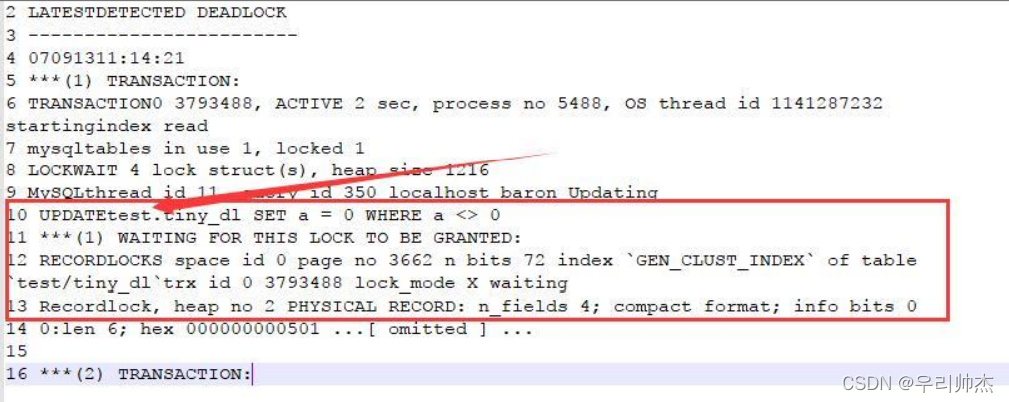
两个或两个以上的进程在执行过程中, 因争夺资源而造成的一种互相等待的现象
监控死锁: show engine innodb status\G;
数据库性能问题定位方法
1. explain分析
- 表的读取顺序
- 表的读取操作的操作类型
- 哪些索引可以使用
- 实际命中索引
- 表之间的引用
- 每张有多少行被检索
1.2. 在sql语句前面加上explain关键字
explain select * from tableA where id = 1
- id: 语句的执行顺序标识, 优先级越高, 越先执行
- select_type: 查询类型
- simple: 简单类型
- primary: 若包含任何复杂的子部分, 最外层查询被标记为primary
- union: 连表查询时, union之后的select, 则被标记为union第一个select为primary
- table: 访问列表名称
- type: 重要, 访问类型, 有无使用索引
性能从最好到最差: system contest eq_reg ref range index all- system: const的一个特例, 表中只有一条记录时发生
- const: where条件被转换成常量, 只读取一次数据就能获取结果, 最多有一条记录匹配(主键, 唯一索引)
- eq_ref: 走索引, 返回单行的数据.(连表查询时出现, 主键或唯一索引)
- ref: 走索引, 返回的数据可以是多行, 通常使用等于时发生(普通索引)
- range: 用了索引, 进行范围扫描, 常用于between, <, >, in等操作
- index: 全索引扫描, 最简单的例子, select id from table
- all: 全表扫描(可能存在问题, 一般重点关注)
- possible_keys: 可以利用索引, 如果无索引, 为null
- key: 从possible_keys中所选择使用的索引
- rows: 结果集条数
- Extra:
- using index: 只用索引, 可以避免访问表
- using where: 使用到where来过滤数据, 不是所有的where都要显示using where(访问了索引, 显示为using index)
- nusing tmporary: 用到临时表
- nusing filesort: 用到额外的排序
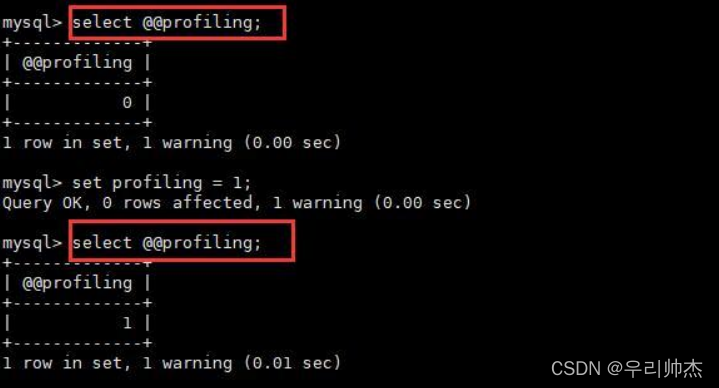
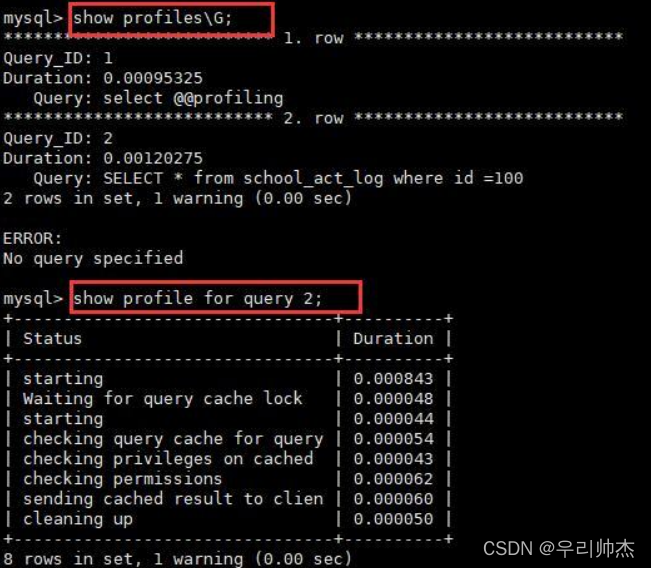
2. profiling分析
可以获取一条SQL语句在整个执行过程中多个资源的消耗情况, 包括每一步的耗时, 和每一个资源(CPU/IO等)消耗
- 查询profiling是否开启: select @@profiling
- 开启profiling: set profiling = 1;(只针对当前用户有效, 每次重新开启)
- 得到被执行的sql语句的时间和ID: show profiles\G;
- 得到对应sql语句执行的详细信息: show profile for query 1;
- 具体到CPU: show profile CPU for query 1;
3. 慢查询分析
-
查看是否开启: show variables like ‘slow_query%’;
-
查看慢查询时间设置: show variables like ‘%long%’;
- 命令方式开启(动态生效):
set global slow_query_log = “ON”;
设置慢查询为1s: set global long_query_time = 1;
- 命令方式开启(动态生效):
使用JMeter测试SQL性能
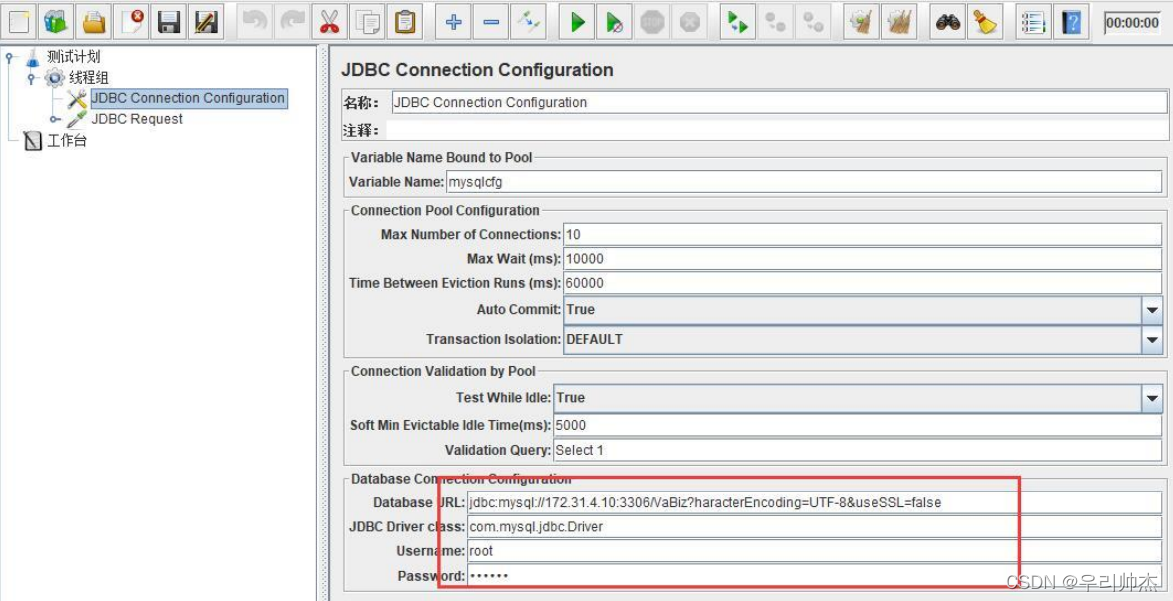
- 配置JDBC Connection Configuration
\lib\ext目录下添加mysql-connector-java-5.1.38.jar
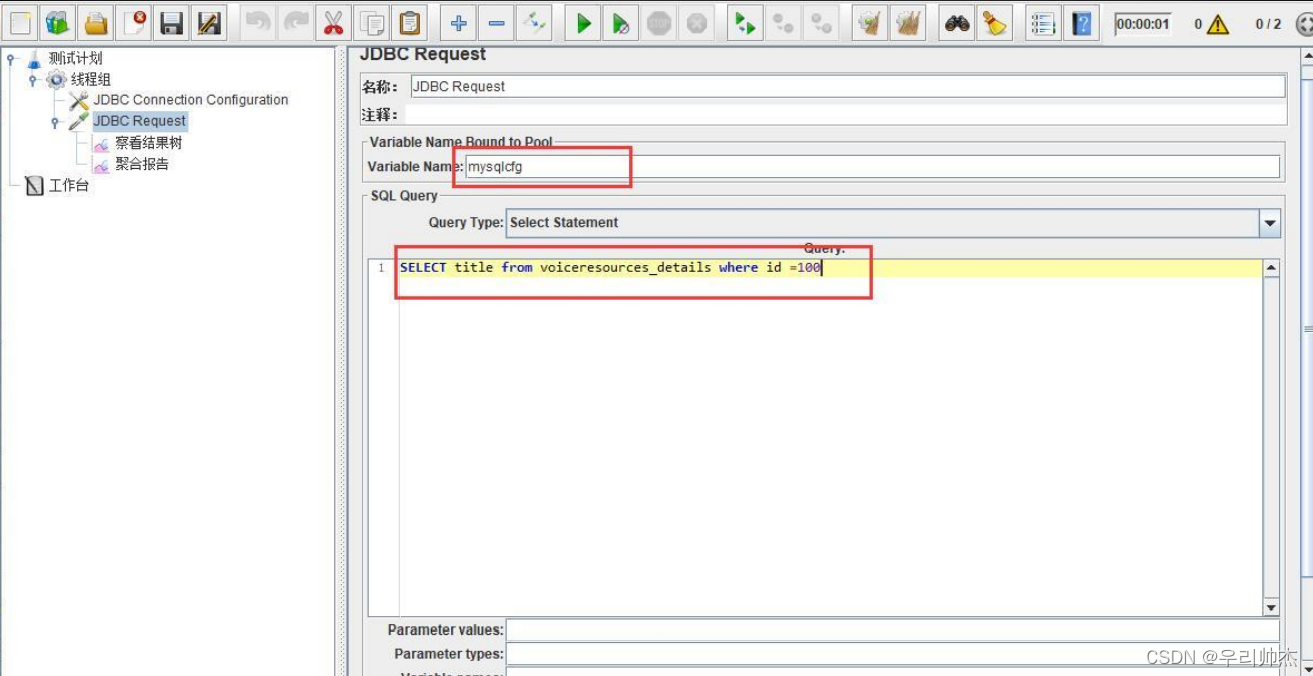
- 新建JDBC Request, 写入被测sql

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 2
 0
- 0


 已为社区贡献8条内容

所有评论(0)