【飞桨成都黑客松】急速开发之矿石分类及安卓部署
·
【飞桨黑客松】急速开发之矿石分类及安卓部署
两天的黑客松大赛,那自然是需要设计开发一款简易而又小实用小工具。
在寻找了众多的开源数据集中,我看到了有一个矿石的数据集,让我突发奇想。
这不正好自己拿手好戏,来一手矿石分类,并输出矿石的必要特质和相关信息。
将其集成到手机APP上,那不就是一个究极便携的矿石AI识别APP嘛。
目前的矿石识别还主要依赖于人眼,此款应用就可以用来降低人工肉眼识别的繁杂操作。
通过肉眼来判别物理外观为主要操作,那这不正是当前的人工智能所能解决的主要问题!
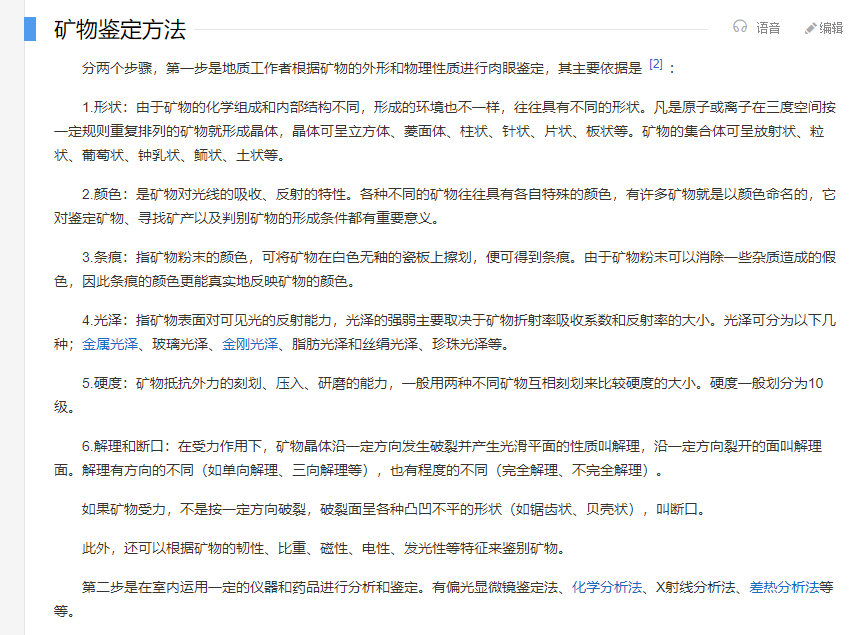
整体思路:
-
处理矿石的图片数据
-
采用paddlex-2.0框架进行分类
-
将预测的矿石信息的详细描述返回给用户。
0 安装PaddleX
!pip install paddlex==2.0.0
1 数据处理
- 解压数据集
- 制作标签文件label_list.txt
- 制作总的训练文件all_list.txt
- 打乱并划分为训练集合验证集
!unzip -oq /home/aistudio/data/data121634/mineral.zip
# 忽略不必要的输出
import warnings
warnings.filterwarnings("ignore")
# 导入paddlex
import paddlex as pdx
# 当然不可避免的第一步,导入库
from sklearn.utils import shuffle
import os
from PIL import Image
import paddle
import random
本来想要采用paddle自带的分数据集,发现无法处理图片,还是算了吧
# 处理图片的问题
!mkdir to_mineral
!mkdir to_mineral/muscovite
!mkdir to_mineral/bornite
!mkdir to_mineral/biotite
!mkdir to_mineral/quartz
!mkdir to_mineral/malachite
!mkdir to_mineral/pyrite
!mkdir to_mineral/chrysocolla
# train_list.txt(训练集)
# val_list.txt(验证集)

# 根据左侧生成的文件夹名字来写根目录
# 训练数据只需要用到训练的,其他两个文件夹不需要读
dirpath = "mineral"
# 先得到总的txt后续再进行划分,因为要划分出验证集,所以要先打乱,因为原本是有序的
def get_all_txt():
    all_list = []
    label_list = []
    i = 0 # 标记总文件数量
    j = 0 # 标记文件类别
    for root,dirs,files in os.walk(dirpath): # 分别代表根目录、文件夹、文件
        # 遍历每个文件去生成all_list集合
        for file in files:
            # 文件中每行格式: 图像相对路径      图像的label_id(数字类别)(注意:中间有空格)。
            imgpath = os.path.join(root,file)

            # 有坏图,解决掉
            try:
                img = Image.open(imgpath)
            except :
                os.remove(imgpath)
            else :
                img = Image.open(imgpath)
                img = img.convert("RGB")

                s = "to_"+imgpath
                i = i + 1
                all_list.append( s +" "+str(j-1)+"\n")
                img.save(s)
        # 遍历每个dir去生成后续需要的label_list集合
        m = 0
        for d in dirs:
            dpath = os.path.join(root,d)
            d = dpath.split("/")[1]
            label_list.append(d+"\n")
            m = m+1
        j = j + 1

    # 生成all_list.txt
    allstr = ''.join(all_list)
    f = open('all_list.txt','w',encoding='utf-8')
    f.write(allstr)
    f.close

    # 生成label_list.txt
    labellist = ''.join(label_list)
    f = open('label_list.txt','w',encoding='utf-8')
    f.write(labellist)
    f.close

    return all_list , i
all_list,all_lenth = get_all_txt()
print(all_lenth)
929
# 把数据打乱
all_list = shuffle(all_list)
allstr = ''.join(all_list)
f = open('all_list.txt','w',encoding='utf-8')
f.write(allstr)
f.close()
print("打乱成功,并重新写入文本")
打乱成功,并重新写入文本
# 按照比例划分数据集 数据有941张图片,我这里采用8:2划分
train_size = int(all_lenth * 0.8)
train_list = all_list[:train_size]
val_list = all_list[train_size:]

print(len(train_list))
print(len(val_list))
743
186
# 运行cell,生成训练集txt
train_txt = ''.join(train_list)
f_train = open('train_list.txt','w',encoding='utf-8')
f_train.write(train_txt)
f_train.close()
print("train_list.txt 生成成功!")

# 运行cell,生成验证集txt
val_txt = ''.join(val_list)
f_val = open('val_list.txt','w',encoding='utf-8')
f_val.write(val_txt)
f_val.close()
print("val_list.txt 生成成功!")
train_list.txt 生成成功!
val_list.txt 生成成功!
2 数据预处理
from paddlex import transforms as T

train_transforms = T.Compose([
    T.ResizeByShort(),
    T.CenterCrop(crop_size=224),
    T.RandomHorizontalFlip(),
    T.RandomVerticalFlip(),
    T.RandomBlur(prob=0.1),
    T.Normalize()
])

eval_transforms = T.Compose([
    T.ResizeByShort(),
    T.CenterCrop(crop_size=224),
    T.RandomHorizontalFlip(),
    T.RandomVerticalFlip(),
    T.RandomBlur(prob=0.1),
    T.Normalize()
])
3 定义数据集
train_dataset = pdx.datasets.ImageNet(
    data_dir='',
    file_list='train_list.txt',
    label_list='label_list.txt',
    transforms=train_transforms,
    shuffle=True)

eval_dataset = pdx.datasets.ImageNet(
    data_dir='',
    file_list='val_list.txt',
    label_list='label_list.txt',
    transforms=eval_transforms)
2021-12-18 09:27:15 [INFO]	Starting to read file list from dataset...
2021-12-18 09:27:15 [INFO]	743 samples in file train_list.txt
2021-12-18 09:27:15 [INFO]	Starting to read file list from dataset...
2021-12-18 09:27:15 [INFO]	186 samples in file val_list.txt
4 开始训练
num_classes = len(train_dataset.labels)
model = pdx.cls.ResNet50_vd_ssld(num_classes=num_classes)
model.train(num_epochs=150,
            train_dataset=train_dataset,
            train_batch_size=16,
            eval_dataset=eval_dataset,
            save_interval_epochs=2,
            learning_rate=0.000625,
            save_dir='output/ResNet50_vd_ssld',
            pretrain_weights=None,
            use_vdl=True)
test_jpg = "chrysocolla_test.png"
model = pdx.load_model("output/ResNet50_vd_ssld/best_model")
resout =model.predict(test_jpg)
print("实际矿石类型:",test_jpg)

print("预测的结果是:")
print(resout)
2021-12-18 10:24:25 [INFO]	Model[ResNet50_vd_ssld] loaded.
实际矿石类型: chrysocolla_test.png
预测的结果是:
[{'category_id': 0, 'category': 'chrysocolla', 'score': 0.9911538}]
5 模型导出
# 模型导出为paddlelite支持的
!paddlex --export_inference --model_dir=./output/ResNet50_vd_ssld/best_model --save_dir=./inference_model
5.1 安装paddlelite
# 准备PaddleLite依赖
!pip install paddlelite
Looking in indexes: https://pypi.tuna.tsinghua.edu.cn/simple
Collecting paddlelite
  Using cached https://pypi.tuna.tsinghua.edu.cn/packages/33/1a/02b25025bcb029f2eac9e5d582a18ff899bc6c0d9871bf3876e5703e66d9/paddlelite-2.10-cp37-cp37m-manylinux1_x86_64.whl
Installing collected packages: paddlelite
Successfully installed paddlelite-2.10
5.2 转换模型为.nb文件
# 准备PaddleLite部署模型
#--valid_targets中参数(arm)用于传统手机,(npu,arm )用于华为带有npu处理器的手机
!paddle_lite_opt \
    --model_file=inference_model/inference_model/model.pdmodel \
    --param_file=inference_model/inference_model/model.pdiparams \
    --optimize_out=inference_model/inference_model/model \
    --optimize_out_type=naive_buffer \
    --valid_targets=arm
odel/model.pdiparams \
    --optimize_out=inference_model/inference_model/model \
    --optimize_out_type=naive_buffer \
    --valid_targets=arm
    #--valid_targets=npu,arm
Loading topology data from inference_model/inference_model/model.pdmodel
Loading params data from inference_model/inference_model/model.pdiparams
1. Model is successfully loaded!
2. Model is optimized and saved into inference_model/inference_model/model.nb successfully
6 安卓Android Studio部署
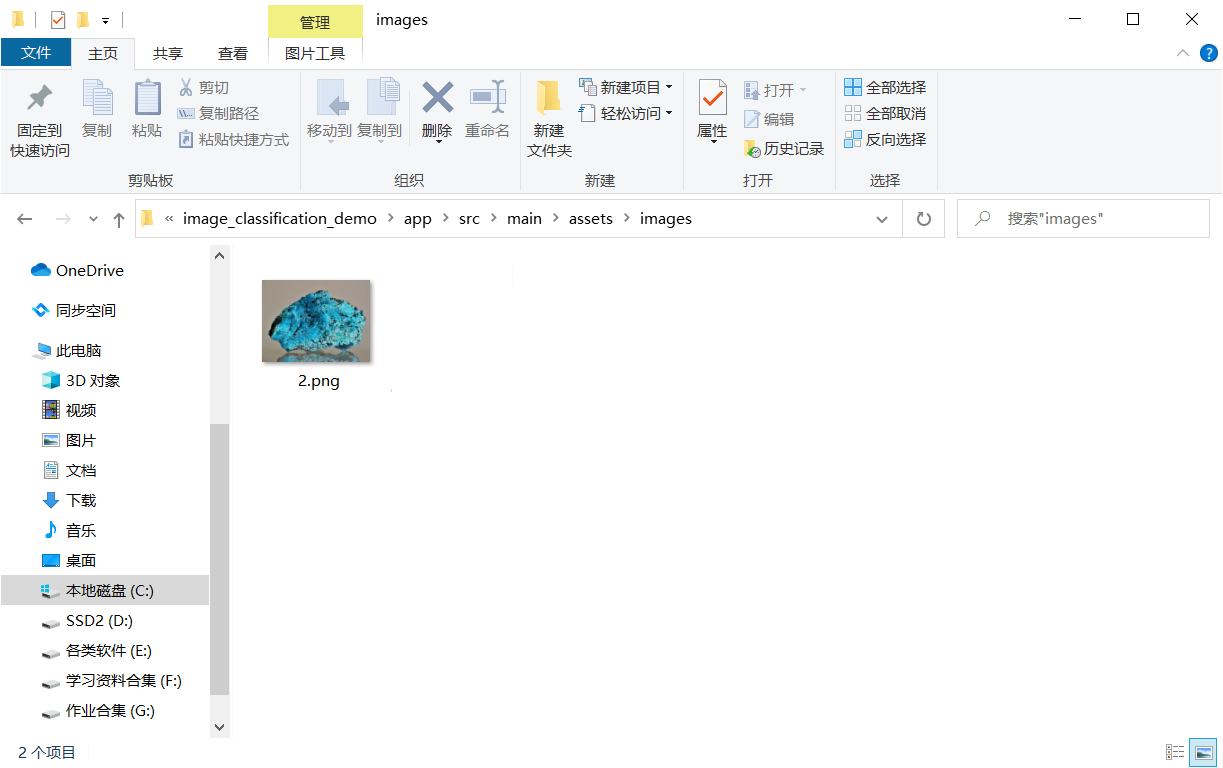
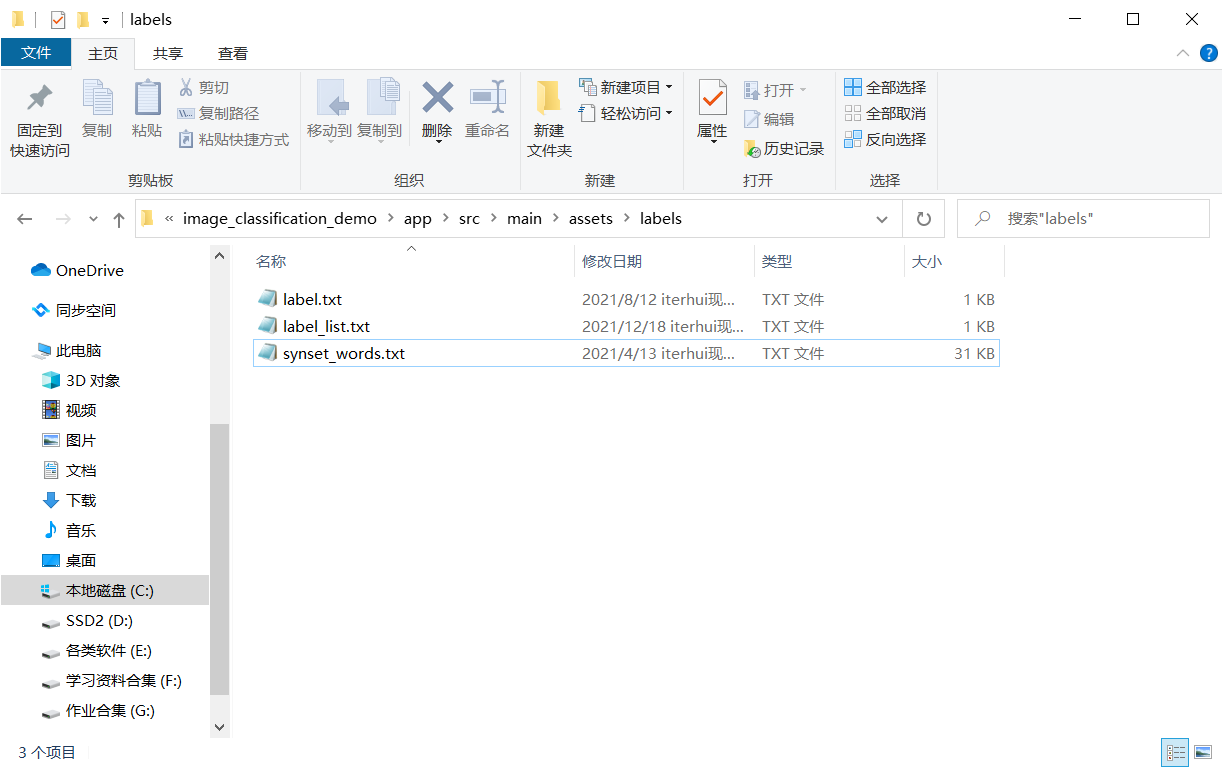
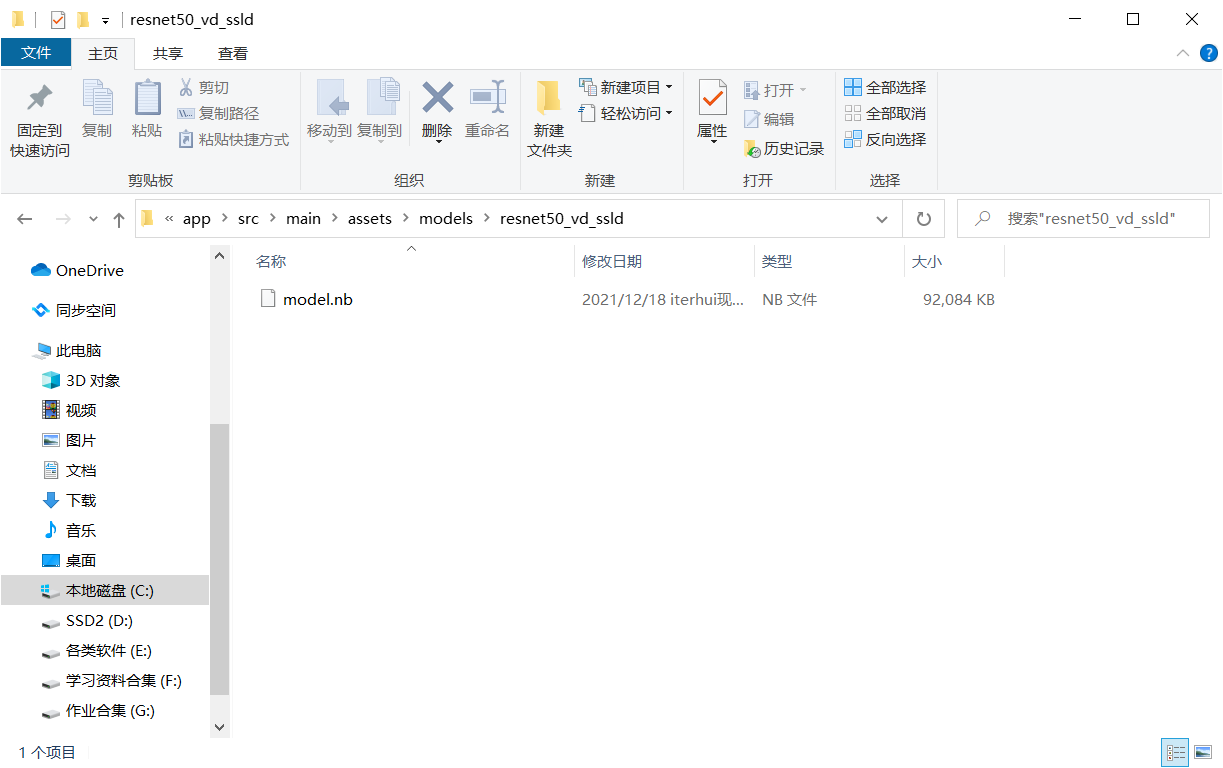
6.1 配置三个文件夹的内容
- images
- labels
- models
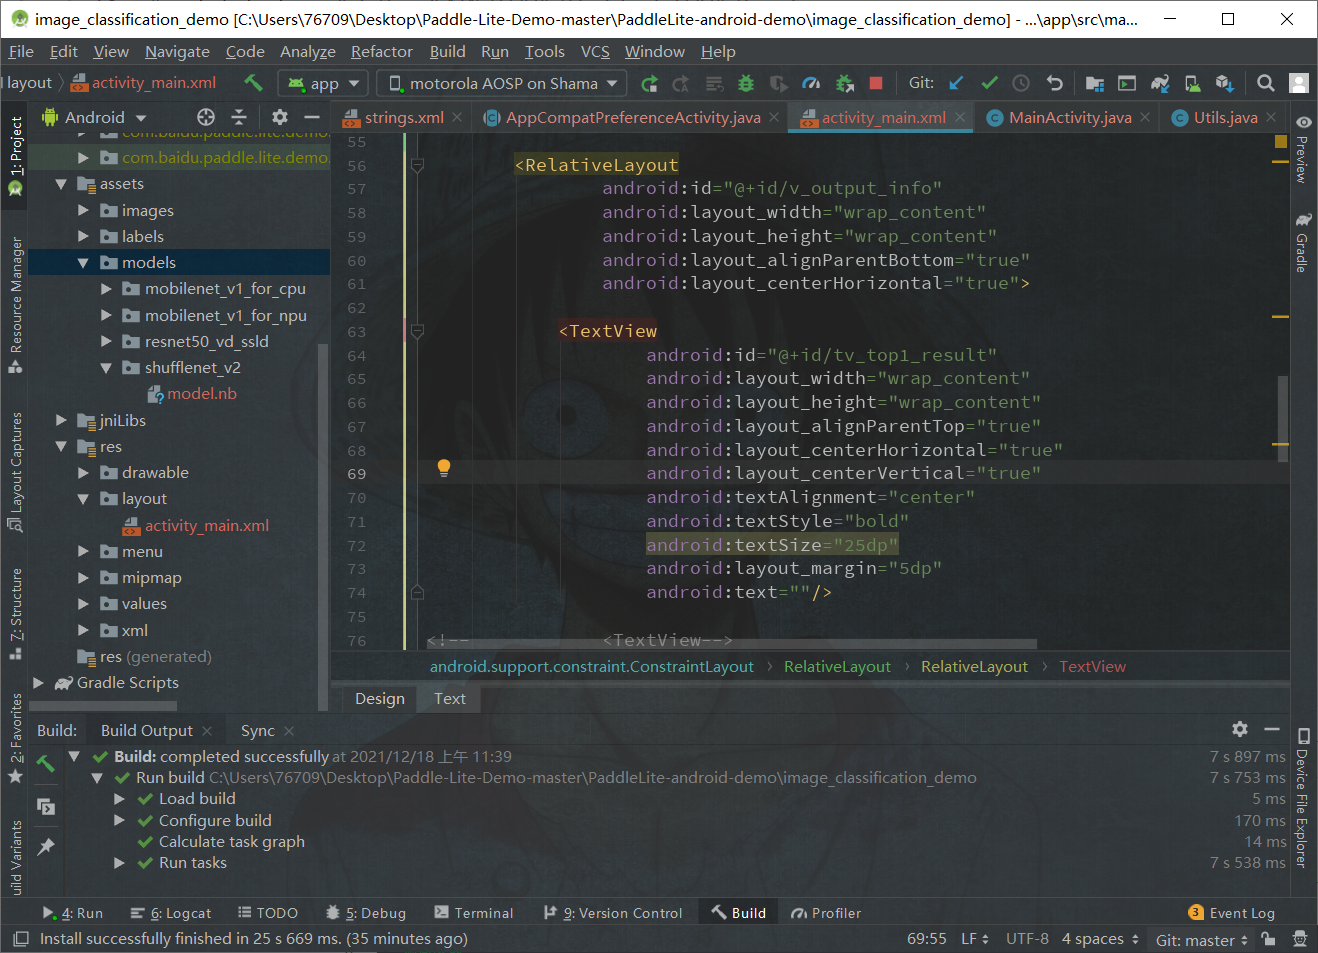
6.2 更改xml输出格式
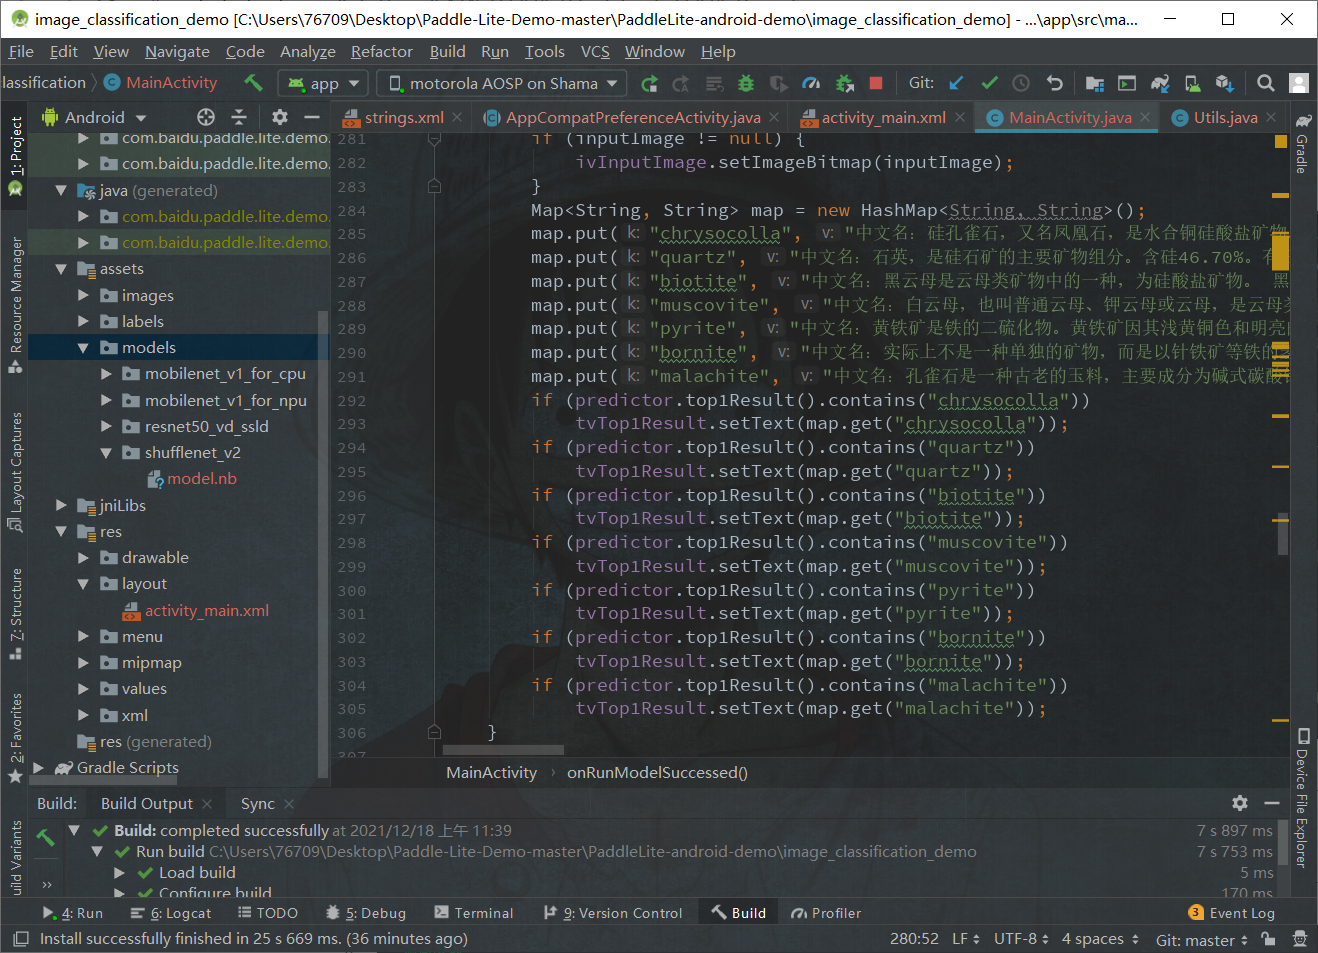
6.3 编写文本输出
本来是打算用nlp进行实现输出文本,但目前矿石类别较少,可以考虑在后续增加数据时再采用nlp
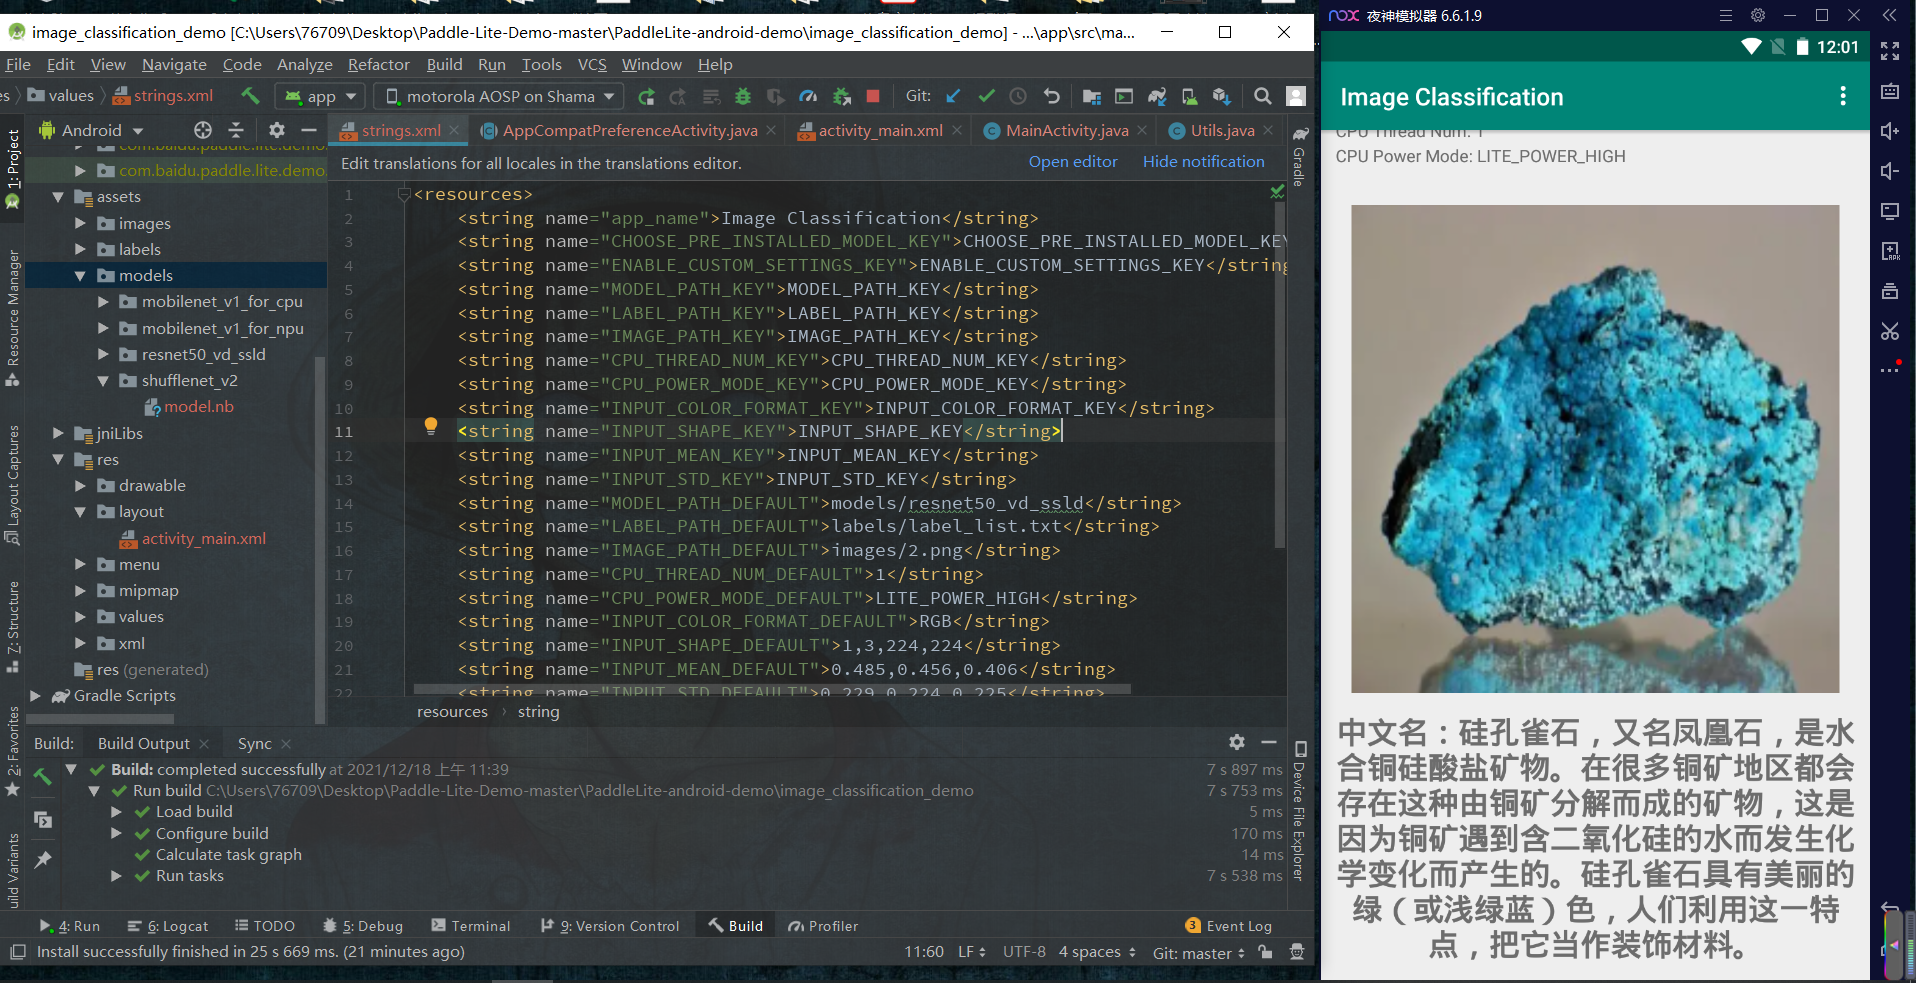
6.4 项目运行
项目支持拍照验证以及选择相册图片验证
这里便于演示,直接放置了静态的默认图。
7 项目总结
- 采用paddle2.0进行项目的训练
- 采用paddlelite进行项目的安卓部署
- 由于是即兴开发,并没有过多的去关注模型的精度,达到能用即可。
- 是一套全流程的paddlex+paddlelite的安卓分类部署项目。
iterhui && 乌木白桦
来互关呀~ https://aistudio.baidu.com/aistudio/personalcenter/thirdview/681892

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献61条内容

所有评论(0)