模型剪枝方法:通过网络瘦身学习高效的卷积网络
通过网络瘦身学习高效的卷积网络
摘要
深度卷积神经网络 (CNN) 在许多实际应用中的部署在很大程度上受到其高计算成本的阻碍。在本文中,我们为 CNN 提出了一种新颖的学习方案,以同时 1) 减小模型大小; 2) 减少运行时内存占用; 3) 在不影响准确性的情况下,减少计算操作的次数。这是通过以一种简单但有效的方式在网络中实施通道级稀疏性来实现的。与许多现有方法不同,所提出的方法直接适用于现代 CNN 架构,将训练过程的开销降至最低,并且不需要为生成的模型使用特殊的软件/硬件加速器。我们称我们的方法为网络瘦身,它以宽大的网络作为输入模型,但在训练过程中,微不足道的通道会被自动识别并在之后修剪,从而产生具有类似精度的薄而紧凑的模型。我们使用多种最先进的 CNN 模型(包括 VGGNet、ResNet 和 DenseNet)在各种图像分类数据集上凭经验证明了我们的方法的有效性。对于 VGGNet,网络瘦身的多通道版本使模型大小减少了 20 倍,计算操作减少了 5 倍。
1.导论
近年来,卷积神经网络 (CNN) 已成为各种计算机视觉任务的主要方法,例如图像分类 [22]、目标检测 [8]、语义分割 [26]。大规模数据集、高端现代 GPU 和新的网络架构允许开发前所未有的大型 CNN 模型。例如,从 AlexNet [22]、VGGNet [31] 和 GoogleNet [34] 到 ResNets [14],ImageNet 分类挑战赛获胜者模型已经从 8 层发展到 100 多层。
然而,更大的 CNN 尽管具有更强的表示能力,但更需要资源。例如,一个 152 层的 ResNet [14] 有超过 6000 万个参数,在推断分辨率为 224×224 的图像时需要 20 多个 Giga 浮点运算 (FLOP)。这在移动设备、可穿戴设备或物联网 (IoT) 设备等资源受限平台上不太可能负担得起。
CNN 在现实世界应用中的部署主要受 1) 模型大小的限制:CNN 强大的表示能力来自其数百万个可训练参数。这些参数以及网络结构信息需要存储在磁盘上并在推理期间加载到内存中。例如,存储在 ImageNet 上训练的典型 CNN 会消耗超过 300MB 的空间,这对嵌入式设备来说是一个很大的资源负担。 2) 运行时内存:在推理期间,CNN 的中间激活/响应甚至可能比存储模型参数占用更多的内存空间,即使批量大小为 1。这对于高端 GPU 来说不是问题,但是对于计算能力低的应用程序来说负担不起。 3)计算操作的数量:卷积操作在高分辨率图像上是计算密集型的。大型 CNN 可能需要几分钟才能在移动设备上处理单个图像,在实际应用中采用不现实。
已经提出了许多工作来压缩大型 CNN 或直接学习更有效的 CNN 模型以进行快速推理。这些包括低秩逼近 [7]、网络量化 [3, 12] 和二值化 [28, 6]、权重修剪 [12]、动态推理 [16] 等。 然而,这些方法中的大多数只能解决上面提到的一两个问题。此外,一些技术需要专门设计的软件/硬件加速器来加速执行 [28, 6, 12]。
减少大型 CNN 资源消耗的另一个方向是稀疏网络。稀疏性可以施加在不同层次的结构上[2,37,35,29,25],这会产生相当大的模型大小压缩和推理加速。然而,这些方法通常需要特殊的软件/硬件加速器来获得内存增益或节省时间,尽管这比[12]中的非结构化稀疏权重矩阵更容易。

图 1:我们将缩放因子(从批量归一化层复用)与卷积层中的每个通道相关联。在训练期间对这些缩放因子施加稀疏正则化以自动识别不重要的通道。具有小比例因子值(橙色)的通道将被修剪(左侧)。修剪后,我们获得紧凑模型(右侧),然后对其进行微调以达到与正常训练的完整网络相当(甚至更高)的精度。
在本文中,我们提出了网络瘦身,一种简单而有效的网络训练方案,它解决了在有限资源下部署大型 CNN 时的所有上述问题。我们的方法在批量归一化 (BN) 层中的缩放因子上加 L1 正则化,因此很容易实现,而无需对现有 CNN 架构进行任何更改。使用 L1 正则化将 BN 缩放因子的值推向零,使我们能够识别无关紧要的通道(或神经元),因为每个缩放因子对应于特定的卷积通道(或完全连接的神经元层)。这有助于后续步骤中的通道级修剪。额外的正则化项很少会影响性能。事实上,在某些情况下,它会导致更高的泛化精度。修剪不重要的通道有时可能会暂时降低性能,但这种影响可以通过对修剪后的网络进行后续微调来补偿。修剪后,与最初的宽网络相比,由此产生的更窄网络在模型大小、运行时内存和计算操作方面更加紧凑。上述过程可以重复多次,产生多通道网络瘦身方案,从而使网络更加紧凑。
在几个基准数据集和不同网络架构上的实验表明,我们可以获得模型大小压缩高达 20 倍、计算操作减少 5 倍的 CNN 模型,同时实现相同甚至更高的精度。此外,我们的方法通过传统的硬件和深度学习软件包实现了模型压缩和推理加速,因为由此产生的更窄的模型没有任何稀疏存储格式或计算操作。
2.相关工作
这部分,我们从五个方面讨论相关工作。
低秩分解使用诸如奇异值分解 (SVD) [7] 之类的技术来近似具有低秩矩阵的神经网络中的权重矩阵。这种方法在全连接层上效果特别好,产生~3x 模型大小的压缩,但没有显着的速度加速,因为 CNN 中的计算操作主要来自卷积层。
权重量化。 HashNet [3] 建议量化网络权重。在训练之前,网络权重被散列到不同的组,并且在每个组权重内共享值。这样只需要存储共享的权重和哈希索引,可以节省大量的存储空间。 [12] 在深度压缩管道中使用改进的量化技术,并在 AlexNet 和 VGGNet 上实现了 35 到 49 倍的压缩率。然而,这些技术既不能节省运行时内存也不能节省推理时间,因为在推理期间共享权重需要恢复到它们的原始位置。
[28, 6] 将实值权重量化为二元/三元权重(权重值限制为 {−1,1} 或 {−1,0,1})。这产生了大量的模型大小节省,并且在给定按位运算库的情况下也可以获得显着的加速。然而,这种激进的低位近似方法通常会带来一定的精度损失。
权重修剪/稀疏化。 [12] 建议在训练好的神经网络中用小权重修剪不重要的连接。最终网络的权重大部分为零,因此可以通过以稀疏格式存储模型来减少存储空间。然而,这些方法只能通过专用的稀疏矩阵运算库和/或硬件来实现加速。运行时内存节省也非常有限,因为大部分内存空间被激活映射(仍然密集)而不是权重消耗。
在[12]中,在训练期间没有关于稀疏性的指导。 [32] 通过使用额外的门变量显式地对每个权重施加稀疏约束来克服这一限制,并通过修剪零门值的连接来实现高压缩率。这种方法比[12]实现了更好的压缩率,但也有同样的缺点。
结构化修剪/稀疏化。最近,[23] 建议在经过训练的 CNN 中修剪具有较小传入权重的通道,然后微调网络以重新获得准确性。 [2] 通过在训练前随机停用卷积层中的输入-输出通道连接来引入稀疏性,这也产生了具有中等精度损失的较小网络。与这些工作相比,我们在训练过程中明确地在优化目标中强加了通道稀疏性,从而使通道修剪过程更平滑,精度损失很小。
[37] 在训练期间施加神经元级稀疏性,因此可以修剪一些神经元以获得紧凑的网络。 [35] 提出了一种结构化稀疏学习(SSL)方法来稀疏化 CNN 中不同级别的结构(例如过滤器、通道或层)。这两种方法都在训练期间利用组稀疏正则化来获得结构化稀疏。我们的方法不是在卷积权重上采用组稀疏性,而是在通道缩放因子上施加简单的 L1 稀疏性,因此优化目标要简单得多。
由于这些方法修剪或稀疏化部分网络结构(例如,神经元、通道)而不是单个权重,因此它们通常需要较少专门的库(例如用于稀疏计算操作)来实现推理加速和运行时内存节省.我们的网络瘦身也属于这一类,绝对不需要特殊的库来获得好处。
神经架构学习。虽然最先进的 CNN 通常由专家设计 [22, 31, 14],但也有一些关于自动学习网络架构的探索。 [20] 为给定资源预算的网络架构搜索引入了子模块/超模块优化。最近的一些工作 [38, 1] 建议通过强化学习自动学习神经结构。这些方法的搜索空间非常大,因此需要训练数百个模型来区分好坏。网络瘦身也可以被视为架构学习的一种方法,尽管选择仅限于每一层的宽度。然而,与上述方法相反,网络瘦身仅通过单一的训练过程来学习网络架构,这符合我们的效率目标。
3.网络瘦身
我们的目标是提供一个简单的方案来实现深度 CNN 中的通道级稀疏性。在本节中,我们首先讨论通道级稀疏性的优势和挑战,并介绍我们如何在批量归一化中利用缩放层来有效识别和修剪网络中不重要的通道。
通道级稀疏性的优势。正如之前的工作 [35, 23, 11] 中所讨论的,可以在不同的级别实现稀疏性,例如,权重级别、内核级别、通道级别或层级别。细粒度级别(例如权重级别)的稀疏性提供了最高的灵活性,通用性导致更高的压缩率,但它通常需要特殊的软件或硬件加速器来对稀疏模型进行快速推理 [11]。相反,最粗糙的层级稀疏性不需要特殊的包来获得推理加速,而它的灵活性较差,因为需要修剪一些整个层。事实上,去除层只有在深度足够大时才有效,例如超过 50 层 [35, 18]。相比之下,通道级稀疏性在灵活性和易于实施之间提供了很好的权衡。它可以应用于任何典型的 CNN 或全连接网络(将每个神经元视为一个通道),由此产生的网络本质上是未剪枝网络的“精简”版本,可以在传统的 CNN 平台上进行高效推理。
挑战。实现通道级别的稀疏性需要修剪与通道相关的所有传入和传出连接。这使得在预训练模型上直接修剪权重的方法无效,因为通道输入端或输出端的所有权重不太可能接近零值。正如 [23] 中所报告的,在预训练的 ResNet 上修剪通道只能导致参数数量减少约 10%,而不会遭受精度损失。 [35] 通过在训练目标中实施稀疏正则化来解决这个问题。具体来说,他们采用组LASSO在训练期间将对应于同一通道的所有滤波器权重同时推向零。然而,这种方法需要计算关于所有滤波器权重的附加正则化项的梯度,这是非常重要的。我们介绍了一个简单的想法来解决上述挑战,详细信息如下。
缩放因子和稀疏性引起的惩罚。我们的想法是为每个通道引入一个缩放因子 γ,它与该通道的输出相乘。然后我们联合训练网络权重和这些缩放因子,并对后者进行稀疏正则化。最后,我们用小因子修剪那些通道,并对修剪后的网络进行微调。具体来说,我们方法的训练目标由下式给出
L
=
∑
(
x
,
y
)
l
(
f
(
x
,
W
)
,
y
)
+
λ
∑
γ
∈
Γ
g
(
γ
)
————
(
1
)
L=\sum_{(x,y)}l(f(x,W),y)+λ\sum_{\gamma\in\Gamma}g(\gamma)————(1)
L=(x,y)∑l(f(x,W),y)+λγ∈Γ∑g(γ)————(1)
其中(x,y)表示训练输入和目标,W 表示可训练权重,第一个求和项对应于 CNN 的正常训练损失,g(·)是稀疏性引起的尺度因子惩罚,λ 平衡这两个项。在我们的实验中,我们选择 g(s)=| s |,这被称为 L1 范数,广泛用于实现稀疏性。采用次梯度下降法作为非光滑 L1 罚项的优化方法。另一种选择是将 L1 惩罚替换为平滑 L1 惩罚[30],以避免在非平滑点使用次梯度。
由于修剪通道本质上对应于删除该通道的所有传入和传出连接,因此我们可以直接获得一个狭窄的网络(见图 1),而无需借助任何特殊的稀疏计算包。缩放因子充当通道选择的代表。由于它们与网络权重联合优化,网络可以自动识别无关紧要的通道,从而安全地删除这些通道,而不会极大地影响泛化性能。
利用 BN 层中的缩放因子。批量归一化 [19] 已被大多数现代 CNN 用作实现快速收敛和更好泛化性能的标准方法。 BN 对激活进行归一化的方式促使我们设计一种简单有效的方法来合并通道缩放因子。特别是,BN 层使用小批量统计数据对内部激活进行归一化。设 zin 和 zout 为一个 BN 层的输入和输出,B 表示当前的 minibatch,BN 层进行如下变换:
z
^
=
z
i
n
−
μ
B
(
σ
B
2
+
ϵ
)
;
z
o
u
t
=
γ
z
^
+
β
————
(
2
)
\hat{z} = \frac{z_{in}-\mu_{\mathcal{B}}}{\sqrt(\sigma^{2}_{\mathcal{B}}+\epsilon)};z_{out}=\gamma\hat{z}+\beta————(2)
z^=(σB2+ϵ)zin−μB;zout=γz^+β————(2)
其中
μ
B
μ_{B}
μB 和
σ
B
σ_{B}
σB 是
B
\mathcal{B}
B 上输入激活的均值和标准差值,γ 和 β 是可训练的仿射变换参数(尺度和位移),它提供了将归一化激活线性转换回任何尺度的可能性。
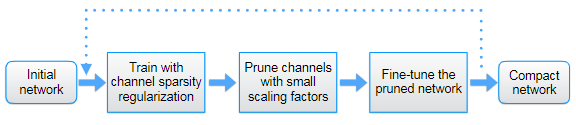
图 2:网络瘦身过程流程图。虚线用于多通道/迭代方案。
通常的做法是在卷积层之后插入一个 BN 层,并带有通道级缩放/移位参数。因此,我们可以直接利用 BN 层中的 γ 参数作为网络瘦身所需的缩放因子。它的巨大优势在于不会给网络增加开销。事实上,这可能也是我们学习有意义的通道剪枝缩放因子的最有效方式。 1)如果我们在没有 BN 层的 CNN 中添加缩放层,缩放因子的值对于评估通道的重要性没有意义,因为卷积层和缩放层都是线性变换。可以通过减小缩放因子值同时放大卷积层中的权重来获得相同的结果。 2)如果我们在 BN 层之前插入一个缩放层,缩放层的缩放效果将被 BN 中的归一化过程完全抵消。 3)如果我们在 BN 层之后插入缩放层,则每个通道有两个连续的缩放因子。
通道修剪和微调。在通道级稀疏诱导正则化下训练后,我们获得了一个模型,其中许多缩放因子接近于零(见图 1)。然后我们可以通过删除所有传入和传出连接以及相应的权重来修剪具有接近零缩放因子的通道。我们使用跨所有层的全局阈值修剪通道,该阈值定义为所有缩放因子值的某个百分位数。例如,我们通过选择百分比阈值为 70% 来修剪具有较低缩放因子的 70% 通道。通过这样做,我们获得了一个更紧凑的网络,具有更少的参数和运行时内存,以及更少的计算操作。
当修剪率很高时,修剪可能会暂时导致一些精度损失。但这可以在很大程度上通过修剪后的网络上的微调过程得到补偿。在我们的实验中,经过微调的窄网络在很多情况下甚至可以达到比原始未剪枝网络更高的精度。
多程方案。我们还可以将所提出的方法从单程学习方案(使用稀疏正则化、修剪和微调进行训练)扩展到多程方案。具体来说,网络瘦身过程会导致网络变窄,我们可以再次应用整个训练过程来学习更紧凑的模型。这由图 2 中的虚线说明。实验结果表明,这种多通道方案可以在压缩率方面产生更好的结果。
处理跨层连接和预激活结构。上面介绍的网络瘦身过程可以直接应用于大多数普通的 CNN 架构,例如 AlexNet [22] 和 VGGNet [31]。虽然将其应用于具有跨层连接和预激活设计(例如 ResNet [15] 和 DenseNet [17])的现代网络时需要进行一些调整。对于这些网络,一层的输出可以作为后续多个层的输入,其中在卷积层之前放置一个 BN 层。在这种情况下,稀疏性是在层的传入端实现的,即该层有选择地使用它接收到的信道子集。为了在测试时获得参数和计算节省,我们需要放置一个通道选择层来屏蔽我们已经确定的无关紧要的通道。
4.实验
我们在几个基准数据集上实证证明了网络瘦身的有效性。基于公开可用的 Torch[5]实现 [10]来实施我们的方法。代码可在 https://github.com/liuzhuang13/slimming 获得。
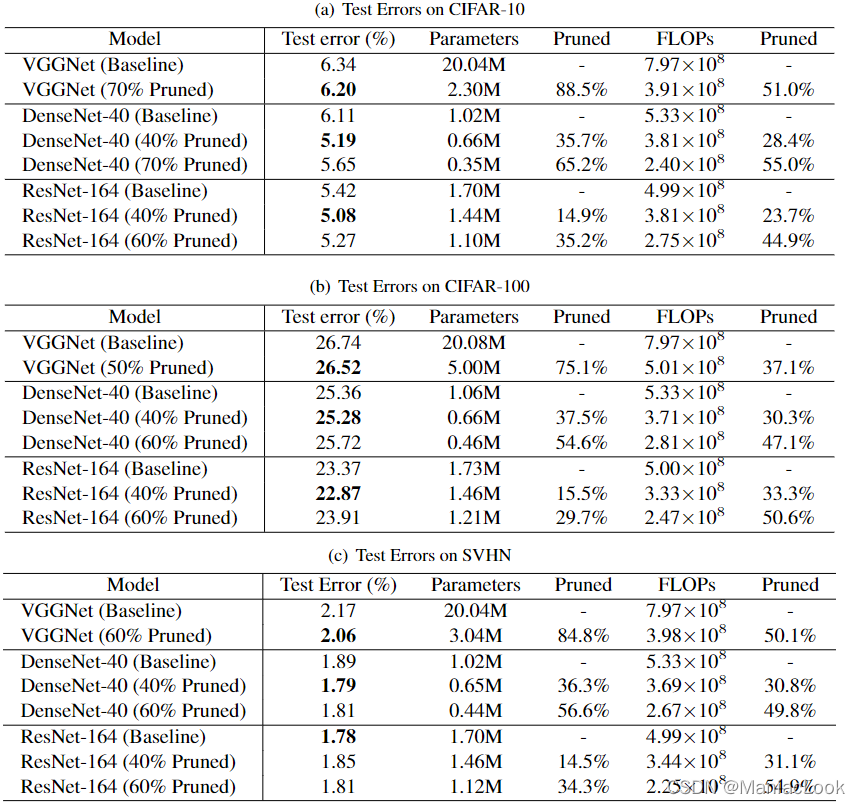
表 1:
CIFAR和SVHN数据集的结果。 “基线”表示没有稀疏正则化的正常训练。在第 1 列中,“60% pruned”表示微调模型,其中 60% 的通道从用稀疏等训练的模型中修剪出来。参数和 FLOP 的修剪率也显示在第 4 列和第 6 列中。修剪适量 (40%) 的通道可以在很大程度上降低测试错误。通常可以通过修剪≥60% 的通道来保持精度。
4.1.数据集
CIFAR。两个 CIFAR 数据集 [21] 由分辨率为 32×32 的自然图像组成。CIFAR-10 来自 10 个类,CIFAR-100 来自 100 个类。训练集和测试集分别包含 50,000 和 10,000 张图像。在 CIFAR-10 上,从训练集中拆分 5,000 张图像的验证集,用于在每个模型上搜索 λ(在公式 1 中)。我们在对所有训练图像进行训练或微调后报告最终测试误差。采用了标准的数据增强方案(移位/镜像)[14, 18, 24]。输入数据使用通道均值和标准差进行归一化。我们还在 CIFAR 数据集上将我们的方法与 [23] 进行了比较。
SVHN。街景房号 (SVHN) 数据集 [27] 由 32x32 彩色数字图像组成。按照惯例 [9, 18, 24],我们使用所有 604,388 张训练图像,从中我们拆分了 6,000 张图像的验证集,用于训练期间的模型选择。测试集包含 26,032 张图像。在训练过程中,我们选择验证误差最低的模型作为要剪枝的模型(或基线模型)。我们还报告了微调期间验证误差最低的模型的测试误差。
ImageNet。 ImageNet 数据集包含 120 万张训练图像和 1000 个类别的 50,000 张验证图像。我们采用 [10] 中的数据增强方案。我们报告了最终模型的单中心裁剪验证误差。
MNIST。 MNIST 是一个手写数字数据集,包含 60,000 张训练图像和 10,000 张测试图像。为了测试我们的方法在全连接网络上的有效性(将每个神经元视为具有 1×1 空间大小的通道),我们在此数据集上将我们的方法与 [35] 进行比较。
4.2.网络模型
在 CIFAR 和 SVHN 数据集上,我们在三种流行的网络架构上评估我们的方法:VGGNet [31]、ResNet [14] 和 DenseNet [17]。 VGGNet 最初是为 ImageNet 分类而设计的。对于我们的实验,CIFAR 数据集的原始 VGGNet 的变体取自 [36]。对于 ResNet,使用具有瓶颈结构 (ResNet-164) [15] 的 164 层预激活 ResNet。对于 DenseNet,我们使用增长率为 12 (DenseNet-40) 的 40 层 DenseNet。
在 ImageNet 数据集上,我们采用 11 层(8-conv + 3 FC)VGG-A网络 [31] 模型和来自 [4] 的批量归一化。因为我们使用了相对大量的数据增强,所以我们移除了 dropout 层。为了修剪全连接层中的神经元,我们将它们视为具有 1×1 空间大小的卷积通道。
在 MNIST 数据集上,我们在与 [35] 中相同的 3 层全连接网络上评估我们的方法。
4.3.训练,剪枝和微调
正常训练。我们通常从头开始训练所有网络作为基准。所有网络都使用 SGD 进行训练。在 CIFAR 和 SVHN 数据集上,我们分别使用小批量大小 64 进行 160 和 20 次训练。初始学习率设置为 0.1,并在训练周期总数的 50% 和 75% 处除以 10。在 ImageNet 和 MNIST 数据集上,我们分别训练我们的模型 60 和 30 个 epoch,批量大小为 256,初始学习率为 0.1,在训练时期的 1/3 和 2/3 部分后除以 10 .我们使用 10-4 的权重衰减和 0.9 的无阻尼 Nesterov 动量 [33] 。采用[13]引入的权重初始化。我们的优化设置严格遵循 [10] 中的原始实现。在我们所有的实验中,我们将所有通道缩放因子初始化为 0.5,因为与 [10] 中的默认设置(全部初始化为 1)相比,这为基线模型提供了更高的精度。
稀疏训练。对于 CIFAR 和 SVHN 数据集,当使用通道稀疏正则化训练时,控制经验损失和稀疏性之间权衡的超参数 λ ,通过在CIFAR-10 验证集上对
1
0
−
3
、
1
0
−
4
、
1
0
−
5
10^{-3}、10^{-4}、10^{-5}
10−3、10−4、10−5 进行网格搜索确定。对于 VGGNet,我们选择
λ
=
1
0
−
4
λ=10^{−4}
λ=10−4,对于 ResNet 和 DenseNet,我们选择
λ
=
1
0
−
5
λ=10^{−5}
λ=10−5。对于 ImageNet 上的 VGG-A,我们设置
λ
=
1
0
−
5
λ=10^{−5}
λ=10−5。所有其他设置与正常训练中保持相同。
修剪。当我们修剪稀疏训练模型的通道时,需要确定缩放因子的修剪阈值。与[23]中不一样——不同的层按不同的比率修剪不同,为了简单起见,我们使用了全局修剪阈值。修剪阈值由所有缩放因子中的百分位数确定,例如,40% 或 60% 的通道被修剪。通过构建一个新的更窄的模型,并从稀疏训练的模型中复制相应的权重,来进行修剪。
微调。修剪后,我们得到一个更窄更紧凑的模型,然后对其进行微调。在 CIFAR、SVHN 和 MNIST 数据集上,微调使用与训练相同的优化设置。对于 ImageNet 数据集,由于时间限制,我们仅在 5 个 epoch 内以
1
0
−
3
10^{-3}
10−3 的学习率微调修剪后的 VGG-A。
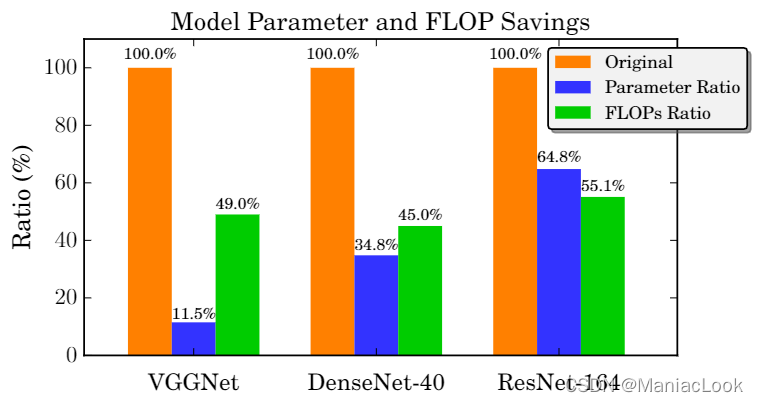
图 3:在
CIFAR-10上测试误差低于原始模型的修剪模型的比较。蓝色和绿色条是修剪模型和原始模型之间的参数和 FLOP 比率。
4.4.结果
CIFAR 和 SVHN CIFAR 和 SVHN 的结果如表 1 所示。我们用黑体标出模型的所有最低测试误差。
参数和 FLOP 减少。网络瘦身的目的是减少所需的计算资源量。每个模型的最后一行修剪了 ≥ 60% 的通道,同时仍保持与基准相似的准确度。参数保存可达10倍。 FLOP 减少通常约为 50%。为了突出网络瘦身的效率,我们在图 3 中绘制了资源节省情况。可以观察到 VGGNet 有大量可以修剪的冗余参数。在 ResNet-164 上,参数和 FLOP 的节省相对微不足道,我们推测这是因为它的 bottleneck 结构已经起到了选择通道的作用。此外,在 CIFAR-100 上,减少率通常略低于 CIFAR-10 和 SVHN,这可能是因为 CIFAR-100 包含更多类。
正则化效应。从表 1 中,我们可以观察到,在 ResNet 和 DenseNet 上,通常在修剪 40% 的通道时,微调网络可以实现比原始模型更低的测试误差。例如,修剪了 40% 通道的 DenseNet-40 在 CIFAR-10 上实现了 5.19% 的测试误差,这比原始模型低了近 1%。我们假设这是由于 L1 稀疏性对通道的正则化效应,它自然地在网络的中间层提供特征选择。我们将在下一节分析这种影响。
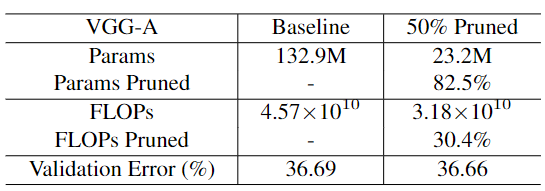
表 2:
ImageNet上的结果
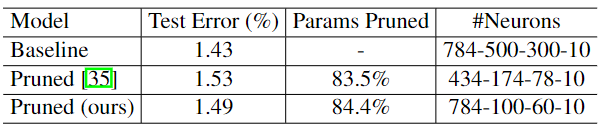
表 3:
MNIST上的结果
ImageNet。 ImageNet 数据集的结果总结在表 2 中。当剪枝 50% 的通道时,参数节省超过 5 倍,而 FLOP 节省仅为 30.4%。这是因为所有计算密集型卷积层中只有 378 个(2752 个中)通道被修剪,而参数密集型全连接层中的 5094 个神经元(8192 个中)被修剪。值得注意的是,我们的方法可以在 1000 类 ImageNet 数据集上实现节省而没有精度损失,而其他用于高效 CNN 的方法 [2,23,35,28] 大多报告精度损失。
MNIST。在 MNIST 数据集上,我们将我们的方法与表 3 中的结构化稀疏学习 (SSL) 方法 [35] 进行了比较。尽管我们的方法主要设计用于修剪卷积层中的通道,但它也适用于修剪全连接层中的神经元。在这个实验中,我们观察到使用全局阈值修剪有时会完全删除一个层,因此我们修剪了两个中间层中每一层中 80% 的神经元。我们的方法略胜于 [35],因为在修剪更多参数的同时实现了较低的测试误差。
我们在补充材料中提供了一些额外的实验结果,包括(1)CIFAR-10 上紧凑型 VGGNet 的详细结构; (2) 在实践中节省挂钟时间和运行时内存。 (3) 与之前的通道剪枝方法比较[23];
4.5.多程方案的结果
我们使用 VGGNet 在 CIFAR 数据集上采用多通道方案。由于没有跳过连接,剪掉整个层将完全破坏模型。因此,除了将百分位阈值设置为 50% 之外,我们还设置了一个约束,即在每一层,最多可以修剪 50% 的通道。
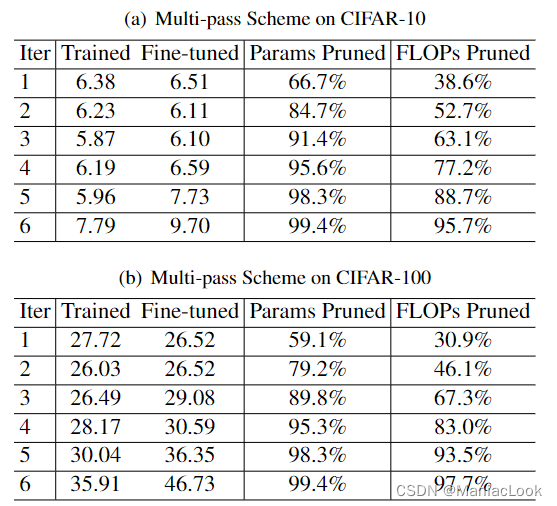
表 4:使用
VGGNet在CIFAR-10和CIFAR-100数据集上的多通道方案的结果。基线模型的测试误差分别为 6.34% 和 26.74%。 “Trained”和“Fine-tuned”列分别表示稀疏训练模型和通道修剪后微调模型的测试误差(%)。参数和 FLOP 修剪率对应于该行中的微调模型和下一行中的训练模型。
每个迭代中模型的测试误差如表4所示。随着修剪过程的进行,我们得到了越来越多的紧凑模型。在 CIFAR-10 上,经过训练的模型在迭代5中实现了最低的测试误差。该模型实现了20倍的参数缩减和5倍的 FLOP 缩减,同时仍然实现了较低的测试误差。在 CIFAR-100 上,迭代3后,测试误差开始增加。这可能是因为它包含比 CIFAR-10 更多的类,因此过度修剪通道将不可避免地损害性能。然而,我们仍然可以删减近90%的参数和近70%的 FLOP,而不会造成显著的精度损失。
5.分析
网络瘦身中有两个关键的超参数,修剪百分比 t 和稀疏正则化项 λ 的系数(参见等式 1)。在本节中,我们将更详细地分析它们的影响。
修剪百分比的影响。一旦我们获得了一个用稀疏正则化训练的模型,我们需要决定从模型中修剪的通道百分比。如果我们修剪的通道太少,节省的资源可能非常有限。但是,如果我们修剪过多的通道可能会对模型造成破坏,并且可能无法通过微调来恢复准确度。我们在 CIFAR-10 上训练一个
λ
=
1
0
−
5
λ=10^{−5}
λ=10−5 的 DenseNet-40 模型,以显示修剪不同百分比通道的效果。结果总结在图 5 中。
从图5可以得出结论,只有当修剪比率超过阈值时,修剪或微调模型的分类性能才会下降。微调过程通常可以补偿修剪可能造成的精度损失。只有当阈值超过80%时,微调模型的测试误差才落后于基准模型。值得注意的是,当使用稀疏性进行训练时,即使没有微调,该模型也比原始模型表现得更好。这可能是由于 L1 稀疏性对通道比例因子的正则化效应。
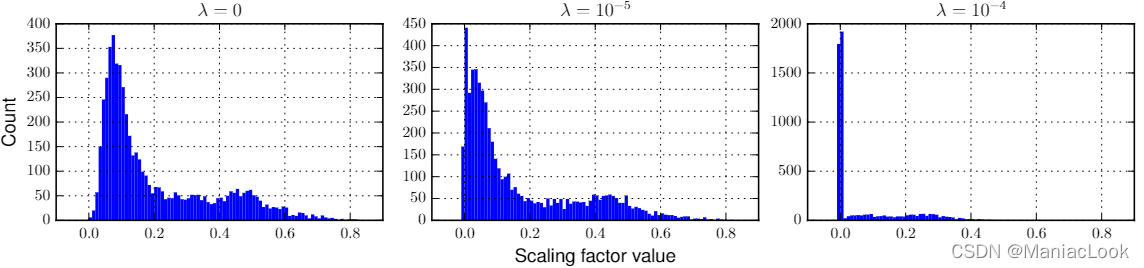
图 4:在不同程度的稀疏正则化(由参数 λ 控制)下训练的
VGGNet中缩放因子的分布。随着 λ 的增加,缩放因子变得稀疏。
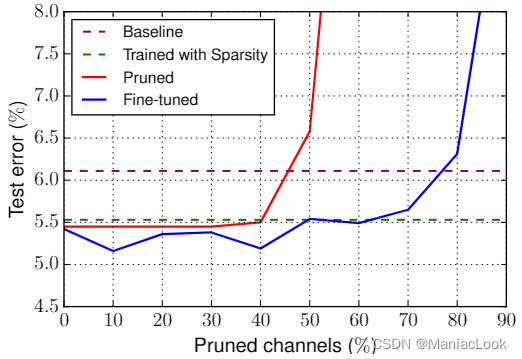
图 5:修剪不同百分比通道的效果,来自在
CIFAR-10上训练的DenseNet-40, λ = 1 0 − 5 λ=10^{−5} λ=10−5。
通道稀疏正则化。 L1 稀疏项的目的是强制许多缩放因子接近于零。与正常训练损失相比,等式 1 中的参数 λ 控制其显着性。在图 4 中,我们用不同的 λ 值绘制了整个网络中缩放因子的分布。对于这个实验,我们使用在 CIFAR-10 数据集上训练的 VGGNet。
可以观察到,随着 λ 的增加,缩放因子越来越集中在零附近。当 λ = 0 时,即没有稀疏正则化,分布相对平坦。当
λ
=
1
0
−
4
λ = 10^{-4}
λ=10−4 时几乎所有的缩放因子都落入一个接近零的小区域。这一过程可以被视为发生在深度网络中间层的特征选择,其中仅选择具有不可忽略比例因子的通道。我们通过热图进一步观察这一过程。图6显示了VGGNet 中一个层在训练过程中的比例因子大小。每个通道以相等的权重开始;随着训练的进行,一些通道的比例因子变得更大(更亮),而另一些通道的比例因子变得更小(更暗)。
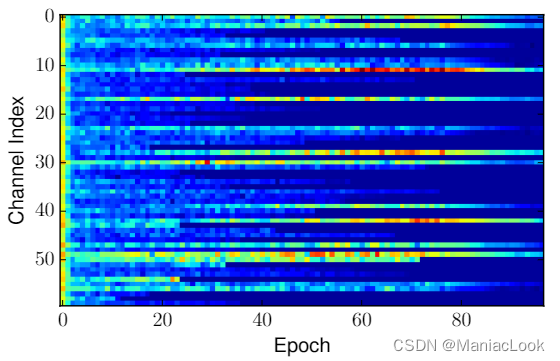
图 6:通道缩放因子在训练过程中的尺度变化的可视化,取自在
CIFAR-10上训练的VGGNet中的第 11 个卷积层。更亮的颜色对应于更大的值。亮线表示“选定”的通道,暗线表示可以修剪的通道。
6.结论
我们提出了网络瘦身技术来学习更紧凑的 CNN。它直接对批量归一化层中的缩放因子施加稀疏诱导的正则化,因此可以在训练期间自动识别不重要的通道,然后进行修剪。在多个数据集上,我们已经证明所提出的方法能够显着降低最先进网络的计算成本(高达 20 倍),而不会损失精度。更重要的是,所提出的方法同时减少了模型大小、运行时内存、计算操作,同时为训练过程引入了最小开销,并且生成的模型不需要特殊的库/硬件来进行有效的推理。
参考文献
[1] B. Baker, O. Gupta, N. Naik, and R. Raskar. Designing neural network architectures using reinforcement learning. In ICLR, 2017.
[2] S. Changpinyo, M. Sandler, and A. Zhmoginov. The power of sparsity in convolutional neural networks. arXiv preprint arXiv:1702.06257, 2017.
[3] W. Chen, J. T. Wilson, S. Tyree, K. Q. Weinberger, and Y. Chen. Compressing neural networks with the hashing trick. In ICML, 2015.
[4] S. Chintala. Training an object classifier in torch-7 on multiple gpus over imagenet. https://github.com/soumith/imagenet-multiGPU.torch.
[5] R. Collobert, K. Kavukcuoglu, and C. Farabet. Torch7: A matlab-like environment for machine learning. In BigLearn,NIPS Workshop, number EPFL-CONF-192376, 2011.
[6] M. Courbariaux and Y. Bengio. Binarynet: Training deep neural networks with weights and activations constrained to+1 or-1. arXiv preprint arXiv:1602.02830, 2016.
[7] E. L. Denton, W. Zaremba, J. Bruna, Y. LeCun, and R. Fergus. Exploiting linear structure within convolutional networks for efficient evaluation. In NIPS, 2014.
[8] R. Girshick, J. Donahue, T. Darrell, and J. Malik. Rich feature hierarchies for accurate object detection and semantic segmentation. In CVPR, pages 580–587, 2014.
[9] I. Goodfellow, D. Warde-Farley, M. Mirza, A. Courville, and Y. Bengio. Maxout networks. In ICML, 2013.
[10] S. Gross and M. Wilber. Training and investigating residual nets. https://github.com/szagoruyko/cifar.torch.
[11] S. Han, H. Mao, and W. J. Dally. Deep compression: Compressing deep neural network with pruning, trained quantization and huffman coding. In ICLR, 2016.
[12] S. Han, J. Pool, J. Tran, and W. Dally. Learning both weights and connections for efficient neural network. In NIPS, pages 1135–1143, 2015.
[13] K. He, X. Zhang, S. Ren, and J. Sun. Delving deep into rectifiers: Surpassing human-level performance on imagenet classification. In ICCV, 2015.
[14] K. He, X. Zhang, S. Ren, and J. Sun. Deep residual learning for image recognition. In CVPR, 2016.
[15] K. He, X. Zhang, S. Ren, and J. Sun. Identity mappings in deep residual networks. In ECCV, pages 630–645. Springer,2016.
[16] G. Huang, D. Chen, T. Li, F. Wu, L. van der Maaten, and K. Q. Weinberger. Multi-scale dense convolutional networks for efficient prediction. arXiv preprint arXiv:1703.09844, 2017.
[17] G. Huang, Z. Liu, K. Q. Weinberger, and L. van der Maaten. Densely connected convolutional networks. In CVPR, 2017.
[18] G. Huang, Y. Sun, Z. Liu, D. Sedra, and K. Q. Weinberger. Deep networks with stochastic depth. In ECCV, 2016.
[19] S. Ioffe and C. Szegedy. Batch normalization: Accelerating deep network training by reducing internal covariate shift.arXiv preprint arXiv:1502.03167, 2015.
[20] J. Jin, Z. Yan, K. Fu, N. Jiang, and C. Zhang. Neural network architecture optimization through submodularity and supermodularity. arXiv preprint arXiv:1609.00074, 2016.
[21] A. Krizhevsky and G. Hinton. Learning multiple layers of features from tiny images. In Tech Report, 2009.
[22] A. Krizhevsky, I. Sutskever, and G. E. Hinton. Imagenet classification with deep convolutional neural networks. In NIPS, pages 1097–1105, 2012.
[23] H. Li, A. Kadav, I. Durdanovic, H. Samet, and H. P. Graf. Pruning filters for efficient convnets. arXiv preprint arXiv:1608.08710, 2016.
[24] M. Lin, Q. Chen, and S. Yan. Network in network. In ICLR, 2014.
[25] B. Liu, M. Wang, H. Foroosh, M. Tappen, and M. Pensky.Sparse convolutional neural networks. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, pages 806–814, 2015.
[26] J. Long, E. Shelhamer, and T. Darrell. Fully convolutional networks for semantic segmentation. In CVPR, pages 3431–3440, 2015.
[27] Y. Netzer, T. Wang, A. Coates, A. Bissacco, B. Wu, and A. Y. Ng. Reading digits in natural images with unsupervised feature learning, 2011. In NIPS Workshop on Deep Learning and Unsupervised Feature Learning, 2011.
[28] M. Rastegari, V. Ordonez, J. Redmon, and A. Farhadi. Xnornet: Imagenet classification using binary convolutional neural networks. In ECCV, 2016.
[29] S. Scardapane, D. Comminiello, A. Hussain, and A. Uncini.Group sparse regularization for deep neural networks. arXiv preprint arXiv:1607.00485, 2016.
[30] M. Schmidt, G. Fung, and R. Rosales. Fast optimization methods for l1 regularization: A comparative study and two new approaches. In ECML, pages 286–297, 2007.
[31] K. Simonyan and A. Zisserman. Very deep convolutional networks for large-scale image recognition. In ICLR, 2015.
[32] S. Srinivas, A. Subramanya, and R. V. Babu. Training sparse neural networks. CoRR, abs/1611.06694, 2016.
[33] I. Sutskever, J. Martens, G. Dahl, and G. Hinton. On the importance of initialization and momentum in deep learning.In ICML, 2013.
[34] C. Szegedy, W. Liu, Y. Jia, P. Sermanet, S. Reed, D. Anguelov, D. Erhan, et al. Going deeper with convolutions. In CVPR, pages 1–9, 2015.
[35] W. Wen, C. Wu, Y. Wang, Y. Chen, and H. Li. Learning structured sparsity in deep neural networks. In NIPS, 2016.
[36] S. Zagoruyko. 92.5% on cifar-10 in torch. https://github.com/szagoruyko/cifar.torch.
[37] H. Zhou, J. M. Alvarez, and F. Porikli. Less is more: Towards compact cnns. In ECCV, 2016.
[38] B. Zoph and Q. V. Le. Neural architecture search with reinforcement learning. In ICLR, 2017.

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献3条内容

所有评论(0)