贪心算法笔记
在求解最优化问题时,面对许多问题,使用动态规划就显得有些杀鸡用牛刀,所以我们可以使用更简单更高效的贪心算法来求解一些最优解问题。贪心算法在每一步都做出当时看起来是最佳的选择,通过这样的选择希望找到全局的最优解,但是难点是在于如何证明贪心算法取得的是最优解而远不是贪心算法本身。
活动选择问题
假定有n个活动,这些活动共同使用一个资源,每个时间段只能供一个活动使用,每个活动ai都有一个开始时间si和结束时间fi,当两个活动的时间区间重叠时,就称这两个活动是不兼容的。
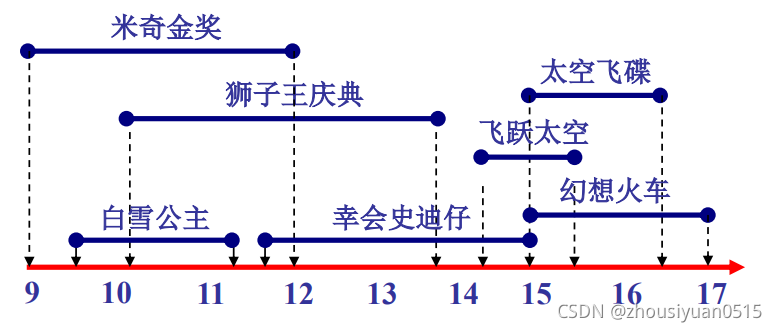
这道题显然可以通过动态规划解决,我们来看这道题的最优子结构,我们令Sij为ai结束后aj开始前的活动结合,我们要求其中最大的子集,假设ak在ai与aj之间,因此显然原问题Sij转换成两个子问题Sik与Skj,很明显的最优子结构的形式,从而我们得到其递归式。
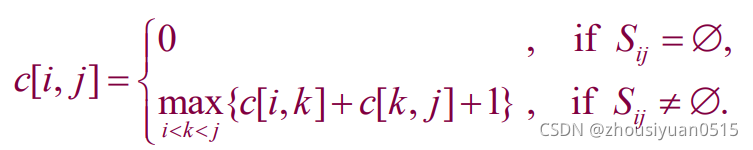
从而我们就得到了动态规划的大体解法,但是对于这个问题,我们还有另外的选择。如果我们可以不对所有子问题进行求解,那么相比会使问题的解决更为简便。首先我们观察解的形式,对于Sij,我们观察到首先进行的活动一定是最先结束的活动,即am最先结束的活动一定包含在某个最大的相容活动子集中。然后我们要求解的问题就转化为一个Smj的问题,显然可以继续进行递归。因此我们从这里观察到,我们解决这个问题是一个不断进行选择的过程,通过某个条件不断进行贪心选择,这个选择只受之前选择的影响而不由之后的选择影响。在活动选择问题中,我们进行的选择显然就是对最先结束的活动进行选择通过不断地贪心选择最后得到最优解。
而显然,贪心算法与动态规划算法是一个不同的过程,动态规划是通过不断的求解子问题最终得到问题的最优解,是一个自底向上的递归求解过程,而贪心是不断的进行贪心选择,先解决子问题不断向最优解靠拢,是一个自顶而下的递归过程。
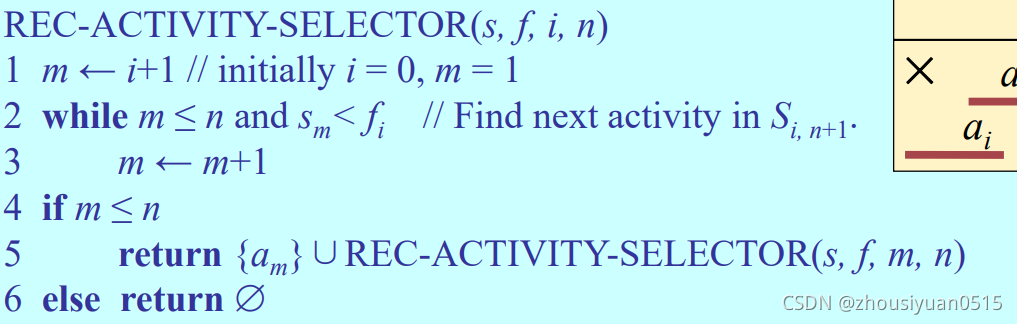
因此我们得到贪心算法的特征:总是希望当前选择是最优的,通过当前的最优选择能产生最优解的问题。(难点在于证明贪心算法有效)贪心算法面对问题更简单也更有效,相较于DP每个子问题都需要求解,贪心显得简单易行得多。
#include<stdio.h>
#include<algorithm>
using namespace std;
struct Task
{
	int begin;
	int end;
};
int cmp(struct Task t1,struct Task t2)
{
	return t1.end<t2.end;
}
int main()
{
   struct Task t[1000001];
   	int N;
   	scanf("%d",&N);
   	for(int i=0;i<N;i++)
   	  scanf("%d %d",&t[i].begin,&t[i].end);
   	sort(t,t+N,cmp);
	int cnt=1;
	int temp=t[0].end;
	for(int i=1;i<N;i++)
	{
		if(t[i].begin>=temp)
		{
			cnt++;
			temp=t[i].end;
		}
	}
	printf("%d",cnt);
	return 0;
}
贪心算法原理
对于一个问题,我们可以设计一个过程设计贪心算法:
- 将最优化问题转化为这样的形式:对其做出一次选择后,只剩下一个子问题需要求解。
- 证明做出贪心选择后,原问题总是存在最优解,即贪心选择总是安全的。
- 证明做出贪心选择后,剩余的子问题满足性质:其最优解与贪心选择组合即可得到原问题的最优解,这样就得到了最优子结构。
其中重要的是两个点一个是相应子结构的有效性和贪婪属性如何选择。我们通过局部最优构造全局最优,我们选择的时候直接进行最优选择而不去考虑他对子问题产生的影响。因此贪心算法进行第一次选择之前无需解决任何子问题。之后就是最优子结构的问题,这是动态规划和贪心的共同问题,最优解是否包含最优子结构,在进行了贪心选择之后得到的子问题与贪心选择的结果是否能组成最优解。
下面用两个实例对贪心与DP进行区别:
01背包问题
总共n个物品,每个物品重量为wi,价值为vi,我们有一个容纳W的背包,问如何取能得到价值最大的背包。
#include <stdio.h>


int v[1005], w[1005];
long long f[100001] = {0};
long long dp[1005][100001];

long long max(long long a,long long b)
{
if (a>b) return a;
else return b;
}

int main(){
	int n,k;
	scanf("%d%d",&n,&k);

	for(int i = 1;i <= n;i++){
		scanf("%d%d",&v[i],&w[i]);
	}
	for(int i = 1;i <= n;i++){
		for(int j = k;j >= 0;j--){
			if(j - w[i] >= 0)f[j] = max(f[j - w[i]] + v[i],f[j]);

		}
	}
	printf("%lld",f[k]);
}
分数背包问题
设定与之前相同,对每个物品我们可以取一部分而不必全部拿走,如何取获得价值更高的背包,显然我们可以通过贪婪选择选择取性价比更高的物体取填满背包。这个问题比较简单就不放码了。
赫夫曼编码
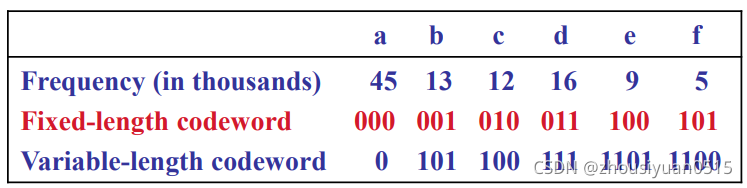
赫夫曼编码能够有效的压缩数据,通过字符出现的概率表使用二进制串来建立一种表示字符的方法。
前缀码
我们这里只考虑前缀码,即没有任何码字是其他码字的前缀。前缀码的作用就是进化解码过程,由于没有码字是其他码字的前缀,所以开始码字是没有歧义的,因此我们可以通过一颗二叉树实现解码需求。字符的二进制码字从根节点到该字符的叶节点的简单路径表示,其中0意味着转向左边,1意味着转向右边,注意编码树不是二叉搜索树,因为叶节点并未有序排列,内部节点也没有包含字符关键字。

文件的最优编码总是对应一棵满二叉树,即每个非叶节点都有两个孩子节点。
构造赫夫曼编码
首先将字符按照频率排序,使用一个优先队列,每次取出最小的两个元素合并为一个再次进入优先队列,这两个元素作为叶子节点,直至队列中只有一个元素,赫夫曼编码树构造完毕。
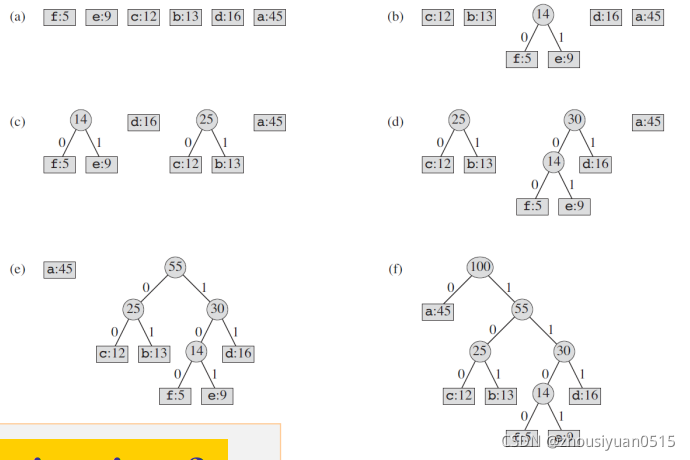
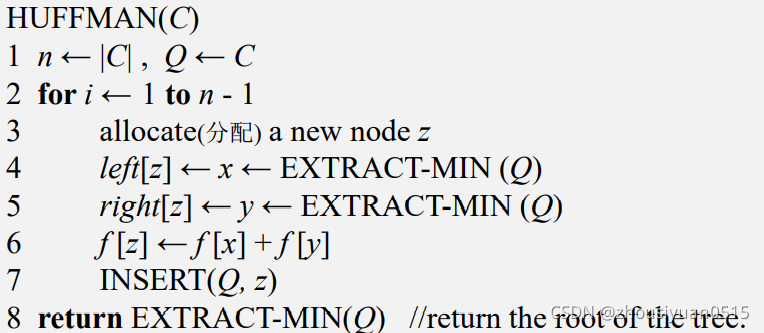
#include <stdio.h>
#include <queue>
#include<iostream>
#include<algorithm>
using namespace std;
priority_queue<long long,vector<long long>,greater<long long> > q;

long long huffman() //哈夫曼树,贪心算法
{
    long long res=0;
    while(q.size()>=2){          //每次合并最小的两个元素
        long long a=q.top();q.pop();
        long long b=q.top();q.pop();
        q.push(a+b);
        res+=a+b;      //计算代价
    }
    return res;
}

int main()
{
	int N;
    while(cin>>N){
        while(!q.empty()) q.pop();
        while(N--){
            long long tmp;
            cin>>tmp;
            q.push(tmp);    //直接入队
        }
        cout<<huffman()<<endl;
		break;
    }
}
分析赫夫曼算法的运行时间,Q使用最小二叉堆实现因此,运行时间为O(nlglgn)。
加权拟阵和任务调度没看懂就下次再写把。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)