【论文笔记】AdvDrop: Adversarial Attack to DNNs by Dropping Information
一篇当时也没怎么看懂也没留点笔记的文章。。。
Motivation
我们都知道对抗扰动是在图片上添加了一些对DNN有意义但对人类无意义且大多数时间无法察觉的特征。反过来想,如果删除一些人类无法察觉但对DNN至关重要的特征呢?毕竟人类可以很容易识别信息丢失的视觉对象,甚至只有轮廓人类也可以识别。
Contribution
1.提出了AdvDrop这种攻击
2.实验证实该攻击的有效性(targeted和non-targeted)
3.丢失信息和DNN的注意力可视化,以解释AdvDrop
Method
这篇文章并没有像其他文章那样给算法框架,不过总体流程大概是:
1.DCT变换至频域
2.基于本文提出的quantization table q做优化,实现丢掉图片细节信息的目标
3.IDCT再变换到时域
解决的目标问题如下:
Q就是上面提到的quantization table q.D就是DCT,加个I就是IDCT…我真的好懒
Adversarial loss
即上式的L,如下规定:

其中p为概率输出,即logits上面的softmax输出。
Quantization
并不太理解作者说的舍入和截断,但看公式感觉比较明了:
注意,这里的△\triangle△和上面提到的q同义。
然而事情没那么简单。[]函数是阶梯函数。并没有办法求导,也就没有办法后向传播来进行优化了。为此,作者参考了Differentiable soft quantization: Bridging full-precision and low-bit neural networks.这篇文章,对Q进行的改进,得到QdiffQ_{diff}Qdiff:
其中的ϕ\phiϕ函数为:
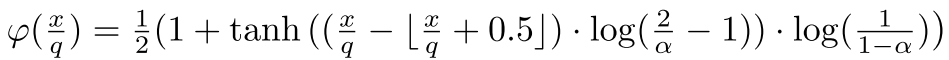
其中α\alphaα为可调整的参数。
为啥改进了之后还有阶梯函数??回头看一下代码=-=
又因为q必须为整数,于是q选择用sign函数来更新,就变成了下图:
Transformation
指的是DCT和反DCT变换啦,作者并没有多说,只是在进行DCT变换之前把原图划分为N*N的块。这里作者选择了N=8。N太大会导致块内像素之间的相关性降低,且对于每个块像素值都被调整为相对0对称。DCT数学定义如下:
感觉DCT变换也需要仔细看一下。。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)