[Inception V2/V3]One-hot、Label Smooth、知识蒸馏
One-hot
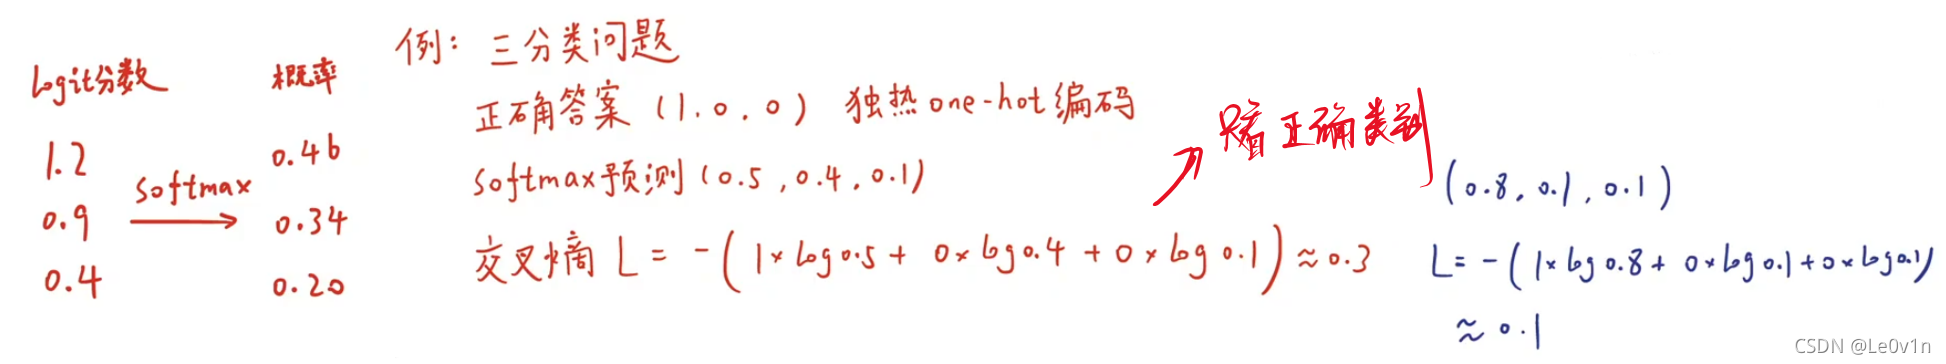
如果使用One-hot编码来训练网络存在一个问题:
采样One-hot编码,交叉熵损失函数只看正确类别,错误的就不看了。因为交叉熵是通过极大似然估计推导出来的(二者可以看成是等价的):
Loss=−∑i=1kqilog(pi)=−log(py)=−Zy+log(∑i=1keZi)
Loss=-\sum_{i=1}^{k}q_ilog\left(p_i\right)=-log\left(p_y\right)=-Z_y+log\left(\sum_{i=1}^{k}e^{Z_i}\right)
Loss=−i=1∑kqilog(pi)=−log(py)=−Zy+log(i=1∑keZi)
其中qiq_iqi为不同类别的概率,kkk为分类的个数。
在训练过程中网络会尽可能增大[正确类别]的概率ZyZ_yZy(Loss就减少),所以ZyZ_yZy需要增大,一直增大到+∞+\infty+∞ —— 正确类别对应的分数logit会一味增大,直到+∞+\infty+∞。
为了达到这样的效果,网络在训练过程中会无所不用其极的去增大[正确类别]的分数logit,缺点:
- 有过拟合的风险——死记硬背无法泛化
- 鼓励模型对于[结果]过于自信——不计一切增大某一类的logit
Label Smooth
不再使用One-hot编码对模型进行训练了,相当于是把标签进行弱化:
qi={1−ϵ,i=y时(正确类别)ϵk−1,i≠y时(错误类别) q_i=\begin{cases} 1-ϵ,&i=y时(正确类别) \\ \frac{ϵ}{k-1},&i≠y时(错误类别) \end{cases} qi={1−ϵ,k−1ϵ,i=y时(正确类别)i=y时(错误类别)
其中qiq_iqi为不同类别的概率,kkk为分类的个数。
原始One-hot标签(1,0,0,0)⟶ϵ=0.1\overset{\epsilon=0.1}{\longrightarrow}⟶ϵ=0.1(1−ϵ1-\epsilon1−ϵ,ϵ4−1\frac{\epsilon}{4-1}4−1ϵ,ϵ4−1\frac{\epsilon}{4-1}4−1ϵ,ϵ4−1\frac{\epsilon}{4-1}4−1ϵ)=(0.9,0.3333,0.3333,0.3333)
我们用这个弱化之后的标签去训练模型,虽然表面上看我们是把它的正确答案篡改了,让模型变得更加困惑(甚至于告诉它不正确的类别也有一定的概率),但实际上我们能够让模型不那么过于自信、过于死记硬背——不要一味增大正确类别的logit
[Label Smooth处理之后]正确类别对应的分数logit:
Z∗={log(k−1)(1−ϵ)ϵ+α,i=y时(正确类别)α,i≠y时(错误类别) Z^\ast=\begin{cases} log\frac{(k-1)(1-ϵ)}{ϵ}+α,&i=y时(正确类别) \\ \alpha,&i≠y时(错误类别) \end{cases} Z∗={logϵ(k−1)(1−ϵ)+α,α,i=y时(正确类别)i=y时(错误类别)
- α\alphaα可以是任意实数
- Z∗Z^\astZ∗不再会增大到 +∞+\infty+∞ 了——有一个上界
知识蒸馏(Knowledge Distillation)
Label Smooth有点像我们之前讲过的知识蒸馏——Knowledge Distillation。
知识蒸馏表示:用一个老师模型,如预训练好的VGG/GoogLeNet去教一个学生模型。不像Label Smooth,知识蒸馏并不是把所有的错误类别用同一个概率替代,而是把相关类别的概率尽可能的一致。
比如我们的图像中有一种猫,这1000个种类中,猫和老虎、豹子、狮子都比较像,那么这些相关类别的概率应该有一些增大。
我们用这样蒸馏之后的概率去训练模型,也可以起到防止过拟合、加速模型收敛速度。
Label Smooth相当于是一个低级版本的知识蒸馏。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献4条内容

所有评论(0)