Spring boot + Sharding JDBC 分库分表 及 分布式事务处理
Sharding JDBC 基础概念
Apache ShardingSphere 是一套开源的分布式数据库解决方案组成的生态圈,它由 JDBC、Proxy 和 Sidecar(规划中)这 3 款既能够独立部署,又支持混合部署配合使用的产品组成。 它们均提供标准化的数据水平扩展、分布式事务和分布式治理等功能,可适用于如 Java 同构、异构语言、云原生等各种多样化的应用场景。
Apache ShardingSphere 旨在充分合理地在分布式的场景下利用关系型数据库的计算和存储能力,而并非实现一个全新的关系型数据库。 关系型数据库当今依然占有巨大市场份额,是企业核心系统的基石,未来也难于撼动,我们更加注重在原有基础上提供增量,而非颠覆。
Apache ShardingSphere 5.x 版本开始致力于可插拔架构,项目的功能组件能够灵活的以可插拔的方式进行扩展。 目前,数据分片、读写分离、数据加密、影子库压测等功能,以及 MySQL、PostgreSQL、SQLServer、Oracle 等 SQL 与协议的支持,均通过插件的方式织入项目。 开发者能够像使用积木一样定制属于自己的独特系统。Apache ShardingSphere 目前已提供数十个 SPI 作为系统的扩展点,仍在不断增加中。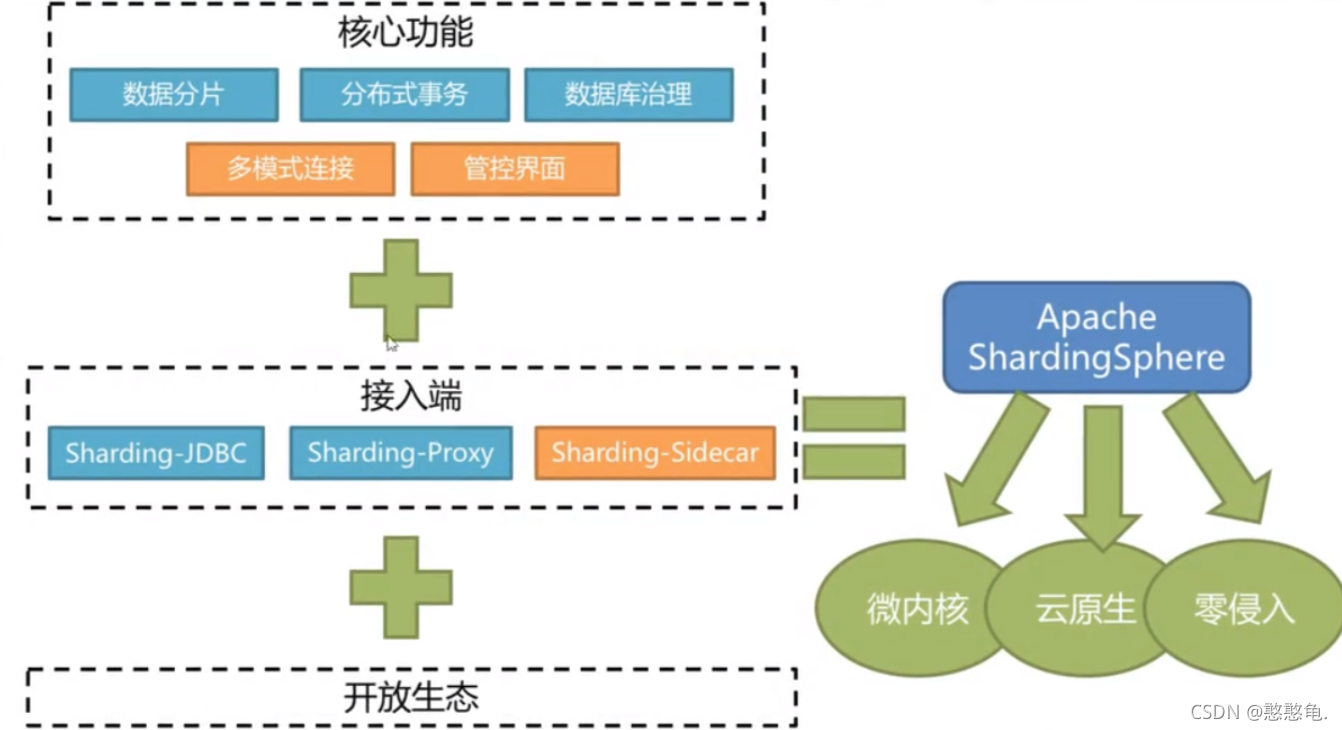
简单使用
引入依赖
 		<!-- sharding jdbc 依赖 -->
        <dependency>
            <groupId>org.apache.shardingsphere</groupId>
            <artifactId>sharding-jdbc-spring-boot-starter</artifactId>
            <version>4.0.0-RC1</version>
        </dependency>

        <dependency>
            <groupId>org.apache.shardingsphere</groupId>
            <artifactId>sharding-core-common</artifactId>
            <version>4.0.0-RC1</version>
        </dependency>

        <!-- 分布式事务管理 -->
        <dependency>
            <groupId>io.shardingsphere</groupId>
            <artifactId>sharding-transaction-spring-boot-starter</artifactId>
            <version>3.1.0</version>
        </dependency>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>

        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-test</artifactId>
            <scope>test</scope>
        </dependency>

        <dependency>
            <groupId>org.mybatis.spring.boot</groupId>
            <artifactId>mybatis-spring-boot-starter</artifactId>
            <version>2.1.4</version>
        </dependency>

        <dependency>
            <groupId>mysql</groupId>
            <artifactId>mysql-connector-java</artifactId>
        </dependency>

        <dependency>
            <groupId>com.alibaba</groupId>
            <artifactId>druid-spring-boot-starter</artifactId>
            <version>1.1.21</version>
        </dependency>

        <dependency>
            <groupId>org.projectlombok</groupId>
            <artifactId>lombok</artifactId>
            <optional>true</optional>
        </dependency>
编写application配置
我这边将配置文件拆开,方便演示不同策略进行分库分表。
server:
  port: 8085

spring:
  main:
    allow-bean-definition-overriding: true
  profiles:
    active: sub

mybatis:
  mapper-locations: classpath:mapper/*.xml
在处理分库分表的时候,我们可以分库分表同时进行,或者单独分库或者分表,通过设置相应的策略实现相应的功能。
spring:
  main:
    allow-bean-definition-overriding: true
  shardingsphere:
    # 参数配置 ,显示SQL
    props:
      sql:
        show: true
    # 配置数据源
    datasource:
      # 给每个数据源取别名 任意取
      names: ds0,ds1
      # 给master-ds1配置数据库连接信息
      ds0:
        type: com.alibaba.druid.pool.DruidDataSource
        driver-class-name: com.mysql.cj.jdbc.Driver
        url: jdbc:mysql://192.168.26.128:3306/myslave?useSSL=false&useUnicode=true&characterEncoding=utf-8
        username: root
        password: 123456
        maxPoolSize: 100
        minPoolSize: 5
      ds1:
        type: com.alibaba.druid.pool.DruidDataSource
        driver-class-name: com.mysql.cj.jdbc.Driver
        url: jdbc:mysql://192.168.26.129:3306/myslave?useSSL=false&useUnicode=true&characterEncoding=utf-8
        username: root
        password: 123456
        maxPoolSize: 100
        minPoolSize: 5
    #配置默认数据源ds0
    sharding:
      # 默认数据源,主要用于写,注意一定要配置;如果不配置就会把三个节点都当作从slave节点,新增,修改和删除会出错。
      default-data-source-name: ds0
      # 配置分表规则 --》单数存储在user1中,偶数存放在user0中
      tables:
        # 逻辑表名 user
        user:
          # 数据节点 : 数据源${0..N}.逻辑表名${0..N},
          # ds0.user0 代表ds0数据中的user0表
          actual-data-nodes: ds${0..1}.user${0..1}
          # 只分表不分库
          # actual-data-nodes: ds0.user${0..1}
          # 拆分库策略 将数据存放到指定库中
          database-strategy:
            inline:
              sharding-column: age  # 分片字段
              algorithm-expression: ds${age % 2}  # 分片算法表达式
          table-strategy:
            inline:
              sharding-column: age  # 分片字段
              algorithm-expression: user${age % 2}  # 分片算法表达式
创建数据库
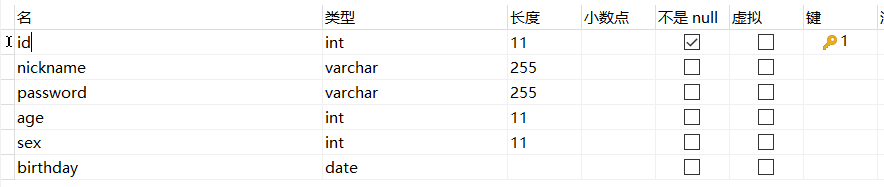
由上文的配置可知,我们需要在两台虚拟机中分表创建两张user表,分别是user0,user1;如果不创建的话会导致我们插入数据失败。
编写业务代码
实体类
@Data
public class User {
    private Long id;

    private String nickname;

    private String password;

    private Integer age;

    private Integer sex;

    private Date birthday;
}
Mapper
@Mapper
public interface UserMapper {

    @Insert("insert into user(nickname,password,age,sex,birthday) values(#{nickname},#{password},#{age},#{sex},#{birthday})")
    void addUser(User user);

    @Select("select * from user")
    List<User> findUsers();
}
测试
	@Autowired
    private UserMapper userMapper;

    @Test
    void contextLoads() {
        User user = new User();
        user.setNickname("张三" + new Random().nextInt());
        user.setPassword("123");
        user.setAge(22);
        user.setSex(22);
        user.setBirthday(new Date());
        userMapper.addUser(user);
    }
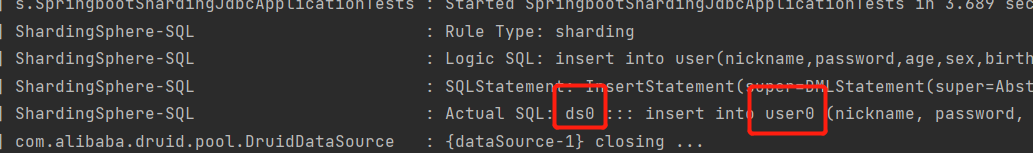
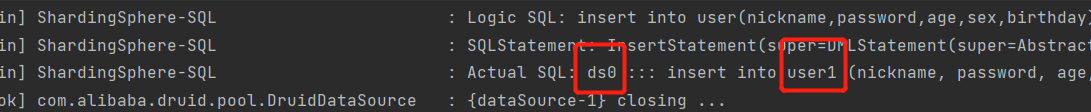
可以看到将数据插入到ds0数据库中的user0表中。
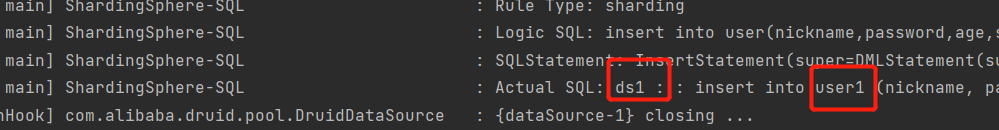
将测试代码中的年龄修改为单数后,可以发现数据插入到ds1数据库中的user1表中。
使用standard策略进行分片
该案例根据上述用户表中的birthday字段进行分片。
编写application配置
spring:
  main:
    allow-bean-definition-overriding: true
  shardingsphere:
    # 参数配置 ,显示SQL
    props:
      sql:
        show: true
    # 配置数据源
    datasource:
      # 给每个数据源取别名 任意取
      names: ds0,ds1
      # 给master-ds1配置数据库连接信息
      ds0:
        type: com.alibaba.druid.pool.DruidDataSource
        driver-class-name: com.mysql.cj.jdbc.Driver
        url: jdbc:mysql://192.168.26.128:3306/myslave?useSSL=false&useUnicode=true&characterEncoding=utf-8
        username: root
        password: 123456
        maxPoolSize: 100
        minPoolSize: 5
      ds1:
        type: com.alibaba.druid.pool.DruidDataSource
        driver-class-name: com.mysql.cj.jdbc.Driver
        url: jdbc:mysql://192.168.26.129:3306/myslave?useSSL=false&useUnicode=true&characterEncoding=utf-8
        username: root
        password: 123456
        maxPoolSize: 100
        minPoolSize: 5
    #配置默认数据源ds0
    sharding:
      # 默认数据源,主要用于写,注意一定要配置;如果不配置就会把三个节点都当作从slave节点,新增,修改和删除会出错。
      default-data-source-name: ds0
      # 配置分表规则 --》单数存储在user1中,偶数存放在user0中
      tables:
        # 逻辑表名 user
        user:
          actual-data-nodes: ds${0..1}.user${0..1}
          # 拆分库策略 将数据存放到指定库中
          database-strategy:
            standard:
              shardingColumn: birthday
              preciseAlgorithmClassName: com.example.springbootshardingjdbc.algorithm.BirthdayAlgorithm
          table-strategy:
            inline:
              sharding-column: age  # 分片字段
              algorithm-expression: user${age % 2}  # 分片算法表达式
编写策略配置文件
datalist的数量要根据你定义的数据库数量来,否则会出错。
public class BirthdayAlgorithm implements PreciseShardingAlgorithm<Date> {

    List<Date> dateList = new ArrayList<>();

    {
        Calendar calendar1 = Calendar.getInstance();
        calendar1.set(2021, 1, 1, 0, 0, 0);
        Calendar calendar2 = Calendar.getInstance();
        calendar2.set(2022, 1, 1, 0, 0, 0);
        dateList.add(calendar1.getTime());
        dateList.add(calendar2.getTime());
    }

    @Override
    public String doSharding(Collection<String> collection, PreciseShardingValue<Date> preciseShardingValue) {
        // 获取属性数据库的值
        Date date = preciseShardingValue.getValue();
        // 获取数据源的名称消息列表
        Iterator<String> iterable = collection.iterator();
        String target = null;
        for (Date date1 : dateList) {
            target = iterable.next();
            //如果数据晚于指定日期
            if (date.before(date1)) {
                break;
            }
        }
        return target;
    }
}
测试
 	@Test
    void contextLoads() {
        User user = new User();
        user.setNickname("张三" + new Random().nextInt());
        user.setPassword("123");
        user.setAge(1);
        user.setSex(22);
        user.setBirthday(new Date());
        userMapper.addUser(user);
    }
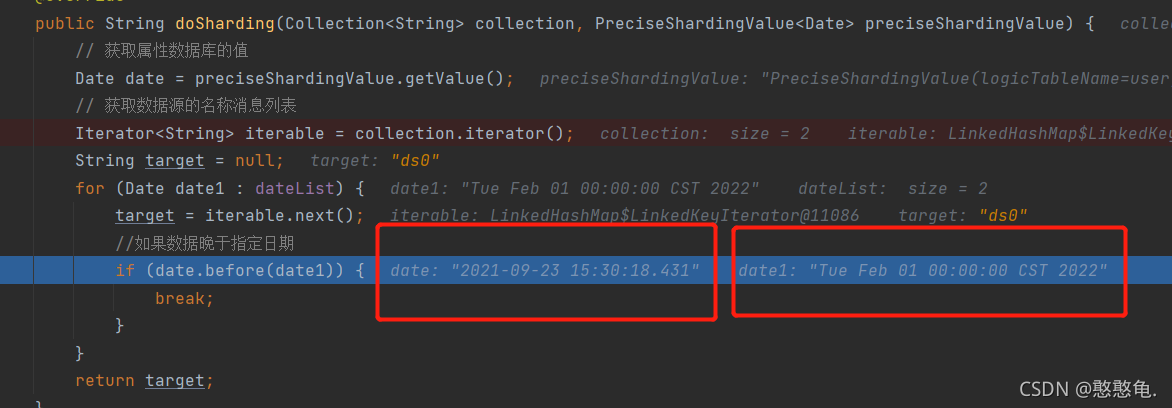
由于当前时间晚于datalist时间,所以直接返回第一个数据库,将数据插入到ds0数据库中。
插入数据时主键使用雪花算法
只需要在application中进行配置即可;配置雪花算法之后,我们需要将数据库中主键的类型改为bigint型。
 #配置默认数据源ds1
    sharding:
      # 默认数据源,主要用于写,注意一定要配置读写分离;如果不配置就会把三个节点都当作从slave节点,新增,修改和删除会出错。
      default-data-source-name: ds0
      # 配置分表规则 --》单数存储在user1中,偶数存放在user0中
      tables:
        # 逻辑表名 user
        user:
          key-generator:
            # 主键 雪花算法
            column: id
            type: SNOWFLAKE
          # 只分表不分库
          actual-data-nodes: ds0.user${0..1}
          table-strategy:
            inline:
              sharding-column: age  # 分片字段
              algorithm-expression: user${age % 2}  # 分片算法表达式
按照日期将数据插入到对应的表中
我们可以将数据按照日期分别存放到对应的表中,比如订单数据,我们可以将其区分为1月的订单,2月的订单等。这里采用最简单的方法,直接通过字段进行匹配存放。
创建数据库
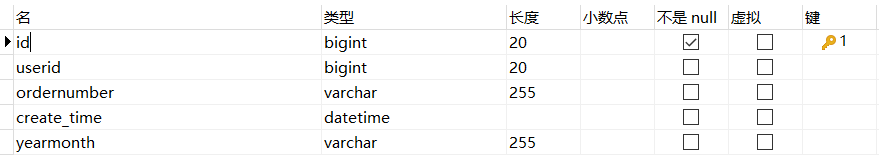
这边只演示分表,没进行分库,所以只需要在本地数据库创建3张order表即可,分别是order_202101,order_202102,order_202103。
编写application配置
spring:
  main:
    allow-bean-definition-overriding: true
  shardingsphere:
    # 参数配置 ,显示SQL
    props:
      sql:
        show: true
    # 配置数据源
    datasource:
      # 给每个数据源取别名 任意取
      names: ds0,ds1
      # 给master-ds1配置数据库连接信息
      ds0:
        type: com.alibaba.druid.pool.DruidDataSource
        driver-class-name: com.mysql.cj.jdbc.Driver
        url: jdbc:mysql://192.168.26.128:3306/myslave?useSSL=false&useUnicode=true&characterEncoding=utf-8
        username: root
        password: 123456
        maxPoolSize: 100
        minPoolSize: 5
      ds1:
        type: com.alibaba.druid.pool.DruidDataSource
        driver-class-name: com.mysql.cj.jdbc.Driver
        url: jdbc:mysql://192.168.26.129:3306/myslave?useSSL=false&useUnicode=true&characterEncoding=utf-8
        username: root
        password: 123456
        maxPoolSize: 100
        minPoolSize: 5
    #配置默认数据源ds1
    sharding:
      # 默认数据源,主要用于写,注意一定要配置读写分离;如果不配置就会把三个节点都当作从slave节点,新增,修改和删除会出错。
      default-data-source-name: ds0
      # 配置分表规则 --》单数存储在user1中,偶数存放在user0中
      tables:
        # 逻辑表名 user
        order:
          key-generator:
            # 主键 雪花算法需要修改
            column: id
            type: SNOWFLAKE
          # collect 的作用是补0 order_2021_01
          actual-data-nodes: ds0.order_2021${(1..3).collect{t->t.toString().padLeft(2,'0')}}
          table-strategy:
            inline:
              sharding-column: yearmonth  # 分片字段
              algorithm-expression: order_${yearmonth}  # 分片算法表达式
编写业务代码
实体类
@Data
public class Order {

    private Long id;

    private String ordernumber;

    private Long userid;

    private String yearmonth;

    private Date createTime;
}
mapper
由于我们使用yearmonth进行分片,所以我们插入数据时必须带上该属性,如果不带的话则会插入到所有表中。
@Mapper
public interface OrderMapper {

    @Insert("insert into order(ordernumber,userid,create_time,yearmonth) values(#{ordernumber},#{userid},#{createTime},#{yearmonth})")
    void addUserOrder(Order order);

    @Select("select count(1) from order")
    Integer count();

}
测试
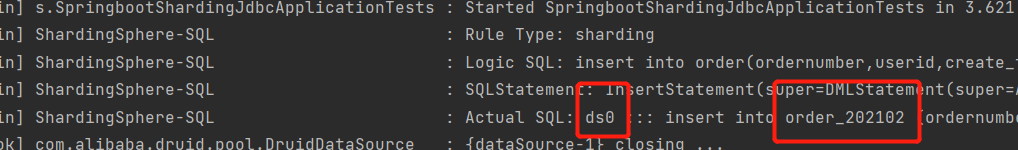
可以看到将yearmonth设置为202102后,将该条数据插入到order_202102表中。
	@Test
    void order() {
        Order order = new Order();
        order.setUserid(1L);
        order.setOrdernumber("123");
        order.setCreateTime(new Date());
        order.setYearmonth("202102");
        orderMapper.addUserOrder(order);
    }
分布式事务处理
在处理事务的时候,如果发生错误,我们需要进行数据的回滚,确保数据的一致性。sharding jdbc 也提供了相对应的方法。
首先需要添加相关依赖
	<dependency>
       <groupId>io.shardingsphere</groupId>
       <artifactId>sharding-transaction-spring-boot-starter</artifactId>
       <version>3.1.0</version>
    </dependency>
     // 分布式事务回滚
    @ShardingTransactionType(TransactionType.XA)
    //单库 事务回滚
    @Transactional(rollbackFor = Exception.class)
    public int saveUserOrder(User user, Order order) {
        userMapper.addUser(user);

        //int a = 1 / 0;

        orderMapper.addUserOrder(order);
        return 1;
    }
如果是单数据库,我们可以使用Transactional注解进行事务的回滚;
如果是微服务架构,我们则可以使用ShardingTransactionType注解处理;

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献5条内容

所有评论(0)