hive建库,建表,以及内外部表,分区表,分桶表
·
hive建库
建库语法
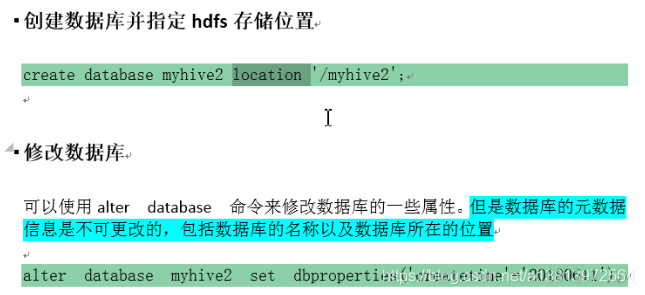
创建一个hive的数据库,就会默认创建一个对应的文件夹在这个路径下面
hive.metastore.warehouse.dir
/user/hive/warehouse
create database;语法
查看数据库信息
查看数据库基本信息
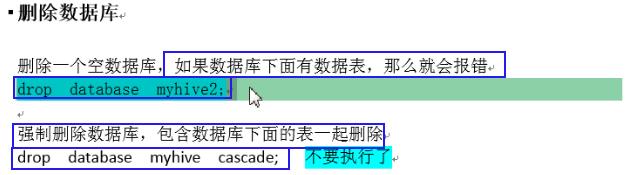
desc database myhive2;
查看数据库更多详细信息
desc database extended myhive2;
hive建表
[(col_name data_type [COMMENT col_comment], ...)] 列注释
[COMMENT table_comment] 表注释
[PARTITIONED BY (col_name data_type [COMMENT col_comment], ...)]
[CLUSTERED BY (col_name, col_name, ...)
[SORTED BY (col_name [ASC|DESC], ...)] INTO num_buckets BUCKETS]
[ROW FORMAT row_format]
[STORED AS file_format]
[LOCATION hdfs_path]```
external 定义我们的表为外部表
location 指定我们表里面的数据应该存放在hdfs的哪个位置
partitioned by 创建分区表 按照文件夹,将不同的数据,划分到不同的文件夹下面去
clustered by 分桶表 将我们的数据按照一定的规则,划分到多个文件里面去
store as 指定数据的存储格式 text sequenceFile parquet orc
row format 指定我们hive建表的分隔符,与我们hdfs的数据的分隔符保持一致,才能够映射hdfs上面的数据到对应的hive的表的字段里面来
like允许用户复制现有的表结构,但是不复制数据
#### hive当中的四种常见的表模型:
#### 内部表
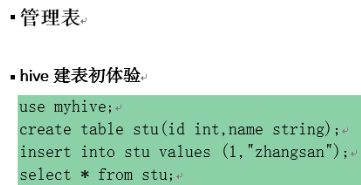
==第一种表模型:管理表,又叫做内部表 删除表的时候,hdfs上面对应的数据,同步删除==
hive当中的默认分隔符: \001 键盘打不出来 asc码值 非打印字符 避免分隔符的冲突
创建表指定字段之间的分隔符,指定数据的存储格式,指定数据的存放位置
```create table if not exists stu2(id int ,name string) row format delimited fields terminated by '\t' stored as textfile location '/user/stu2';```
根据查询结果创建表,复制表结构,并且复制表数据到我们创建的表里面去
```create table stu3 as select * from stu2;```
仅仅复制表结构,不复制表数据
```create table stu4 like stu2;```
查看表的类型
```desc formatted tableName;```
#### 外部表
==外部表:删表的时候不会删除hdfs上面的数据==
指定hdfs其他位置的路径的数据,加载到hive的表当中来
hive认为数据是从其他地方移动过来的,hive表没有完全的独占这份数据,删除表的时候不能够删除数据
本地磁盘:local
hdfs文件系统:不加local
```load data [local] inpath '/export/servers/hivedatas/techer.csv' into table techer```
从本地加载数据的时候:本地数据没有动
从hdfs上面加载数据的时候:把数据移动到了我们hive表的location位置了
如果没有指定location位置,那么默认表的位置在 /usr/hive/warehouse/dbname/tablename
创建外部表
创建老师表:
```create external table techer (t_id string,t_name string) row format delimited fields terminated by '\t';```
创建学生表:
```create external table student (s_id string,s_name string,s_birth string , s_sex string ) row format delimited fields terminated by '\t';```
加载数据
从本地文件系统向表中加载数据
```load data local inpath '/export/servers/hivedatas/student.csv' into table student;```
加载数据并覆盖已有数据
```load data local inpath '/export/servers/hivedatas/student.csv' overwrite into table student;```
内部表与外部表的创建:
```external关键字决定了我们是内部表还是外部表```
内部表:删表的时候,同时删除hdfs的数据
外部表:删表的时候,不会删除hdfs上面的数据
#### 分区表
分区表:一般没有一种独立的表模型,只有内部分区表,或者外部分区表
核心的思想,也是分治:数据量越少,跑起来就会越快
可以按照一定的规则,创建一些文件夹,可以根据指定的文件夹,找到我们指定的数据
```/user/hive/warehouse/myhive.db/score/month=201808```
```/user/hive/warehouse/myhive.db/score/month=201809```
```/user/hive/warehouse/myhive.db/score/month=201810```
分区表加载数据的语法
加载数据到分区表中
```load data local inpath '/export/servers/hivedatas/score.csv' into table score partition (month='201806');```
加载数据到一个多分区的表中去
```load data local inpath '/export/servers/hivedatas/score.csv' into table score2 partition(year='2018',month='06',day='01');```
#### 分桶表
第四种表模型 桶表 一般也是与内部表或者外部表搭配使用
可以将我们的数据按照一定的规则,划分成多个文件里面去
分桶表我们指定某一个字段进行分桶,其实就是将这个字段运行了一把mr的程序,以这个字段作为key2,
应用mr的分区规则(HashParttiioner) 通过多个reducer输出多个文件

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)