八股文——数据结构
查找
1、二分查找
说明:元素必须是有序的,如果是无序的则要先进行排序操作。
复杂度分析:最坏情况下,关键词比较次数为 l o g 2 n + 1 log_2{n} + 1 log2n+1,且期望时间复杂度为 l o g 2 n log_2{n} log2n ;
折半查找是一棵二叉排序树,每个根结点的值都大于左子树的所有结点的值,小于右子树所有结点的值。
int BinarySearch1(int[] a, int value, int n)
{
    int low, high, mid;
    low = 0;
    high = n-1;
    while(low <= high)
    {
        mid = (low+high)/2;
        if(a[mid]==value)
            return mid;
        else if(a[mid]>value)
            high = mid-1;
        else if(a[mid]<value)
            low = mid+1;
    }
    return -1;
}
2、插值查找
在介绍插值查找之前,首先考虑一个新问题,为什么上述算法一定要是折半,而不是折四分之一或者折更多呢?
基本思想:基于二分查找算法,将查找点的选择改进为自适应选择,可以提高查找效率。当然,差值查找也属于有序查找。
二分查找中查找点计算如下:
mid=(low+high)/2, 即mid=low+1/2*(high-low);
通过类比,我们可以将查找的点改进为如下:
mid=low+(key-a[low])/(a[high]-a[low])*(high-low)
也就是将上述的比例参数1/2改进为自适应的,根据关键字在整个有序表中所处的位置,让mid值的变化更靠近关键字key,这样也就间接地减少了比较次数。
复杂度分析:查找成功或者失败的时间复杂度均为 O ( l o g 2 ( l o g 2 n ) ) O(log_2{(log_2{n}})) O(log2(log2n)) 。
//插值查找
int InsertionSearch(int[] a, int value, int low, int high)
{
    if(low <= high)
    {
        int mid = low+(value-a[low])/(a[high]-a[low])*(high-low);
        if(a[mid]==value)
            return mid;
        if(a[mid]>value)
            return InsertionSearch(a, value, low, mid-1);
        if(a[mid]<value)
            return InsertionSearch(a, value, mid+1, high);
    }
    else
        return -1;
}
排序
希尔排序
链接
想法来自简单排序
- 将数的个数设为n,取奇数k=n/2,将下标差值为k的书分为一组,构成有序序列。
- 再取k=k/2 ,将下标差值为k的书分为一组,构成有序序列。
- 重复第二步,直到k=1执行简单插入排序。
如何写成代码:
- 首先确定分的组数。
- 然后对组中元素进行插入排序。
- 然后将length/2,重复1,2步,直到length=0为止。
public  void sheelSort(int[] a){
        int d  = a.length;
        while (d!=0) {
            d=d/2;
            for (int x = 0; x < d; x++) {//分的组数
                for (int i = x + d; i < a.length; i += d) {//组中的元素,从第二个数开始
                    int j = i - d;//j为有序序列最后一位的位数
                    int temp = a[i];//要插入的元素
                    while(j >= 0 && temp < (a[j -= d])) {//从后往前遍历。
                        a[j + d] = a[j];//向后移动d位
                    }
                    a[j + d] = temp;
                }
            }
        }
    }
简单选择排序
第一次选择一个最小的数,放在第一个,然后一直循环做n次。
 public void selectSort(int[] a) {
        int length = a.length;
        for (int i = 0; i < length; i++) {//循环次数
            int key = a[i];
            int position=i;
            for (int j = i + 1; j < length; j++) {//选出最小的值和位置
                if (a[j] < key) {
                    key = a[j];
                    position = j;
                }
            }
            a[position]=a[i];//交换位置
            a[i]=key;
        }
    }
堆排序
链接
(1)堆是一颗完全二叉树;
(2)堆中某个节点的值总是不大于(或不小于)其父节点的值(左右子树谁大谁小并没有规定,左子树可以比右子树大)。
其中,我们把根节点最大的堆叫做大顶堆,根节点最小的堆叫做小顶堆。
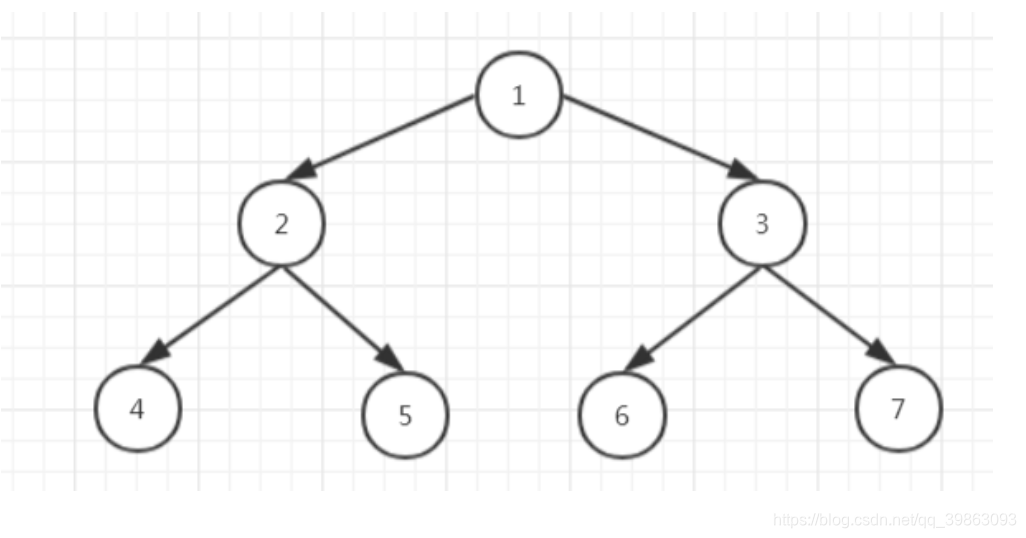
完全二叉树:完全二叉树是指除了最后一层其它层都达到最大节点数,且最后一层节点都靠左排列。完全二叉树的节点都是比较紧凑的,且只有最后一层是不满的,所以使用数组是最节省空间的,比如上面这颗完全二叉树我们可以这样存储。
插入、删除、建堆都是 l o g 2 n log_2{n} log2n,最坏情况可能是O(n)
链接
(写的代码的连接,写的比较清楚了)
构建大顶堆:
//1.构建大顶堆
        for(int i=arr.length/2-1;i>=0;i--){
            //从第一个非叶子结点从下至上,从右至左调整结构
            adjustHeap(arr,i,arr.length);
        }
        public static void adjustHeap(int []arr,int i,int length){
        int temp = arr[i];//先取出当前元素i
        for(int k=i*2+1;k<length;k=k*2+1){//从i结点的左子结点开始,也就是2i+1处开始
            if(k+1<length && arr[k]<arr[k+1]){//如果左子结点小于右子结点,k指向右子结点
                k++;
            }
            if(arr[k] >temp){//如果子节点大于父节点,将子节点值赋给父节点(不用进行交换)
                arr[i] = arr[k];
                i = k;
            }else{
                break;
            }
        }
        arr[i] = temp;//将temp值放到最终的位置
    }
2、从堆顶中取出元素
	swap(arr,0,j);//将堆顶元素与末尾元素进行交换
    adjustHeap(arr,0,j);//重新对堆进行调整
    public static void adjustHeap(int []arr,int i,int length){
        int temp = arr[i];//先取出当前元素i
        for(int k=i*2+1;k<length;k=k*2+1){//从i结点的左子结点开始,也就是2i+1处开始
            if(k+1<length && arr[k]<arr[k+1]){//如果左子结点小于右子结点,k指向右子结点
                k++;
            }
            if(arr[k] >temp){//如果子节点大于父节点,将子节点值赋给父节点(不用进行交换)
                arr[i] = arr[k];
                i = k;
            }else{
                break;
            }
        }
        arr[i] = temp;//将temp值放到最终的位置
    }

    public static void swap(int []arr,int a ,int b){
        int temp=arr[a];
        arr[a] = arr[b];
        arr[b] = temp;
    }
快排排序
核心思想:
1.在待排序的元素任取一个元素作为基准(通常选第一个元素,称为基准元素)
2.将待排序的元素进行分块,比基准元素大的元素移动到基准元素的右侧,比基准元素小的移动到作左侧,从而一趟排序过程,就可以锁定基准元素的最终位置
3.对左右两个分块重复以上步骤直到所有元素都是有序的(递归过程)
   public void quickSort(int[] arr, int l, int r){
        if(l < r){
            int temp = arr[l];
            int i = l;
            int j = r;
            while(l <= r){
                while(arr[i] <= temp && i < j ){
                    i++;
                }
                while(arr[j] > temp && i < j){
                    j--;
                }
                int t = arr[i];
                arr[i] = arr[j];
                arr[j] = t;
            }
            arr[i] = temp;
            quickSort(arr,l,i -1);
            quickSort(arr, i + 1, r);
        }
    }
时间复杂度:
最好:O(
n
l
o
g
2
n
n log_{2} n
nlog2n)
最坏:O (
n
2
n^2
n2 ) (接近有序的时候)
怎样避免最坏情况:
1)主元素的选取随机化:这样就会导致每次分解一直找到的是最小元素和最大元素作为主元素 的概率很小,但还是可能发生
2)求序列的中值,然后选取序列的中值作为主元素。(求中值和找到中值的位置的时间复杂度为O(n))
空间复杂度:O( n l o g 2 n n log_{2} n nlog2n)
稳定性:不稳定
归并排序
速度仅次于快排,内存少的时候使用,可以进行并行计算的时候使用。
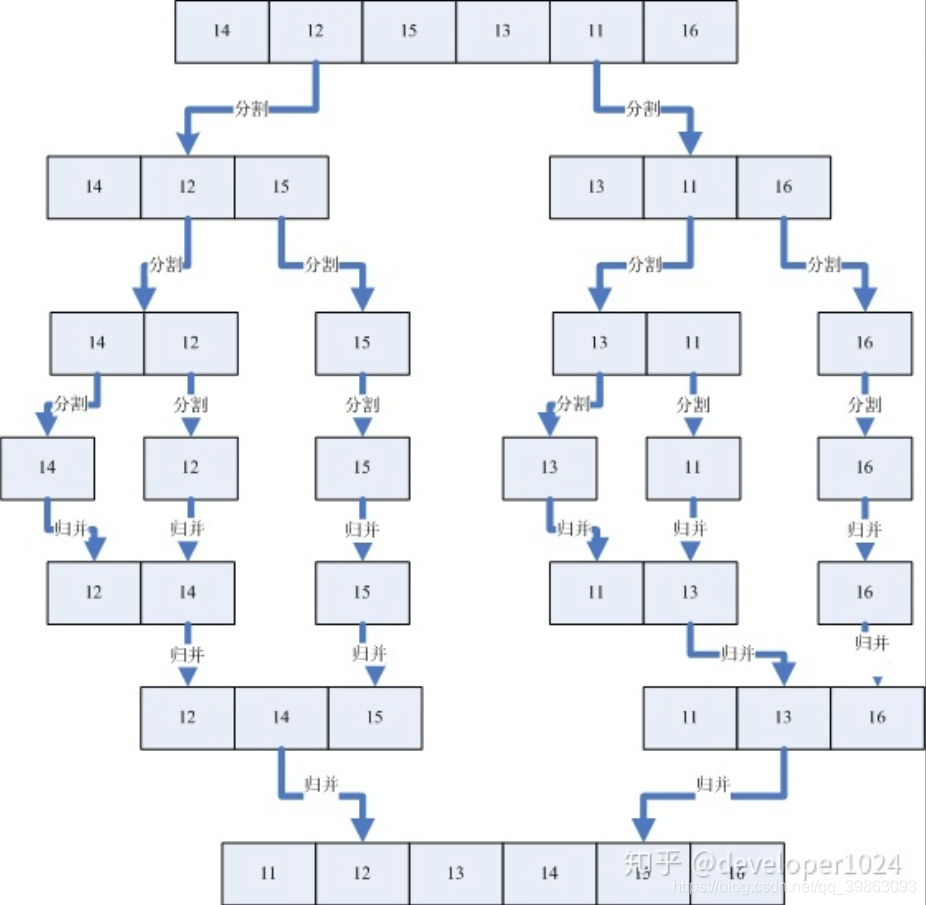
// 归并排序(Java-递归版)
static void merge_sort_recursive(int[] arr, int[] result, int start, int end) {
    if (start >= end)
        return;
    int len = end - start, mid = (len >> 1) + start;
    int start1 = start, end1 = mid;
    int start2 = mid + 1, end2 = end;
    merge_sort_recursive(arr, result, start1, end1);
    merge_sort_recursive(arr, result, start2, end2);
    int k = start;
    while (start1 <= end1 && start2 <= end2)
        result[k++] = arr[start1] < arr[start2] ? arr[start1++] : arr[start2++];
    while (start1 <= end1)
        result[k++] = arr[start1++];
    while (start2 <= end2)
        result[k++] = arr[start2++];
    for (k = start; k <= end; k++)
        arr[k] = result[k];
}

public static void merge_sort(int[] arr) {
    int len = arr.length;
    int[] result = new int[len];
    merge_sort_recursive(arr, result, 0, len - 1);
}
平均时间复杂度:O(nlogn)
最佳时间复杂度:O(n)
最差时间复杂度:O(nlogn)
空间复杂度:O(n)
排序方式:In-place
稳定性:稳定
基数排序
用于大量数,很长的数进行排序时。
- 将所有的数的个位数取出,按照个位数进行排序,构成一个序列。
- 将新构成的所有的数的十位数取出,按照十位数进行排序,构成一个序列
图论
图的存储方式,广度搜索和深度搜索
邻接矩阵:本质就是2*2的数组
邻接表:数组+列表,和哈希表的存储方式差不多
深度搜索(dfs):可以使用递归或者栈来实现
广度搜索(bfs):使用列表实现
最短距离
Dijkstra最短路径算法(求一个点到其他点的最短距离)
链接
Floyd算法(求各个点的最短距离)
链接
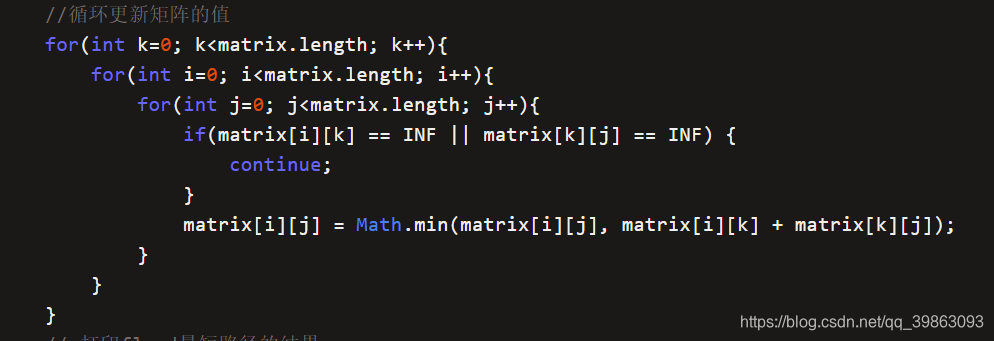
本质就是动态规划,公式:顶点i 到 顶点j 的新距离 = Min(顶点i 到 顶点j 的旧距离,顶点i 到 顶点n 的距离+顶点n 到 顶点j 的距离)
最小生成树
一个有 n 个结点的连通图的生成树是原图的极小连通子图,且包含原图中的所有 n 个结点,并且有保持图连通的最少的边
如使用联通城市修最少的铁路,就是用的最小生成树:
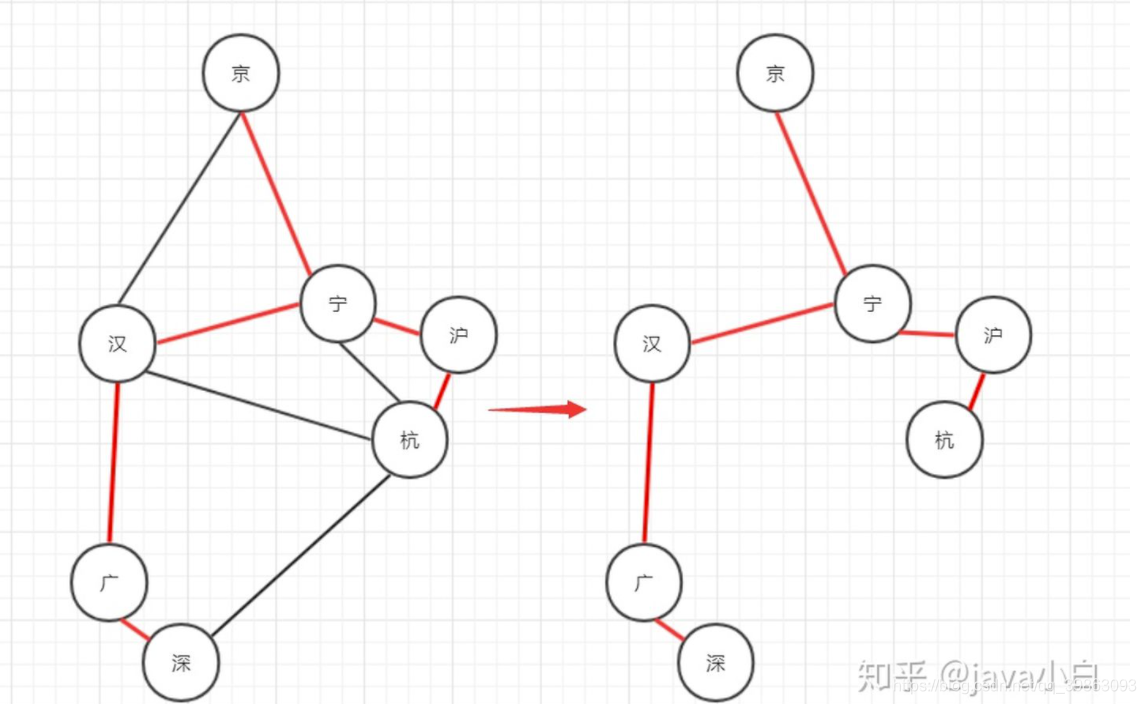
(karsual本质也是用的贪心算法,只是方式不一样)
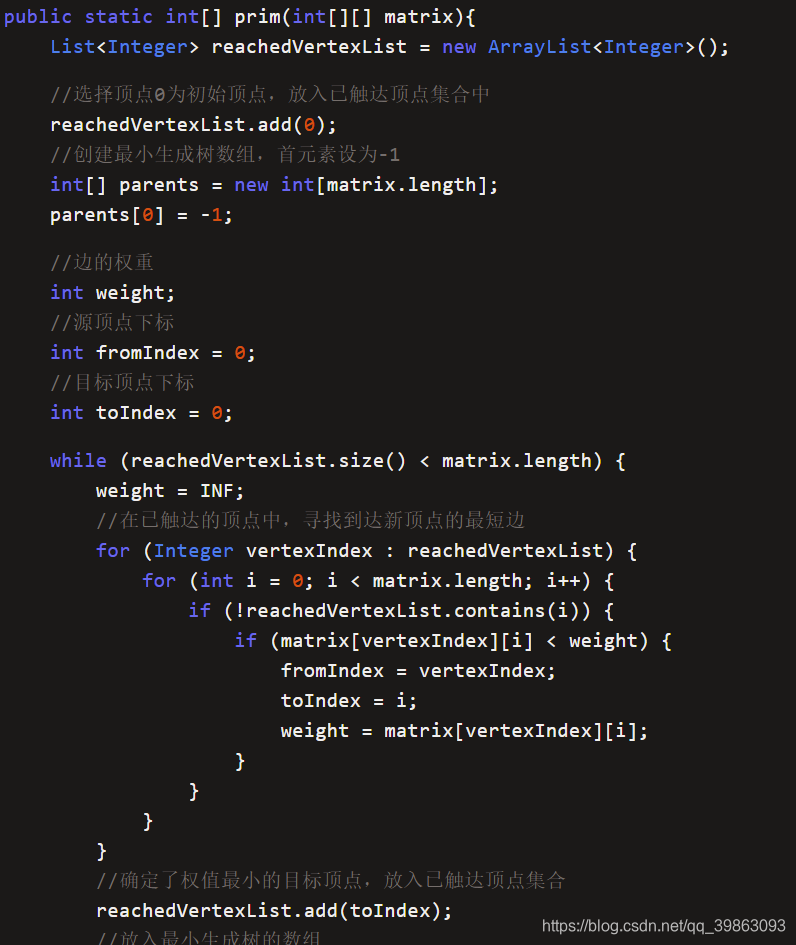
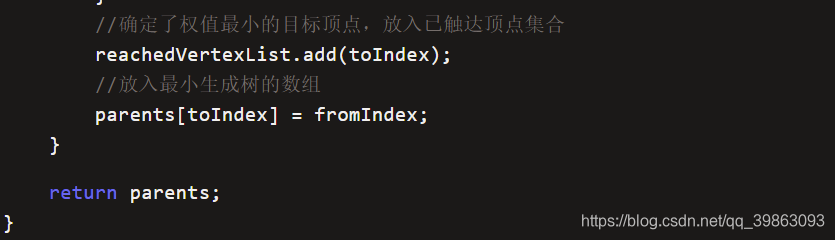
prim算法(贪心算法):
- 寻找图中任意点,以它为起点,它的所有边V加入集合(优先队列)q1,设置一个boolean数组bool[]标记该位置已经确定。
- 从集合q1找到距离最小的那个边v1并判断边另一点p是否被标记(访问),如果p被标记说明已经确定那么跳过,如果未被标(访问)记那么标记该点p,并且与p相连的未知点(未被标记)构成的边加入集合q1,边v1(可以进行计算距离之类,该边构成最小生成树) .
- 重复1,2直到q1为空,构成最小生成树 !
并查集
链接
主要用于解决一些元素分组的问题。它管理一系列不相交的集合, 并支持两种操作:
合并(Union):把两个不相交的集合合并为一个集合。
查询(Find):查询两个元素是否在同一个集合中。
性能跟树的深度有关系,并查集的时间复杂度为 O(logn)
拓扑排序
链接
拓扑排序是对DAG(有向无环图)判断,判断图是否有环
// deg是入度,在存图的时候需要录入数据
// A是排序后的数组
int deg[MAXN], A[MAXN];
bool toposort(int n)
{
    int cnt = 0;
    queue<int> q;
    for (int i = 1; i <= n; ++i)
        if (deg[i] == 0)
            q.push(i);
    while (!q.empty())
    {
        int t = q.front();
        q.pop();
        A[cnt++] = t;
        for (auto to : edges[t])
        {
            deg[to]--;
            if (deg[to] == 0) // 出现了新的入度为0的点
                q.push(to);
        }
    }
    return cnt == n;
}
时间复杂度O(logn)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 2
 0
- 0


 已为社区贡献2条内容

所有评论(0)