八股文——多线程
八股文——多线程
- 线程的几种状态?具体是怎么运行的?
- 进程和线程二者的区别
- 进程切换说一下 进程切换具体哪些资源?线程的上下文切换呢?
- java中实现多线程的方式?
- 进程间通信方式?
- 同步和异步的概念?
- 乐观锁和悲观锁?
- 什么是CAS算法?CAS会出现什么问题?讲讲violate关键字?
- synchronized修饰static方法和修饰代码块有什么区别?
- Synchronized同步锁的的优化方法?
- 多线程的三大特征?
- jmm的结构?
- 什么是AQS?AQS如何实现可重入锁?ReentrantLock原理?countdownlatch原理?
- Synchronized 和 ReentrantLock的区别
- ThreadLocal作用和实现方式 ?会不会导致内存泄露?为什么用弱引用?InheritableThreadLocal作用和实现方式 ?
- 线程池的简单使用?
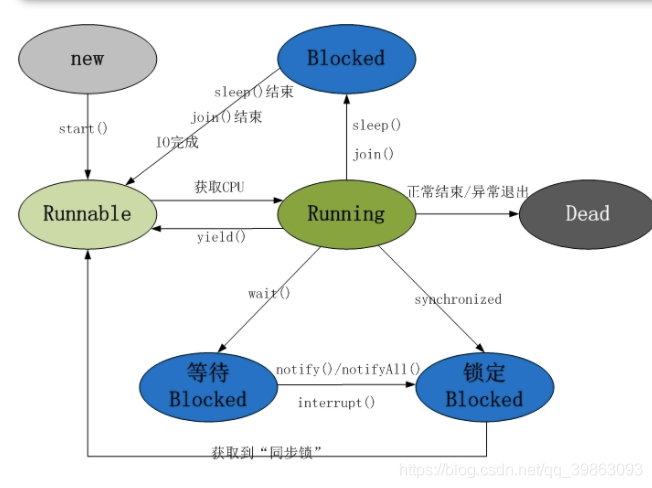
线程的几种状态?具体是怎么运行的?
-
通过new关键字创建后,进入到新生状态
-
调用start后进入就绪状态
-
CPU调度到本线程后,本线程开始执行。进入到运行状态
-
运行中遇到join,yield,sleep造成阻塞,进入阻塞状态。阻塞完成后,又回到就绪状态
-
线程正常执行完,或者遇到异常终止后,进入死亡状态
-
interrupt()方法不能直接中断线程,它只会改变当前线程局部变量中的violate变量blocker。若需要打断线程,可以使用IsInterrupt()判断blocker标志。
   @Override
    public void run() {
        while(true){
            if(Thread.currentThread().isInterrupted()){
                System.out.println("Yes,I am interruted,but I am still running");
                return;

            }else{
                System.out.println("not yet interrupted");
            }
        }
    }
线程状态常见问题:
1、造成线程阻塞的方法?
阻塞线程的方法:join、yield、sleep、synchronized 和Object的wait()方法
2、哪些状态之后是回到就绪状态?
a)通过join、yield、sleep造成线程阻塞,阻塞状态后是回到了就绪状态。
b)遇到synchronized后也是进入阻塞状态,获得锁后先进入就绪状态。
c)遇到Object的等待wait方法后,进入阻塞状态,阻塞时间结束或者被notify后进入就绪状态。
3、sleep会释放锁吗?
sleep不会释放锁【它会抱着锁睡觉】
4、sleep()和wait的区别?
sleep 是Thread中的方法,线程暂停,让出CPU,但是不释放锁🔐
wait()是Object中的方法, 调用次方法必须让当前线程必须拥有此对象的monitor(即锁),执行之后 线程阻塞,让出CPU, 同时也释放锁🔐; 等待期间不配拥有CPU执行权, 必须调用notify/notifyAll方法唤醒,(notify是随机唤醒) 唤醒并不意味着里面就会执行,而是还是需要等待分配到CPU才会执行;
进程和线程二者的区别
进程是资源分配的最小单位,线程是CPU调度的最小单位。
一个进程可以创建多个线程,协调完成进程的功能,线程能共享所在进程的虚拟地址空间。
进程切换说一下 进程切换具体哪些资源?线程的上下文切换呢?
进程切换:
进程需要切换虚拟内存、页表、堆栈、硬件上下文等资源,比较消耗性能。
1、切换页表全局目录
2、切换内核态堆栈
3、切换硬件上下文(进程恢复前,必须装入寄存器的数据统称为硬件上下文)
ip(instruction pointer):指向当前执行指令的下一条指令
bp(base pointer): 用于存放执行中的函数对应的栈帧的栈底地址
sp(stack poinger): 用于存放执行中的函数对应的栈帧的栈顶地址
cr3:页目录基址寄存器,保存页目录表的物理地址
…
4、刷新TLB
5、系统调度器的代码执行
个人理解:线程切换除了不要切换虚拟地址空间,其他和进程切换都一样,至于既然线程是有私有空间的,为什么还会出现多线程数据问题,可以看链接
进程切换与线程切换的区别:
进程切换涉及到虚拟地址空间的切换而线程切换则不会。
因为每个进程都有自己的虚拟地址空间,而线程是共享所在进程的虚拟地址空间的,因此同一个进程中的线程进行线程切换时不涉及虚拟地址空间的转换。
线程的上下文切换:
一个 CPU 在一个时刻只能运行一个线程,当其运行一个线程时,由于时间片耗尽或出现阻塞等情况,CPU 会转去执行另外一个线程,这个叫做线程上下文切换,需要用户态转到内核态。
java中实现多线程的方式?
链接
Java多线程实现方式主要有四种:
1、继承Thread类
2、实现Runnable接口
3、实现Callable接口通过FutureTask包装器来创建Thread线程
4、使用线程池ThreadPoolExecutor接口ExecutorService结合Callable、Future实现有返回结果的多线程。
进程间通信方式?
写得很好的链接
管道 单向传输字节流,无缓冲区
消息队列 维护消息队列列表,以消息形式发送
共享内存 解决数据太多发送慢的问题
信号量 解决共享内存读写冲突问题
信号 通知接受通信的一个函数
套接字 基于tcp,可以不同主机进行通信
同步和异步的概念?
同步:顺序执行
异步:多线程并行执行
乐观锁和悲观锁?
链接
乐观锁: 假设每次都是最好的情况,即数据不会被修改,不上锁,但是在更新的时候会判断数据是否更新。相关方法版本号机制(数据库mvcc)和cas算法。
悲观锁: 乐观锁每次假设最好的情况,悲观锁每次假设最坏的情况,每次拿数据都会上锁。数据库中的行锁、写锁、读锁、写锁都是悲观锁。java中的synchronized和ReetrantLock等。
什么是CAS算法?CAS会出现什么问题?讲讲violate关键字?
CAS就是一种非阻塞算法实现,也是一种乐观锁技术,它能在不使用锁的情况下实现多线程安全。CAS具体包括三个参数:当前内存值V、旧的预期值A、即将更新的值B,当且仅当预期值A和内存值V相同时,将内存值修改为B并返回true,整个比较并交换的操作是原子操作。
源码:使用naive函数保证原子操作
public final int getAndIncrement() {
    return unsafe.getAndAddInt(this, valueOffset, 1);
}

public final int getAndAddInt(Object o, long offset, int delta) {
    int v;
    do {
        v = this.getIntVolatile(o, offset);
    } while(!this.compareAndSwapInt(o, offset, v, v + delta));
    return v;
}

public final native boolean compareAndSwapInt(Object o, long offset, int delta, int v);
CAS的缺点:
1、循环时间长、开销很大。如果CAS失败,会一直进行尝试。如果CAS长时间尝试但是一直不成功,可能会给CPU带来很大的开销。
2、只能保证一个共享变量的原子操作。是从 JDK 1.5开始,提供了AtomicReference类来保证引用对象之间的原子性,你可以把多个变量放在一个对象里来进行 CAS 操作.所以我们可以使用锁或者利用AtomicReference类把多个共享变量合并成一个共享变量来操作。
3、ABA问题。解决方法:JDK 1.5 以后的 AtomicStampedReference类对应的数值被修改时,除了更新数据本身外,还必须要更新时间戳。因此,即使对象值被反复读写,写回原值,只要时间戳发生变化,就能防止不恰当的写入。
synchronized和轻量级锁比较:
Java并发编程这个领域中synchronized关键字一直都是元老级的角色,很久之前很多人都会称它为 “重量级锁” 。但是,在JavaSE 1.6之后进行了主要包括为了减少获得锁和释放锁带来的性能消耗而引入的 偏向锁 和 轻量级锁 以及其它各种优化之后变得在某些情况下并不是那么重了。synchronized的底层实现主要依靠 Lock-Free 的队列,基本思路是 自旋后阻塞,竞争切换后继续竞争锁,稍微牺牲了公平性,但获得了高吞吐量。在线程冲突较少的情况下,可以获得和CAS类似的性能;而线程冲突严重的情况下,性能远高于CAS。
讲讲violate关键字
violate关键字能保证可见性和有序性,但是不能证原子性。
synchronized修饰static方法和修饰代码块有什么区别?
synchronized的用法有两种:
1、对某一块代码进行加锁
2、对方法进行加锁。
对修饰static方法 和对直接对Class类上锁的效果是一样的,都是对该类进行上锁,该类的所有对象都是同一把锁。
//锁住对象
synchronized(Main.class){
}
//锁住方法
public static synchronize void service(){
}
修饰代码块,只是对对象加锁,只能锁住new的对象,即每一个对象有一把锁。
//锁住对象
synchronized(this){
}
//锁住方法
public synchronize void service(){
}
Synchronized同步锁的的优化方法?
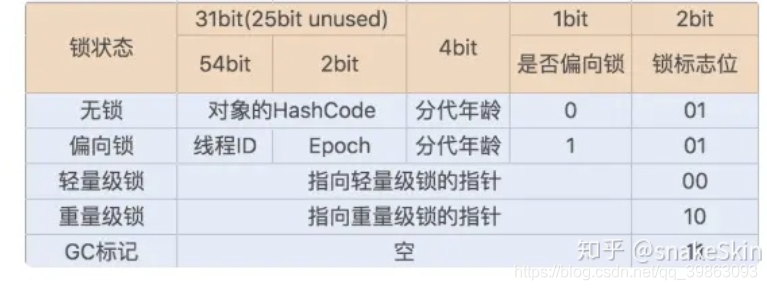
偏向锁->轻量级锁->重量级锁
偏向锁: 对象中记录了获取到对象锁的线程ID,并没有上锁。此时没有其他线程与其竞争。当有其他线程访问同步代码或方法时,线程只需要判断对象头的Mark Word中判断一下是否有偏向锁指向线程ID。一旦出现其他线程竞争资源时,偏向锁就会被撤销
轻量级锁: 当有另外一个线程竞争获取这个锁时,由于该锁已经是偏向锁,当发现对象头 Mark Word 中的线程 ID 不是自己的线程 ID,就会进行 CAS 操作获取锁,如果获取成功,直接替换 Mark Word 中的线程 ID 为自己的 ID,该锁会保持偏向锁状态;如果获取锁失败,代表当前锁有一定的竞争,偏向锁将升级为轻量级锁。
当有其他线程想访问加了轻量级锁的资源时,会使用自旋锁优化,来进行资源访问。
重量级锁: 旋转十次左右升级为重量级锁。重量级锁是指当有一个线程获取锁之后,其余所有等待获取该锁的线程都会处于阻塞状态。
总结
synchronized锁升级实际上是把本来的悲观锁变成了 在一定条件下 使用无锁(同样线程获取相同资源的偏向锁),以及使用乐观(自旋锁 cas)和一定条件下悲观(重量级锁)的形式。synchronized升级为重量级锁后无法在正常情况下完成降级,只有在gc的时候才能降级
偏向锁:适用于单线程适用锁的情况
轻量级锁:适用于竞争较不激烈的情况(这和乐观锁的使用范围类似)
重量级锁:适用于竞争激烈的情况
多线程的三大特征?
1 . 原子性(Atomicity):Java中,对基本数据类型的读取和赋值操作是原子性操作,所谓原子性操作就是指这些操作是不可中断的,要做一定做完,要么就没有执行。
只有简单的读取,赋值是原子操作,还只能是用数字赋值,用变量的话还多了一步读取变量值的操作。
2.可见性(Visibility): 可见性问题是指一个线程修改了某一个共享变量的值时,其他线程是否能够立即知道这个修改。Java利用volatile来提供可见性。 当一个变量被volatile修饰时,那么对它的修改会立刻刷新到主存,当其它线程需要读取该变量时,会去内存中读取新值。而普通变量则不能保证这一点。
3.有序性(Ordering): JMM是允许编译器和处理器对指令重排序的。JMM保证了重排序不会影响到单线程的执行,但是在多线程中却容易出问题。
jmm的结构?
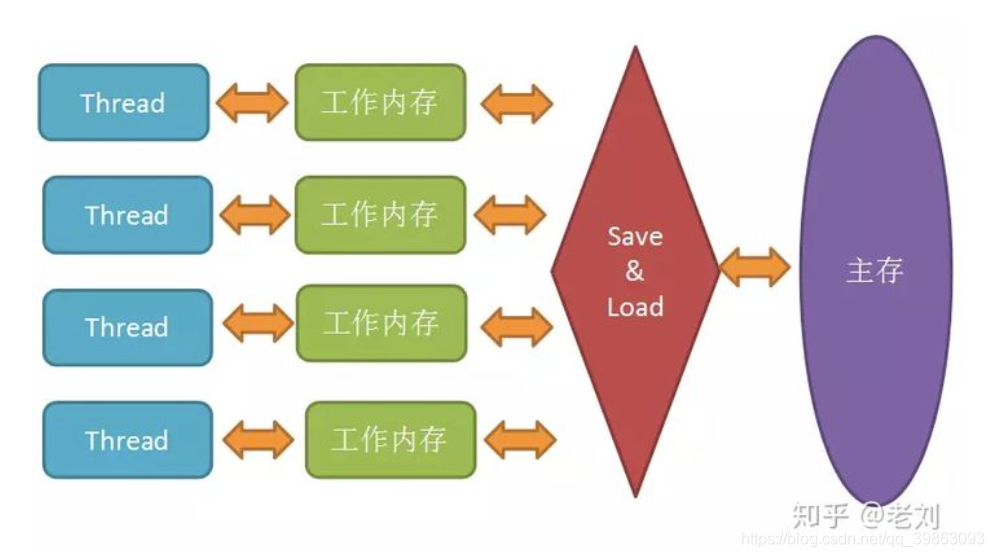
Java虚拟机规范试图定义一种Java内存模型(JMM),来屏蔽掉各种硬件和操作系统的内存访问差异,让Java程序在各种平台上都能达到一致的内存访问效果。简单来说,由于CPU执行指令的速度是很快的,但是内存访问的速度就慢了很多,相差的不是一个数量级,所以搞处理器的那群大佬们又在CPU里加了好几层高速缓存。
在Java内存模型里,对上述的优化又进行了一波抽象。JMM规定所有变量都是存在主存中的,类似于上面提到的普通内存,每个线程又包含自己的工作内存,方便理解就可以看成CPU上的寄存器或者高速缓存。所以线程的操作都是以工作内存为主,它们只能访问自己的工作内存,且工作前后都要把值在同步回主内存。
什么是AQS?AQS如何实现可重入锁?ReentrantLock原理?countdownlatch原理?
AQS全称是AbstractQueuedSynchronizer,抽象队列同步器。AQS就是一个并发包的基础组件,用来实现各种锁,各种同步组件的。它包含了state变量、加锁线程、FIFO(先进先出)队列等并发中的核心组件。它有独占模式和共享模式。
ReentrankLock 独占模式过程:
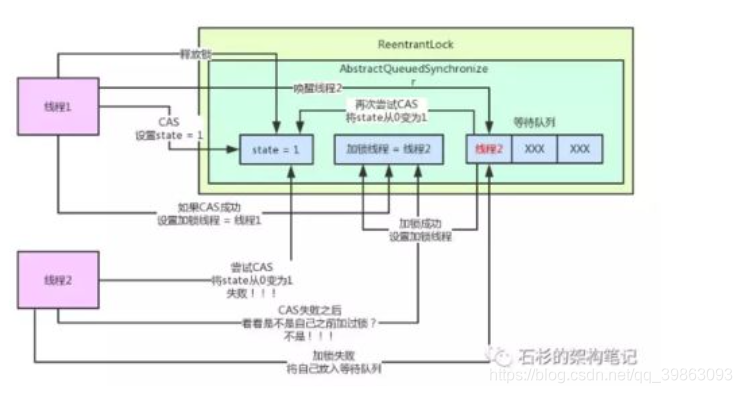
这个AQS对象内部有一个核心的变量叫做state,是int类型的,代表了加锁的状态。
初始状态下,这个state的值是0。
另外,这个AQS内部还有一个关键变量,用来记录当前加锁的是哪个线程,初始化状态下,这个变量是null。
接着线程跑过来调用ReentrantLock的lock()方法尝试进行加锁,这个加锁的过程,直接就是用CAS操作将state值从0变为1。
你会发现,ReentrantLock这种东西只是一个外层的API,内核中的锁机制实现都是依赖AQS组件的。这个ReentrantLock之所以用Reentrant打头,意思就是他是一个可重入锁。
可重入锁的意思,就是你可以对一个ReentrantLock对象多次执行lock()加锁和unlock()释放锁,也就是可以对一个锁加多次,叫做可重入加锁。
其实每次线程1可重入加锁一次,会判断一下当前加锁线程就是自己,那么他自己就可以可重入多次加锁,每次加锁就是把state的值给累加1,别的没啥变化。
线程2跑过来一下看到,哎呀!state的值不是0啊?所以CAS操作将state从0变为1的过程会失败,因为state的值当前为1,说明已经有人加锁了!
接着,线程2会将自己放入AQS中的一个等待队列,因为自己尝试加锁失败了,此时就要将自己放入队列中来等待,等待线程1释放锁之后,自己就可以重新尝试加锁了
接着,线程1在执行完自己的业务逻辑代码之后,就会释放锁!他释放锁的过程非常的简单,就是将AQS内的state变量的值递减1,如果state值为0,则彻底释放锁,会将“加锁线程”变量也设置为null!
还有ReentrantLock是如何实现公平锁的(其实是在竞争资源时如果有新进入的线程,先判断队列中是否有节点,如果有直接插入队尾等待,按顺序获取资源)。
CountDownLatch的获取共享资源的过程:
CountDownLatch会将任务分成N个子线程去执行,state的初始值也是N(state与子线程数量一致)。N个子线程是并行执行的,每个子线程执行完成后countDown()一次,state会通过CAS方式减1。直到所有子线程执行完成后(state=0),会通过unpark()方法唤醒主线程,然后主线程就会从await()方法返回,继续后续操作。
CountDownLatch是一个同步容器,但是有人叫它发令枪,也有人叫它门闩。初始化设定线程的个数,调用countDownLatch.await()阻塞所有线程,直到countDownLatch.countDown()为0,那么将继续执行剩余的操作。例如,跑步比赛,所有线程都await()在起跑线,当所有人告诉裁判准备好了,裁判发令枪一响,运动员开炮。门闩道理一样,门不开全给我等着!
Synchronized 和 ReentrantLock的区别
ThreadLocal作用和实现方式 ?会不会导致内存泄露?为什么用弱引用?InheritableThreadLocal作用和实现方式 ?
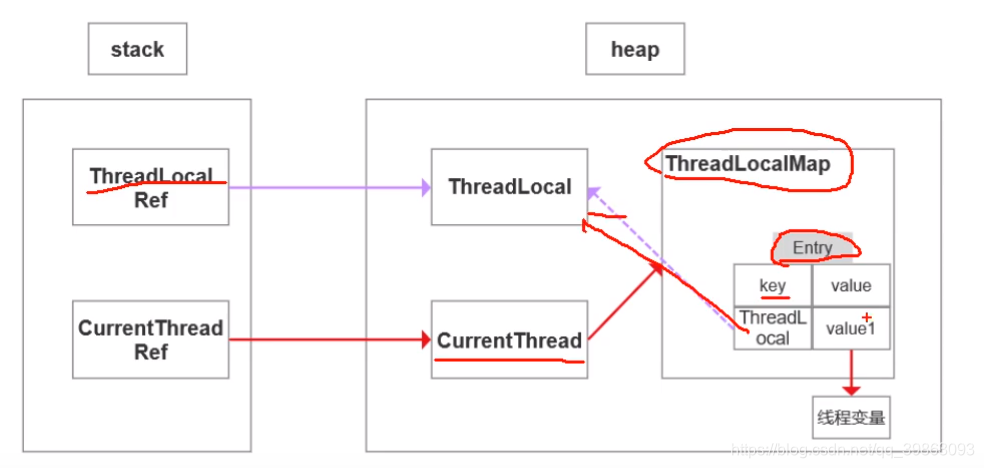
每一个Thread对象均有一个ThreadLocalMap类型的成员变量threadlocals,它存储本线程中所有的threadlocal对象以及对应的值。
他实际是在存储全局变量,只不过这个全局变量比较特殊,每一个实例都跟一个线程绑定了
threadlocal只会在一个线程内使用,因此没有多线程问题。
threadlocal的key是弱引用,弱引用内存满的时候会直接被jvm回收(强引用会报oom),及会存在内存泄露的问题。
使用场景:
1、在进行对象跨层传递的时候,使用threadlocals避免多层传递。
2、线程间数据隔离。
3、进行事务操作,用于存储线程的事务信息。
内存泄漏的原因
内存泄露:申请的内存不再使用了,但是jvm无法回收,这就是内存泄漏。
jvm回收强引用和弱引用的差别: 强引用(new创建的)对象jvm不会强行gc,只有收到设置为null。弱引用(继承weakreference)对象gc会强行gc。
threadlocal会导致内存泄露。因为threadlocal的key是弱引用,gc能强制回收,但是value却不能强制回收,会导致内存泄露。
解决方法:
threadlocalMap的key为弱引用回收threadlocal时,由于threadlocalMap持有ThreadLocal的弱引用,即使没有手动删除,threadlocal也会回收,当key为null时,再下一次threadLocalMap调用set(),get(),remove()方法时的时候会被清除value值。
因此,每次使用完threadlocal的时候,都调用它的remove()方法清除数据。
为什么要使用弱引用?
弱引用尝尝运用在缓存机制中,缓存机制数据删除掉比起内存不足导致oom,对程序影响更小。
threadlocal的key也使用弱引用,也是遵循这个思想。
线程池的简单使用?
为什么使用线程池?
线程的创造的销毁比较消耗资源,省掉创建和销毁的耗时操作。提高响应速度。
线程池的参数?
- corePoolSize:核心线程数。常驻线程数,这些线程创建后并不会消除。
- maxinumPoolSize:最大线程数。表示最大允许创建的线程,若核心线程用完了,还无法满足需求,这时需要创建线程。
- keepAliveTime、unit:表示超出核心线程数之外的线程的空闲存活时间,超出空闲时间,非核心线程会被清除。
wokeQuene:用来存放待执行的任务。 - ThreadFactory:线程工厂。创建线程的工厂,可以使用自定义的线程工厂创建线程,一般根据不同的业务来创建线程。
- Handler:拒绝策略,当线程池关闭或者线程池达到最大线程数时候使用。
CallerRunsPolicy:提交任务的线程自己去执行该任务。
AbortPolicy:默认的拒绝策略,直接丢弃任务,抛出RejectedExecutionException。
DiscardPolicy:直接丢弃任务,没有任何异常抛出。
DiscardOldestPolicy:丢弃最老的任务,其实就是把最早进入工作队列的任务丢弃,然后把新任务加入到工作队列。
线程池的运行过程
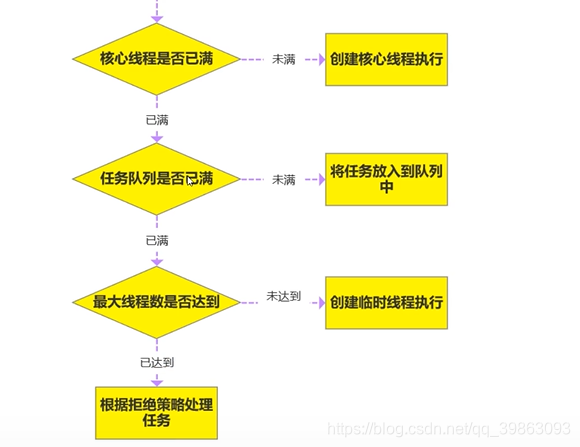
线程中阻塞队列的作用?
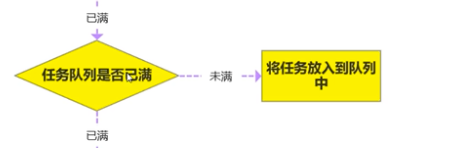
作用就是如上图所示,维护一个阻塞队列,该阻塞队列会将任务take(挂起),维护线程的存活也不一直占用cpu资源,并且自带阻塞和唤醒的功能,不需要额外处理。
为什么是先添加队列而不是先创建最大线程?
线程池考虑创建线程也需要消耗cpu资源,若任务量不大,则不需要着急创建线程,过多创建和销毁线程反而更消耗cpu资源。
线程池的复用原理
线程池中同一个线程可以获取阻塞队列中的的任务不断执行,原因是线程池中的线程调用的是的run()方法,直接调用run()方法,其实就是一个普通的方法,和start()方法有区别,可以多次调用。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)