使用grafana+prometheus监控flink任务
·
1,软件安装:
grafana+prometheus 安装教程请参考文章: 安装教程
2,flink配置
方案一: 修改文件conf/flink-conf.yaml
metrics.reporter.promgateway.class: org.apache.flink.metrics.prometheus.PrometheusPushGatewayReporter
#这里填写安装的prometheusGateway的ip
metrics.reporter.promgateway.host: xx.xx.xx.xx
metrics.reporter.promgateway.port: 9091
#此处填写jobName
metrics.reporter.promgateway.jobName: xxxx
metrics.reporter.promgateway.randomJobNameSuffix: true
metrics.reporter.promgateway.deleteOnShutdown: false
# 为自己的job添加可被区分或者查询的key, aBcDf 在下面会用到
metrics.reporter.promgateway.groupingKey: jobUqId=aBcDf
方案二, flink on yarn直接在命令行上添加, 会更方便:
-yD metrics.reporter.promgateway.class=org.apache.flink.metrics.prometheus.PrometheusPushGatewayReporter \
-yD metrics.reporter.promgateway.host=xxx.xxx.xxx.xxx -yD metrics.reporter.promgateway.port=9091 \
-yD metrics.reporter.promgateway.jobName=flink-iot-anlz-log \
-yD metrics.reporter.promgateway.randomJobNameSuffix=true \
-yD metrics.reporter.promgateway.deleteOnShutdown=false \
-yD metrics.reporter.promgateway.groupingKey=jobUqId=aBcDf
然后将任务启动.
2,监控查看

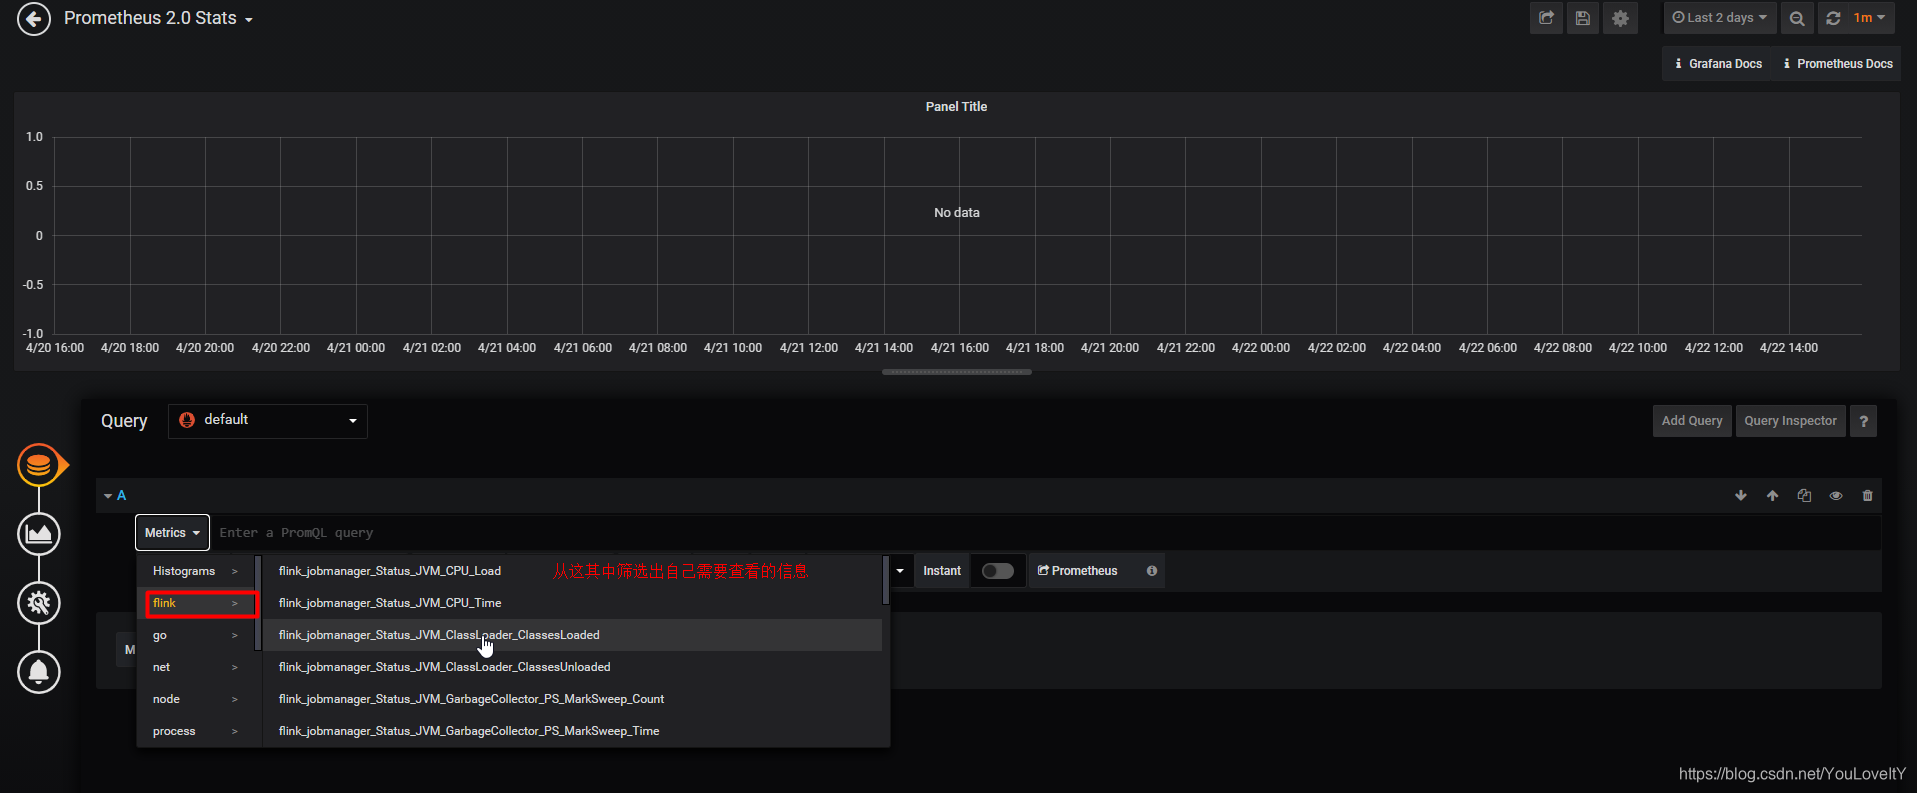
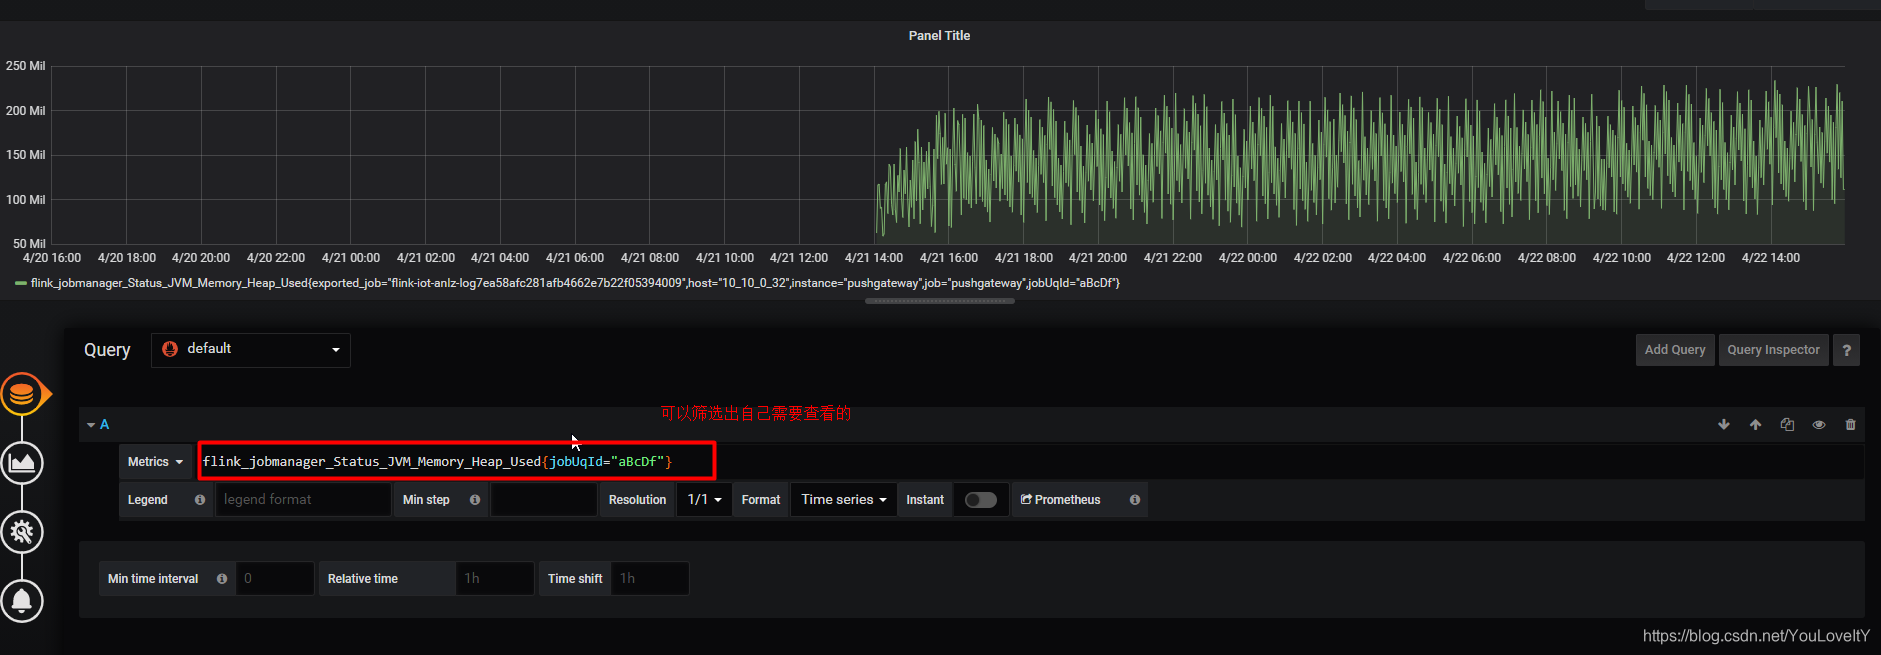
jobManager的指标
flink_jobmanager_Status_JVM_Memory_Heap_Used{jobUqId="aBcDf"}    当前使用的堆内存数量(byte单位)
flink_jobmanager_Status_JVM_Memory_Heap_Committed{jobUqId="aBcDf"}  保证向JVM可用的堆内存量(byte单位)
flink_jobmanager_numRegisteredTaskManagers{jobUqId="aBcDf"}   注册的tm的个数
flink_jobmanager_numRunningJobs{jobUqId="aBcDf"}  正在运行的job的个数
flink_jobmanager_taskSlotsAvailable{jobUqId="aBcDf"}  可用的slots的个数
flink_jobmanager_taskSlotsTotal{jobUqId="aBcDf"}   总共的slots的个数
任务状态
flink_jobmanager_job_downtime{jobUqId="aBcDf"}  表示任务单次非运行状态的时长(毫秒) 0表示正在运行,-1表示已完成
flink_jobmanager_job_numRestarts{jobUqId="aBcDf"}  表示任务重启次数
checkpoint的指标
flink_jobmanager_job_numberOfCompletedCheckpoints{jobUqId="aBcDf"}  表示任务的checkpoint完成次数
flink_jobmanager_job_numberOfFailedCheckpoints{jobUqId="aBcDf"}   表示checkpoint失败的次数
flink_jobmanager_job_numberOfInProgressCheckpoints{jobUqId="aBcDf"}  正在进行的checkpoint的个数
flink_jobmanager_job_totalNumberOfCheckpoints{jobUqId="aBcDf"}  表示任务的checkpoint总次数
flink_jobmanager_job_lastCheckpointDuration{jobUqId="aBcDf"}  最新的一次的checkpoint完成所需要的时间
flink_jobmanager_job_lastCheckpointSize{jobUqId="aBcDf"}  最新一次checkpoint的大小
taskmanager的cpu指标
flink_taskmanager_Status_JVM_CPU_Time{jobUqId="aBcDf"}
flink_taskmanager_Status_JVM_CPU_Load{jobUqId="aBcDf"}
#可以通过使用-yD yarn.containers.vcores=2参数来调整, 在通过slot和taskmanagerNumSlot来确定taskmanager的数量, 从而确定了container的数量, 再通过vcores来确定每一个container中的core的个数, 从而整体降低了yarn的core的数量
flink_taskmanager_Status_JVM_Memory_Direct_Count{jobUqId="aBcDf"}   tm使用直接内存的对象数量
flink_taskmanager_Status_JVM_Memory_Direct_MemoryUsed{jobUqId="aBcDf"}  tm使用直接内存大小
flink_taskmanager_Status_JVM_Memory_Direct_TotalCapacity{jobUqId="aBcDf"} tm使用直接内存总容量大小
flink_taskmanager_Status_JVM_Memory_Heap_Committed{jobUqId="aBcDf"} tm的jvm可用的堆内存量
flink_taskmanager_Status_JVM_Memory_Heap_Max{jobUqId="aBcDf"}    tm可用于内存管理的最大堆内存量(以字节为单位)。
flink_taskmanager_Status_JVM_Memory_Heap_Used{jobUqId="aBcDf"}   当前使用的堆内存数量(以字节为单位)。
flink_taskmanager_Status_JVM_Memory_NonHeap_Committed{jobUqId="aBcDf"}   对JVM可用的非堆内存量(以字节为单位)
flink_taskmanager_Status_JVM_Memory_NonHeap_Max{jobUqId="aBcDf"}  可用于内存管理的最大非堆内存数量(以字节为单位)。
flink_taskmanager_Status_JVM_Memory_NonHeap_Used{jobUqId="aBcDf"}   当前使用的非堆内存数量(以字节为单位)。
flink_taskmanager_Status_JVM_Threads_Count{jobUqId="aBcDf"}   存活的线程数
反压分析
大概分析反压
是否反压
flink_taskmanager_job_task_isBackPressured{jobUqId="aBcDf"}

发送端很高,说明是下游反压
flink_taskmanager_job_task_buffers_outPoolUsage{jobUqId="aBcDf",task_id="0dfd460ec7c42df129e084b4306beaa2"}

接收端很高, 说明接收端正在将反压传递给上游节点
flink_taskmanager_job_task_buffers_inPoolUsage{jobUqId="aBcDf",task_id="0dfd460ec7c42df129e084b4306beaa2"}

flink_taskmanager_job_task_buffers_inputFloatingBuffersUsage{jobUqId="aBcDf",task_id="0dfd460ec7c42df129e084b4306beaa2"}
flink_taskmanager_job_task_buffers_inputExclusiveBuffersUsage{jobUqId="aBcDf",task_id="0dfd460ec7c42df129e084b4306beaa2"}
以上各项指标均来自flink的metric. 查看官方文档

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 3
 0
- 0


 已为社区贡献4条内容

所有评论(0)