Java设计原则和设计模式
一、SOLID设计原则
SOLID 原则是什么呢?它实际上是五个设计原则首字母的缩写,它们分别是:
- 单一职责原则(Single responsibility principle,SRP)
- 开放封闭原则(Open–closed principle,OCP)
- Liskov 替换原则(Liskov substitution principle,LSP)
- 接口隔离原则(Interface segregation principle,ISP)
- 依赖倒置原则(Dependency inversion principle,DIP)
1.单一职责
一个类只负责一个职责
我们来看一个例子。假设我们要开发一个项目管理的工具,自然少不了一个用户的类,我们可能设计出这样一个用户类:

看上去,这个类设计得还挺合理,有用户信息管理、有项目管理等等。没过多久,新的需求来了,要求每个用户能够设置电话号码,所以,你给它增加了一个新的方法:
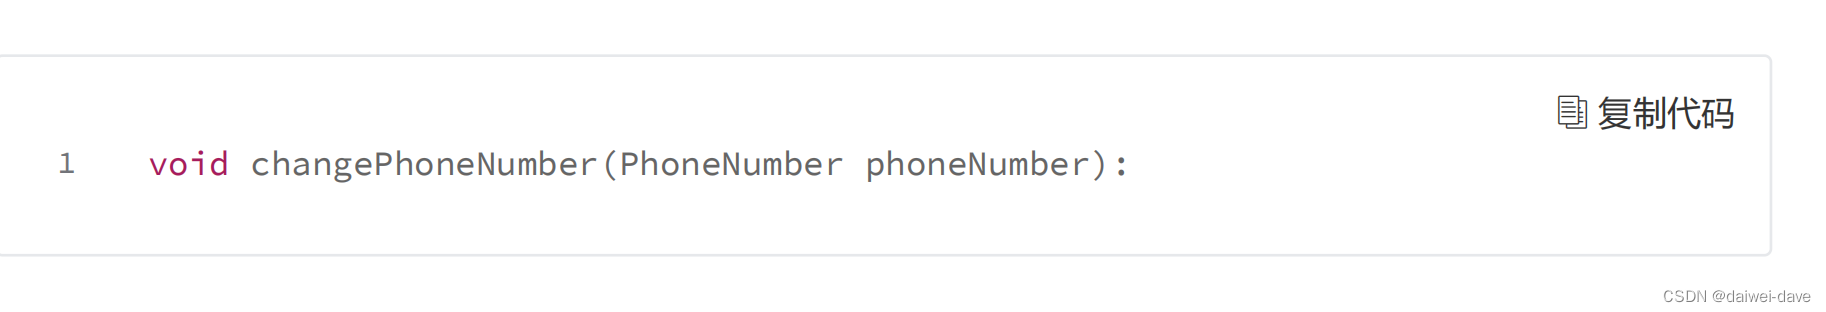
过了几天,又来了新需求,要查看一个用户加入了多少项目:
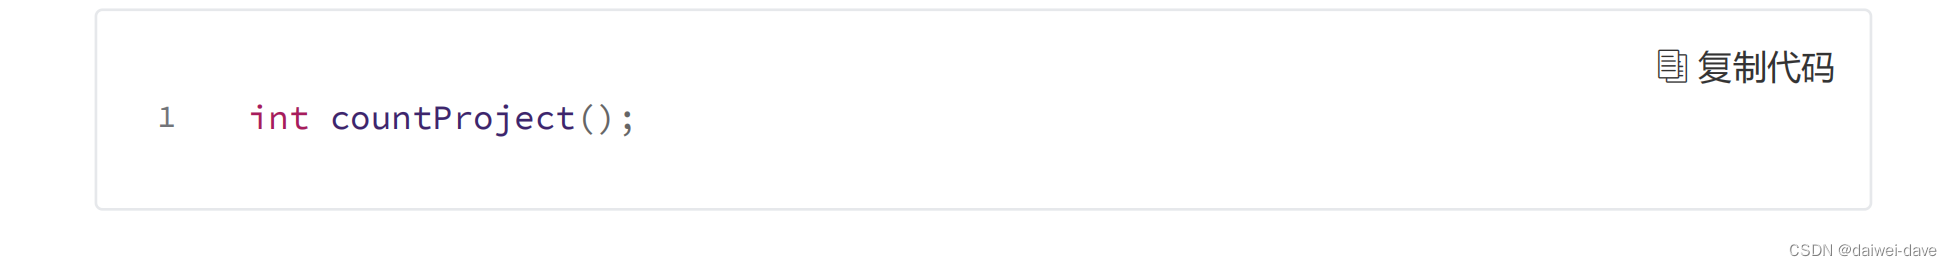
就这样,左一个需求,右一个需求,几乎每个需求都要改到这个类。那会导致什么结果呢?一方面,这个类会不断膨胀;另一方面,内部的实现会越来越复杂。按照我们提出的衡量标准,这个类变动的频繁程度显然是不理想的,主要原因就在于它引起变动的需求太多了:
这就是两种完全不同的需求,但它们都改到了同一个类,所以,这个 User 类就很难稳定下来。解决这种问题,最好的办法就是把不同的需求引起的变动拆分开来。针对这里的用户管理和项目管理两种不同需求,我们完全可以把这个 User 类拆成两个类。比如,像下面这样,把用户管理类的需求放到 User 类里,把项目管理类的需求放到 Member 类里:
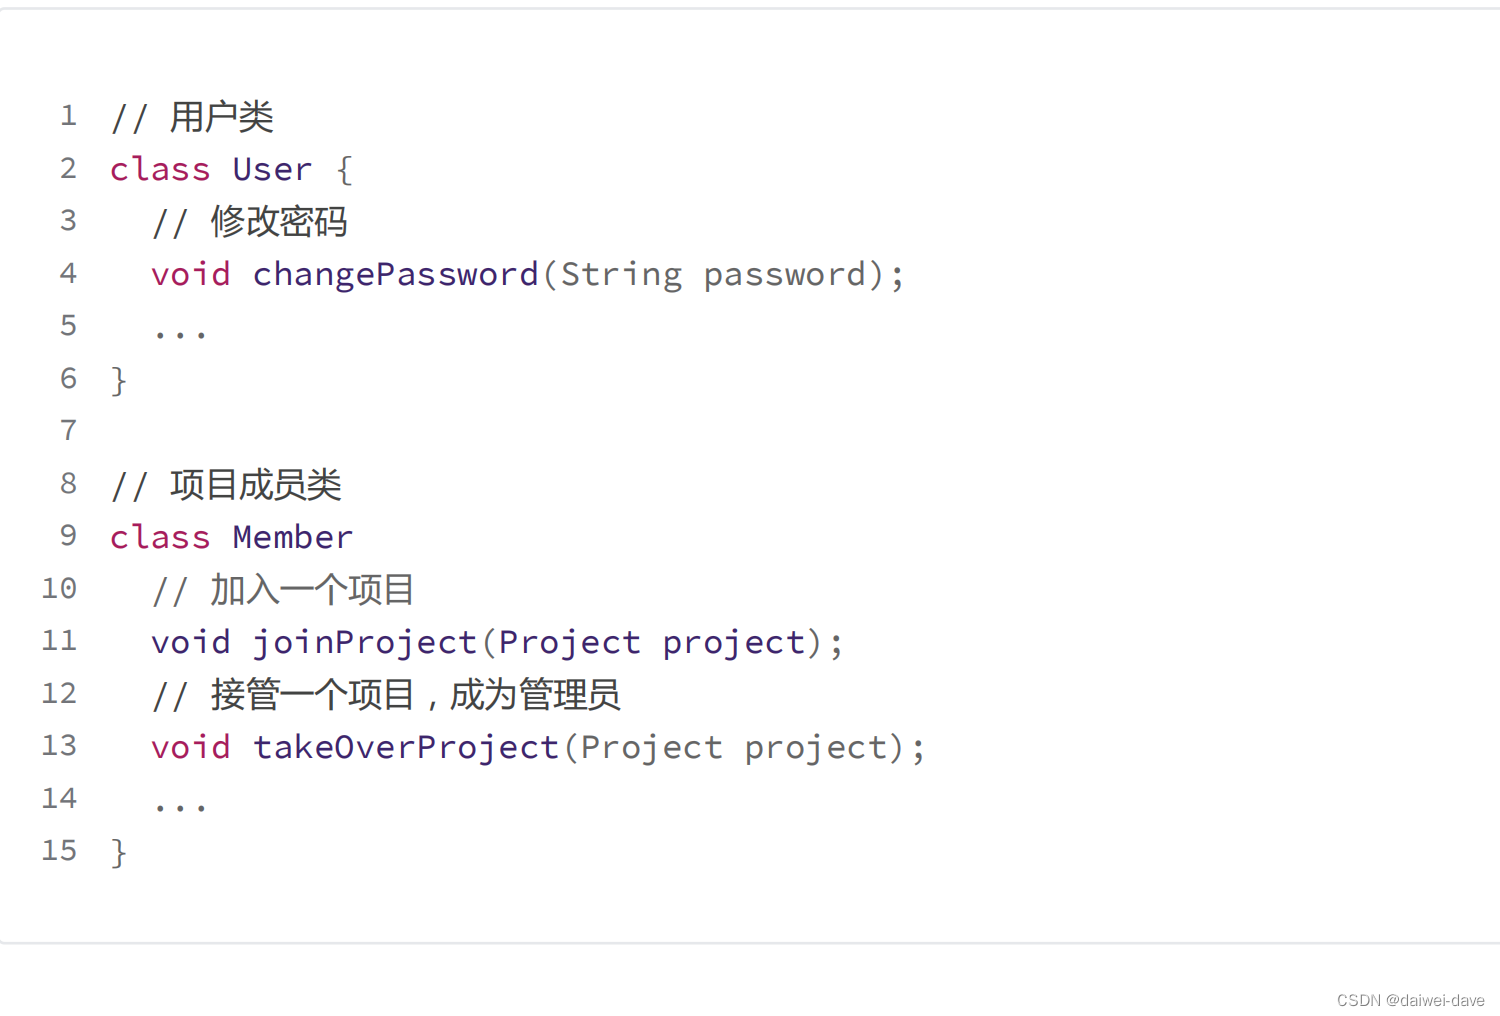
按照之前的说法,分离关注点,应该是发现的关注点越多越好,粒度越小越好。如果你能看到的关注点越多,就可以构建出更多的类,但每个类的规模相应地就会越小,与之相关的需求变动也会越少,它能够稳定下来的几率就会越大。我们代码库里稳定的类越多越好,这应该是我们努力的一个方向。
不过,也许你会想,如果将这种思路推演到极致,一个类应该只有一个方法,这样,它受到的影响应该是最小的。的确如此,但我们在真实项目中,一个类通常都不只有一个方法,如果我们要求所有人都做到极致,显然也是不现实的。
那应该把哪些内容组织到一起呢?这就需要我们考虑单一职责原则定义的升级版,也就是第二个定义:一个模块应该对一类且仅对一类行为者负责。
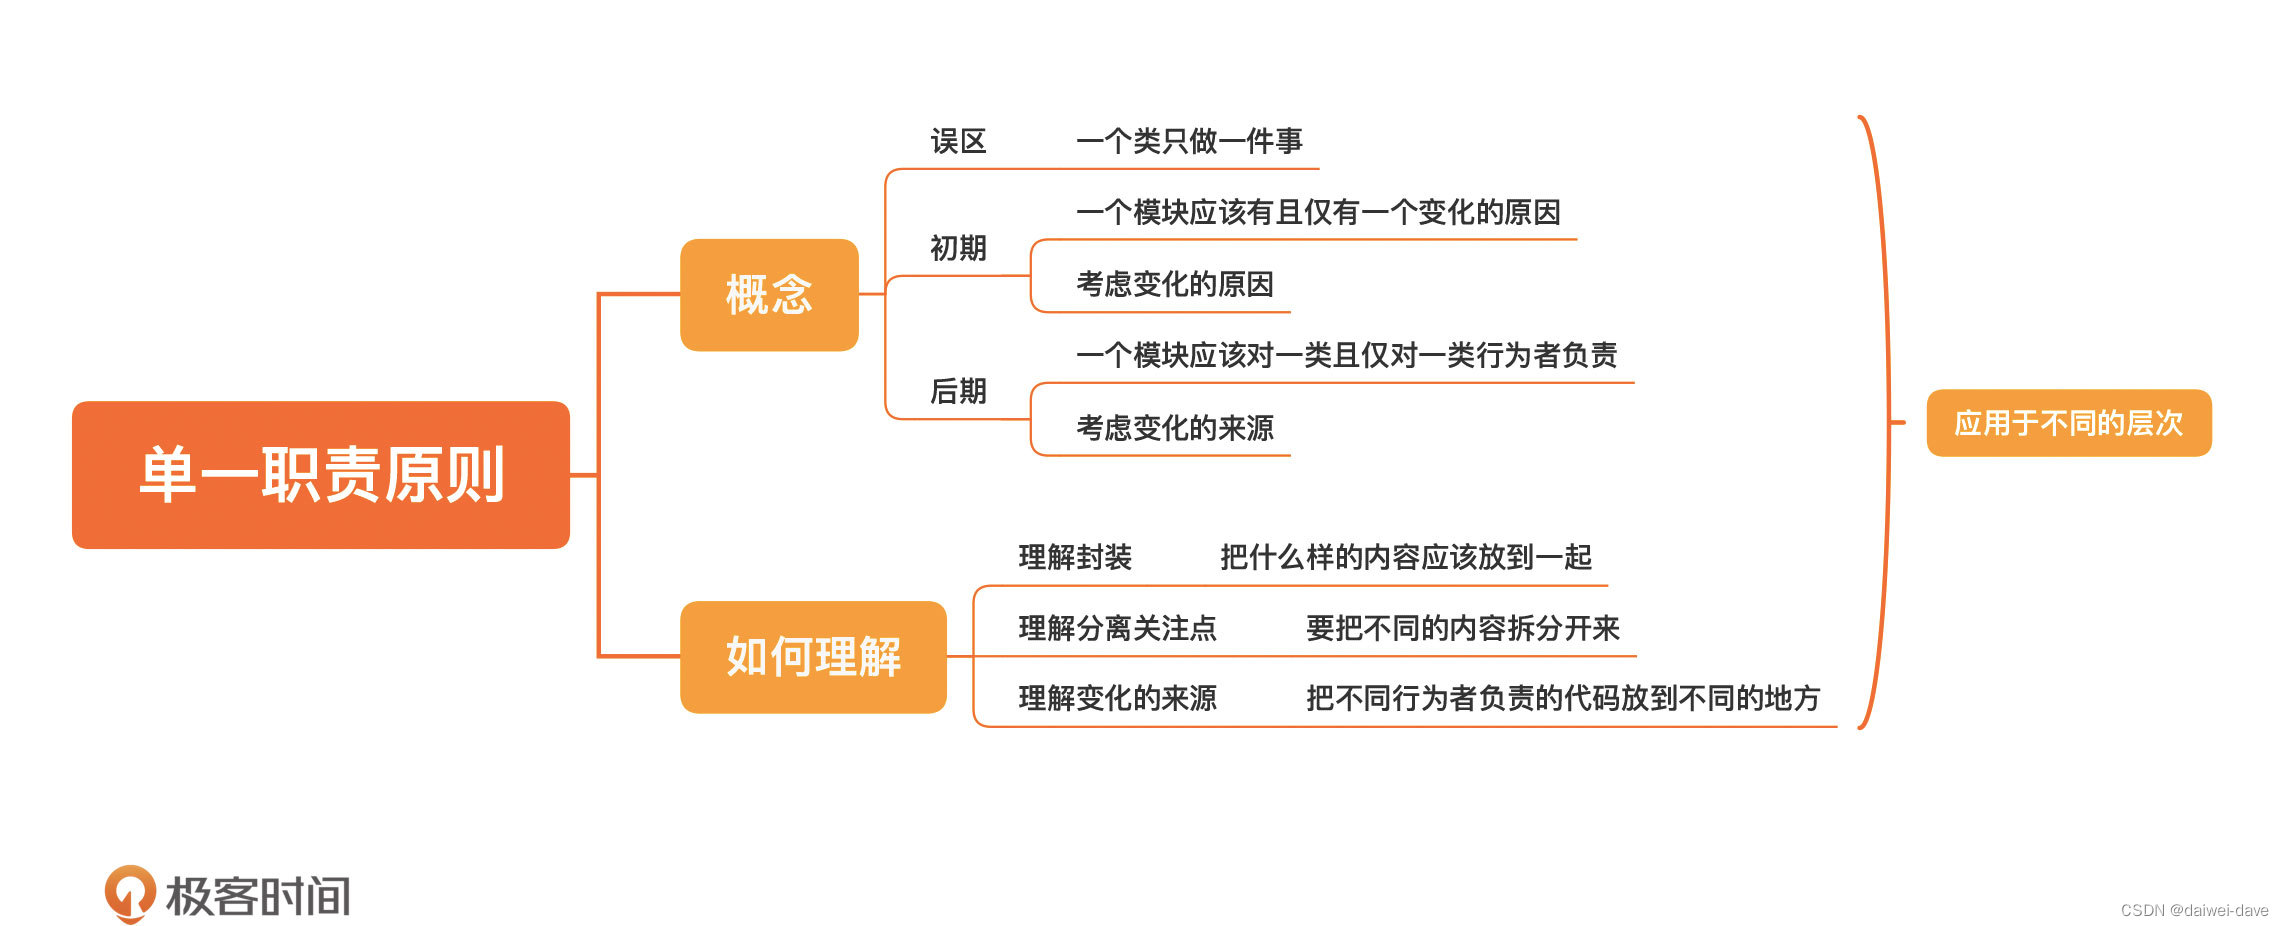
单一职责原则也可以指导我们在不同的子系统之间进行职责分配。所以,单一职责原则这个看起来最简单的原则,实际上也蕴含着很多值得挖掘的内容。要想理解好单一职责原则:
我们需要理解封装,知道要把什么样的内容放到一起;
我们需要理解分离关注点,知道要把不同的内容拆分开来;
我们需要理解变化的来源,知道把不同行为者负责的代码放到不同的地方
2.开闭原则
一个软件实体如类、模块和函数应该对扩展开放,对修改关闭。
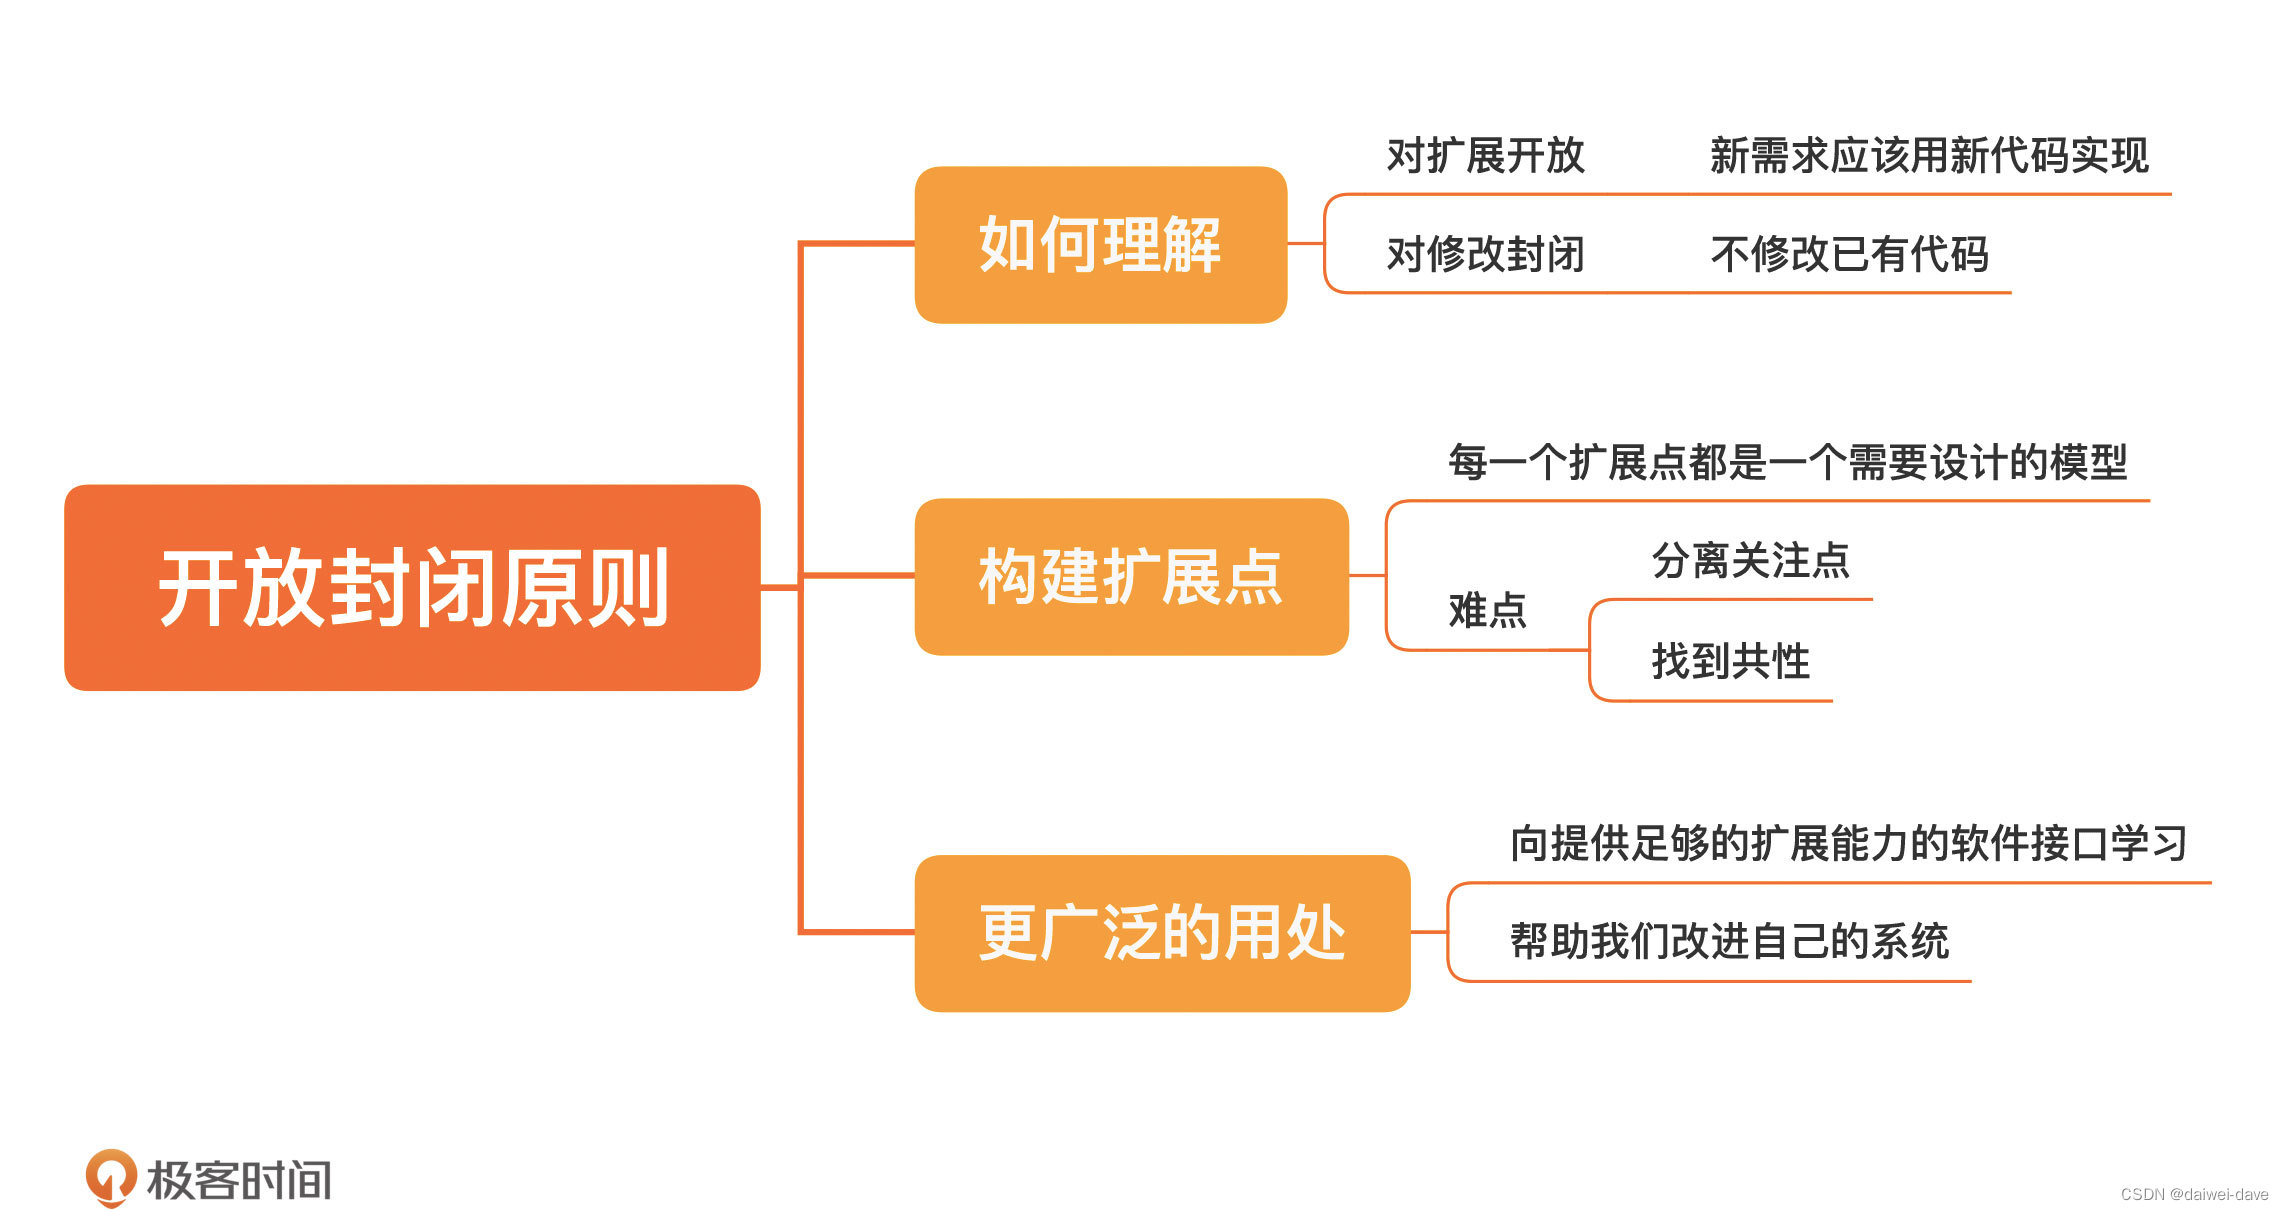
常见的工厂模式+策略模式其实质大多遵守的就是开闭原则和里氏替换原则
3.接口隔离原则
类不应该依赖它不需要的接口;一个类对另一个类的依赖应该建立在最小的接口上
问题由来:类A通过接口I依赖类B,类C通过接口I依赖类D,如果接口I对于类A和类B来说不是最小接口,则类B和类D必须去实现他们不需要的方法。

解决方案:将臃肿的接口I拆分为独立的几个接口,类A和类C分别与他们需要的接口建立依赖关系。也就是采用接口隔离原则。

总结:单一职责原则告诉我们实现类要职责单一;里氏替换原则告诉我们不要破坏继承体系;依赖倒置原则告诉我们要面向接口编程;接口隔离原则告诉我们在设计接口的时候要精简单一;迪米特法则告诉我们要降低耦合。而开闭原则是总纲,他告诉我们要对扩展开放,对修改关闭。
4.Liskov替换原则
1.核心理论
理论上,在定义了接口之后,我们就可以把继承这个接口的类完美地嵌入到我们设计好的体系之中。然而,用了继承,子类就一定设计对了吗?事情可能并没有这么简单。
新的类虽然在语法上声明了一个接口,形成了一个继承关系,但我们要想让这个子类真正地扮演起这个接口的角色,还需要有一个好的继承指导原则。
所以,我们就来看看可以把继承体系设计好的设计原则:Liskov 替换法则。
官方定义:
若每个类型 S 的对象 o1,都存在一个类型 T 的对象 o2,使得
在所有针对 T 编程的程序 P 中,用 o1 替换 o2 后,程序 P 行为保持不变,则 S 是 T 的子类型。
通俗的来讲:子类可以扩展父类的功能,但是子类不能修改父类原有的功能 里氏替换原则就是给继承性的使用制定了规范。
他指导了使用继承需要遵守以下原则:
- 子类可以实现父类的抽象方法,但是不能覆盖父类的非抽象方法
-
子类中可以扩展自己的方法,但不能修改父类的方法。
-
里氏替换原则并非让我们尽量避免使用继承
-
里氏替换原则是实现开闭原则的重要方式
如果违背了Liskov替换原则,那么程序P的执行结果,需要依赖于类型 T的实现到底是o1还是o2.
关心子类是一种实现继承的表现,而实现继承是我们要努力摒弃的,接口继承才是我们的努力方向,而做好接口继承,显然会更符合LSP。
2.例子
定义计算器类Calculator.java
/**
 * 计算器类
 * @author:liyajie
 * @createTime:2022/1/31 15:25
 * @version:1.0
 */
public class Calculator {
    //定义加法功能
    public int add(int a,int b){
        return a + b;
    }
    //定义减法功能
    public int sub(int a,int b){
        return a - b;
    }
}
定义超级计算器类SuperCalculator.java
/**
 * 超级计算器类
 * @author:liyajie
 * @createTime:2022/1/31 15:25
 * @version:1.0
 */
public class SuperCalculator extends Calculator{
    //增补需求,两数相加再加5
    @Override
    public int add(int a,int b){
        return a + b + 5;
    }
    //希望两数相加之和与100求差
    public int mul(int a,int b){
        int count = add(a, b);
        return 100 - count;
    }
}
定义测试类Test1.java
/**
 * 测试类1
 * @author:liyajie
 * @createTime:2022/1/31 15:25
 * @version:1.0
 */
public class Test1 {

    public static void main(String[] args) {
        int result = new Calculator().add(4,6);
        System.out.println("4和6之和为:" + result);

        int mul = new SuperCalculator().mul(4,6);
        System.out.println("4和6之和与100相差:" + mul);
    }
}
测试结果: 可以看到4和6之后与100相差的结果为85,明显是错误的答案。错误的原因就是SuperCalculator类继承Calculator类之后,重写了add方法,最终在调用的时候产生了错误的答案
3.更广泛的 LSP
如果理解了 LSP,你会发现,它不仅适用于类级别的设计,还适用于更广泛的接口设计。
比如,我们在开发中经常会遇到系统集成的问题,有不同的厂商都要通过 REST 接口把他们的统计信息上报到你的系统中,但是,有一个大厂上报的消息格式没法遵循你定义的格式,因为他的系统改动起来难度比较大。你该怎么办呢?
也许,专门为大厂设计一个特定接口是最简单的想法,但是,一旦开了这个口子,后面的各种集成接口都要为这个大厂开发一份特殊的,而且,如果未来再有其他大厂也提出要求,你要不要为它们也设计特殊接口呢?事实上,很多项目功能不多,但接口特别多,就因为在这种决策的时候开了口子。请记住,公开接口是最宝贵的资源,千万不能随意添加。
如果我们用 LSP 的角度看这个问题,通用接口就是一个父类接口,而不同厂商的内容就相当于一个个子类。让厂商面对特定接口,系统将变得无法维护。后期随着人员变动,接口只会更加膨胀,到最后,没有人说清楚每个接口到底是做什么的。好,那我们决定采用统一的接口,可是不同的消息格式该怎么处理呢?
首先,我们需要区分出不同的厂商,办法有很多,无论是通过 REST 的路径,还是 HTTP 头的方式,我们可以得到一个标识符。然后呢?
很容易想到的做法就是写出一个 if 语句来,像下面这样
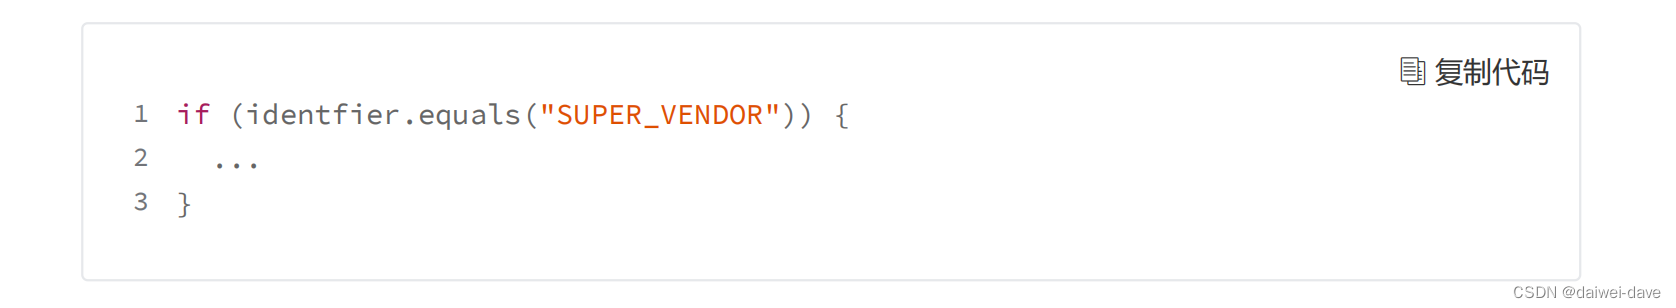
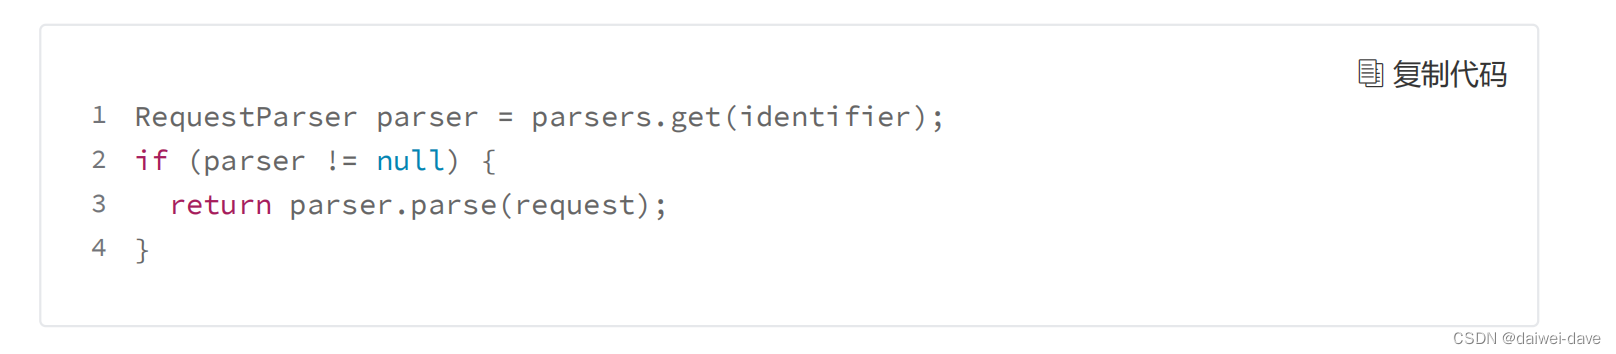
但是,千万要遏制自己写 if 的念头,一旦开了这个头,后续的代码也将变得难以维护。我
们可以做的是,提供一个解析器的接口,根据标识符找到一个对应的解析器,像下面这
样
5.依赖倒置原则
依赖倒置原则(Dependency inversion principle,简称 DIP)是这样表述的:
高层模块不应依赖于低层模块,二者应依赖于抽象。
High-level modules should not depend on low-level modules. Both should
depend on abstractions.
抽象不应依赖于细节,细节应依赖于抽象。
Abstractions should not depend on details. Details (concrete implementations)
should depend on abstractions.
其实依赖倒置的设计原则的完美落地实现就是spring框架的DI依赖注入。
在实际的项目中,代码经常会直接耦合在具体的实现上。比如,我们用 Kafka 做消息传递,我们就在代码里直接创建了一个 KafkaProducer 去发送消息。我们就可能会写出这样的代码:
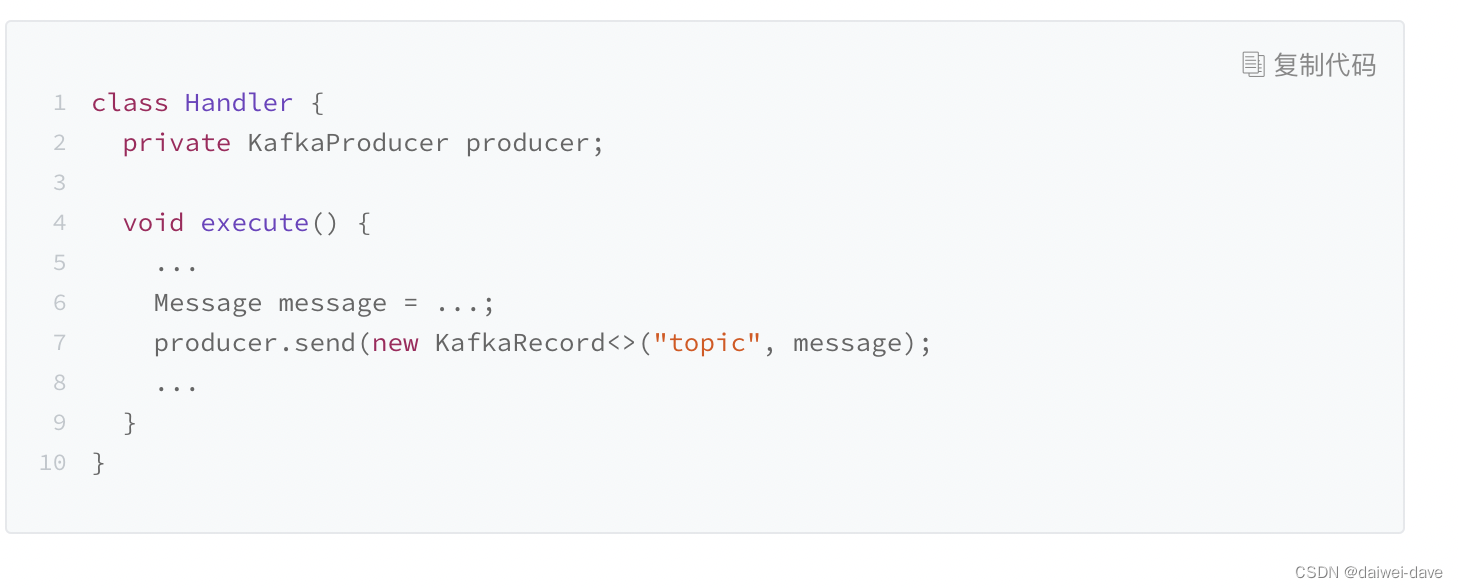
既然这个模块扮演的就是消息发送者的角色,那我们就可以引入一个消息发送者
(MessageSender)的模型:
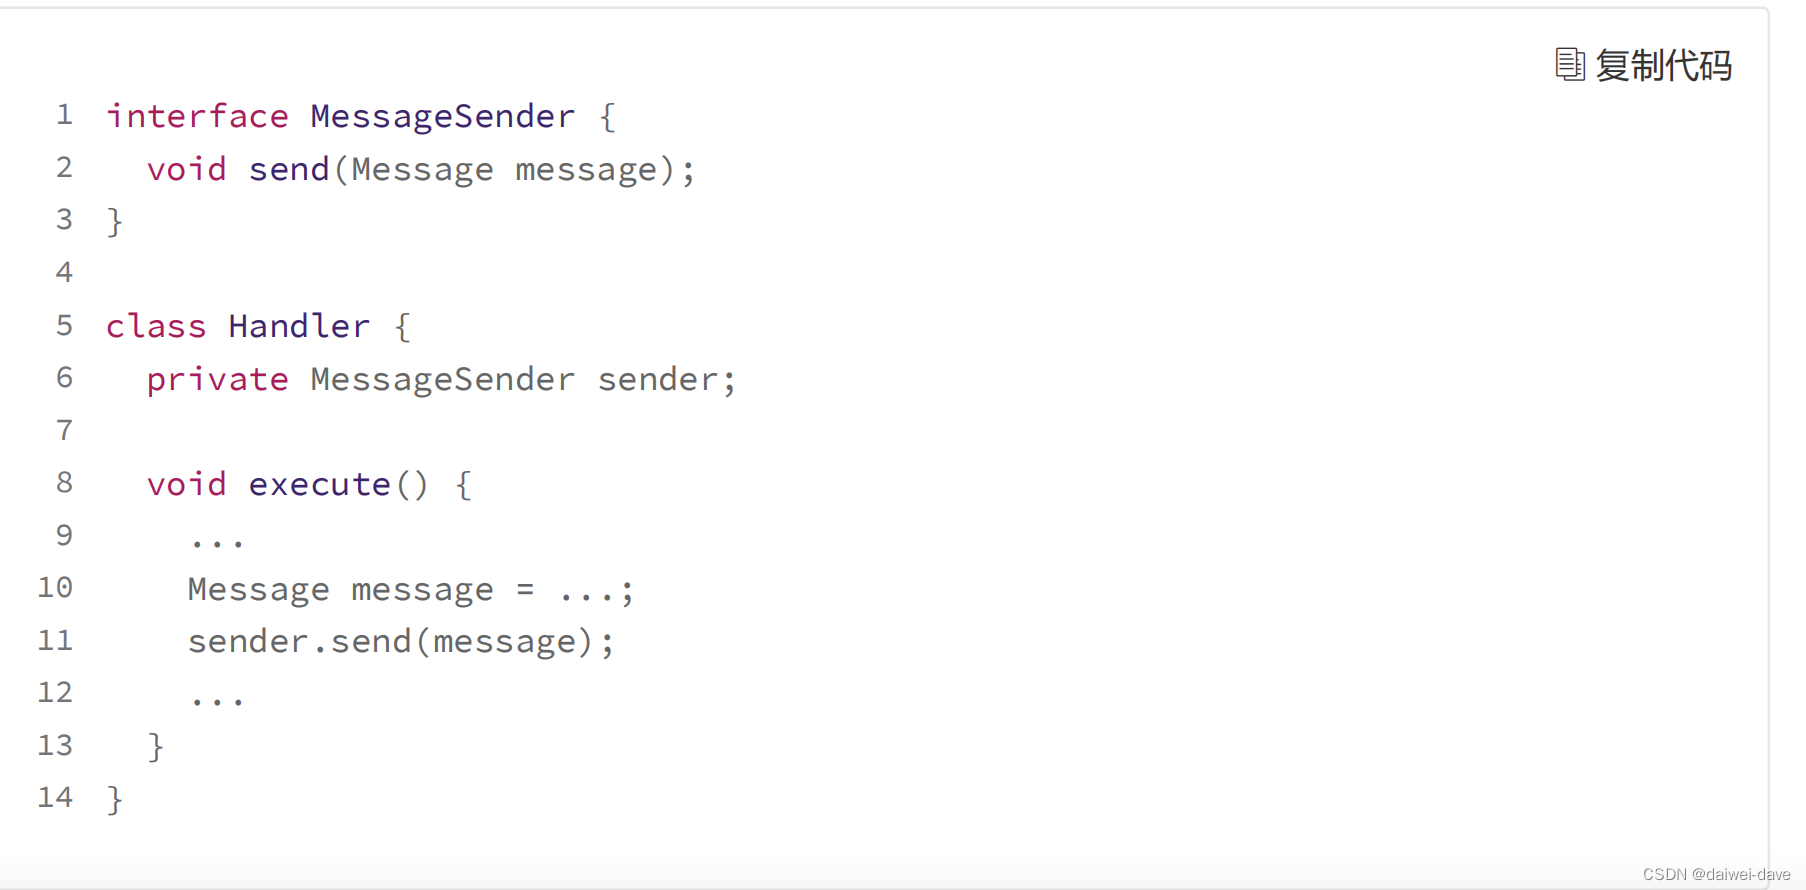
有了消息发送者这个模型,那我们又该如何把 Kafka 和这个模型结合起来呢?那就要实现
一个 Kafka 的消息发送者:
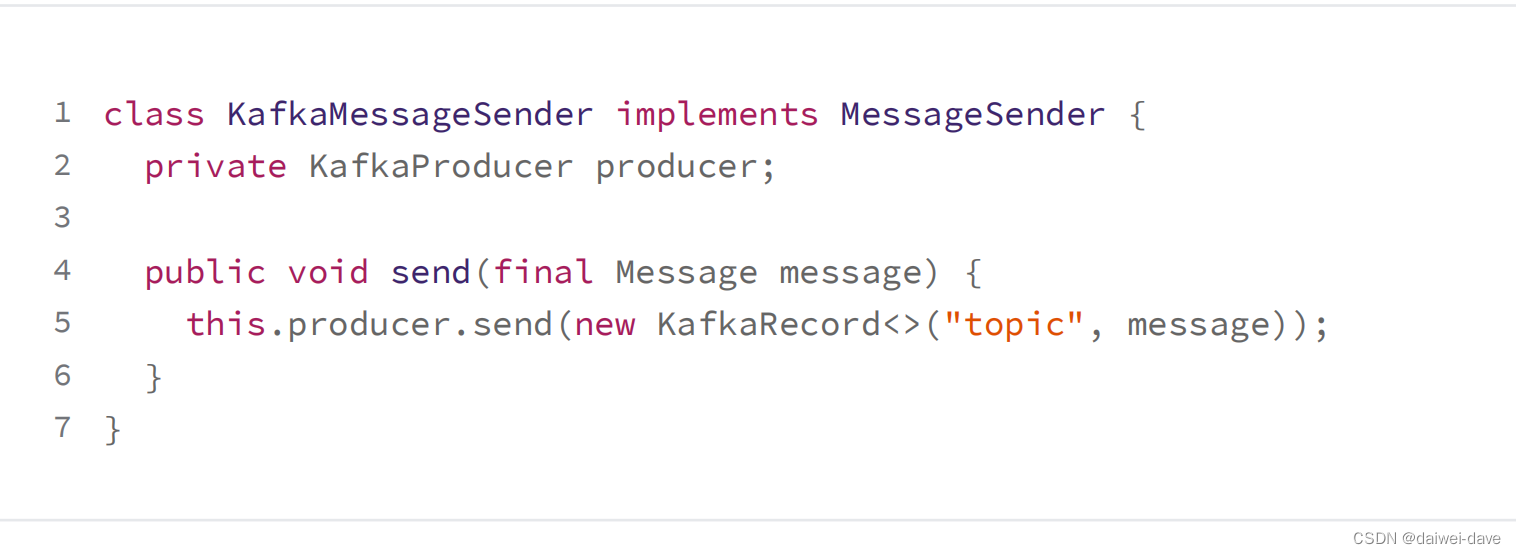
这样一来,高层模块就不像原来一样直接依赖低层模块,而是将依赖关系“倒置”过来,让低层模块去依赖由高层定义好的接口。这样做的好处就在于,将高层模块与低层实现解耦开来。
如果未来我们要替换掉 Kafka,只要重写一个 MessageSender 就好了,其他部分并不需要改变。这样一来,我们就可以让高层模块保持相对稳定,不会随着低层代码的改变而改变。
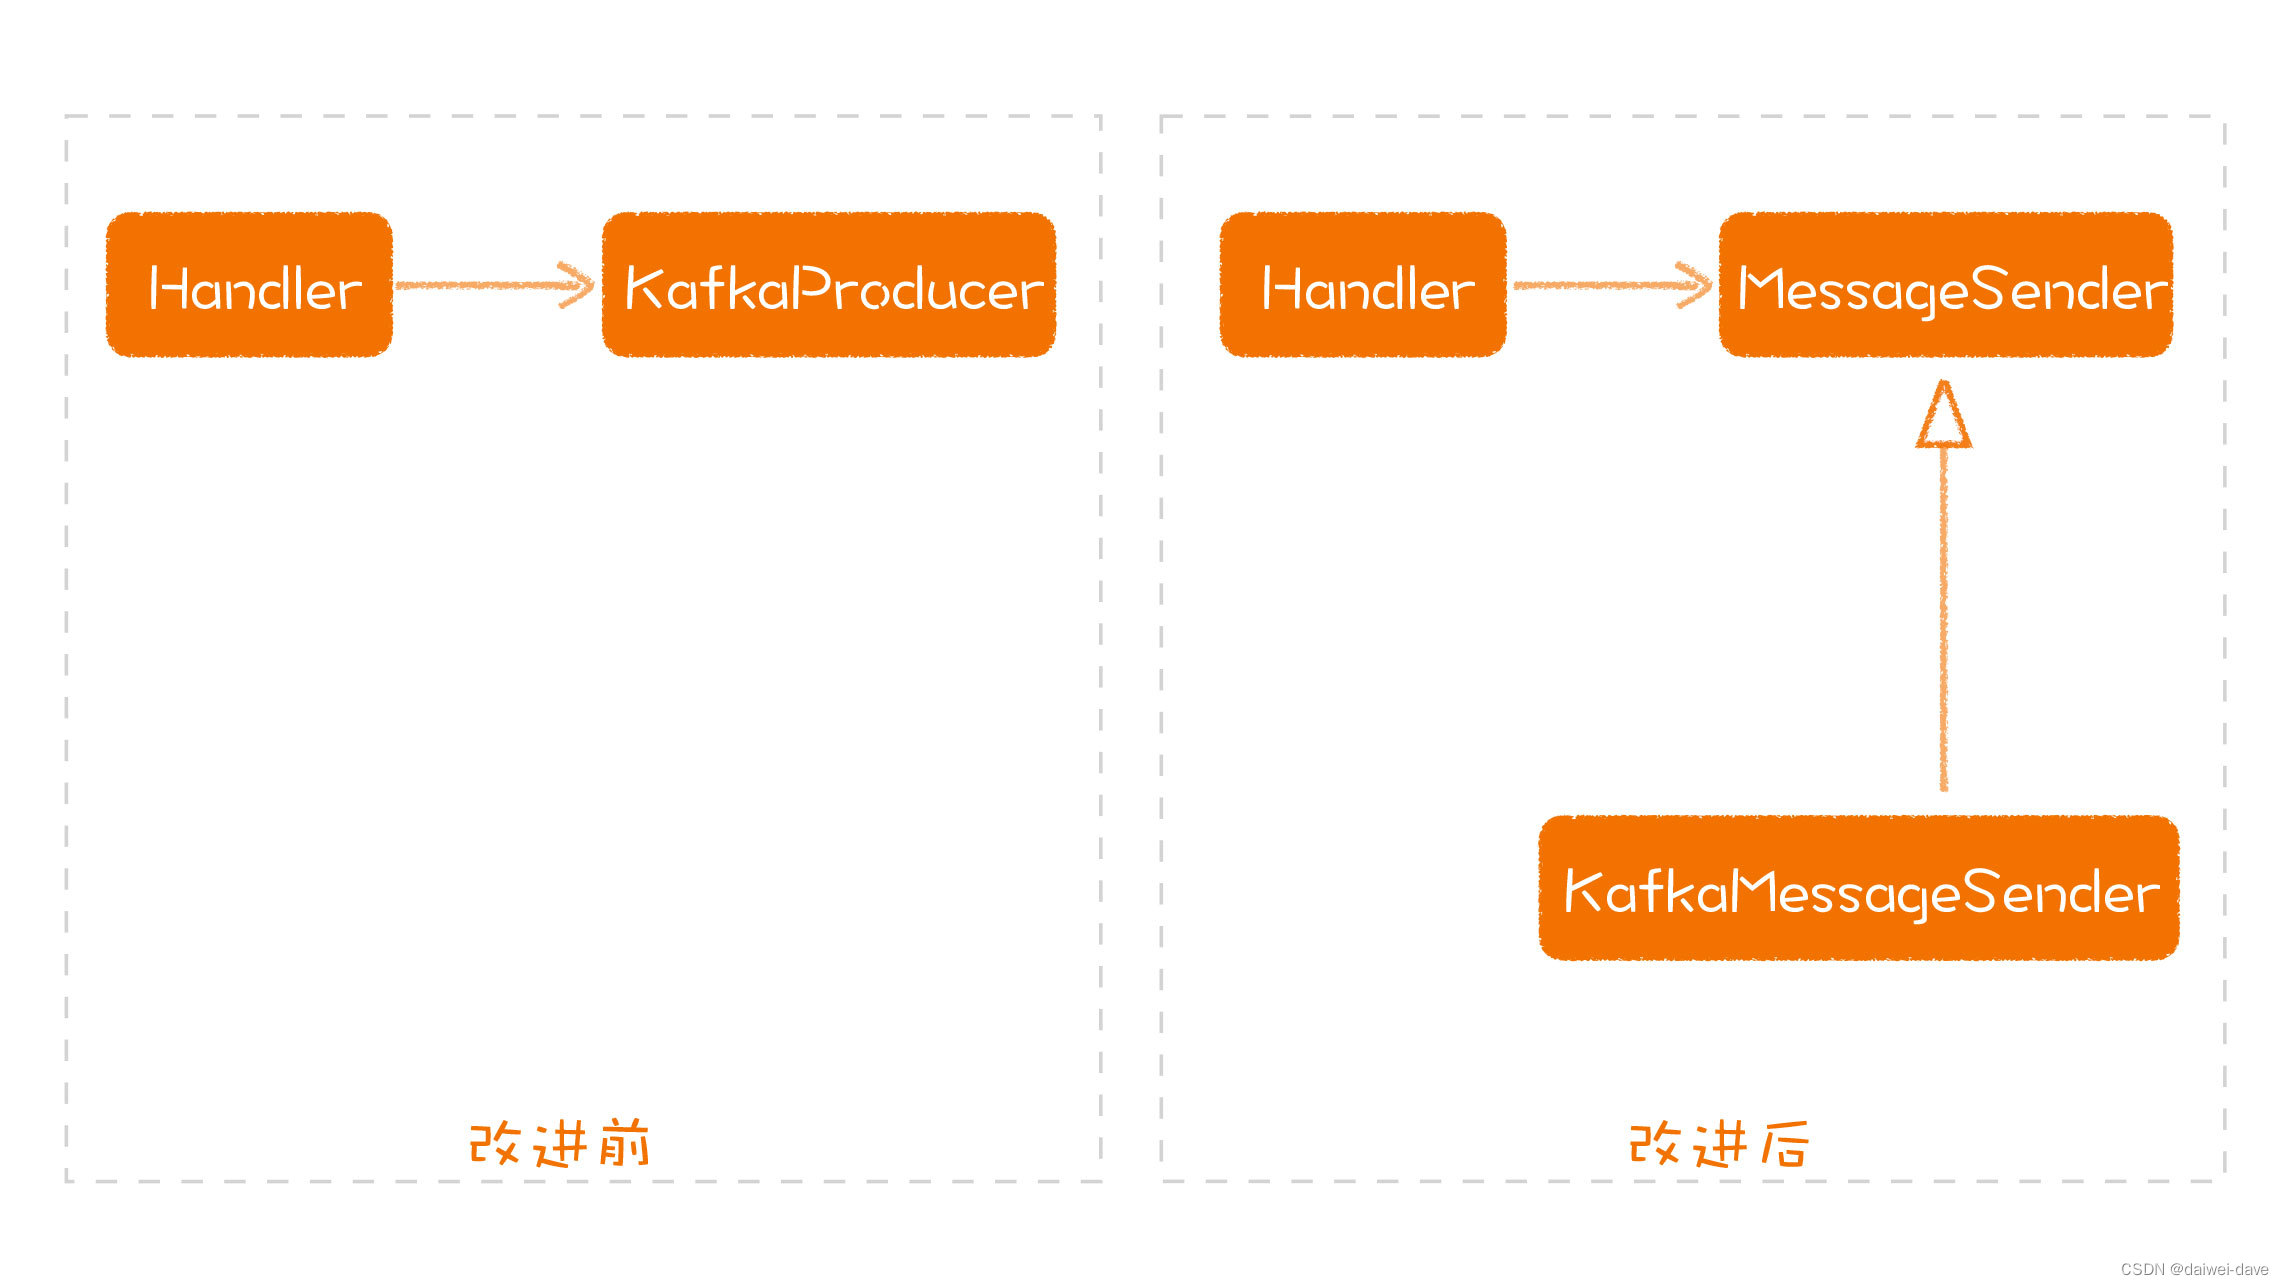
理解了 DIP 的第一部分后,我们已经知道了要建立起模型(抽象)的概念。
你有没有发现,我们学习的所有原则都是在讲,尽可能把变的部分和不变的部分分开,让不变的部分稳定下来。我们知道,模型是相对稳定的,实现细节则是容易变动的部分。所以,构建出一个稳定的模型层,对任何一个系统而言,都是至关重要的。
那接下来,我们再来分析 DIP 的第二个部分:抽象不应依赖于细节,细节应依赖于抽象。
其实,这个可以更简单地理解为一点:依赖于抽象,从这点出发,我们可以推导出一些更
具体的指导编码的规则:
- 任何变量都不应该指向一个具体类;
- 任何类都不应继承自具体类;
- 任何方法都不应该改写父类中已经实现的方法。
我们在说多态时,提到过一个 List 声明的例子,其实背后遵循的就是这里的第一条规则:
List<String> list = new ArrayList<>();二、设计模式
创建型模式:共5种:
工厂方法模式、抽象工厂模式、单例模式、建造者模式、原型模式
结构型模式:共7种:
适配器模式、装饰器模式、代理模式、桥接模式、外观模式、组合模式、享元模式
行为型模式:共11种:
策略模式、模板方法模式、观察者模式、责任链模式、访问者模式、中介者模式、迭代器模式、命令模式、状态模式、备忘录模式、解释器模式
1.创建型模式(5种)
1.工厂模式
简单的说本质是实列工厂,即按照不同的业务类型去取对应业务bean,常常伴随着策略模式使用。而工厂模式的核心是就是在容器启动时就已经注册好了,即开箱即用。
使用案例
1.spring+枚举方式实现工厂模式
本案例的场景是监听数据表字段的修改记录,并对表字段的修改作后续的业务处理。
定义枚举:
/**
 * 业务-数据表关系映射
 *
 * @author daiwei
 */

public enum TableNameEnum {
    SALE_PLAN("salePlan", "sale_plan", "salePlanBizHandler"),
    PRODUCE_SALE_COO("produceSaleCooperate", "produce_sale_cooperate", "produceSaleCooperateBizHandler"),
    ;

    /**
     * 业务名
     */
    String businessName;
    /**
     * 业务对应的表名
     */
    String tableName;

    /**
     * 业务处理器
     */
    String bizHandler;

    TableNameEnum(String businessName, String tableName, String bizHandler) {
        this.businessName = businessName;
        this.tableName = tableName;
        this.bizHandler = bizHandler;
    }

    public String getBusinessName() {
        return businessName;
    }

    public void setBusinessName(String businessName) {
        this.businessName = businessName;
    }

    public String getTableName() {
        return tableName;
    }

    public void setTableName(String tableName) {
        this.tableName = tableName;
    }

    public String getBizHandler() {
        return bizHandler;
    }

    public static TableNameEnum getByBusinessName(String businessName) {
        for (TableNameEnum e : values()) {
            if (e.getBusinessName().equals(businessName)) {
                return e;
            }
        }
        return null;
    }

    public static TableNameEnum getByTableName(String tableName) {
        for (TableNameEnum e : values()) {
            if (e.getTableName().equals(tableName)) {
                return e;
            }
        }
        return null;
    }
通过spring ioc获取对应的bean
 FieldValChangeHandler fieldValChangeHandler = SpringUtils.getBean(tableNameEnum.getBizHandler());
                fieldValChangeHandler.handleBizLogic(value);
bean的具体执行业务逻辑如下:
/**
 * 表字段值变更业务处理接口
 *
 * @author daiwei
 */
public interface FieldValChangeHandler {
    /**
     * 处理业务逻辑
     *
     * @param fieldAlterLogs
     */
    void handleBizLogic(List<FieldAlterLog> fieldAlterLogs);
}
salePlanBizHandler类的执行逻辑
/**
 * @author daiwei
 */
@Service("salePlanBizHandler")
public class SalePlanBizHandler implements FieldValChangeHandler {
    @Autowired
    SalePlanService salePlanService;
    @Autowired
    ProductSaleCooperateMapper productSaleCooperateMapper;

    @Autowired
    ProduceSaleCooperateService produceSaleCooperateService;

    @Override
    public void handleBizLogic(List<FieldAlterLog> fieldAlterLogs) {
        Long salePlanId = ListUtil.nullToEmpty(fieldAlterLogs).stream()
                .map(FieldAlterLog::getSourceId)
                .map(Long::valueOf)
                .findFirst().orElse(null);
        SalePlan salePlan = salePlanService.getById(salePlanId);
        List<ProduceSaleCooperate> produceSaleCooperateList = productSaleCooperateMapper.selectList(new LambdaQueryWrapper<ProduceSaleCooperate>()
                .eq(ProduceSaleCooperate::getMonthDate, salePlan.getMonthDate())
                .eq(ProduceSaleCooperate::getNickName, salePlan.getNickName())
                .eq(ProduceSaleCooperate::getSeedOutputExpectTime, salePlan.getSeedOutputExpectTime())
                .eq(ProduceSaleCooperate::getProductStandard, salePlan.getProductStandard())
                .eq(ProduceSaleCooperate::getProductStrain, salePlan.getProductStrain()));
        if (CollectionUtil.isEmpty(produceSaleCooperateList)){
            return;
        }
        List<ProduceSaleCooperate> updateParams = ListUtil.collect(produceSaleCooperateList, entity -> ProduceSaleCooperate.builder()
                .id(entity.getId())
                .procureCompany(salePlan.getProcureCompany())
                .build());
        produceSaleCooperateService.updateBatchById(updateParams);
    }
}
produceSaleCooperateBizHandler类的执行逻辑:
@Service("produceSaleCooperateBizHandler")
public class ProduceSaleCooperateBizHandler implements FieldValChangeHandler {
    @Override
    public void handleBizLogic(List<FieldAlterLog> fieldAlterLogs) {

    }
}
2. 单例模式
作为对象的创建模式,单例模式确保某一个类只有一个实例,而且自行实例化并向整个系统提供这个实例。这个类称为单例类。
一个类产生一个对象
1.2.1 双重检查加锁
为何使用双重检查加锁
1.性能问题
懒汉式的实现是线程安全的,这样会降低整个并发访问的速度,而且每次都要判断。
2.为何需要双重检查
不是每次进入getInstance方法都需要同步,而是先不同步,进入方法后,先检查实例是否存在,如果不存在才进行下面的同步块,这是第一重检查。
进入同步块过后,再次检查实例是否存在,如果不存在,就在同步的情况下创建一个实例,这是第二重检查。
为什么需要第二重检查的原因是第一个获取到锁的线程创建完实例后释放锁,剩余卡在synchronized (Singleton.class) 的线程开始执行就无需再创建完实例了。
主要解决创建实例时的线程安全问题和性能问题:
public class Singleton {
    private volatile static Singleton instance = null;
    private Singleton(){}
    public static Singleton getInstance(){
        //先检查实例是否存在,如果不存在才进入下面的同步块
        if(instance == null){
            //同步块,线程安全的创建实例
            synchronized (Singleton.class) {
                //再次检查实例是否存在,如果不存在才真正的创建实例
                if(instance == null){
                    instance = new Singleton();
                }
            }
        }
        return instance;
    }
}
1.2.2 懒汉和饿汉模式
饿汉模式
public class EagerSingleton {
    private static EagerSingleton instance = new EagerSingleton();
    /**
     * 私有默认构造子
     */
    private EagerSingleton(){}
    /**
     * 静态工厂方法
     */
    public static EagerSingleton getInstance(){
        return instance;
    }
}
懒汉模式
public class LazySingleton {
    private static LazySingleton instance = null;
    /**
     * 私有默认构造子
     */
    private LazySingleton(){}
    /**
     * 静态工厂方法
     */
    public static synchronized LazySingleton getInstance(){
        if(instance == null){
            instance = new LazySingleton();
        }
        return instance;
    }
}
1.2.3 类级内部类实现单例
public class Singleton {

    private Singleton(){}
    /**
     *    类级的内部类,也就是静态的成员式内部类,该内部类的实例与外部类的实例
     *    没有绑定关系,而且只有被调用到时才会装载,从而实现了延迟加载。
     */
    private static class SingletonHolder{
        /**
         * 静态初始化器,由JVM来保证线程安全
         */
        private static Singleton instance = new Singleton();
    }

    public static Singleton getInstance(){
        return SingletonHolder.instance;
    }
}
《JAVA与模式》之单例模式 https://www.cnblogs.com/java-my-life/archive/2012/03/31/2425631.html
3.建造者模式
将内部复杂的对象属性构建流程封装起来,便于客户端快速构建类的属性。如典型lombok插件构造属性值,当然你也可以自己写一个建造者方法构建属性
4.原型模式
通过给出一个原型对象来指明所有创建的对象的类型,然后用复制这个原型对象的办法创建出更多同类型的对象。简单就是对象的复制。注意要区分浅拷贝还是深拷贝。
5.抽象工厂模式
用得比较少,比如spring中FactoryBean接口就是抽象工厂模式的典型实现
2.结构型模式(7种)
1.代理模式
代理模式给某一个对象提供一个代理对象,并由代理对象控制对原对象的引用。AOP的设计思想就是基于代理模式。
常见的场景:
1.mybatis dao层生成动态代理执行jdbc那套获取数据库连接并执行SQL和映射结果的那一套流程

2.dubbo rpc层生成代理执行协议编码/解码,序列化/反序列化,网络传输等流程功能
2.适配器模式
适配器在实战中,更多的是兼容上下处理器,将兼容的部分抽离出来。实现将相互独立的处理器松耦合,最有效的比喻是:电脑适配器,兼容了插座和电脑接口的联通。
2.1 类适配
2.2 对象适配
2.3 缺省适配
缺省适配为一个接口提供缺省实现,这样子类型可以从这个缺省实现进行扩展,而不必从原有接口进行扩展。在任何时候,如果不准备实现一个接口的所有方法时,就可以使用“缺省适配模式”制造一个抽象类,给出所有方法的平庸的具体实现。这样,从这个抽象类再继承下去的子类就不必实现所有的方法了。
适配器模式的优点
- 更好的复用性
系统需要使用现有的类,而此类的接口不符合系统的需要。那么通过适配器模式就可以让这些功能得到更好的复用。
- 更好的扩展性
在实现适配器功能的时候,可以调用自己开发的功能,从而自然地扩展系统的功能。
适配器模式的缺点
过多的使用适配器,会让系统非常零乱,不易整体进行把握。比如,明明看到调用的是A接口,其实内部被适配成了B接口的实现,一个系统如果太多出现这种情况,无异于一场灾难。因此如果不是很有必要,可以不使用适配器,而是直接对系统进行重构。
参考:
http://www.cnblogs.com/java-my-life/archive/2012/04/13/2442795.html
3.外观模式
如各个业务部门的网关,用于屏蔽内部实现细节,在里面可以实现鉴权,权限控制等。一般以Facade结尾作为标志。
3.行为型模式(11种)
1.策略模式
常伴随着工厂模式一起使用,主要根据不同的业务模型,使用不同的处理的方法。
2.模板模式
准备一个抽象类,将部分逻辑以具体方法以及具体构造函数的形式实现,然后声明一些抽象方法来迫使子类实现剩余的逻辑。不同的子类可以以不同的方式实现这些抽象方法,从而对剩余的逻辑有不同的实现。
他即定义了处理器的核心公用流程,由兼容了各个业务模型独立的处理逻辑。
抽象类主要的职责就是定义业务流程,并实现一些公有的逻辑。常见场景主要有:推送模型,消息队列监听消息和处理逻辑模型
使用的好处
作为结构式设计模式,使业务的总处理流程结构更加清晰
《JAVA与模式》之模板方法模式
https://www.cnblogs.com/java-my-life/archive/2012/05/14/2495235.html
3.观察者模式
观察者模式定义了一种一对多的依赖关系,让多个观察者对象同时监听某一个主题对象。这个主题对象在状态上发生变化时,会通知所有观察者对象,使它们能够自动处理对应的业务逻辑。
常见的应用模型有:发布-订阅(Publish/Subscribe)模式、模型-视图(Model/View)模式、源-监听器(Source/Listener)模式
比如我们常见的中间件有用到发布-订阅模型,各种应用框架的监听器等等
发布-订阅模式原理:
个人认为:topic作为key值,消费者列表则为values。当topic有消息进来时,则获取key里面的value值,然后推送消息
在观察者模式中,又分为推模型和拉模型两种方式。
● 推模型
主题对象向观察者推送主题的详细信息,不管观察者是否需要,推送的信息通常是主题对象的全部或部分数据。
● 拉模型
主题对象在通知观察者的时候,只传递少量信息。如果观察者需要更具体的信息,由观察者主动到主题对象中获取,相当于是观察者从主题对象中拉数据。一般这种模型的实现中,会把主题对象自身通过update()方法传递给观察者,这样在观察者需要获取数据的时候,就可以通过这个引用来获取了。
参考:https://www.cnblogs.com/java-my-life/archive/2012/05/16/2502279.html
4.状态模式
可以简单的理解为switch 表达式,主要就是解决状态过多,减少复杂的if-else场景
5.责任链模式
责任链模式是一种对象的行为模式。在责任链模式里,很多对象由每一个对象对其下家的引用而连接起来形成一条链。请求在这个链上传递,直到链上的某一个对象决定处理此请求。发出这个请求的客户端并不知道链上的哪一个对象最终处理这个请求,这使得系统可以在不影响客户端的情况下动态地重新组织和分配责任。
自己理解:各个处理器组件按照链表一样的链式关系,来协同处理某一个业务场景。
好处是什么?
首先行为结构更加清晰,动态的增加或者减少处理器更方便,对业务的耦合较小,维护起来相对简单
https://www.cnblogs.com/java-my-life/archive/2012/05/28/2516865.html
6.命令模式
命令允许请求的一方和接收请求的一方能够独立演化,从而具有以下的优点:
(1)命令模式使新的命令很容易地被加入到系统里。
(2)允许接收请求的一方决定是否要否决请求。
(3)能较容易地设计一个命令队列。
(4)可以容易地实现对请求的撤销和恢复。
(5)在需要的情况下,可以较容易地将命令记入日志。
思考
1.责任链模式与策略模式的区别?
责任链模式主要指各个处理器一起协调的完成某一个功能,而策略模式各个处理器是相互独立的,是根据业务类型进行区分的。
设计模式的案例代码地址:https://gitee.com/daiwei-dave/design-pattern.git

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)