mysql cas mvcc_你对MVCC有所了解吗?
MySQL数据库之MVCC
前言
什么是MVCC,它的全程就是Multi Version Concurrency Control(多版本并发控制)。在原始的数据库当中,只有读读可以并发, 其余像读写、写读、写写都需要阻塞;而再引入多版本并发控制以后,就只有写写是阻塞了。这就在很大的程度上提高了数据库的并发性能
书上说的
1、MVCC是被MySQL数据库中事务性存储引擎InnoDB所支持的;
2、应对高并发事务,MVCC要比加锁高效。
3、MVCC只在READ_COMMITED 和 REAPATABLE READ事务隔离级别下生效
4、MVCC可以使用乐观锁和悲观锁来解决
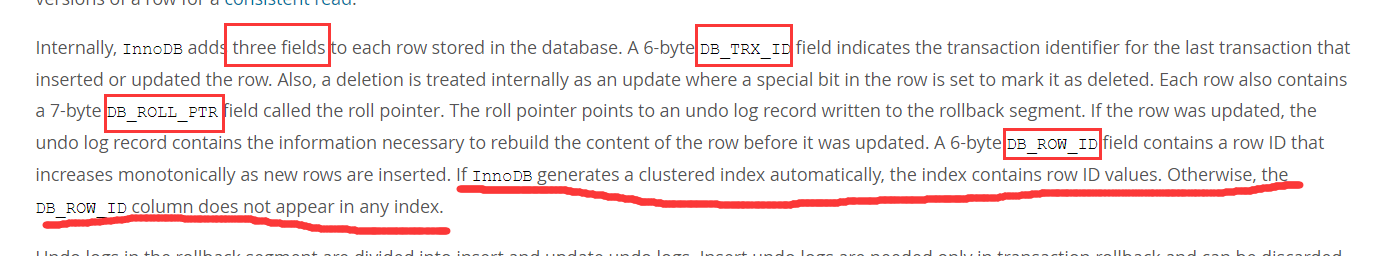
5、MVCC通过每行记录后面加三个隐藏列来实现的。
相关概念
如果对快照读和当前读还不明白的可以去去看看我的这篇笔记
传送门
快照读
快照读就是在执行一个select语句的时候,读取的是当前活跃事务能够看到的数据,具体的话有一个比较算法,后面会将。现在还需要区分的就是快照读对于读已提交和可重复读的事务隔离级别下的场景。
在innodb中(默认repeatable read级别), 事务在begin/start transaction之后的第一条select读操作后, 会创建一个快照(read view), 将当前系统中活跃的其他事务记录记录起来;
在innodb中(默认repeatable committed级别), 事务中每条select语句都会创建一个快照(read view);
当前读
当前读就相当于加锁的读了。例如:update、insert、delete天然就是加锁的读了。如果想要select也是当前读的话,就可以使用select … for update;
undo log
1、它是实现MVCC的重要组成部分,它是一个记录每个事务操作的日志,可以用来实现事务的隔离性。
2、undo log里面存储的是旧版的数据,当一个旧事务读取到数据时,为了能够保证能够读到老版的数据,需要顺着undo log的链一直往下找,直到找到对当前事务可见的记录。当版本链表很长的时候,通常可以任务,这个查询是非常耗时的。
3、在对数据库进行修改的操作大致包括INSERT/UPDATE/DELETE这几个,在insert的时候,它只对自己可见,并且别人也不会关心这个新插入的数据,insert只有在回滚的时候有作用,并且在事务提交之后,会立即删除。剩下的UPDATE/DELETE是我们所关心的,就是涉及到维护多个版本,所以我们通常把它俩作为一个 update_undo;insert为insert_undo。
InnoDB引擎在数据库的每行数据后面都会添加三个字段
这三个字段在上面提到过,分别是:
DB_TRX_ID:事务ID,用来标识最近的一次对本条数据更新的一个事务ID
DB_ROLL_PTR:回滚指针,用来进行回滚的
DB_ROW_ID:主键ID,这个需要注意的是,如果在设计表的时候,如果这个表被人为的设计了一个主键ID,那么生成的聚簇索引上没有这个字段值;如果是InnoDB自动生成的聚簇索引就有这个值了。
可见性比较算法
前面提到了事务是如何实现隔离,就是通过这个可见性比较算法来进行事务隔离的,让当前事务只能读到当前事务沿着undo log链应该读到的数据。
在这里记录下RR级别下的比较算法,其实RC级别下的比较算法和它是一样的,我们暂且描述一次:
首先,我们会有一个trx_id_current表示该行最稳定的事务ID;
当我们开启一个新事务去读取改行记录的时候,InnoDB会创建一个read view(快照),它维护了当前活跃的事务id(也就是未提交的事务),我们姑且称那个最早的事务ID为minID,最晚的事务ID为maxID。
接下来我们会根据这几个值进行描述比较算法:
当trx_id_current < minID的时候,说明该行数据的稳定事务id小于活跃事务id的,所以该行数据是可见的,跳到步骤五
当trx_id_current > maxID的时候,说明该行数据的稳定事务id大于当前快照下的活跃事务ID,所以说该行数据是不可见的,跳到步骤四。
当minID < trx_id_current < maxID,在这个范围的事务ID,那就在read view里的活跃事务ID中遍历,如果trx_id_current == 其中一个事务ID,那么就说明改行数据不可见。跳到步骤四。否则表示可见。
从该行记录的回滚指针(DB_ROLL_PIR)指向的下一个最新的事务ID,将这个值赋值给trx_id_current,继续从步骤1开始。
将该可见行的数据返回。
案例分析
下面是一个非常简版的演示事务对某行记录的更新过程, 当然, InnoDB引擎在内部要做的工作非常多:
我们假设现在有四个事务,其中三个事务是更新数据的,第四个事务是查询数据的
事务1
事务2
事务3
事务4
start transaction;
start transaction;
start transaction;
start transaction;
update table set name=‘A’ where id=1
update table set name=‘B’ where id=1
commit
update table set name=‘C’ where id=1
update table set name='AD where id=1
select name from table where id = 1
commit
commit
select name from table where id =1
undo log日志:
当事务1去更新数据的时候,会进行如下操作:
1、用排他锁锁定改行
2、记录redo log
3、把该行修改前的值copy到undo log中去
4、修改当前行的值,填写事务编号,使回滚指针指向undo log中的修改前的行
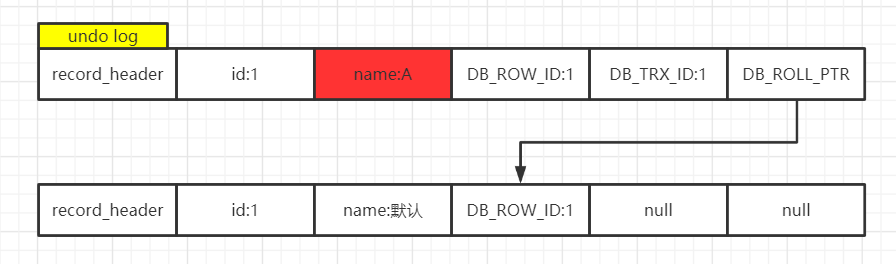
当事务2去更新数据的时候,也会跟着上面的步骤,然后undo log日志就是这样:
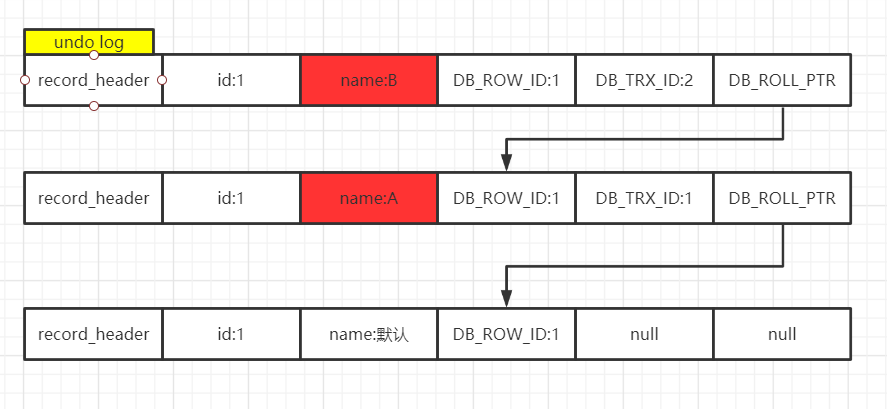
以此类推,最终会是这样:
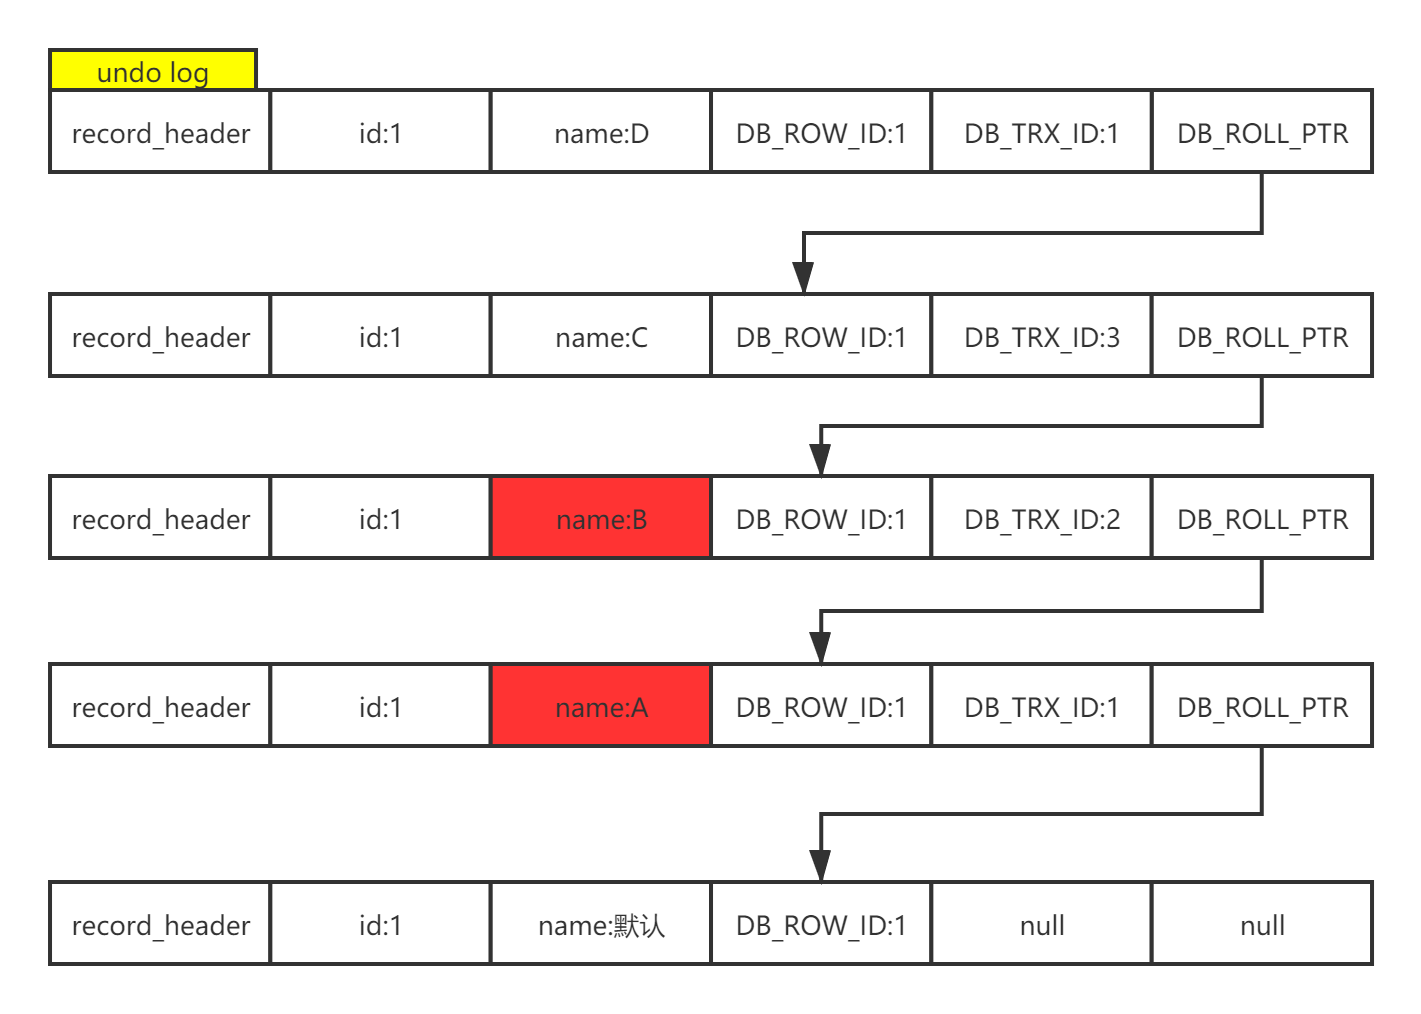
上面的这些是进行更新的时候的一个流程,如果涉及到查询信息,就会根据前面提到的可见性比较算法,沿着这个undo log找到最新可见的数据返回。
总结
1、一般我们认为MVCC有下面几个特点:
每行数据都存在一个版本,每次数据更新时都更新该版本
修改时Copy出当前版本, 然后随意修改,各个事务之间无干扰
保存时比较版本号,如果成功(commit),则覆盖原记录, 失败则放弃copy(rollback)
就是每行都有版本号,保存时根据版本号决定是否成功,听起来含有乐观锁的味道, 因为为这看起来正是,在提交的时候才能知道到底能否提交成功
2、而InnoDB实现MVCC的方式是:
事务以排他锁的形式修改原始数据
把修改前的数据存放于undo log,通过回滚指针与主数据关联
修改成功(commit)啥都不做,失败则恢复undo log中的数据(rollback)
感谢
创作来自:https://segmentfault.com/a/1190000012650596
还有一个可爱up主小姐姐:https://www.bilibili.com/video/BV1Vk4y1k7KQ?t=455

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献8条内容

所有评论(0)