pandas 批量修改列名_Pandas增删改查的详细总结
·
Numpy和Pandas是Python进行数据分析的基础库,当初学习Pandas就买了《利用Python进行数据分析》这本书来看,书非常棒,既深入又通俗,而且这本书的原作者就是Pandas库的主要创建者之一。Pandas最常用的两种数据结构是Series和DataFrame,Series是一维数据,类似一维数组,DataFrame是二维数据,类似Excel表格,这两种数据结构都包含数据标签index,在没有设置index时,系统会自动分配(0到N-1)。本文使用Jupyter notebook进行编程测试。
创建/读取Series和DataFrame数据
import pandas as pd
import numpy as np
#创建数据
data_series = pd.Series([1,2,3,4])    #列表生成Series
data_pd = pd.DataFrame({'col1':[1,2,3,4],'col2':[5,6,7,8]})  #可用包含等长列表(数组/Series)的字典生成DataFrame
#设置索引
data_series = pd.Series([1,2,3,4],index=['a','b','c','d'])    #列表生成Series
data_pd = pd.DataFrame({'col1':[1,2,3,4],'col2':[5,6,7,8]},index=['a','b','c','d'])
#分别查看值和索引
print(data_series.index)
print(data_pd.index)
print(data_series.values)   #一维数组
print(data_pd.values)       #二维数组


#读取其他数据文件
df_excel = pd.read_excel('file.xlsx',sheet_name='Sheet1') #读入excel文件
df_csv = pd.read_csv('file.csv')  #读入csv文件
df_json = pd.read_json('file.json')

#输出数据文件
df.to_csv('save_file.csv')
df.to_excel('save_file.xlsx')
df.to_json('save_file.json')
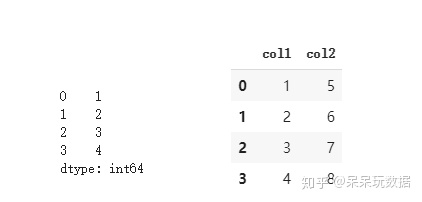
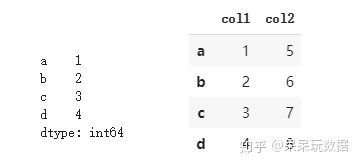
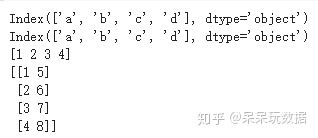
索引对象
Pandas的索引对象用来存储轴标签(包括行索引和列索引),索引对象不可以修改,类似于数组和集合,与集合不同的是索引可以重复。
#输出DataFrame的索引对象
print('data_pd.columns: ',data_pd.columns)
print('data_pd.index: ',data_pd.index)

#生成索引对象
index = pd.Index(np.arange(3))

#判断元素是否存在索引中
1 in index   #返回True
4 in index   #返回False

#重置索引reindex
data_pd.reindex(['a','c','b','d','h','f'])  #数据按照新索引进行排列,如果索引不存在为NaN
data_pd.reindex(columns = ['col3','col2','col1'])  #重置列索引
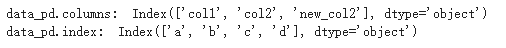
查找数据
#查找列数据
data_pd['col1']  #查找一列
data_pd[['col1','col2']]  #查找多列

#切片查找数据
data_pd[:2]  #得到前2行的数据

#利用索引符号loc查找数据(轴标签)
data_pd.loc['c']        #查找c行
data_pd.loc['c','col2'] #可传入两个参数,行标签和列标签,查找c行col2列的数据
data_pd.loc[['c','d'],'col2'] #标签可传入列表作为参数选择多列多行
data_pd.loc[:'c','col2']  #loc可进行切片选择行列

#利用索引符号iloc查找数据(整数标签)
data_pd.iloc[2]        #查找第3行,c行
data_pd.ioc[2,1] #可传入两个参数,行整数标签和列整数标签,查找第3行第2列的数据
data_pd.iloc[[2,3],1] #标签可传入多个整数选择多列多行
data_pd.iloc[:2,1]  #iloc可进行切片选择行列

#按条件查找数据
data_pd[data_pd['col1']>2]   #查找col1大于2的数据
data_pd[data_pd<2] = 0  #将数据中小于2的都赋值为0

#多条件查找,&连接条件,选col1列大于2,col2列小于8的数据
data_new = data_pd[(data_pd['col1']>2)&(data_pd['col2']<8)]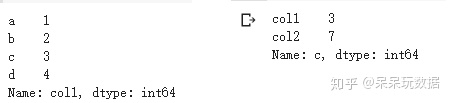
修改数据
#插入新行
data_pd['new_col1'] = 5    #生成一行标量5
data_pd['new_col2'] = np.arange(4)   #生成一行从0到3

#修改列名 rename函数
data_pd.rename(columns = {oldname1 : newname1,oldname2 : newname2,})  #传入字段修改
data_pd.renam(columns = lambda x : x.replace("col",""))  #传入lambda函数批量修改

#按条件修改数据
data.loc[data['order_mark'].isnull(),'order_seq'] = np.nan将数组和列表赋值给data_frame时,长度必须一致,而将series赋值给data_frame的一列会按照索引重新排列,不匹配的索引则为缺失值NaN。
删除数据
#删除列del,直接在原数据上删除
del data_pd['new_col1']

#轴向上删除用drop,drop函数会返回一个新对象,如果要修改原数据可加上参数inplace = True
data_pd.drop('c')    #删除c行
data_pd.drop(['col1','new_col2'],axis=1)  #利用axis = 1 或者axis = 'columns'
data_pd.drop(['col1','new_col2'],axis=1,inplace=True) #在原数据上删除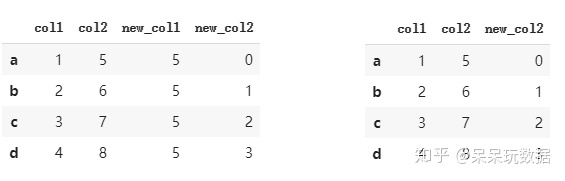
数据排序
对DataFrame数据排序,既可以按照行列标签排序,也可以按照值进行排序,函数分别是sort_index和sort_values,排序后会生成排完序的新对象,而不是改变原来的数据。
#创建新data
data_pd2 = pd.DataFrame({'two':[1,5,7,4],'one':[3,5,7,8]},index=['b','a','d','c'])
#排序
data_pd2.sort_index()  #按标签引排序
data_pd2.sort_index(axis=1)  #按列标签排序
data_pd2.sort_values('one')
data_pd2.sort_values(by=['one','two'])   #还可传入列表序列进行多个字段排序
data_pd2.sort_values(['one','two'],ascending=False)  #默认升序,加上Ascending=False降序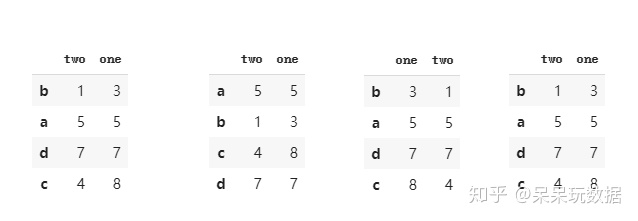
用rank()函数可对dataframe和series进行排名,pandas默认相同值取平均序号,可以传入参数更改。
#排序
data_pd2.rank()  #每列数据按照从小到大得到序号
data_pd2.rank(axis=1) #可按列对每行数据进行排序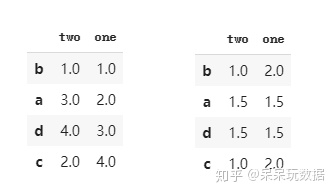
数据连接
Pandas连接数据主要是通过merge()函数和concat()函数,merge()函数的连接类似于sql数据库中的join,而concat是在轴向上进行连接
#merge连接
pd.merge(df1,df2,on='key',how='left') #on表示连接列,how选择连接方式
pd.merge(df1,df2,left_on='lkey',right_on='rkey',how='left') #当连接列名不同分别指定

#concat
pd.concat([s1,s2])  #纵向连接,当s1和s2索引不重叠时,可以直接拼接,相当于sql中的union

pd.concat([s1,s2],axis = 1)  #横向连接,默认外连接,以行索引为连接字段
常用统计方法
#统计某一列值的频率
data_pd['columns'].value_counts()
北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献6条内容

所有评论(0)