mongodb-erlang文档阅读+源码解析
mongodb-erlang 是一个非官方的MongoDB客户端,提供了Erlang语言版本的MongoDB驱动。本文旨在通过对其文档和源码的分析探索其使用方法,解析其工作方式。
我们假定读者已经有了如下的知识储备:
- Erlang语言的语法和OTP的的基本使用方法
- MongoDB的基本用法
- Erlang进程池管理项目poolboy的基本用法
文档解析
我们从文档可以得知,该项目有两个api模块:mc_worker_api.erl和mongo_api.erl。mc_worker_api.erl会建立单独的连接与MongoDB进行交互,mongo_api.erl则会建立连接池,管理与MongoDB的多个连接。
文档还提到了,如果要在官方提供的mongos(MongoDB分片集群路由)和通过mongo_api.erl连接shard(分片)之间进行选择,建议使用mongos + mc_worker_api.erl的组合。
连接
使用mc_worker_api:connect/1连接MongoDB数据库:
Database = <<"test">>.
{ok, Connection} = mc_worker_api:connect ([{database, Database}]).
建立连接时可以传递一些参数,具体的参数见文档,为了方面后面对源码的理解,我们来分析其中几个参数:
- login和password:不解释。
- w_mode:如果设置为
safe|{safe,GetLastErrorParams},进程会在每次写入后发送getLastError请求,如果MongoDB报告写入错误,则剩余的写入会被中断并返回{failure, {write_failure, Reason}}错误;如果设置为unsafe,则假定每次写入必定成功,写入失败会被忽略。 - next_req_fun:会在进程每次向MongoDB发送请求后执行,可以用来优化进程池性能(It can be use to optimise pool usage)。如果使用的是poolboy,可以用
{next_req_fun, fun() -> poolboy:checkin(?DBPOOL, self()) end}使得工作进程(worker)在发送请求后马上被进程池回收(poolboy的进程池启动策略需要是{strategy,fifo})。
关于GetLastErrorParams,在MongoDB关于getLastError的文档写到:
Changed in version 2.6: A new protocol for write operations integrates write concerns with the write operations, eliminating the need for a separate getLastError.
就是说getLastError已经在2.6之后的Database Command已经用不上了,但在MongoDB Wire Protocol里还保留着,这点值得留意。
写入
这几种都属于写方法。可以使用mc_worker_api:insert,mc_worker_api:update和mc_worker_api:delete完成数据库写入操作。
插入maps:
Collection = <<"test">>.
mc_worker_api:insert(Connection, Collection, #{<<"name">> => <<"Yankees">>, <<"home">> =>
  #{<<"city">> => <<"New York">>, <<"state">> => <<"NY">>}, <<"league">> => <<"American">>}),
删除文档,需要指定Selector:
mc_worker_api:delete(Connection, Collection, Selector).
读取
使用mc_worker_api:find,mc_worker_api:find_one读取数据:
{ok, Cursor} = mc_worker_api:find(Connection, Collection, Selector)
find_one和find的不同在于,前者直接返回查询结果(文档),后者返回一个游标(cursor)进程的pid,可以在mc_cursor.erl模块中查看游标的用法:
Result = mc_cursor:next(Cursor),
mc_cursor:close(Cursor),
除了selector,还可传入projector过滤查询结果:
mc_worker_api:find_one(Connection, Collection, {}, #{projector => #{<<"value">> => true}).
更新
使用mc_worker_api:update和$set进行更新,不多解释:
Command = #{<<"$set">> => #{
    <<"quantity">> => 500,
    <<"details">> => #{<<"model">> => "14Q3", <<"make">> => "xyz"},
    <<"tags">> => ["coats", "outerwear", "clothing"]
}},
mc_worker_api:update(Connection, Collection, #{<<"_id">> => 100}, Command),
创建索引
使用mc_worker_api:ensure_index/3创建索引。
mc_worker_api:ensure_index(Connection, Collection, #{<<"key">> => #{<<"index">> => 1}}).  %simple
mc_worker_api:ensure_index(Connection, Collection, #{<<"key">> => #{<<"index">> => 1}, <<"name">> => <<"MyI">>}).  %advanced
mc_worker_api:ensure_index(Connection, Collection, #{<<"key">> => #{<<"index">> => 1}, <<"name">> => <<"MyI">>, <<"unique">> => true, <<"dropDups">> => true}).  %full
索引的参数有如下:
- name: index key
- unique: 索引是否唯一,若数据有不符合唯一的则索引建立失败。unique默认false
- dropDups: 如果unique为true且额外指定了dropDups,则只会保留第一条数据,其他不不符合唯一索引的数据会被删除。dropDups默认为false。
再闲聊几句,参数dropDups在2.7.5版本之后已经被弃用了,详见stackoverflow的讨论,这个参数这个参数应该是没用的。
其他
其他指令:对于模块没用提供方法的指令,可以使用mc_worker_api:command直接执行。
超时:通过设置application环境变量参数mc_worker_call_timeout可以设置mc_worker(实际发送数据库请求的进程)的超时时间。cursor进程的超时时间可以在函数mc_cursor:next/2, mc_cursor:take/3, mc_cursor:reset/2中设定。
进程池:如果需要简单的进程池管理,可以使用修改后的poolboy,将mc_worker_api作为worker。如果需要管理分片(shard)并且自动发现MongoDB的拓扑结构,使用mongo_api。
mongo_api的使用
mongo_api除了连接,使用方式和mc_worker_api基本一致。
通过调用mongo_api:connect连接MongoDB,因为连接的是多台服务器,所以传入的是Host列表:
{ok, Topology} = mongo_api:connect(Type, Hosts, Options, WorkerOptions)
如果只部署了一台服务器,可以只传入一个hostname和port,或者一个包含single的tuple:
“hostname:27017”
{ single, “hostname:27017” }
如果要连接到一个replica set(复制集):
{ rs, <<“ReplicaSetName”>>, [ “hostname1:port1”, “hostname2:port2”] }
连接到一个shared cluster(分片集群):
{ sharded, [“hostname1:port1”, “hostname2:port2”] }
希望部署结构被自动验证(?):
{ unknown, [“hostname1:port1”, “hostname2:port2”] }
WorkerOptions的参数有很多,详见源文档,此处不做过多展开。
大概的用法我们都清楚了,接下来我们进入源码的探究。
源码探究
项目结构不算复杂,每个文件夹用途如下:
- api:提供了供应用程序使用的API。
- connection:包含了与MongoDB服务器进行交互的主要逻辑。
- main:包含application,mongo client监控树,mongo id服务器的启动。
- mongoc:mongo client
- support:包含一些工具函数。
交互的接口:mc_worker_api
作为程序简单而基本的入口,我们先研究mc_worker_api.erl:
建立连接过程的图示如下:
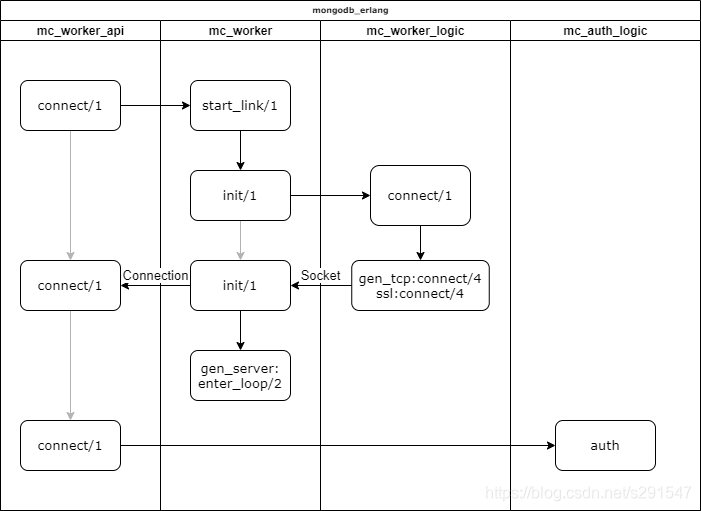
逻辑比较简单,客户端程序通过mc_worker_api:connect/1发起连接,会新建mc_worker进程(gen_server),并在进程内部调用TCP/SSL方法连接MongoDB数据库服务器。连接完成后进行异步认证。
接下来看一下mc_worker_api如何处理数据库CRUD请求。我们发现,所有的写入请求都会调用mc_worker_api:command/3:
insert
command(DB, Connection, {<<"insert">>, Coll, <<"documents">>, Converted, <<"writeConcern">>, WC})
update
command(DB, Connection, {<<"update">>, Coll, <<"updates">>,
        [#{<<"q">> => Selector, <<"u">> => Converted, <<"upsert">> => Upsert, <<"multi">> => MultiUpdate}],
        <<"writeConcern">>, WC}).
delete
command(DB, Connection, {<<"delete">>, Coll, <<"deletes">>,
        [#{<<"q">> => Selector, <<"limit">> => N}], <<"writeConcern">>, WC}).
command方法的工作方式如下图:
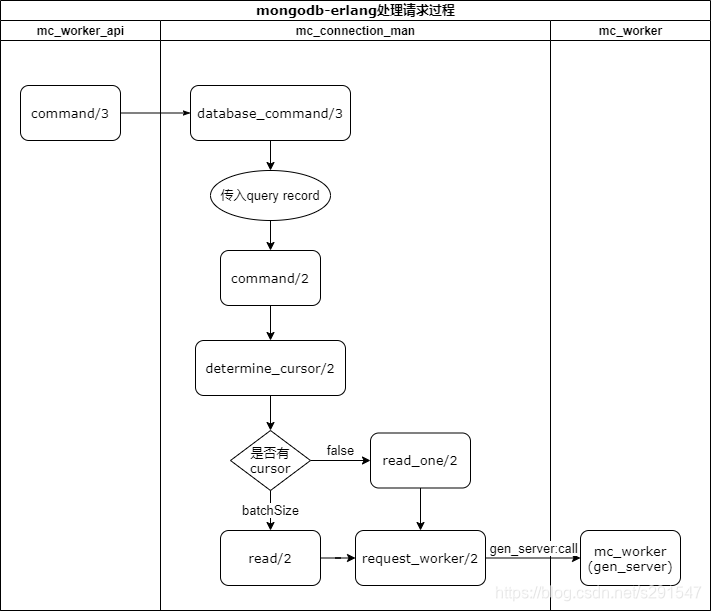
展开来看,我们先看看mc_worker_api:command/3的源码:
%% @doc Execute given MongoDB command on specific database and return its result.
-spec command(database(), pid(), selector()) -> {boolean(), map()} | {ok, cursor()}.
command(undefined, Connection, Command) ->
    command(Connection, Command);
command(Db, Connection, Command) ->
    mc_connection_man:database_command(Connection, Db, Command).
我们比较在意selector()的结构,查看mongo_types.hrl,可以发现:
-type selector() :: map() | bson:document().
在mc_connection_man:database_command/3中,在进一步处理之前,会把传入的selector打包成#‘query’{}结构:
database_command(Connection, Database, Command) ->
  command(Connection,
    #'query'{
      collection = <<"$cmd">>,
      selector = Command,
      database = Database
    }).
在mc_connection_man:command/2里,会判断是否需要建立curso:
command(Connection, Query = #query{selector = Cmd}) ->
  case determine_cursor(Cmd) of
    false ->
      Doc = read_one(Connection, Query),
      process_reply(Doc, Query);
    BatchSize ->
      case read(Connection, Query#query{batchsize = -1}, BatchSize) of
        [] -> [];
        {ok, Cursor} when is_pid(Cursor) ->
          {ok, Cursor}
      end
  end;
read方法先请求MongoDB数据库,数据库会返回cursor_id,然后调用mc_cursor:start_link/4建立mc_cursor进程,该进程会保存cursor_id。除了cursor_id,该进程还有一个队列,用来保存请求数据库返回的文档列表,调用mc_cursor:next/1等操作实际上是从该队列获取文档。如果队列空了,mc_cursor进程发送getmore请求,获取更多的文档。可以通过mc_cursor:next/1等方法操作cursor,也可以用mc_cursor:close/1关闭一个cursor。
实际上,无论是客户端进程还是mc_cursor,所有的请求都会发送到mc_worker上。
交互的核心:mc_worker
mc_worker进程是一个gen_server,是与数据库服务器交互的核心。mc_worker初始化的时候会建立与MongoDB的TCP连接,并将socket保存在state中。
在mc_worker_api.erl中调用mc_worker:start_link/1启动mc_worker进程。值得注意的是,mc_worker进程初始化的时候和普通的gen_server有一些不同:
init(Options) ->
    case mc_worker_logic:connect(Options) of
        {ok, Socket} ->
            ... % 省略一些初始化工作
            proc_lib:init_ack({ok, self()}),
            gen_server:enter_loop(?MODULE, [],#state{});
        Error ->
            proc_lib:init_ack(Error)
    end.
不同于直接返回state,mc_worker使用proc_lib:init_ack/1返回进程状态(给通过以start_link方式连接的进程),然后gen_server:enter_loop/3进入gen_server循环。
mc_worker进程工作方式如下图所示:
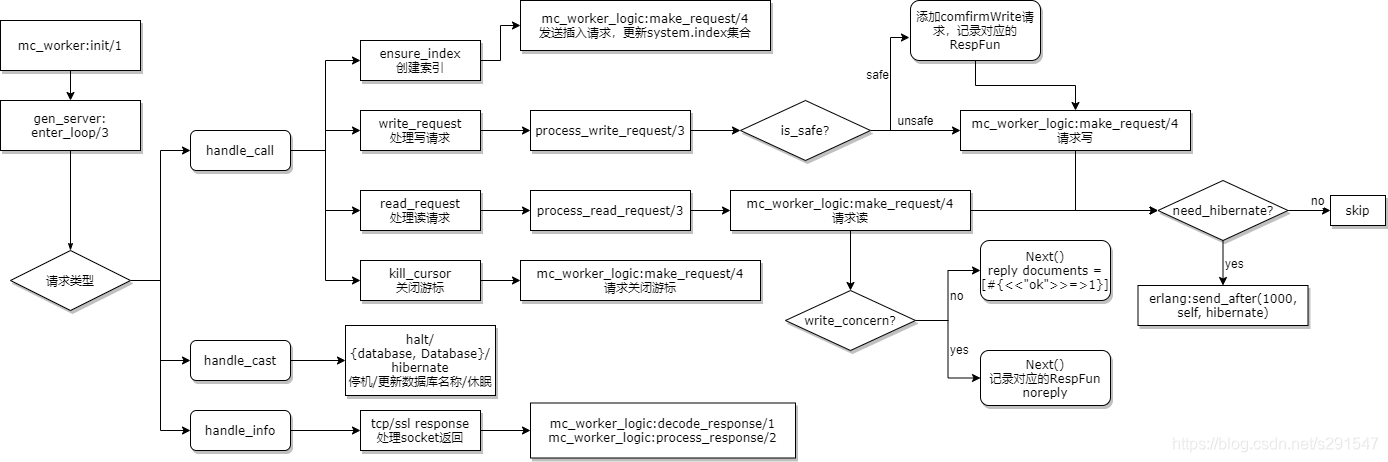
mc_worker接到请求后,会判断请求是WRITE(insert, update,delete)还是READ(‘query’,getmore),然后分别调用mc_worker:process_write_request/2和mc_worker:process_read_request/2,这两个函数的返回值也作为handle_call的返回。
看一下process_read_request/3的实现:
process_read_request(Request, From, State) ->
    ...
    {ok, PacketSize, Id} = mc_worker_logic:make_request(Socket, NetModule, Database, UpdReq),
    UState = need_hibernate(PacketSize, State),
    case get_write_concern(Selector) of
        {<<"w">>, 0} -> %no concern request
            Next(),
            {reply, Reply, UState};
        _ ->  %ordinary request with response
            Next(),
            RespFun = mc_worker_logic:get_resp_fun(UpdReq, From),  % save function, which will be called on response
            URStorage = RequestStorage#{Id => RespFun},
            {noreply, UState#state{request_storage = URStorage}}
    end.
代码在不影响理解的情况下有省略。可以看到对于下面那种情况,mc_worker并没有立即返回,而是将每次请求的ID和RespFun保存到state里。
一般来说,客户端通过gen_server:call给gen_server发送请求后会被阻塞,gen_server会在回调结构handle_call/3中返回{reply, Reply, State},其中Relpy作为gen_server:call/3的返回值返回给客户端。如果gen_server返回{noreply, State},那么必须要在适合的时候调用gen_server:reply/2给客户端返回一个值。
查看mc_worker_logic:get_resp_fun/2,可以发现gen_server:reply/2就在RespFun里面:
-spec get_resp_fun(#query{} | #getmore{} | #insert{} | #update{} | #delete{}, pid()) -> fun().
get_resp_fun(Read, From) when is_record(Read, query); is_record(Read, getmore) ->
  fun(Response) -> gen_server:reply(From, Response) end;
get_resp_fun(Write, From) when is_record(Write, insert); is_record(Write, update); is_record(Write, delete) ->
  process_write_response(From).
那么什么时候会调用RespFun呢?答案是当mc_worker收到socket返回的网络数据的时候:
handle_info({Net, _Socket, Data}, State = #state{request_storage = RequestStorage}) when Net =:= tcp; Net =:= ssl ->
    Buffer = <<(State#state.buffer)/binary, Data/binary>>,
    {Responses, Pending} = mc_worker_logic:decode_responses(Buffer),
    UReqStor = mc_worker_logic:process_responses(Responses, RequestStorage),
    UState = need_hibernate(byte_size(Buffer), State),
    {noreply, UState#state{buffer = Pending, request_storage = UReqStor}};
process_responses(Responses, RequestStorage) ->
  lists:foldl(
    fun({Id, Response}, UReqStor) ->
      case maps:find(Id, UReqStor) of
		 ...
          try Fun(Response) % call on-response function
		 ...
      end
    end, RequestStorage, Responses).
就是在这里调用了RespFun。
数据的解码编码
在进入源码之前,我们要先了解一下MongoDB Wire Protocol。
MongoDB Wire Protocol是一种基于Socket的、请求-响应式的协议,通过该协议客户端通过常规TCP/IP协议与数据库服务器交流。
MongoDB Wire Protocal的结构体由两部分组成:MsgHeader和其他部分。
MsgHeader即为Standard Message Header,结构如下:
struct MsgHeader {
    int32   messageLength; // total message size, including this
    int32   requestID;     // identifier for this message
    int32   responseTo;    // requestID from the original request
                           //   (used in responses from db)
    int32   opCode;        // request type - see table below for details
}
其中的opCode是请求操作的类型,例如OP_UPDATE是2001,代表更新操作;OP_INSERT是2002,代表插入操作。具体的操作码见文档。
一个完整的请求除了MsgHeader,还包括其他必要的请求参数。其他请求参数会因为opCode的不同而有所不同。以OP_UPDATE为例:
struct OP_UPDATE {
    MsgHeader header;             // standard message header
    int32     ZERO;               // 0 - reserved for future use
    cstring   fullCollectionName; // "dbname.collectionname"
    int32     flags;              // bit vector. see below
    document  selector;           // the query to select the document
    document  update;             // specification of the update to perform
}
其中selector和update为BSON类型。
清楚了请求的结构,我们只需要照猫画虎构造请求,然后通过TCP/IP协议发给数据库服务器就行了。
编码
mc_worker最后都要通过mc_worker_logic:make_request/4向MongoDB服务器发送请求,我们进入mc_worker_logic.erl来具体考察一下发送的过程。
make_request(Socket, NetModule, Database, Request) ->
  {Packet, Id} = encode_request(Database, Request),
  {NetModule:send(Socket, Packet), iolist_size(Packet), Id}.
Packet就是打包后的请求,根据NetModule的不同,选择tcp:send/2或者ssl:send/2发送。
encode_request(Database, Request) ->
  RequestId = mongo_id_server:request_id(),
  Payload = mongo_protocol:put_message(Database, Request, RequestId),
  {<<(byte_size(Payload) + 4):32/little, Payload/binary>>, RequestId}.
可以看到:Packet = <<(byte_size(Payload) + 4):32/little, Payload/binary>>。
看一下mongo_protocol.put_message/3怎么打包update请求:
put_message(Db, #update{collection = Coll, upsert = U, multiupdate = M, selector = Sel, updater = Up}, _RequestId) ->
  <<?put_header(?UpdateOpcode),
  ?put_int32(0),
  (bson_binary:put_cstring(dbcoll(Db, Coll)))/binary,
  ?put_bits32(0, 0, 0, 0, 0, 0, bit(M), bit(U)),
  (bson_binary:put_document(Sel))/binary,
  (bson_binary:put_document(Up))/binary>>;
看得出来和OP_UPDATE的结构是一样的。这个函数里面用到了很多宏和bson_binary.erl的方法来处理二进制数据。对其他操作同理,这里不展开了。仔细观察的话会发现?put_header宏的返回与Standard Message Header结构对不上:
-define(put_header(Opcode), ?put_int32(_RequestId), ?put_int32(0), ?put_int32(Opcode)).
发现少了32位的长度,实际上长度是在整个Payload打包好后在mc_worker_logic:encode_request/2后面加上去的:
<<(byte_size(Payload) + 4):32/little, Payload/binary>>
MongoDB服务器只会对OP_QUERY和OP_GET_MORE操作返回结果,其他操作如果想要知道成功需要发送getLastError指令。
解码
MongoDB服务器会返回OP_REPLY响应OP_QUERY和OP_GET_MORE请求,OP_REPLY结构如下:
struct {
    MsgHeader header;         // standard message header
    int32     responseFlags;  // bit vector - see details below
    int64     cursorID;       // cursor id if client needs to do get more's
    int32     startingFrom;   // where in the cursor this reply is starting
    int32     numberReturned; // number of documents in the reply
    document* documents;      // documents
}
同样的,知道了返回的结构,我们只需要把返回的消息按照结构解析。看一下在mc_worker_logic:decode_responses里怎么解析获取的网络数据包:
decode_responses(<<Length:32/signed-little, Data/binary>>, Acc) when byte_size(Data) >= (Length - 4) ->
  PayloadLength = Length - 4,
  <<Payload:PayloadLength/binary, Rest/binary>> = Data,
  {Id, Response, <<>>} = mongo_protocol:get_reply(Payload),
  decode_responses(Rest, [{Id, Response} | Acc]);
decode_responses(Data, Acc) ->
  {lists:reverse(Acc), Data}.
将网络包根据长度进行拆分,因为可能有多个网络包。拆分后的网络包放入mongo_protocol:get_reply/1继续解析,到了这里按照OP_REPLY的结构进行模板匹配,就能获取数据了。
-spec get_reply(binary()) -> {requestid(), reply(), binary()}.
get_reply(Message) ->
  <<?get_header(?ReplyOpcode, ResponseTo),
  ?get_bits32(_, _, _, _, AwaitCapable, _, QueryError, CursorNotFound),
  ?get_int64(CursorId),
  ?get_int32(StartingFrom),
  ?get_int32(NumDocs),
  Bin/binary>> = Message,
  {Docs, BinRest} = get_docs(NumDocs, Bin, []),
  Reply = #reply{
    cursornotfound = bool(CursorNotFound),
    queryerror = bool(QueryError),
    awaitcapable = bool(AwaitCapable),
    cursorid = CursorId,
    startingfrom = StartingFrom,
    documents = Docs
  },
  {ResponseTo, Reply, BinRest}.
最后返回#reply{}结构,mc_worker获取结构之后,调用mc_worker_logic:process_responses/2,寻找保存对应的RespFun,执行RespFun(Response)将数据返回给发起请求的客户端进程。
尾声
这篇算是个人的学习笔记,加深了自己对MongoDB和Erlang的认识。虽然题目是源码解析,实际上本文解析的基本都是connection文件夹内的代码,关于mongoc部分的并没有涉及。mongodb-erlang作为GitHub上star和fork最多的MongoDB Erlang版本驱动,截止当前有51个issue,其中大部分是bug报告,代码的最后一次merge也停留在了2018年10月。看来Erlang社区的发展仍然任重道远……

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)