推荐系统实践-新闻推荐 Task1 Baseline
本篇为Datawhale组队学习笔记,Datawhale推荐系统实践
天池比赛地址:零基础入门推荐系统
数据概况:
articles_emb.csv
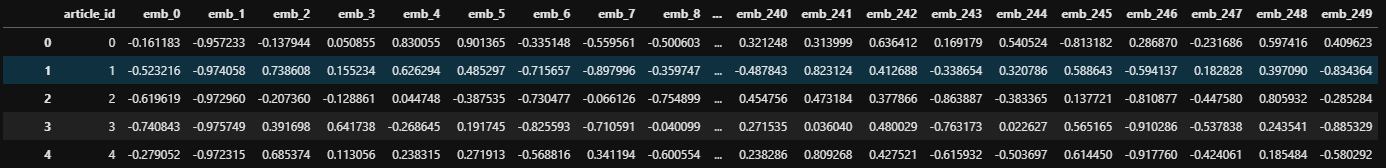 364046 rows × 251 columns
一共364046篇文章,每篇文章表示为250维的向量。
articles.csv
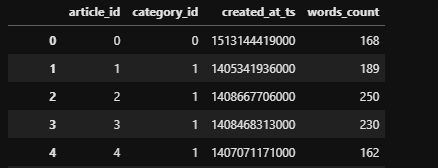
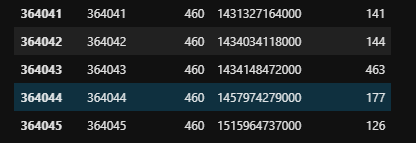 所有文章分为461个钟类,文章时间可以根据根据数的大小排序,每篇文章有字数统计
testA_click_log.csv
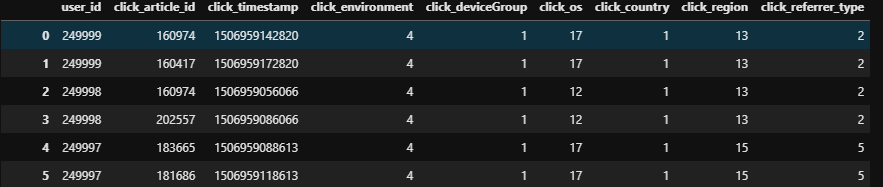
测试集A,用户点击行为记录,共计50000个用户
train_click_log.csv
训练集用户点击行为记录,共计200000个用户。
Baseline
该部分分析代码,完整代码见Datawhale推荐系统实践
该Baseline采用基于ItemCF的方法,通过用户点击行为记录新闻间的相似度,推荐相似度最高的。
数据读取
def get_all_click_df(data_path='./data_raw/', offline=True):
    if offline:
        all_click = pd.read_csv(data_path + 'train_click_log.csv')
    else:
        trn_click = pd.read_csv(data_path + 'train_click_log.csv')
        tst_click = pd.read_csv(data_path + 'testA_click_log.csv')

        all_click = trn_click.append(tst_click)

    all_click = all_click.drop_duplicates((['user_id', 'click_article_id', 'click_timestamp']))
    return all_click
读数据的时候可以把测试集训练集一起读入,因为测试集没有标签,但是也可以利用测试集的用户行为信息。这里我们采用ItemCF的方法,需要构建每个用户的item列表,也就是访问新闻的记录。因此只需user_id和click_article_id就可以了。click_timestamp其实也可以不要。
相似度计算
def itemcf_sim(df):
    """
        文章与文章之间的相似性矩阵计算
        :param df: 数据表
        :item_created_time_dict:  文章创建时间的字典
        return : 文章与文章的相似性矩阵
        思路: 基于物品的协同过滤(详细请参考上一期推荐系统基础的组队学习), 在多路召回部分会加上关联规则的召回策略
    """

    user_item_time_dict = get_user_item_time(df)

    # 计算物品相似度
    i2i_sim = {}
    item_cnt = defaultdict(int)
    for user, item_time_list in tqdm(user_item_time_dict.items()):
        # 在基于商品的协同过滤优化的时候可以考虑时间因素
        for i, i_click_time in item_time_list:
            item_cnt[i] += 1
            i2i_sim.setdefault(i, {})
            for j, j_click_time in item_time_list:
                if(i == j):
                    continue
                i2i_sim[i].setdefault(j, 0)

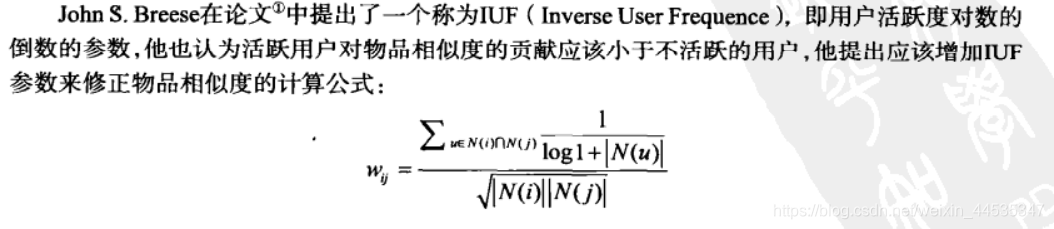
                i2i_sim[i][j] += 1 / math.log(len(item_time_list) + 1)

    i2i_sim_ = i2i_sim.copy()
    for i, related_items in i2i_sim.items():
        for j, wij in related_items.items():
            i2i_sim_[i][j] = wij / math.sqrt(item_cnt[i] * item_cnt[j])

    # 将得到的相似性矩阵保存到本地
    pickle.dump(i2i_sim_, open(save_path + 'itemcf_i2i_sim.pkl', 'wb'))

    return i2i_sim_
该计算相似度方法对应推荐系统实践中的公式
 原文理由:
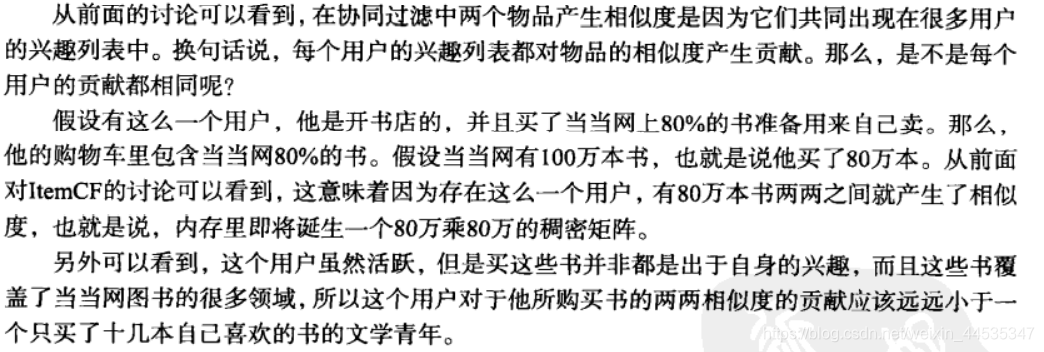 其实与计算平均流行度的时候,应该对流行度取log道理一样。用户活跃度,与物品流行度一样服从长尾分布,取log可以使平均值更稳定。
submit部分Pandas操作
本次是debug随机抽的10000条数据。
起始:recall_df
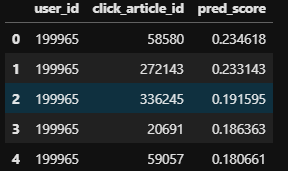
recall_df = recall_df.sort_values(by=['user_id', 'pred_score'])
recall_df.head()
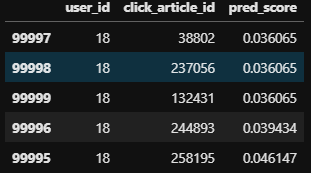
recall_df['rank'] = recall_df.groupby(['user_id'])['pred_score'].rank(ascending=False, method='first')
recall_df.head()
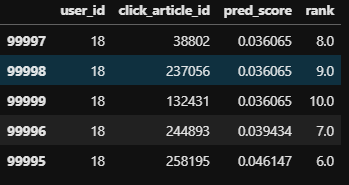
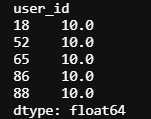
tmp = recall_df.groupby('user_id').apply(lambda x: x['rank'].max())
tmp.head()
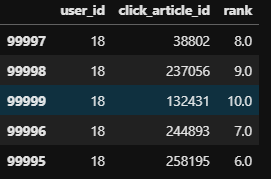
del recall_df['pred_score']
recall_df.head()
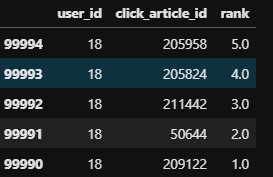
recall_df = recall_df[recall_df['rank'] <= 5]
recall_df.head()
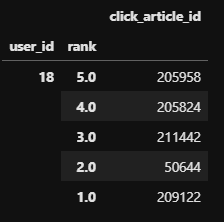
recall_df = recall_df.set_index(['user_id','rank'])
recall_df.head()
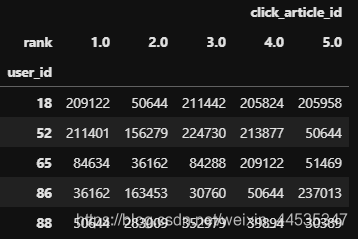
recall_df = recall_df.unstack(-1)
recall_df.head()
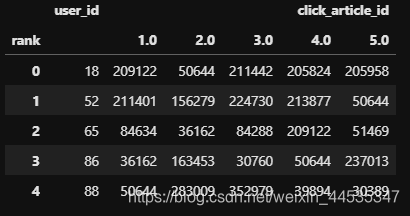
submit = recall_df.reset_index()
submit.head()
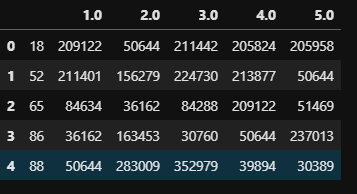
submit.columns.droplevel(0)

submit.columns = [int(col) if isinstance(col, int) else col for col in submit.columns.droplevel(0)]
submit.head()
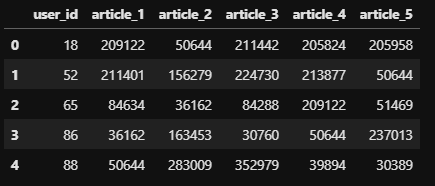
submit = submit.rename(columns={'': 'user_id', 1: 'article_1', 2: 'article_2',
                                                  3: 'article_3', 4: 'article_4', 5: 'article_5'})
submit.head()
总结
这个baseline是基于物品间的相似度的,计算相似度只利用了用户的访问行为序列,未利用地新闻本身之间地相关性(可以利用新闻的embedding向量)。也暂未利用访问时间顺序的信息。该Baseline得分为0.1026

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)