k8s利用statefulset部署kafka集群(依赖zookeeper)
最近在工作上调研k8s部署kafka集群的方案,以下配置和部署方案都是亲测可用,有问题可以评论或私我解决。
kafka需要依赖zookeeper
kafka的生产者与消费者需要在zookeeper中注册,不然消费者怎么知道生产者是否存活之类的哈哈。废话不多说,直接上干货!
本文用的是statefulset和动态存储部署zookeeper和kafka集群。
部署zookeeper的yaml
apiVersion: v1
kind: Service
metadata:
  name: zk-headless
  namespace: liulei
  labels:
    app: zk
spec:
  ports:
  - port: 2888
    name: server
  - port: 3888
    name: leader-election
  clusterIP: None   #指定无头服务,需要对外暴露自行创建一个service
  selector:
    app: zk
---
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: zk-pdb
  namespace: liulei
spec:
  selector:
    matchLabels:
      app: zk
  minAvailable: 2
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: zk     #指定的zookeeper名称会在kafka.yaml里面用来配置和kafka连接,会创建pod为zk-0,zk-1,zk-2......这里只创建了三个
  namespace: liulei
spec:
  selector:
    matchLabels:
      app: zk
  serviceName: zk-headless
  replicas: 3
  updateStrategy:
    type: RollingUpdate # K8s 会将 StatefulSet 管理的 pod 分批次逐步替换掉
  podManagementPolicy: OrderedReady # 设置为Parallel这样Pod的创建就不必等待,而是会同时创建、同时删除
  template:
    metadata:
      labels:
        app: zk
    spec:
      containers:
      - name: k8s-zk
        image: k8szk:1.0-3.4.10   #需要指定自己的镜像,可去阿里云上下载zookeeper镜像
        imagePullPolicy: Always
        resources:
          requests:
            memory: "1Gi"
            cpu: "1000m"
          limits:
            memory: "1Gi"
            cpu: "1000m"
        ports:
        - containerPort: 2181
          name: client
        - containerPort: 2888
          name: server
        - containerPort: 3888
          name: leader-election
        command:
        - sh
        - -c
        - "start-zookeeper \
          --servers=5 \
          --data_dir=/var/lib/zookeeper/data \
          --data_log_dir=/var/lib/zookeeper/data/log \
          --conf_dir=/opt/zookeeper/conf \
          --client_port=2181 \
          --election_port=3888 \
          --server_port=2888 \
          --tick_time=2000 \
          --init_limit=10 \
          --sync_limit=5 \
          --heap=512M \
          --max_client_cnxns=60 \
          --snap_retain_count=3 \
          --purge_interval=12 \
          --max_session_timeout=40000 \
          --min_session_timeout=4000 \
          --log_level=INFO"
        - "zkGenConfig.sh && exec zkServer.sh start-foreground"
        readinessProbe:
          exec:
            command:
            - sh
            - -c
            - "zookeeper-ready 2181"
          initialDelaySeconds: 10
          timeoutSeconds: 5
        livenessProbe:
          exec:
            command:
            - sh
            - -c
            - "zookeeper-ready 2181"
          initialDelaySeconds: 10
          timeoutSeconds: 5
        imagePullPolicy: IfNotPresent
        volumeMounts:
        - name: zookeeper-pvc
          mountPath: /var/lib/zookeeper
      securityContext:
        runAsUser: 1000
        fsGroup: 1000
  volumeClaimTemplates:
  - metadata:
      name: zookeeper-pvc
      labels:
        type: stateful
    spec:
      accessModes: [ "ReadWriteMany" ]
      storageClassName: storageclass-default   #需要指定你自己的动态存储类名
      resources:
        requests:
          storage: 1Gi
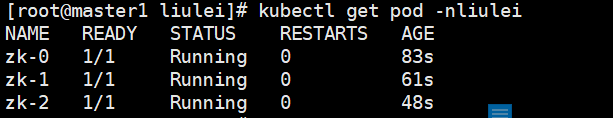
待zookeeper集群创建成功后验证zookeeper集群(注意修改自己的名称空间 -n后面参数):
命令:[root@master1 liulei]# for i in 0 1 2; do kubectl exec zk-$i -n liulei -- hostname; done
结果:
zk-0
zk-1
zk-2
命令:[root@master1 liulei]# for i in 0 1 2; do echo "myid zk-$i";kubectl exec zk-$i -nliulei -- cat /var/lib/zookeeper/data/myid; done
结果:
myid zk-0
1
myid zk-1
2
myid zk-2
3
命令:[root@master1 liulei]# for i in 0 1 2; do kubectl exec zk-$i -nliulei -- hostname -f; done
结果:
zk-0.zk-headless.liulei.svc.cluster.local
zk-1.zk-headless.liulei.svc.cluster.local
zk-2.zk-headless.liulei.svc.cluster.local
部署kafka
apiVersion: v1
kind: Service
metadata:
  name: kafka-svc
  namespace: liulei
  labels:
    app: kafka
spec:
  ports:
  - port: 9093
    name: server
  clusterIP: None   #创建无头服务,如果需要对外暴露端口可自行创建service
  selector:
    app: kafka
---
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: kafka-pdb
  namespace: liulei
spec:
  selector:
    matchLabels:
      app: kafka
  minAvailable: 2
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: kafka
  namespace: liulei
spec:
  selector:
    matchLabels:
      app: kafka
  serviceName: kafka-svc
  replicas: 3
  template:
    metadata:
      labels:
        app: kafka
    spec:
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchExpressions:
                  - key: "app"
                    operator: In
                    values:
                    - kafka
              topologyKey: "kubernetes.io/hostname"
        podAffinity:
          preferredDuringSchedulingIgnoredDuringExecution:
             - weight: 1
               podAffinityTerm:
                 labelSelector:
                    matchExpressions:
                      - key: "app"
                        operator: In
                        values:
                        - zk
                 topologyKey: "kubernetes.io/hostname"
      terminationGracePeriodSeconds: 300
      containers:
      - name: k8skafka
        imagePullPolicy: Always
        image: registry.cn-hangzhou.aliyuncs.com/ccgg/k8skafka:v1  #可自行去阿里云拉去对应镜像
        resources:
          requests:
            memory: "1Gi"
            cpu: "1000m"
          limits:
            memory: "1Gi"
            cpu: "1000m"
        ports:
        - containerPort: 9093
          name: server
        command:
        - sh
        - -c
        - "exec kafka-server-start.sh /opt/kafka/config/server.properties --override broker.id=${HOSTNAME##*-} \
          --override listeners=PLAINTEXT://:9093 \
          --override zookeeper.connect=zk-0.zk-headless.liulei.svc.cluster.local:2181,zk-1.zk-headless.liulei.svc.cluster.local:2181,zk-2.zk-headless.liulei.svc.cluster.local:2181 \   #这里配置了与zookeeper进行连接,非常重要。格式为:pod名.zookeeper的service名.名称空间.svc.cluster.local:2181
          --override log.dir=/var/lib/kafka "
        env:
        - name: KAFKA_HEAP_OPTS
          value : "-Xmx512M -Xms512M"
        - name: KAFKA_OPTS
          value: "-Dlogging.level=INFO"
        volumeMounts:
        - name: kafka-data
          mountPath: /var/lib/kafka
        readinessProbe:
          exec:
           command:
            - sh
            - -c
            - "/opt/kafka/bin/kafka-broker-api-versions.sh --bootstrap-server=localhost:9093"
      securityContext:
        runAsUser: 1000
        fsGroup: 1000
  volumeClaimTemplates:
  - metadata:
      name: kafka-data
    spec:
      accessModes: [ "ReadWriteMany" ]
      storageClassName: storageclass-default   #需指定自己的动态存储类名
      resources:
        requests:
          storage: 1Gi
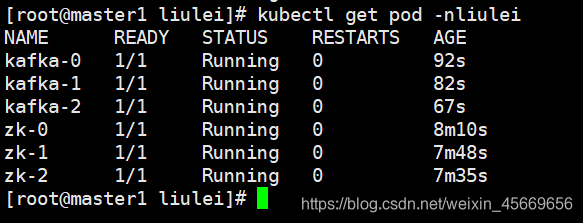
部署成功后查看pod情况:
验证kafka是否可用:
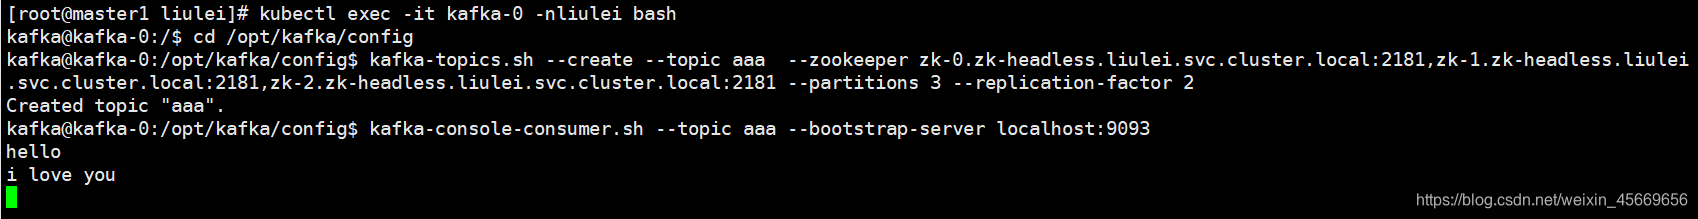
1、进入kafka-0命令: kubectl exec -it kafka-0 -nliulei bash
进入容器目录:cd /opt/kafka/config
2、创建一个名为aaa的topc命令:kafka-topics.sh --create --topic aaa --zookeeper zk-0.zk-headless.liulei.svc.cluster.local:2181,zk-1.zk-headless.liulei.svc.cluster.local:2181,zk-2.zk-headless.liulei.svc.cluster.local:2181 --partitions 3 --replication-factor 2
结果为:
Created topic “aaa”.
3、进入topic为aaa的生产者消息中心:kafka-console-consumer.sh --topic aaa --bootstrap-server localhost:9093
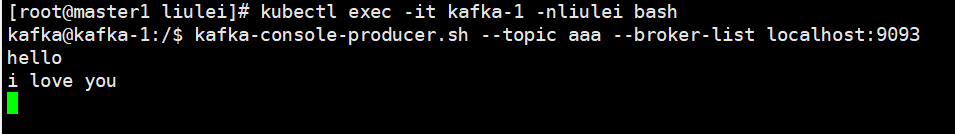
4、复制新的会话,进入另一个容器kafka-1:kubectl exec -it kafka-1 -nliulei bash
进入消费者,输入命令:kafka-console-producer.sh --topic aaa --broker-list localhost:9093
输入:
hello
i lovle you
回车后,可在生产者消息中心看到消息
总结
以上步骤和内容都是我一个一个坑踩过来的,亲测可用,如果本文对你有帮助的话可以给我点个赞支持一下吗,比心❤。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)