新书推荐 |《企业数据湖》
新书推荐
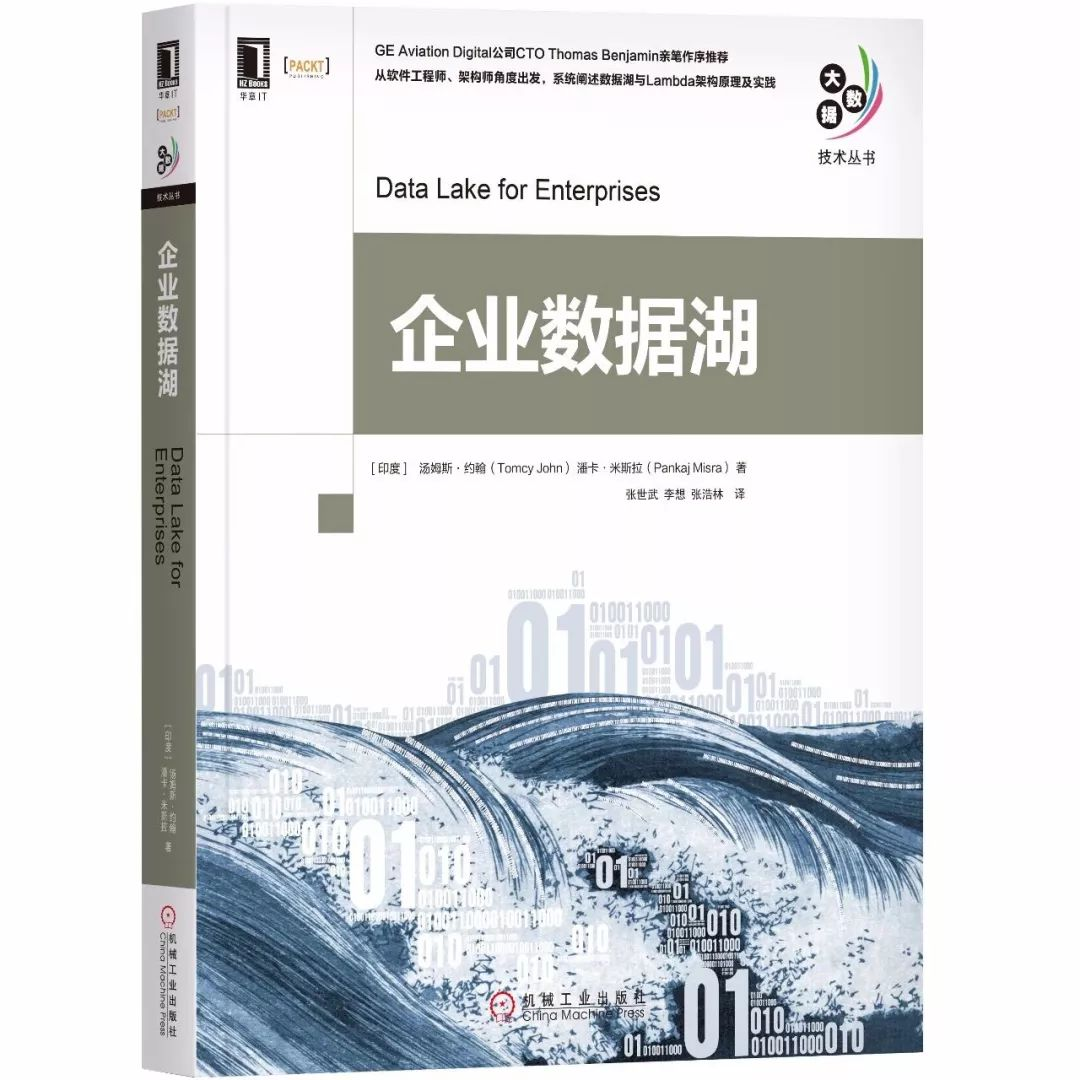
《企业数据湖》
 长按二维码
了解及购买
GE Aviaion Digital公司CTO Thomas Benjamin亲笔作序推荐
从软件工程师、架构师角度出发,手把手教你为企业构建自己的数据湖
编辑推荐
“数据湖”已经成为大数据行业的一个重要术语,它是数据科学家们获得有意义的洞察力的平台,这些洞察力可以被企业用来重新定义或改变它们的运营方式。Lambda架构作为大数据领域的杰出模式之一也应运而生。
本书旨在帮助你选择正确的大数据技术并使用Lambda架构模式来为企业构建自己的数据湖。全书主要分为三部分,第一部分介绍数据湖的概念、数据湖在企业中的重要性以及Lambda架构。第二部分深入研究使用Lambda架构构建数据湖所需的主要技术组件,介绍流行的大数据技术,如Apache Hadoop、Sqoop、Flume、Flink和Elasticsearch等。第三部分展示一些非常实用的数据湖落地建议,包括企业应如何建立一个真实的数据湖,以及提高数据湖运营效率所需的其他技术组件。第三部分最后还详细介绍了几个实际的用例,以及在企业内实现这些用例时应考虑的重要方面。
内容简介
本书主要分为三部分,第一部分介绍数据湖的概念、数据湖在企业中的重要性以及Lambda架构。第二部分深入研究使用Lambda架构构建数据湖所需的主要技术组件,介绍流行的大数据技术,如Apache Hadoop、Sqoop、Flume、Flink和Elasticsearch等。第三部分展示一些非常实用的数据湖落地建议,包括企业应如何建立一个真实的数据湖,以及提高数据湖运营效率所需的其他技术组件。第三部分最后还详细介绍了几个实际的用例,以及在企业内实现这些用例时应考虑的重要方面。
通过阅读本书,你将:
使用大数据技术构建企业级数据湖。
掌握Lambda架构的精髓,以及如何在企业内使用它。
学习与Apache Sqoop及其功能相关的技术细节。
Kafka与Hadoop组件集成,用于获取企业数据。
使用Flume进行流式数据处理。
理解Flink与流式数据处理的关系。
Hadoop生态圈组件的协同使用,以及它们能带来的好处。
使用Elastic Stack构建快速、流式、高吞吐应用。
确保数据摄取处理在不同数据格式配置时的一致性。
作者简介
汤姆斯•约翰(Tomcy John)是一名企业级Java技术专家,拥有工学学士学位,并且有超过14年多行业的开发经验。他目前担任Emirates Group IT核心架构部门的首席架构师。在此之前,他曾在甲骨文公司、安永公司任职。他主要擅长构建企业级应用,并且在企业内担任首席导师和布道者,以促进新技术融入企业标准技术栈。
潘卡•米斯拉(Pankaj Misra)是一名技术传播者,拥有工程学士学位,并且有超过16年跨多个业务领域的技术经验。自2015年以来,他一直在Emirates Group IT任职。他擅长架构和构建多技术栈的解决方案及实现。他在印度的技术论坛上也是一名活跃分子,参与过多个海量数据、可水平扩展的近实时数据处理和分析产品的构建。
目录
译者序
推荐序
关于作者
关于技术审核人员
前言
第一部分 概述
第1章 数据导论 2
1.1 探索数据 3
1.2 什么是企业数据 4
1.3 企业数据管理 5
1.4 大数据相关概念 6
1.5 数据与企业的相关性 8
1.6 数据质量 9
1.7 企业中数据如何存放 10
1.7.1 内联网(企业内部) 10
1.7.2 互联网(企业外部) 10
1.7.3 数据持久化存储(RDBMS或者NoSQL) 12
1.7.4 传统的数据仓库 13
1.7.5 文件存储 13
1.8 企业现状 14
1.9 企业数字化转型 15
1.10 数据湖用例启示 16
1.11 总结 17
第2章 数据湖概念概览 18
2.1 什么是数据湖 18
2.2 数据湖如何帮助企业 19
2.3 数据湖是如何工作的 20
2.4 数据湖与数据仓库的区别 21
2.5 数据湖的构建方法 22
2.6 Lambda架构驱动的数据湖 22
2.6.1 数据摄取层——摄取数据用于处理和存储 23
2.6.2 批处理层——批量处理已提取数据 23
2.6.3 快速处理层——近实时数据处理 24
2.6.4 数据存储层——存储所有数据 24
2.6.5 服务层——数据交付与导出 25
2.6.6 数据获取层——从源系统获取数据 25
2.6.7 消息层——数据传输的保障 26
2.6.8 探索数据摄取层 27
2.6.9 探索Lambda层 28
2.7 总结 35
第3章 Lambda架构:一种数据湖实现模式 36
3.1 什么是Lambda架构 36
3.2 Lambda 架构简史 37
3.3 Lambda架构的原则 37
3.3.1 容错原则 38
3.3.2 不可变数据原则 38
3.3.3 重新计算原则 38
3.4 Lambda架构的组件 38
3.4.1 批处理层 39
3.4.2 快速处理层 41
3.4.3 服务层 43
3.5 Lambda架构的完整工作原理 44
3.6 Lambda架构的优势 45
3.7 Lambda架构的劣势 46
3.8 Lambda架构技术概览 46
3.9 应用Lambda 47
3.9.1 企业级日志分析 47
3.9.2 获取和分析传感器数据 47
3.9.3 电子邮件平台实时统计 48
3.9.4 实时赛事分析 48
3.9.5 推荐引擎 48
3.9.6 安全威胁分析 48
3.9.7 多渠道用户行为分析 48
3.10 Lambda架构运行范例 48
3.11 Kappa架构 49
3.12 总结 50
第4章 数据湖中的Lambda应用 51
4.1 Hadoop发行版本介绍 51
4.2 影响企业大数据技术栈选择的因素 53
4.2.1 技术能力 53
4.2.2 是否易于部署和维护 53
4.2.3 集成准备 53
4.3 批处理层与数据处理 53
4.3.1 NameNode服务器 54
4.3.2 Secondary NameNode服务器 55
4.3.3 YARN 55
4.3.4 数据存储节点 55
4.3.5 快速处理层 56
4.3.6 Flume用于数据获取 57
4.3.7 Spark Streaming 58
4.4 服务层 62
4.4.1 数据存储层 62
4.4.2 数据访问层 63
4.5 总结 64
第二部分 数据湖的技术组件
第5章 基于Apache Sqoop的批量数据获取 68
5.1 数据湖背景中的数据获取 68
5.1.1 数据获取层 68
5.1.2 批量数据获取——技术路线图 69
5.2 为什么使用Apache Sqoop 70
5.2.1 Sqoop简史 71
5.2.2 Sqoop的优势 71
5.2.3 Sqoop的劣势 72
5.3 Sqoop的功能 72
5.3.1 Sqoop 2的架构 74
5.3.2 Sqoop 1与Sqoop 2 75
5.3.3 Sqoop的功能 77
5.3.4 使用Sqoop导入数据 77
5.3.5 使用Sqoop导出数据 78
5.4 Sqoop connector 79
5.5 Sqoop对HDFS的支持 81
5.6 Sqoop运行范例 81
5.6.1 安装与配置 81
5.6.2 数据源配置 90
5.6.3 Sqoop配置(数据库驱动) 91
5.6.4 将HDFS配置为目的地 91
5.6.5 Sqoop数据导入 91
5.6.6 Sqoop数据导出 97
5.6.7 Sqoop job 98
5.6.8 Sqoop 2 99
5.6.9 SCV用例视角中的Sqoop 102
5.7 适合使用Sqoop的场景 103
5.8 不适合使用Sqoop的场景 104
5.9 实时Sqooping是否可行 104
5.10 其他选项 104
5.10.1 原生大数据connector 105
5.10.2 Talend 106
5.10.3 Pentaho Kettle(PDI——Pentaho数据集成) 106
5.11 总结 106
第6章 基于Apache Flume的流式数据获取 108
6.1 数据获取 108
6.1.1 什么是流式数据 109
6.1.2 批量数据和流式数据 110
6.1.3 流式数据获取——技术路线图 110
6.1.4 什么是Flume 111
6.1.5 Sqoop和Flume 112
6.2 为什么使用Flume 113
6.2.1 Flume简史 113
6.2.2 Flume的优势 113
6.2.3 Flume的劣势 114
6.3 Flume的架构原则 114
6.4 Flume架构 115
6.4.1 Flume 架构之一:分布式数据流水线 116
6.4.2 Flume 架构之二:扇出 117
6.4.3 Flume 架构之三:扇入 117
6.4.4 Flume架构中的3层设计 118
6.4.5 高级Flume架构 118
6.4.6 Flume的可靠性级别 120
6.5 Flume事件——流式数据 120
6.6 Flume Agent 120
6.7 Flume Source 122
6.8 Flume Channel 123
6.9 Flume Sink 125
6.10 Flume配置 126
6.11 Flume事务管理 127
6.12 Flume的其他组件 128
6.12.1 Channel Processor 128
6.12.2 Interceptor 129
6.12.3 Channel Selector 129
6.12.4 Sink Group 130
6.12.5 事件序列化 131
6.13 上下文路由 131
6.14 Flume运行范例 132
6.14.1 安装和配置 132
6.14.2 SCV用例中的Flume 133
6.15 适合使用Flume的场景 145
6.16 不适合使用Flume的场景 145
6.17 其他选项 146
6.17.1 Apache Flink 146
6.17.2 Apache NiFi 146
6.18 总结 147
第7章 使用Apache Kafka构建消息层 148
7.1 数据湖背景中的消息层 148
7.1.1 消息层 148
7.1.2 消息层——技术路线图 149
7.1.3 什么是Apache Kafka 150
7.2 为什么使用Apache Kafka 150
7.2.1 Kafka简史 151
7.2.2 Kafka的优势 152
7.2.3 Kafka的劣势 153
7.3 Kafka的架构 153
7.3.1 Kafka架构的核心原则 153
7.3.2 数据流的生命周期 154
7.3.3 Kafka的工作原理 155
7.3.4 Kafka的消息 156
7.3.5 Kafka生产者 157
7.3.6 Kafka topic中的数据持久化 157
7.3.7 Kafka中topic的划分:partition 158
7.3.8 Kafka中的消息broker 159
7.3.9 Kafka的消费者 160
7.4 其他Kafka组件 161
7.4.1 ZooKeeper 161
7.4.2 MirrorMaker 161
7.5 Kafka编程接口 162
7.5.1 Kafka核心API 162
7.5.2 Kafka REST接口 162
7.6 生产者和消费者的可靠性 162
7.7 Kafka的安全性 163
7.8 Kafka作为面向消息的中间件 164
7.9 Kafka与水平可扩展架构 165
7.10 Kafka连接 165
7.11 Kafka运行范例 166
7.11.1 安装 166
7.11.2 生产者:向Kafka写入数据 167
7.11.3 消费者:从Kafka获取数据 171
7.11.4 设置多broker集群 173
7.11.5 SCV用例中的Kafka应用 176
7.12 适合使用Kafka的场景 176
7.13 不合适使用Kafka的场景 177
7.14 其他选项 177
7.14.1 RabbitMQ 177
7.14.2 ZeroMQ 179
7.14.3 Apache ActiveMQ 179
7.15 总结 180
第8章 使用Apache Flink处理数据 181
8.1 数据湖背景中的数据摄取层 181
8.1.1 数据摄取层 182
8.1.2 数据摄取层——技术路线图 183
8.1.3 什么是Apache Flink 184
8.2 为什么使用Apache Flink 184
8.2.1 Flink简史 185
8.2.2 Flink的优势 186
8.2.3 Flink的劣势 187
8.3 Flink的工作原理 187
8.3.1 Flink架构 187
8.3.2 Flink架构的核心原则 192
8.3.3 Flink组件栈 192
8.3.4 Flink中的Checkpointing 192
8.3.5 Flink中的Savepoint 194
8.3.6 Flink中的流窗口选项 195
8.3.7 内存管理 197
8.4 Flink的API 197
8.4.1 DataStream API 198
8.4.2 DataSet API 200
8.4.3 Flink领域相关库 202
8.5 Flink运行范例 203
8.5.1 安装 204
8.5.2 范例——使用Flink处理数据 205
8.5.3 SCV用例中的Flink 212
8.6 适合使用Flink的场景 217
8.7 不适合使用Flink的场景 218
8.8 其他选项 218
8.8.1 Apache Spark 218
8.8.2 Apache Storm 219
8.8.3 Apache Tez 219
8.9 总结 220
第9章 使用Apache Hadoop存储数据 221
9.1 数据湖背景中的数据存储和Lambda批处理层 221
9.1.1 数据存储和Lambda批处理层 222
9.1.2 数据存储和Lambda批处理层——技术路线图 223
9.1.3 什么是Apache Hadoop 224
9.2 为什么使用Hadoop 224
9.2.1 Hadoop简史 225
9.2.2 Hadoop的优势 225
9.2.3 Hadoop的劣势 226
9.3 Hadoop的工作原理 227
9.3.1 Hadoop架构的核心原则 227
9.3.2 Hadoop架构 228
9.3.3 Hadoop架构组件 231
9.3.4 Hadoop架构细节 233
9.4 Hadoop生态系统 234
9.4.1 数据访问/处理组件 235
9.4.2 数据存储组件 236
9.4.3 监控、管理和协调组件 237
9.4.4 数据集成组件 239
9.5 Hadoop发行版 240
9.6 HDFS和数据格式 241
9.7 Hadoop用于近实时应用 242
9.8 Hadoop部署模式 243
9.9 Hadoop运行范例 243
9.9.1 安装 244
9.9.2 数据准备 244
9.9.3 安装Hive 244
9.9.4 范例——批量数据加载 247
9.9.5 范例——MapReduce数据处理 248
9.9.6 SCV用例中的Hadoop 254
9.10 不适合使用Hadoop的场景 262
9.11 其他选项 263
9.12 总结 263
第10章 使用Elasticsearch存储全文索引 264
10.1 数据湖背景中的数据存储层与Lambda快速处理层 264
10.1.1 数据存储层与Lambda快速处理层 265
10.1.2 数据存储层与Lambda快速处理层——技术路线图 265
10.2 什么是Elasticsearch 266
10.3 为什么使用Elasticsearch 266
10.3.1 Elasticsearch简史 267
10.3.2 Elasticsearch的优势 268
10.3.3 Elasticsearch的劣势 269
10.4 Elasticsearch的工作原理 269
10.4.1 Elasticsearch架构的核心原则 269
10.4.2 Elasticsearch术语 270
10.5 Elastic Stack 273
10.5.1 Kibana 273
10.5.2 Elasticsearch 275
10.5.3 Logstash 276
10.5.4 Beats 277
10.6 Elastic Cloud 279
10.7 Elasticsearch DSL 281
10.8 Elasticsearch中的节点 283
10.8.1 Master节点 283
10.8.2 Data节点 283
10.8.3 Client节点 284
10.9 Elasticsearch与关系数据库 284
10.10 Elasticsearch生态系统 285
10.10.1 Elasticsearch分析器 285
10.10.2 Elasticsearch插件 286
10.11 Elasticsearch部署选项 287
10.12 Elasticsearch Client 287
10.13 Elasticsearch用于快速流式处理 288
10.14 Elasticsearch作为数据源 289
10.15 Elasticsearch用于内容索引 289
10.16 Elasticsearch与Hadoop 289
10.17 Elasticsearch运行范例 290
10.17.1 安装 291
10.17.2 创建和删除索引 293
10.17.3 对文档进行索引 294
10.17.4 获取被索引的文档 296
10.17.5 搜索文档 296
10.17.6 更新文档 299
10.17.7 删除文档 299
10.17.8 SCV用例中的Elasticsearch 300
10.18 适合使用Elasticsearch的场景 317
10.19 不适合使用Elasticsearch的场景 317
10.20 其他选项 318
10.21 总结 319
第三部分 将所有技术整合在一起
第11章 数据湖组件集成 322
11.1 数据湖的学习进程 322
11.2 数据湖架构的核心原则 324
11.3 企业数据湖面临的挑战 324
11.4 企业对数据湖的期望 326
11.5 数据湖的其他用途 326
11.6 了解更多关于数据存储的信息 327
11.6.1 数据存储区域 327
11.6.2 数据模式和模型 329
11.6.3 存储选项 329
11.6.4 压缩方法 331
11.6.5 数据分区 332
11.7 更多关于数据处理的知识 333
11.7.1 数据校验和清洗 333
11.7.2 机器学习 334
11.7.3 调度器/工作流 334
11.7.4 Apache Oozie 335
11.7.5 复杂事件处理 340
11.8 数据安全 341
11.8.1 Apache Knox 342
11.8.2 Apache Ranger 342
11.8.3 Apache Sentry 344
11.9 数据加密 345
11.10 元数据管理和治理 346
11.10.1 元数据 346
11.10.2 数据治理 347
11.10.3 数据世系 347
11.10.4 如何实现 348
11.11 数据审计 350
11.12 数据可追溯性 350
11.13 了解更多服务层细节 351
11.13.1 服务层构建原则 351
11.13.2 服务类型 351
11.13.3 服务层组件 353
11.13.4 数据导出 355
11.13.5 混合数据访问 355
11.13.6 范例——服务层 355
11.14 总结 360
第12章 数据湖用例建议 361
12.1 在企业中推行网络安全实践 361
12.2 深入了解企业的客户 362
12.3 提升仓储管理效率 363
12.4 品牌创建与企业营销 364
12.5 为客户提供更个性化的服务 366
12.6 让物联网数据触手可及 367
12.7 更实用的数据归档 367
12.8 现有的数据仓库基础设施 368
12.9 实现电信安全和法规遵从 368
12.10 总结 369
你与世界
只差一个
公众号

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献16条内容

所有评论(0)