【leetcode】140.单词拆分 II (动态规划两种方法,java实现)
·
140. 单词拆分 II
难度困难
给定一个非空字符串 s 和一个包含非空单词列表的字典 wordDict,在字符串中增加空格来构建一个句子,使得句子中所有的单词都在词典中。返回所有这些可能的句子。
说明:
- 分隔时可以重复使用字典中的单词。
- 你可以假设字典中没有重复的单词。
示例 1:
输入:
s = "catsanddog"
wordDict = ["cat", "cats", "and", "sand", "dog"]
输出:
[
  "cats and dog",
  "cat sand dog"
]
示例 2:
输入:
s = "pineapplepenapple"
wordDict = ["apple", "pen", "applepen", "pine", "pineapple"]
输出:
[
  "pine apple pen apple",
  "pineapple pen apple",
  "pine applepen apple"
]
解释: 注意你可以重复使用字典中的单词。
示例 3:
输入:
s = "catsandog"
wordDict = ["cats", "dog", "sand", "and", "cat"]
输出:
[]
我们就接着使用上一题的到的动态规划的状态数组来解答这个问题。
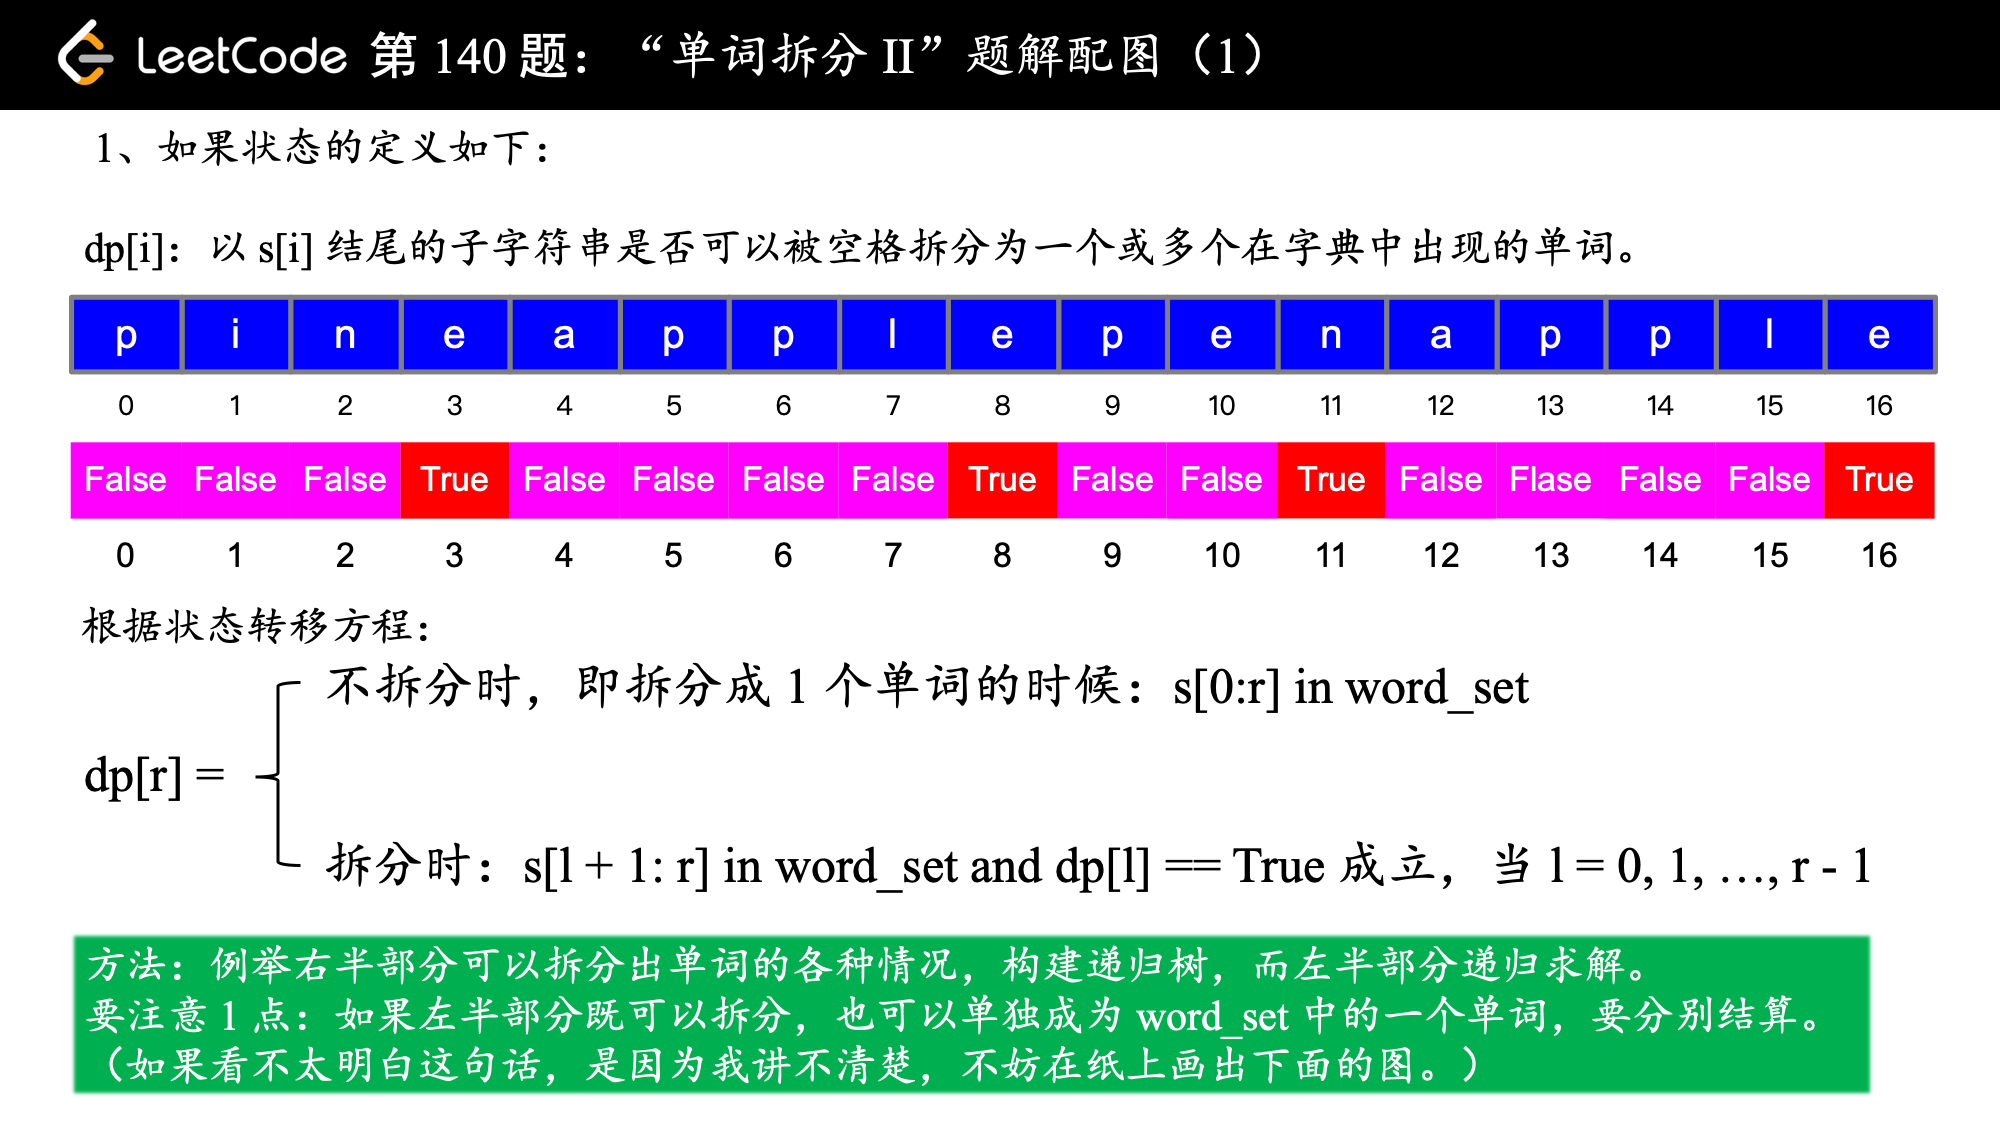
1 / 4
参考代码 1:状态的定义为:以 s[i] 结尾的子字符串是否可以被空格拆分为一个或多个在字典中出现的单词。
import java.util.ArrayList;
import java.util.HashSet;
import java.util.LinkedList;
import java.util.List;
import java.util.Set;

public class Solution {

    public List<String> wordBreak(String s, List<String> wordDict) {
        int len = s.length();
        // 状态定义:以 s[i] 结尾的子字符串是否符合题意
        boolean[] dp = new boolean[len];

        // 预处理
        Set<String> wordSet = new HashSet<>();
        for (String word : wordDict) {
            wordSet.add(word);
        }

        // 动态规划问题一般都有起点,起点也相对好判断一些
        // dp[0] = wordSet.contains(s.charAt(0));
        for (int r = 0; r < len; r++) {
            if (wordSet.contains(s.substring(0, r + 1))) {
                dp[r] = true;
                continue;
            }
            for (int l = 0; l < r; l++) {
                // dp[l] 写在前面会更快一点,否则还要去切片,然后再放入 hash 表判重
                if (dp[l] && wordSet.contains(s.substring(l + 1, r + 1)) ) {
                    dp[r] = true;
                    // 这个 break 很重要,一旦得到 dp[r] = True ,循环不必再继续
                    break;
                }
            }
        }

        List<String> res = new ArrayList<>();
        if (dp[len - 1]) {
            LinkedList<String> queue = new LinkedList<>();
            dfs(s, len - 1, wordSet, res, queue, dp);
            return res;
        }

        return res;
    }

    private void dfs(String s, int end, Set<String> wordSet, List<String> res, LinkedList<String> queue, boolean[] dp) {
        if (wordSet.contains(s.substring(0, end + 1))) {
            queue.addFirst(s.substring(0, end + 1));

            StringBuilder stringBuilder = new StringBuilder();
            for (String word : queue) {
                stringBuilder.append(word);
                stringBuilder.append(" ");
            }
            stringBuilder.deleteCharAt(stringBuilder.length() - 1);
            res.add(stringBuilder.toString());

            queue.removeFirst();
        }

        for (int i = 0; i < end; i++) {

            if (dp[i]) {
                String suffix = s.substring(i + 1, end + 1);

                if (wordSet.contains(suffix)) {
                    queue.addFirst(suffix);
                    dfs(s, i, wordSet, res, queue, dp);
                    queue.removeFirst();
                }
            }

        }
    }


    public static void main(String[] args) {
        String s = "pineapplepenapple";
        List<String> wordDict = new ArrayList<>();
        wordDict.add("apple");
        wordDict.add("pen");
        wordDict.add("applepen");
        wordDict.add("pine");
        wordDict.add("pineapple");
        Solution solution = new Solution();
        List<String> res = solution.wordBreak(s, wordDict);
        System.out.println(res);
    }
}
参考代码 2:状态:dp[i] 表示子串 s[0:i] (即长度为 i 的子串,其实就是前缀)可以被空格拆分,并且拆分以后的单词是否落在 wordDict 中。
public class Solution {
    List<String> result = new ArrayList<>();
    List<String> list = new ArrayList<>();
    Set<String> set = new HashSet<>();
    StringBuilder b = new StringBuilder();
    int max = 0;
    int min = Integer.MAX_VALUE;

    public List<String> wordBreak(String s, List<String> wordDict) {
        int length = s.length();
        for (String str : wordDict) {
            set.add(str);

            int l = str.length();
            if (l > max) max = l;
            if (l < min) min = l;
        }

        // 状态定义:长度为 i 的子字符串是否符合题意
        boolean[] dp = new boolean[length + 1];
        // 这个状态的设置非常关键,说明前部分的字符串已经在 wordSet 中
        dp[0] = true;

        for (int end = min - 1; end <= length; end++) {

            int range = Math.max(0, end - max);
            for (int start = end - 1; range <= start; start--) {
                if (dp[start] && set.contains(s.substring(start, end))) {
                    dp[end] = true;
                    break;
                }
            }
        }

        if (dp[length]) {
            dfs(s, length, dp);
        }

        return result;
    }

    private void dfs(String s, int end, boolean[] dp) {
        if (end == 0) {
            b.setLength(0);

            for (int i = list.size() - 1; i >= 0; i--) {
                b.append(list.get(i)).append(" ");
            }

            b.deleteCharAt(b.length() - 1);
            result.add(b.toString());
            return;
        }

        int size = list.size();
        for (int start = Math.max(0, end - max); start < end; start++) {
            if (end - start < min) break;
            if (!dp[start]) continue;

            String suffix = s.substring(start, end);
            if (!set.contains(suffix)) continue;

            list.add(suffix);
            dfs(s, start, dp);
            list.remove(size);
        }
    }
}


            String suffix = s.substring(start, end);
            if (!set.contains(suffix)) continue;

            list.add(suffix);
            dfs(s, start, dp);
            list.remove(size);
        }
    }
}

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献27条内容

所有评论(0)