算法设计技巧: 贪心算法(Greedy Algorithm)
贪心算法是一种启发式(Heuristic)算法, 它的基本思想是在每一步决策时选择局部最优的策略. 贪心算法一般在设计和实现上比较容易, 因此在求解实际问题中应用广泛.
编码问题
考虑如下的编码问题: 给定字符的集合 C C C, 例如 C = { a , b , c , d , e } C=\{a, b, c, d, e\} C={a,b,c,d,e}. 每个字符 α ∈ C \alpha\in C α∈C的使用频次为 f α f_{\alpha} fα. 我们需要给每个字符 α ∈ C \alpha\in C α∈C进行二进制编码(字符 α \alpha α对应的编码长度记作 l α l_{\alpha} lα). 总的编码长度的计算公式为: L = ∑ α ∈ C f α ⋅ l α L = \sum_{\alpha\in C}f_{\alpha}\cdot l_{\alpha} L=∑α∈Cfα⋅lα. 我们的目标是设计一种编码使得总的编码长度最小.
| a | b | c | d | e | f | |
|---|---|---|---|---|---|---|
| 频次 | 45 | 13 | 12 | 16 | 9 | 5 |
| 定长编码 | 000 | 001 | 010 | 011 | 100 | 101 |
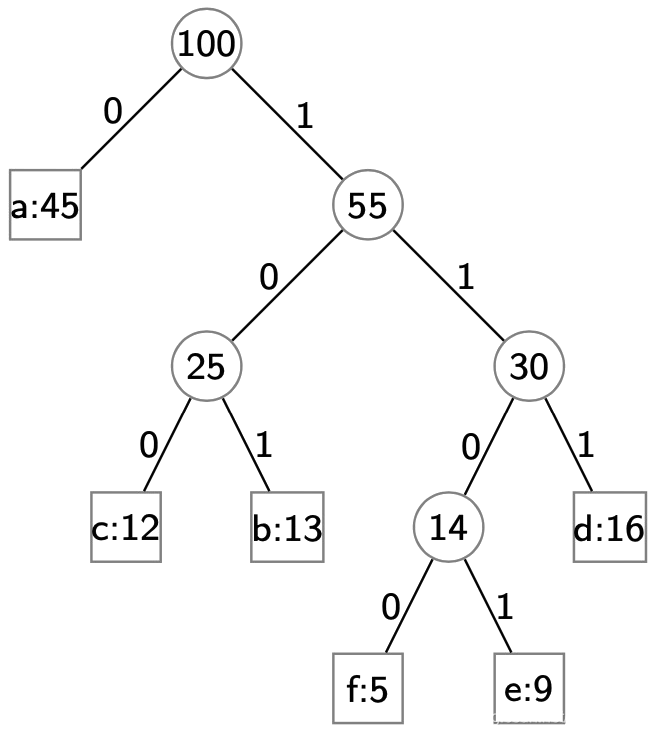
| 变长编码 | 0 | 101 | 100 | 111 | 1101 | 1100 |
如上表所示, 考虑两种编码: 定长编码和变长编码. 其中变长编码为前缀码: 任一字符的编码不是另一字符编码的前缀.
- 定长编码总长度: 300bits
- 变长编码总长度: 224bits
变长编码的解码过程如下: 根据字符编码构造一棵二叉树, 每一个二进制位代表一个分支(和对应的节点), 其中0代表向左分支, 1代表向右分支, 叶子节点代表字符. 解码时从根节点开始搜索直到叶子节点, 则完成一个字符的解码. 例如: 110001001101 = face.
Huffman编码
为了方便理解, 我们把上述编码问题换一种表达方式. 令 T T T代表变长码对应的二叉树, d α T d_{\alpha}^T dαT代表叶子节点 α \alpha α的深度(Depth, 即编码长度). 我们的目标是构造二叉树 T ∗ T^* T∗, 使得 ∑ α ∈ C d α T ∗ f α \sum_{\alpha\in C} d^{T^*}_{\alpha} f_{\alpha} ∑α∈CdαT∗fα最小化.
通过分析(过程省略, 详细请参考1), 我们有如下结论
- Lemma1. T ∗ T^* T∗的每个内部点(即非叶子节点)有两个节点. (反证法)
- Lemma2. T ∗ T^* T∗有|C|个叶子节点(对应每个字符)和 ∣ C ∣ − 1 |C|-1 ∣C∣−1个内部点(Lemma1).
根据Lemma2, 我们从下到上构建二叉树. 注意到节点的深度代表了编码的长度, 因此频次越低的字符所在的节点越深.
算法
从 C C C中弹出2个频次最低的字符 α , β \alpha, \beta α,β, 并构造新的节点 α β \alpha\beta αβ, f α β = f α + f β f_{\alpha\beta} = f_{\alpha} + f_{\beta} fαβ=fα+fβ, 作为 α \alpha α和 β \beta β的父节点, 再把 α β \alpha\beta αβ加入到 C C C中. 循环执行上述步骤直到 C C C为空(注意: 循环次数为 n − 1 n-1 n−1次).
Python实现
定义二叉树的节点类Node.
class Node(object):

    def __init__(self):
        # data
        self.char = None  # character
        self.freq = None  # frequency
        # pointers
        self.left = None  # left child
        self.right = None  # right child
HuffmanCodes类实现对字符串的编码与解码. 编码本质上是按照上述贪心算法自下而上构建二叉树(参考HuffmanCodes._build_binary_tree()). 解码时从二叉树的根节点搜索到叶子节点(0-代表left child, 1代表-right child), 从而得到对应的字符(HuffmanCodes._decode).
import queue


class HuffmanCodes(object):

    def __init__(self, c, f):
        """
        :param c: characters, str list
        :param f: frequencies, int list
        """
        self._c = c
        self._f = f
        self._n = len(self._c)
        self._q = self._init_priority_queue()
        self._root = None  # encoding tree
        self._huffman_codes = {}  # 编码结果
        self._build_binary_tree() # 构建二叉树
        self._format_huffman_codes()  # 保存编码结果

    def _init_priority_queue(self):
        """ 初始化优先队列.
        priority = frequency, value = node
        使用优先队列可以在O(log n)内返回队列的最小值(代价是插入元素的耗时为O(log n)).
        """
        q = queue.PriorityQueue()
        for item in zip(self._c, self._f):
            v = Node()
            v.char, v.freq = item[0], item[1]
            q.put((v.freq, v))
        return q

    def _build_binary_tree(self):
        """ 自下而上构建二叉树.
        Greedy: 每一步从未被连接的节点中, 选择频次(frequency)最小的两个节点合并(作为新的节点).
        """
        for i in range(self._n - 1):
            z = Node()
            # 从队列里弹出两个最小权重的节点,合并成新的节点z
            z.left = self._q.get()[1]
            z.right = self._q.get()[1]
            z.freq = z.left.freq + z.right.freq
            # 把z插入到队列中
            self._q.put((z.freq, z))
        # 执行n-1步之后, 队列q剩下一个元素,即二叉树的根节点.
        self._root = self._q.get()[1]

    def _format_huffman_codes(self):
        """ 把每一个字符对应的编码保存在字典中(self._huffman_codes)
   		"""
        temp = []

        def traverse(v, res):
            if v.left is None and v.right is None:
                self._huffman_codes[v.char] = ''.join(res)
                return
            res.append('0')
            traverse(v.left, res)
            res.pop(-1)
            res.append('1')
            traverse(v.right, res)
            res.pop(-1)

        traverse(self._root, temp)

    def encode(self, chars):
        """ 把字符串chars转换成Huffman codes.
        """
        return ''.join([self._huffman_codes[c] for c in chars])

    def decode(self, codes):
        """ 把0/1编码(字符串格式)转换成字符串.
        """
        res = []
        v = self._root
        for c in codes:
            if c == '0':
                v = v.left
            elif c == '1':
                v = v.right
            if v.left is None and v.right is None:
                res.append(v.char)
                v = self._root

        return ''.join(res)
Remark
为了更好的理解贪心算法, 我们考虑两个问题:
1. 给定一个问题 P P P和求解 P P P的贪心算法 A A A. A A A是否返回 P P P的最优解?
基本的思路是采用反证法. 假设 A A A得到的解不是最优解, 那么存在 k > 0 k>0 k>0, 算法 A A A在第 k k k步决策时没有采用局部最优策略, 按照这个思路如果得出矛盾, 那么最有性得证. 具体的例子可以参考教材算法导论(Introduction to Algorithms)1(23章-最小生成树, 16章-贪心算法).
2. 贪心算法适用于哪些优化问题?(返回最优解)
独立集
设 S S S是一个有限集, I ∈ 2 S \mathcal{I} \in 2^S I∈2S. ( S , I ) (S, \mathcal{I}) (S,I)称为一个独立集系统当它满足两个条件: i. 非空性: ∅ ∈ I \emptyset \in \mathcal{I} ∅∈I; ii. 继承性: 如果 I ∈ I I\in \mathcal{I} I∈I, J ⊆ I J\subseteq I J⊆I, 那么 J ∈ I J\in \mathcal{I} J∈I. 我们把 I ∈ I I\in \mathcal{I} I∈I称为独立集(Independent Set).
独立集上的优化问题
给定权重函数 w : S → R w: S\rightarrow \mathbb{R} w:S→R, 我们的目标是找到 I ∈ I I \in\mathcal{I} I∈I使得 I I I的总权重 w ( I ) = ∑ x ∈ I w ( x ) w(I) = \sum_{x\in I} w(x) w(I)=∑x∈Iw(x)最大.
贪心算法
从 M = ∅ M=\emptyset M=∅开始, 每次从 S S S中弹出权重最大的元素 e e e, 如果 M ∪ { e } ∈ I M\cup \{e\} \in\mathcal{I} M∪{e}∈I, 则把 e e e添加到 M M M中, 否则丢弃 e e e(直到 S S S为空).
结论
考虑独立集上的优化问题. 贪心算法求得最优解当且仅当独立集系统是 拟阵(Matroid)2, ( S , I ) (S,\mathcal{I}) (S,I)满足条件: 如果 I , J ∈ I , ∣ J ∣ < ∣ I ∣ I, J\in \mathcal{I}, |J| < |I| I,J∈I,∣J∣<∣I∣, 那么存在 x ∈ J \ I x\in J\backslash I x∈J\I使得 I ∪ { x } ∈ I I\cup\{x\} \in \mathcal{I} I∪{x}∈I.
参考文献

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)