selenium打开多个标签与切换
·
打开多个标签页
首先举个错误的思路
driver_path = r"D:\Google\Chrome\Application\chromedriver.exe"
driver = webdriver.Chrome(executable_path=driver_path)
driver.get('https://www.baidu.com/')
driver.get('https://www.douban.com/')
上边代码运行之后,只会在一个标签里先打开百度的首页,然后再打开豆瓣的首页,不是打开两个标签
打开新标签页需要使用execute_script()加上一段js代码来实现
window.open(url),注意区分单双引号
driver_path = r"D:\Google\Chrome\Application\chromedriver.exe"
driver = webdriver.Chrome(executable_path=driver_path)
driver.get('https://www.baidu.com/')
driver.execute_script("window.open('https://www.douban.com')")
页面切换
上述代码虽然打开之后,页面会停留在豆瓣的标签下,但是在编辑器代码里实际操作的时候,仍然是百度的网页
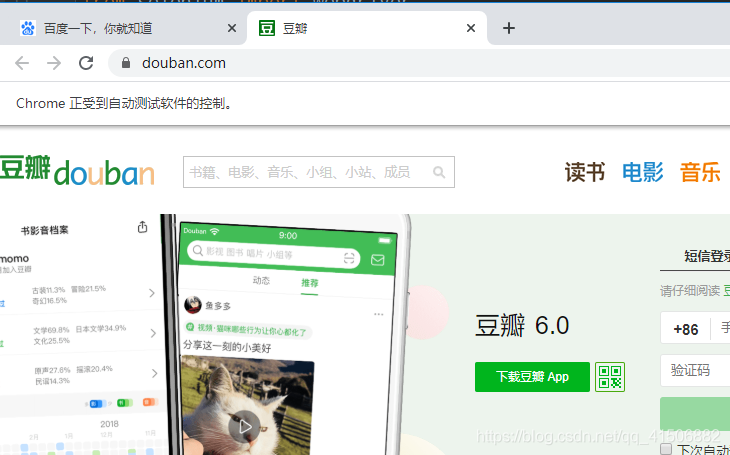
这里通过代码查询当前页面url
print(driver.current_url)
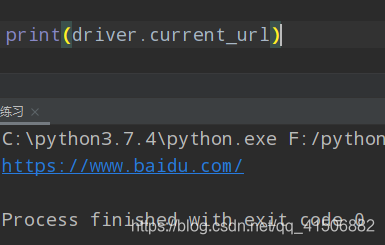
有时候窗口中有很多子tab页面。这时候肯定是需要进行切换的。selenium提供了一个叫做switch_to_window来进行切换,具体切换到哪个页面,可以从driver.window_handles中找到。
print(driver.window_handles)

['CDwindow-13051C3A334123F55FE3D1A2C3484E55',
 'CDwindow-1BB03F20D23F25048FD51CB0CBFD6447']
通过结果可以看出,window_handles返回的是一个列表,所以我们操作的时候需要用索引来切换页面
这里发现有个问题,使用switch_to_window方法,代码上会出现个横线,然后提示错误信息,但是因为我没有后续操作,所以不知道会不会产生什么影响
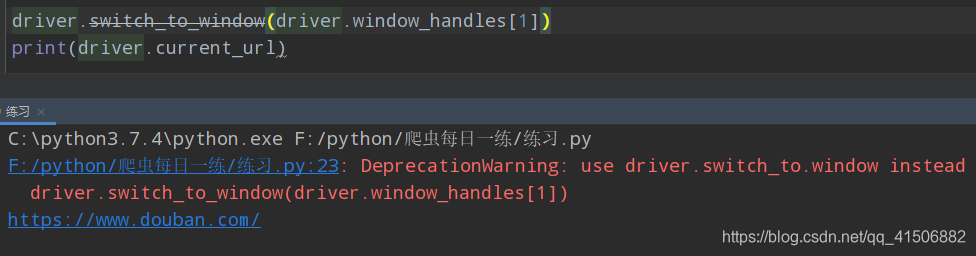
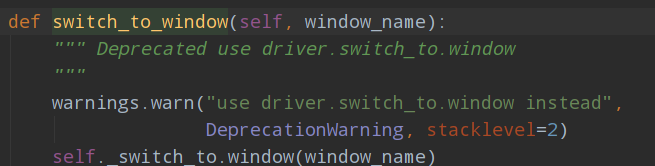
根据源代码,我们换了它提供的方法
driver.switch_to.window(driver.window_handles[1])
print(driver.current_url)
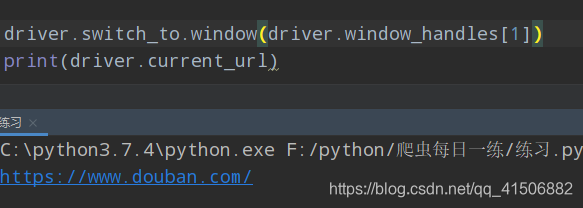
然后就没有问题了
driver.switch_to.window(driver.window_handles[1])
print(driver.current_url)
print(driver.page_source)
需要注意的是,虽然在窗口中切换了新的页面,但是driver中还没有切换,如果想要在代码中切换,并做相应的爬虫,应该先使用driver.switch_to.window切换窗口,从driver.window_handles中取出第几个窗口,driver.window_handles返回的是一个列表,封装的是窗口的句柄,代码会按照页面的顺序来存储窗口的句柄

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献3条内容

所有评论(0)