数据结构之B树与B+树
在了解B树与B+树之前,需要先了解点别的知识。
多路查找树:每一个结点的孩子数可以多于两个,且每一个结点处可以存储多个元素。每一个结点可以存储多少个元素,以及它的孩子数的多少是非常关键的。B树与B+树就是它的特殊形式。
为了更好了解B树,先来看下2-3树和2-3-4树
2-3树
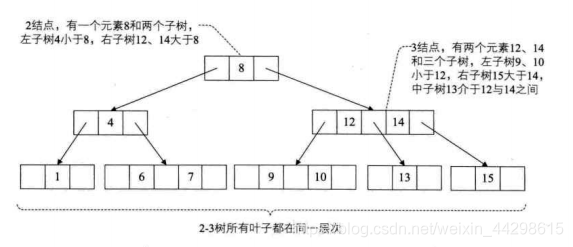
2-3树是这样的一棵多路查找树:每个结点都具有两个孩子(我们称它为2结点)或三个孩子(我们称它为3结点)
一个2结点包含一个元素和两个孩子(或者没有孩子),一个3结点包含一小一大两个元素和三个孩子(或者没有孩子)。这两种情况要么是无孩子,要么满孩子,不会出现2结点含有1个孩子的情况。
2-3-4树
2-3-4树可以说是2-3树的概念扩展,扩展了4结点的使用。
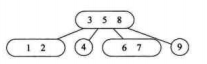
一个4结点包含小中大三个元素和四个孩子(或者没有孩子)。
如果某个结点有孩子的话,左子树包含小于最小元素的元素,第二子树包含大于最小元素,小于第二元素的元素;第三子树包含大于第二元素,小于最大元素的元素;右子树包含大于最大元素的元素。有点拗口,上个图就明白了。
B树
B树是一种平衡的多路查找树,2-3树和2-3-4树都是B树的特例。结点最大的孩子数目称为B树的阶,因此,2-3树是3阶B树,2-3-4树是4阶B树。值得一提的是,B树就是所谓的B-树,B树的英文名称就是B-tree。
一个m阶的B树具有如下属性:
树中每个结点至多有m个孩子。
除根结点和叶子结点外,其它每个结点至少有m/2个孩子。
根结点至少有2个孩子(如果B树只有一个结点除外)。
所有叶结点在同一层,B树的叶结点可以看成一种外部节点,不包含任何信息。
有k个关键字(关键字按递增次序排列)的非叶结点恰好有k+1个孩子。
例如一个2-3-4树:
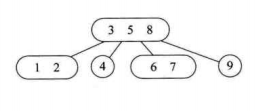
以B树表示时就是:
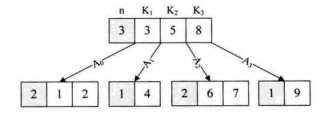
可以看到,在每个结点的前面都加了个灰色方块来表示当前结点的元素的个数。
在一个典型的B树应用中,要处理的硬盘数据量很大,因此无法一次全部装入内存,因此我们对B树进行调整,使得B树的结束(或结点的元素)与硬盘存储的页面大小相匹配。比如一棵B树的阶为1001(即一个结点包含1000个关键字),高度为2他可以存储超过10亿个关键字。
通过这种方式,在有限内存的情况下,每一次磁盘的访问都可以获得最大数量的数据。由于B树每结点可以具有比二叉树多得多的元素,它们减少了必须访问结点和数据块的数量,从而提高了性能。
B+树
虽然B树额能够提高查询速度,但是还是存在问题的。
B+树是应文件系统所需而出的一种B树的变形树。在B+树中出现在分支节点中的元素会被当作它们在该分支结点位置的中序后继者中再次列出。另外,每一个叶子结点都会保存一个指向后一个叶子结点的指针。
B树与B+树的区别:
结构上:
B树中关键字集合分布在整棵树中,叶节点中不包含任何关键字信息,而B+树关键字集合分布在叶子结点中,非叶节点只是叶子结点中关键字的索引;
B树中任何一个关键字只出现在一个结点中,而B+树中的关键字必须出现在叶节点中,也可能在非叶结点中重复出现;
性能上:
B+树的磁盘读写代价更低,因为B+树的所有非叶子节点只会存放索引信息,而真正的数据信息都只存放在叶子节点中,这样一来,每个非叶子节点存放的索引信息就更多,一次磁盘IO就可以读取更多的索引信息到内存中,可以减少磁盘IO的次数。
B+树的查询效率更加稳定,由于非叶子节点只存索引信息,而没有真正的数据信息,所以任何关键字的查找必须走一条从根结点到叶子结点的路。所有关键字查询的路径长度相同,导致每一个数据的查询效率相当。
B+树更加适合在区间查询的情况,由于B+树的数据都存储在叶子结点中,非叶子结点均为索引,只需要扫一遍叶子结点即可得到所有数据信息,但是B树因为其非叶子结点同样存储着数据,我们要找到具体的数据,需要进行一次中序遍历按序来扫,所以B+树更加适合在区间查询的情况,所以通常B+树用于数据库索引。
B+树:
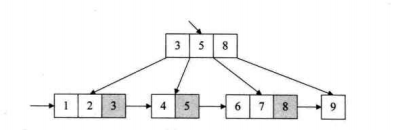
这样的数据结构最大的好处就在于,如果是随机查找,我们就从根结点出发,与B树的查找方式相同,只不过即使在分支结点找到了待查找的关键字,也只是用来索引的,不提供实际记录的访问,还是需要到达包含此关键字的终端结点。
如果是需要从最小关键字进行从小到大的顺序查找,可以从最左侧叶子结点出发,不经过分支结点,而是沿着这项下一叶子的指针就可遍历所有的关键字,不需要返回根节点。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)